

M5 跑大模型:能装下多大、跑多快?内存和带宽一张表看懂(2026)
M5 系列四款芯片的内存和带宽、Apple 用 MLX 测的模型占用、llama.cpp 的生成速度,以及按用途怎么选内存。
 buffer关于作者约 5 分钟阅读
M5 跑大模型没问题,能跑多大看统一内存,跑多快看内存带宽。基础款 M5 最多 32GB、带宽 153GB/s,适合 8B 到 14B 的 4bit 模型和 Qwen3-30B-A3B 这种 MoE 模型;想跑 70B 这一级,至少要 64GB 的 M5 Pro 或 M5 Max,想给上下文留出余量就上 128GB 的 M5 Max 或 M5 Ultra。同样的 7B 模型,M5 Max 的生成速度差不多是基础款 M5 的 3.8 倍。
下面的规格来自 Apple 官网的 14 英寸 M5 MacBook Pro、M5 Pro / M5 Max MacBook Pro、Mac mini 和 Mac Studio 技术规格页,速度数字来自 Apple 的 MLX 测试 和 llama.cpp 的 Apple 芯片跑分帖,都是 2026 年 10 月 27 日核对的。拿独立显卡对比的话,可以先看 4090 能跑多大的模型。
M5 系列四款芯片的内存和带宽
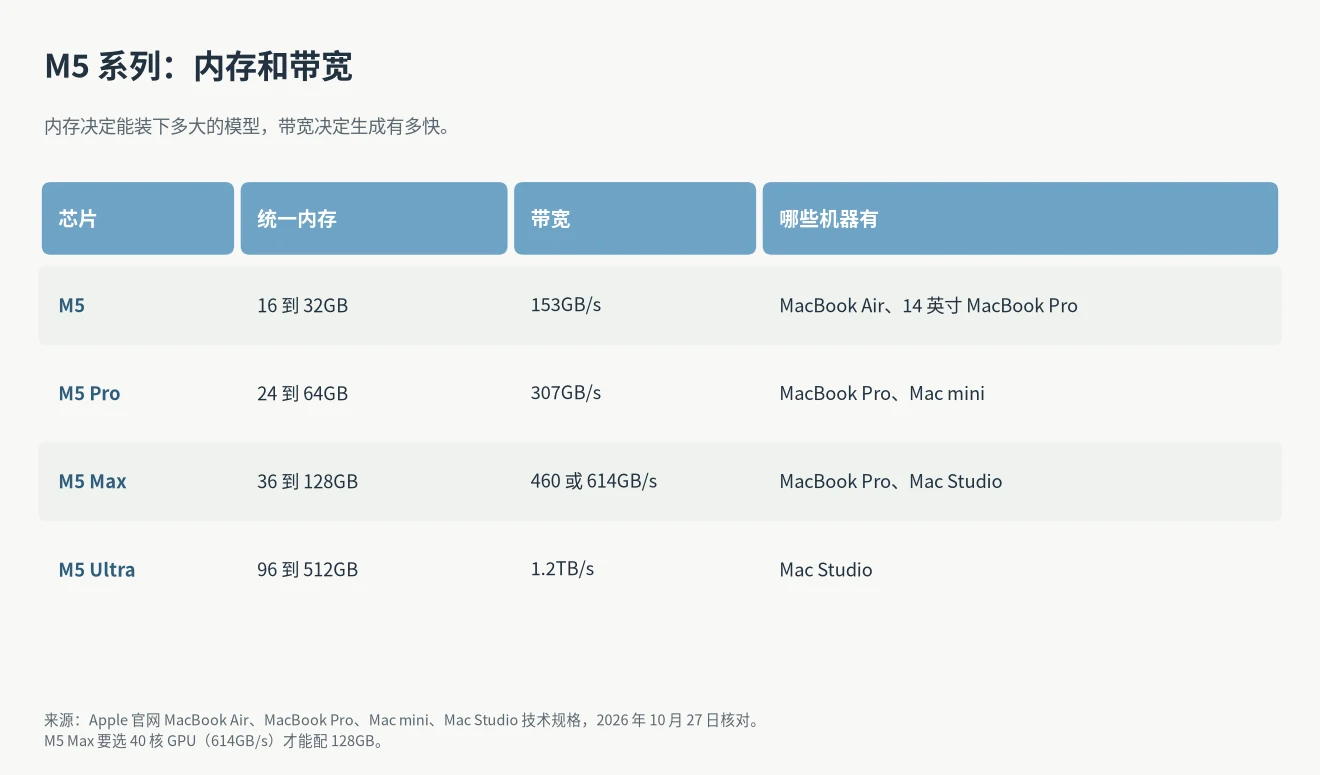
Mac 的 CPU 和 GPU 共用一池统一内存,模型权重放在里面,GPU 直接读。所以买来跑模型,先看这池内存有多大。M5 最多 32GB;M5 Pro 最多 64GB,带宽 307GB/s;M5 Max 最多 128GB,带宽 460 或 614GB/s(Apple 新闻稿);M5 Ultra 只在 Mac Studio 上有,96GB 起,最高 512GB,带宽 1.2TB/s。
有一个容易漏的地方:M5 Max 要选 40 核 GPU 的版本才能配到 128GB,32 核那版固定 36GB(MacBook Pro 规格页)。另外 Mac mini 的入门款现在用的是 M6,想要 M5 系列得选 M5 Pro 版(Mac mini 规格页)。
M5 跑大模型能装下多大
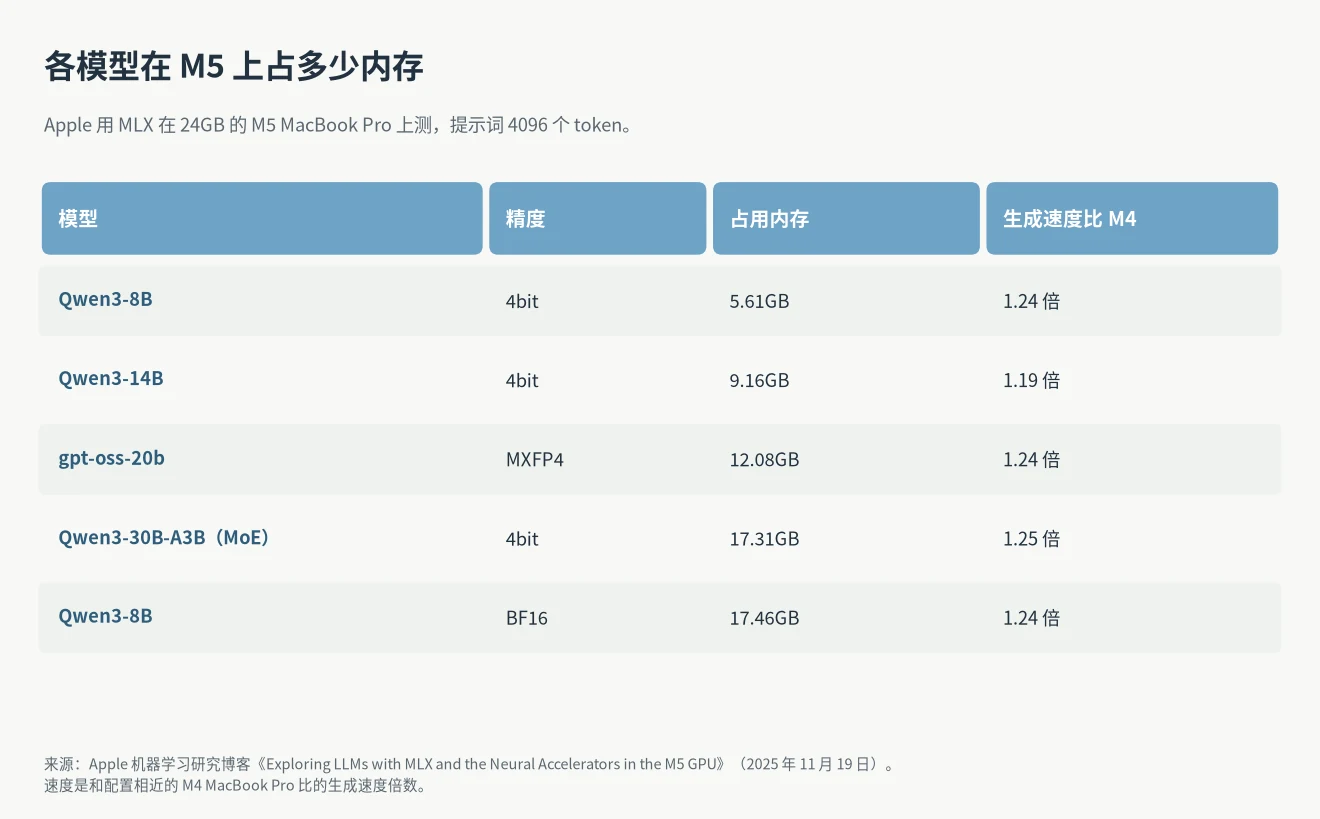
Apple 在 24GB 的 M5 MacBook Pro 上用 MLX 测了 6 个模型。4bit 的 Qwen3-14B 只用了 9.16GB,Qwen3-30B-A3B 4bit 用了 17.31GB,8B 不量化的 BF16 版用了 17.46GB。Apple 的原话是 24GB 的机器能轻松装下 8B 的 BF16 模型或 30B 的 4bit MoE 模型,两种情况都在 18GB 以内(Apple MLX 测试)。
按这张表倒推,4bit 量化下每 10 亿参数大约占 0.65 到 0.7GB。照这个比例粗算,70B 的 4bit 模型要 45GB 以上,再加上系统和上下文要的内存,32GB 的机器装不下,64GB 是起步。这是估算,不同量化格式会差几个 GB。
按内存分一下:
- 16GB:8B 到 14B 的 4bit 模型,适合先试试本地模型。
- 24 到 32GB:gpt-oss-20b、Qwen3-30B-A3B 这类模型,30B 级的 MoE 模型从这一档开始装得下。
- 64GB:70B 的 4bit 模型能装下,或者给 30B 级模型开更长的上下文。
- 128GB 以上:100B 以上的 MoE 模型,或者同时开几个模型。只有 M5 Max 和 M5 Ultra 能选。
跑多快:生成速度看带宽
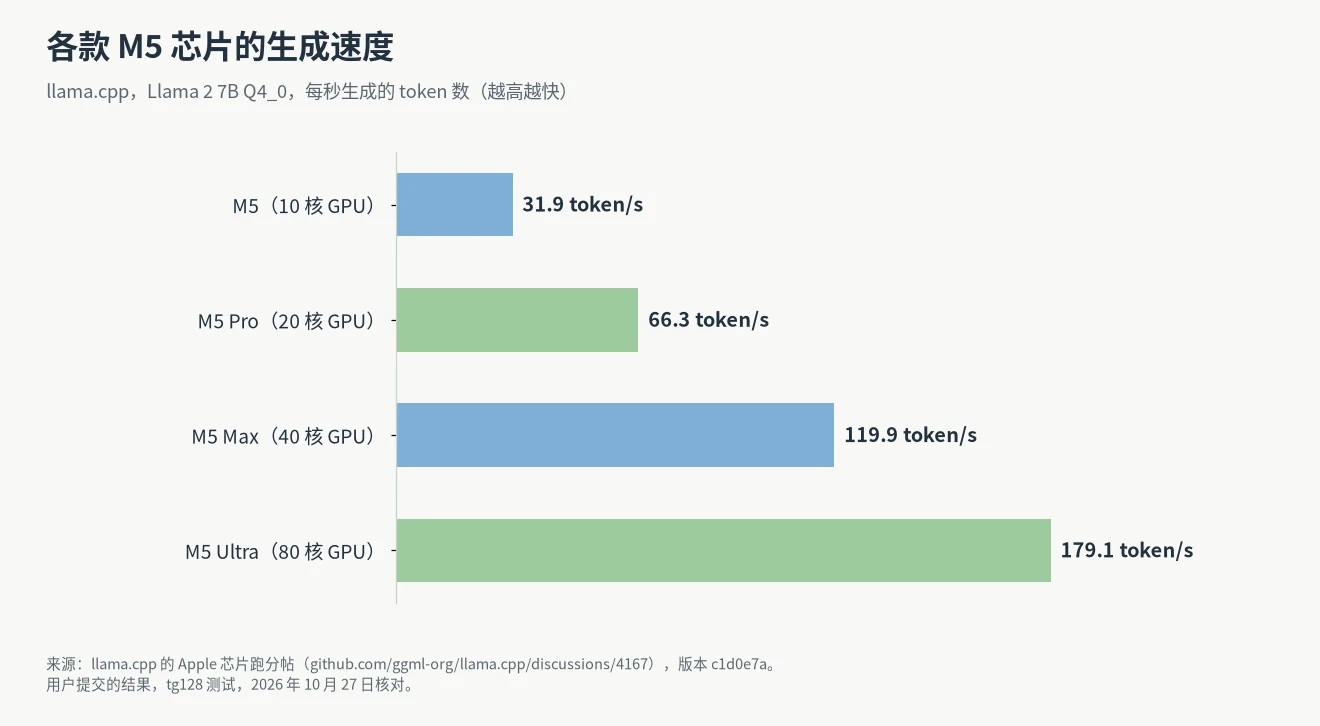
生成每个 token 都要把模型权重读一遍,所以生成速度主要受内存带宽限制。Apple 自己也是这么说的:M5 的带宽是 153GB/s,比 M4 的 120GB/s 高 28%,生成速度就快了 19% 到 27%(Apple MLX 测试)。
llama.cpp 跑分帖里,同一个 Llama 2 7B Q4_0 模型,基础款 M5 每秒生成 31.9 个 token,M5 Pro 66.3 个,M5 Max 119.9 个,M5 Ultra 179.1 个(llama.cpp 跑分帖)。带宽翻倍,速度也差不多翻倍。这是用户提交的数据,不是 Apple 官方测的。
读提示词是另一回事,那部分吃算力。M5 的 GPU 每个核心都带神经网络加速器,Apple 测下来首个 token 出来的速度比 M4 快 3.3 到 4 倍,14B 稠密模型在 10 秒内,30B 的 MoE 在 3 秒内。喂长文档、长代码的话,这个提升比生成速度更明显。
用什么软件跑
最省事的是 MLX。Apple 的开源框架,pip install mlx-lm 装好,用 mlx_lm.chat 就能聊天,Hugging Face 上大部分模型都能跑(mlx-lm 项目)。要用上 M5 的神经网络加速器,系统得是 macOS 26.2 或更新的版本(Apple MLX 测试)。
llama.cpp 和基于它的工具也能用 Metal 跑在 M5 的 GPU 上,上面的速度就是用它测的。两种都试一下,哪个顺手用哪个。
M5 跑大模型怎么选
- 只是试试本地模型、写写东西:16GB 或 24GB 的 M5 MacBook Air 就行。
- 想在本地写代码:至少 32GB,最好是 64GB 的 M5 Pro。哪些模型适合,看 本地大模型写代码选哪个。
- 要跑 70B 或更大的模型:128GB 的 M5 Max,或者 Mac Studio 的 M5 Ultra。
128GB 这个档位也可以看看别的选择,AMD 和 NVIDIA 的小主机我在 AI Max 395 和 DGX Spark 怎么选 里比过。Apple 美西时间 10 月 28 日还有一场发布,什么时候下手可以看 Mac 现在买还是等。
M6 和 M5 跑大模型有什么区别
跑本地模型,M6 没有提高能装下的模型大小。Apple 的 14 英寸 M6 MacBook Pro 统一内存 16GB 起,最高 32GB,和基础款 M5 的上限一样(Apple 新闻稿)。内存带宽最高 170GB/s,M5 是 153GB/s,但只有 24GB 和 32GB 的配置是 170GB/s,16GB 那款还是 153GB/s(MacBook Pro 规格页)。Apple 说 M6 MacBook Pro 处理 LLM 提示词这类端侧 AI 任务比 M5 快最多 25%。新闻稿里的“快 5 倍”说的是新 iMac,比较对象是 M4,测的是 LM Studio 里的提示词处理,不是和 M5 比(iMac 新闻稿)。同样的模型在 M6 上会快一些,但 70B 这类要 64GB 以上内存的模型,还是得选 M5 Pro 或 M5 Max。
常见问题
16GB 的 M5 能跑大模型吗?
能跑,但只适合 8B 到 14B 的 4bit 模型。Apple 测的 4bit Qwen3-14B 用了 9.16GB,16GB 的机器还要留内存给系统和其他软件。
M5 跑模型比 M4 快多少?
生成速度快 19% 到 27%,首个 token 快 3.3 到 4 倍。这是 Apple 用 MLX 在两台配置相近的 MacBook Pro 上测的。
M5 Pro 和 M5 Max 选哪个?
看你要不要 64GB 以上的内存。M5 Pro 最多 64GB,M5 Max 最多 128GB,带宽也是它的两倍,生成速度差不多快一倍。