

M5 para LLM locales: qué modelos caben y a qué velocidad (2026)
Memoria y ancho de banda de los cuatro chips M5, cuánta memoria midió Apple para cada modelo, velocidades de llama.cpp y cuánta memoria comprar según el uso.
 bufferSobre el autor7 min de lectura
Elegir un M5 para LLM locales depende de dos números. La memoria unificada decide qué tamaño de modelo cabe y el ancho de banda decide a qué velocidad escribe. El M5 base llega a 32GB y 153GB/s, suficiente para modelos de 8B a 14B en 4 bits y para modelos MoE como Qwen3-30B-A3B. Para un modelo de 70B necesitas al menos 64GB en un M5 Pro o M5 Max, y 128GB en un M5 Max o M5 Ultra si quieres margen para contextos largos. Con el mismo modelo de 7B, un M5 Max genera unas 3,8 veces más rápido que un M5 base.
Las especificaciones salen de las páginas de Apple del MacBook Pro de 14 pulgadas con M5, del MacBook Pro con M5 Pro o M5 Max, del Mac mini y del Mac Studio. Las velocidades salen de la prueba de Apple con MLX y del hilo de benchmarks de llama.cpp para Apple Silicon. Lo revisé todo el 27 de octubre de 2026. Si estás comparando un Mac con una tarjeta gráfica, empieza por qué modelos puede ejecutar la RTX 4090.
Memoria y ancho de banda de los cuatro chips M5
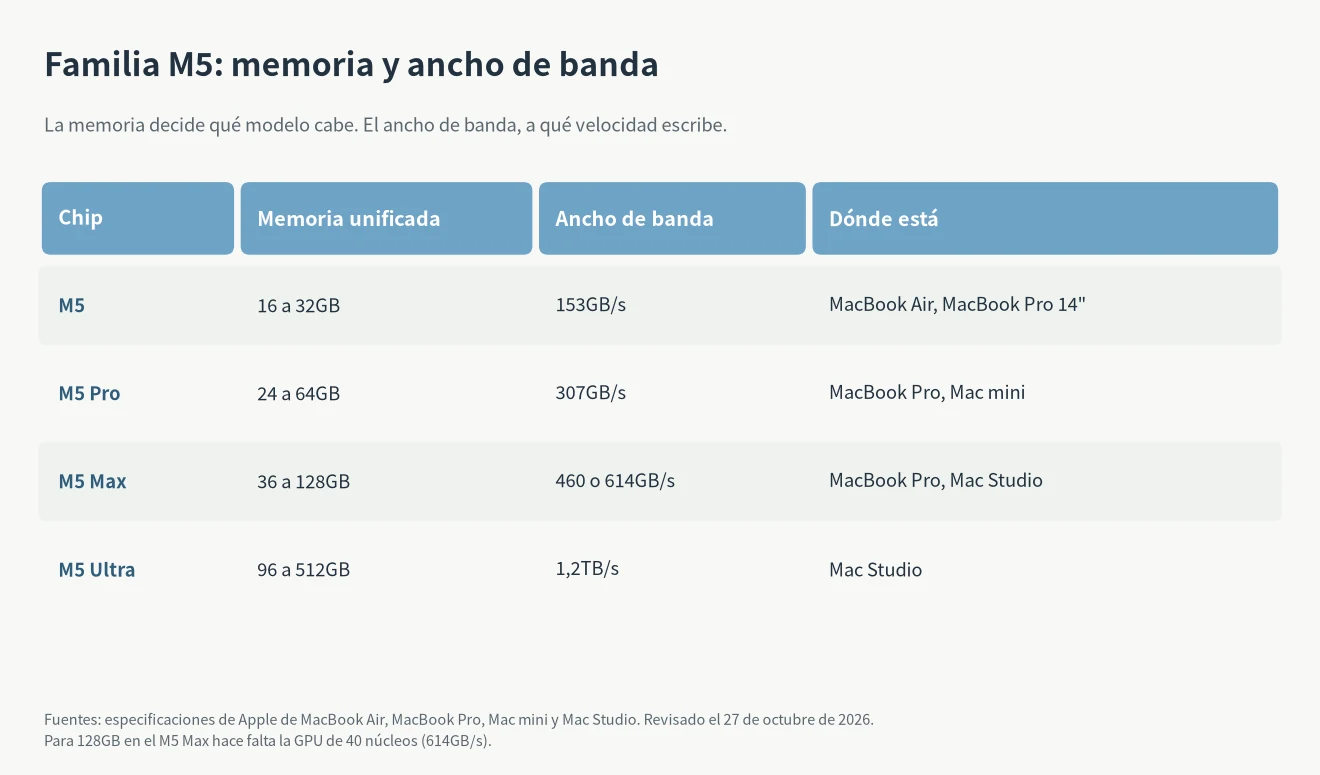
En un Mac la CPU y la GPU comparten una sola memoria unificada, y la GPU lee los pesos del modelo directamente de ahí. Por eso lo primero es mirar cuánta hay. El M5 llega a 32GB. El M5 Pro llega a 64GB con 307GB/s. El M5 Max llega a 128GB con 460 o 614GB/s (nota de prensa de Apple). El M5 Ultra solo está en el Mac Studio, empieza en 96GB y llega a 512GB con 1,2TB/s.
Un detalle que se pasa por alto: el M5 Max necesita la GPU de 40 núcleos para tener 128GB; la versión de 32 núcleos viene fija con 36GB (especificaciones del MacBook Pro). Además, el Mac mini de entrada ya usa el M6, así que para un Mac mini de la familia M5 hay que elegir el modelo con M5 Pro (especificaciones del Mac mini).
Qué tamaño de modelo cabe
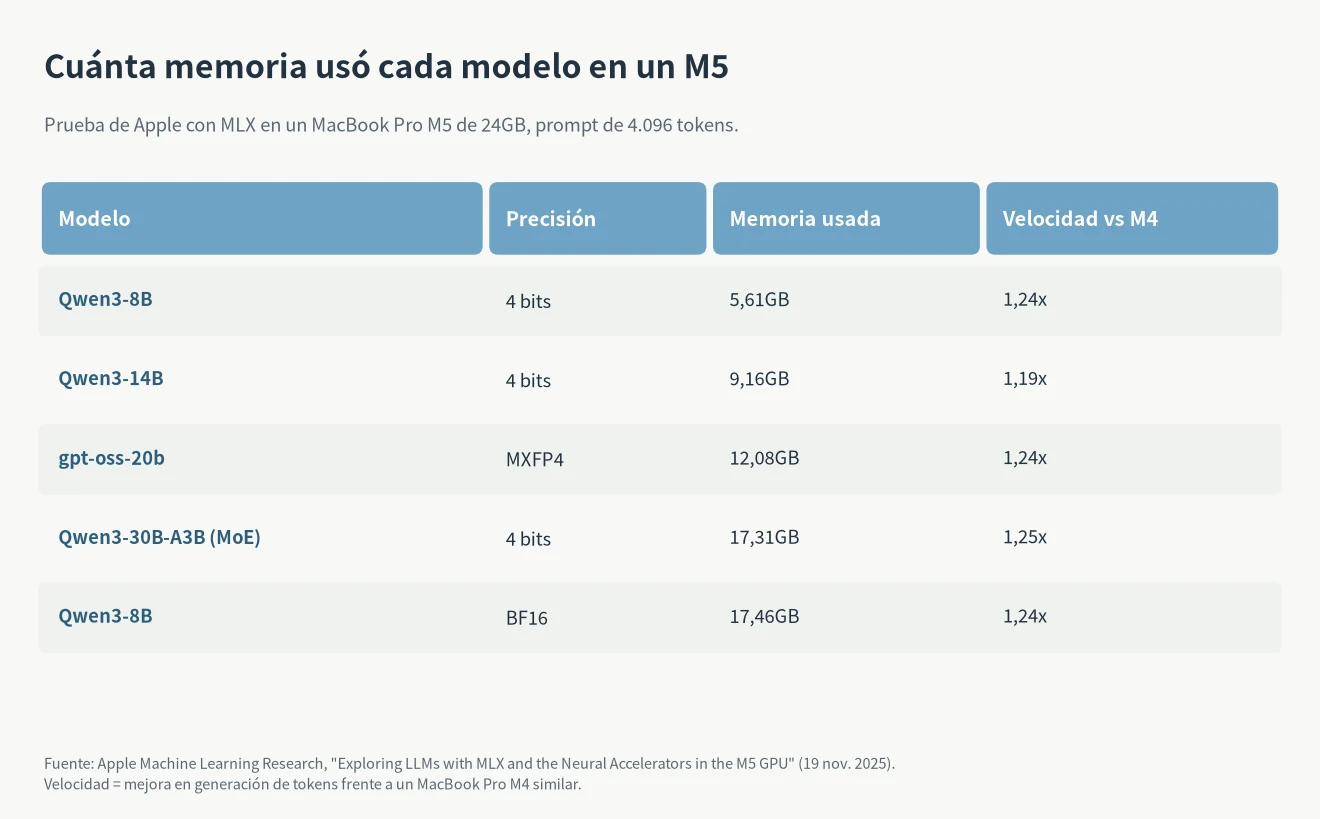
Apple probó seis modelos con MLX en un MacBook Pro M5 de 24GB. Qwen3-14B en 4 bits usó 9,16GB. Qwen3-30B-A3B en 4 bits usó 17,31GB. Qwen3-8B en BF16 completo usó 17,46GB. Según Apple, el equipo de 24GB puede con un modelo de 8B en BF16 o un MoE de 30B en 4 bits, y los dos quedan por debajo de 18GB (prueba de Apple con MLX).
Haciendo la cuenta con esa tabla, en 4 bits cada mil millones de parámetros ocupa entre 0,65 y 0,7GB. Con esa proporción, un modelo de 70B en 4 bits necesita más de 45GB antes de sumar el sistema y el contexto, así que 32GB no alcanzan y 64GB es el punto de partida. Es una estimación; según el formato de cuantización puede variar unos GB.
Por cantidad de memoria:
- 16GB: modelos de 8B a 14B en 4 bits. Sirve para probar modelos locales.
- 24 a 32GB: gpt-oss-20b y Qwen3-30B-A3B. Aquí empiezan a caber los MoE de 30B.
- 64GB: un modelo de 70B en 4 bits, o contextos más largos para modelos de 30B.
- 128GB o más: modelos MoE de más de 100B, o varios modelos a la vez. Solo lo ofrecen el M5 Max y el M5 Ultra.
Velocidad: la generación sigue al ancho de banda
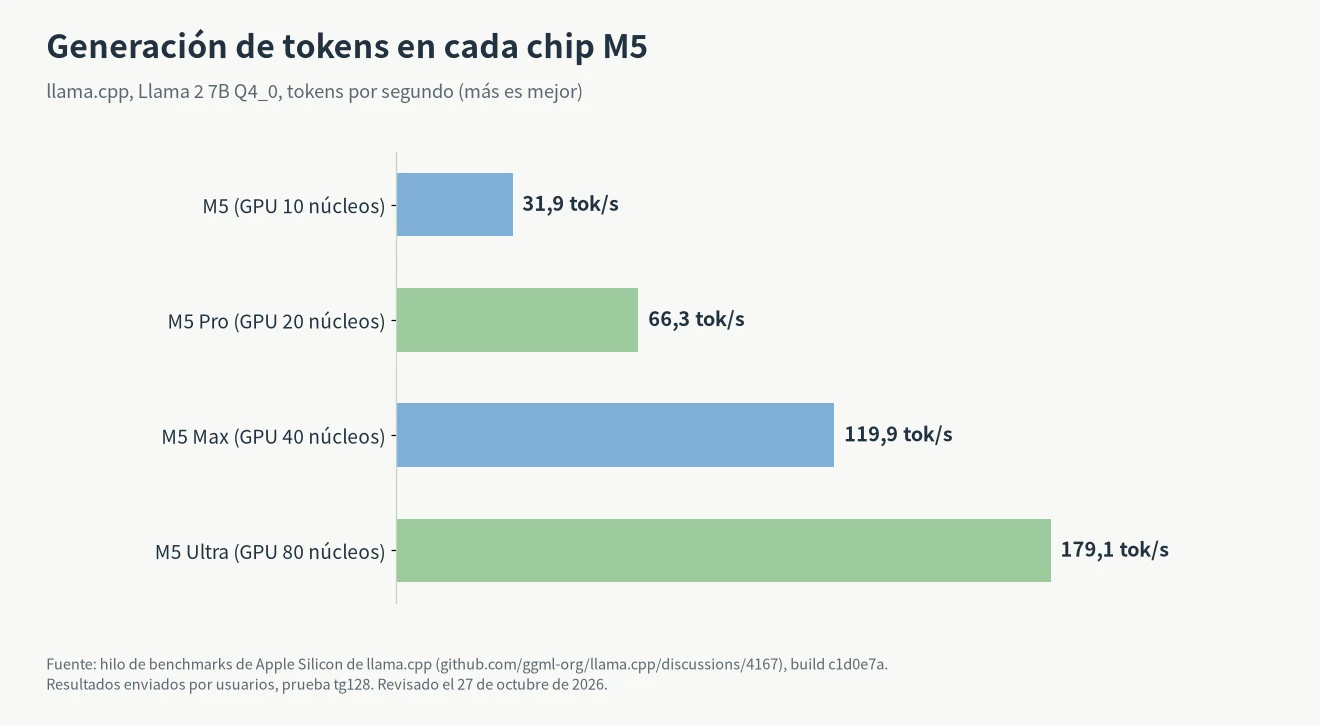
Cada token nuevo obliga a leer otra vez los pesos del modelo, así que la velocidad de generación depende sobre todo del ancho de banda. Apple dice lo mismo: el M5 tiene 153GB/s frente a 120GB/s del M4, un 28% más, y genera entre un 19% y un 27% más rápido (prueba de Apple con MLX).
En el hilo de benchmarks de llama.cpp, el mismo Llama 2 7B Q4_0 genera 31,9 tokens por segundo en un M5 base, 66,3 en un M5 Pro, 119,9 en un M5 Max y 179,1 en un M5 Ultra (benchmarks de llama.cpp). Al doblar el ancho de banda, la velocidad casi se dobla. Son resultados enviados por usuarios, no de Apple.
Leer el prompt es otra cosa y depende del cómputo. Cada núcleo de GPU del M5 tiene un Neural Accelerator. En la prueba de Apple el primer token llegó entre 3,3 y 4 veces antes que en el M4: menos de 10 segundos con un modelo denso de 14B y menos de 3 segundos con un MoE de 30B. Si le pasas documentos largos o mucho código, esta mejora pesa más que la velocidad de generación.
Con qué ejecutarlos
Lo más sencillo es MLX, el framework de código abierto de Apple. Se instala con pip install mlx-lm y con mlx_lm.chat ya puedes chatear. Ejecuta la mayoría de los LLM de Hugging Face (mlx-lm en GitHub). Para usar los Neural Accelerators del M5 hace falta macOS 26.2 o posterior (prueba de Apple con MLX).
llama.cpp y las herramientas basadas en él también corren en la GPU del M5 con Metal; las velocidades de arriba se midieron con él. Prueba los dos y quédate con el que te resulte más cómodo.
Qué Mac con M5 comprar
- Solo para probar modelos locales o escribir: un MacBook Air M5 de 16GB o 24GB basta.
- Para programar en local: 32GB como mínimo, mejor un M5 Pro de 64GB. Para elegir modelos, mira LLM locales para programar.
- Modelos de 70B o más: un M5 Max de 128GB o un Mac Studio con M5 Ultra.
En 128GB también hay opciones fuera de Apple; comparé los mini PC de AMD y NVIDIA en AI Max 395 vs DGX Spark. Apple además tiene un evento el 28 de octubre (hora del Pacífico); si dudas cuándo comprar, mira comprar un Mac ahora o esperar.
M5 frente a M6 para LLM locales
Para LLM locales, el M6 no sube el límite de tamaño de modelo. El MacBook Pro de 14 pulgadas con M6 empieza en 16GB de memoria unificada y se puede configurar hasta 32GB, el mismo techo que el M5 base (nota de prensa de Apple). El ancho de banda llega a 170GB/s frente a los 153GB/s del M5, pero solo en las configuraciones de 24GB y 32GB; la de 16GB se queda en 153GB/s (especificaciones del MacBook Pro). Apple dice que el MacBook Pro con M6 es hasta un 25% más rápido que el M5 en tareas de IA en el dispositivo, como el procesamiento del prompt de un LLM. La cifra de “5 veces más rápido” es del nuevo iMac y se mide frente al M4, con el procesamiento del prompt en LM Studio, no frente al M5 (nota de prensa del iMac). Los mismos modelos irán algo más rápido en un M6, pero para modelos de 70B, que necesitan 64GB o más, sigue haciendo falta un M5 Pro o un M5 Max.
Preguntas frecuentes
¿Cuánta memoria necesita un M5 para LLM locales?
Con 16GB funcionan modelos de 8B a 14B en 4 bits, con 32GB entran los MoE de 30B y para 70B hacen falta 64GB o más. En la prueba de Apple, Qwen3-14B en 4 bits usó 9,16GB, y un equipo de 16GB también tiene que dejar memoria para macOS y tus otras apps.
¿Cuánto más rápido es el M5 que el M4 con LLM?
Genera entre un 19% y un 27% más rápido y el primer token llega entre 3,3 y 4 veces antes, según la prueba de Apple con MLX en dos MacBook Pro de configuración parecida.
¿M5 Pro o M5 Max?
Depende de si necesitas más de 64GB. El M5 Pro llega a 64GB; el M5 Max llega a 128GB con el doble de ancho de banda y genera casi el doble de rápido.