

本地大模型写代码选哪个?2026 年模型和硬件对照,附显存账和实测速度
本地大模型写代码,2026 年按内存挑模型:16GB 显卡用 gpt-oss-20b,24GB 用 Qwen3.8-27B,64GB 用 Qwen3-Coder-Next。附 64K 上下文的显存账、有出处的速度、Ollama 接 Claude Code 的步骤,以及什么时候订阅更划算。
 buffer关于作者约 7 分钟阅读
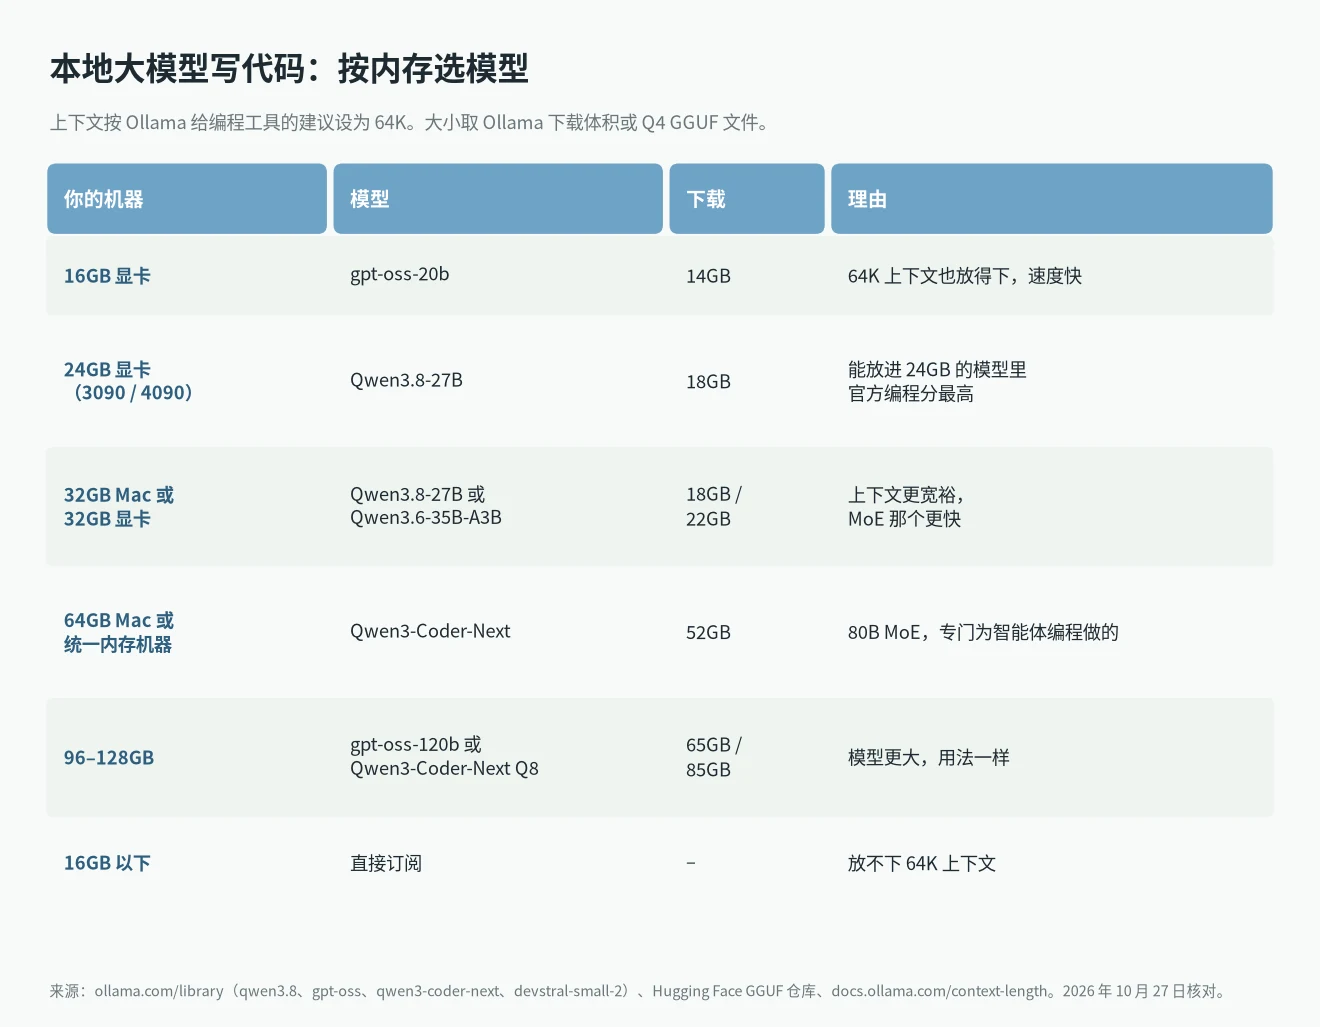
本地大模型写代码,先看你有多少内存。16GB 显卡跑 gpt-oss-20b。3090、4090 这类 24GB 显卡跑 Qwen3.8-27B。64GB 的 Mac 或统一内存机器跑 Qwen3-Coder-Next。内存不到 16GB,直接订阅 20 美元一个月的服务更划算。上下文至少开到 64K,编程智能体需要这么多,而 Ollama 的默认值比这小。下面的数字我都在北京时间 2026 年 10 月 27 日核对过,每个都附了出处。
结论:你的机器该跑哪个
- 16GB 显卡:gpt-oss-20b。官方模型卡写明 16GB 内能跑。按我的算法,64K 上下文大约要 14.3 GiB。
- 24GB 显卡(RTX 3090、RTX 4090):Qwen3.8-27B 的 Q4_K_M。64K 上下文大约 20.8 GiB,放得下,还剩一点余量。
- 32GB Mac 或 32GB 显卡:Qwen3.8-27B 开更长的上下文,或者换 Qwen3.6-35B-A3B。后者每个 token 只激活 3B 参数,速度更快。
- 64GB Mac 或统一内存机器:Qwen3-Coder-Next。80B 的 MoE 模型,激活 3B,专门为编程智能体做的。64K 上下文大约 48 GiB。
- 96 到 128GB:gpt-oss-120b,64K 上下文大约 62.8 GiB;或者 Qwen3-Coder-Next 的 Q8。
- 16GB 以下:做智能体式编程我不建议折腾。模型和 64K 上下文放不到一起。
如果你只是想知道 24GB 显卡还能跑什么,我在RTX 4090 能跑多大模型里写过。这篇只讲写代码。
为什么 64K 上下文这么重要
Claude Code 这类工具每次请求都会带很多内容:系统提示词、工具定义、读过的文件,还有之前的对话。Ollama 的上下文长度文档写明,智能体、编程工具这类任务至少要设到 64,000 token。Claude Code 接入文档也是同样的要求:选好模型,上下文设到 64K 以上。
问题出在 Ollama 的默认值。同一页文档写着:显存小于 24 GiB 默认 4K,24 到 48 GiB 默认 32K,48 GiB 以上才是 256K。所以 16GB 和 24GB 显卡用默认值跑编程智能体,上下文是不够的,要自己调大:
OLLAMA_CONTEXT_LENGTH=64000 ollama serve本地大模型写代码,KV cache 占多少内存
上下文越长,KV cache 越大。我按每个模型的 config.json 算:每个 token 占 2 × 全注意力层数 × KV 头数 × 头维度 × 2 字节。混合注意力的模型只算全注意力层,所以有的模型占得很少。
- Qwen3.8-27B:64 层里有 16 层是全注意力,4 个 KV 头。每个 token 64 KiB,64K 上下文 4 GiB。
- Devstral Small 2 24B:40 层全注意力,8 个 KV 头。每个 token 160 KiB,64K 上下文 10 GiB。
- gpt-oss-20b 和 Qwen3-Coder-Next:每个 token 都是 24 KiB 左右,64K 上下文 1.5 GiB。
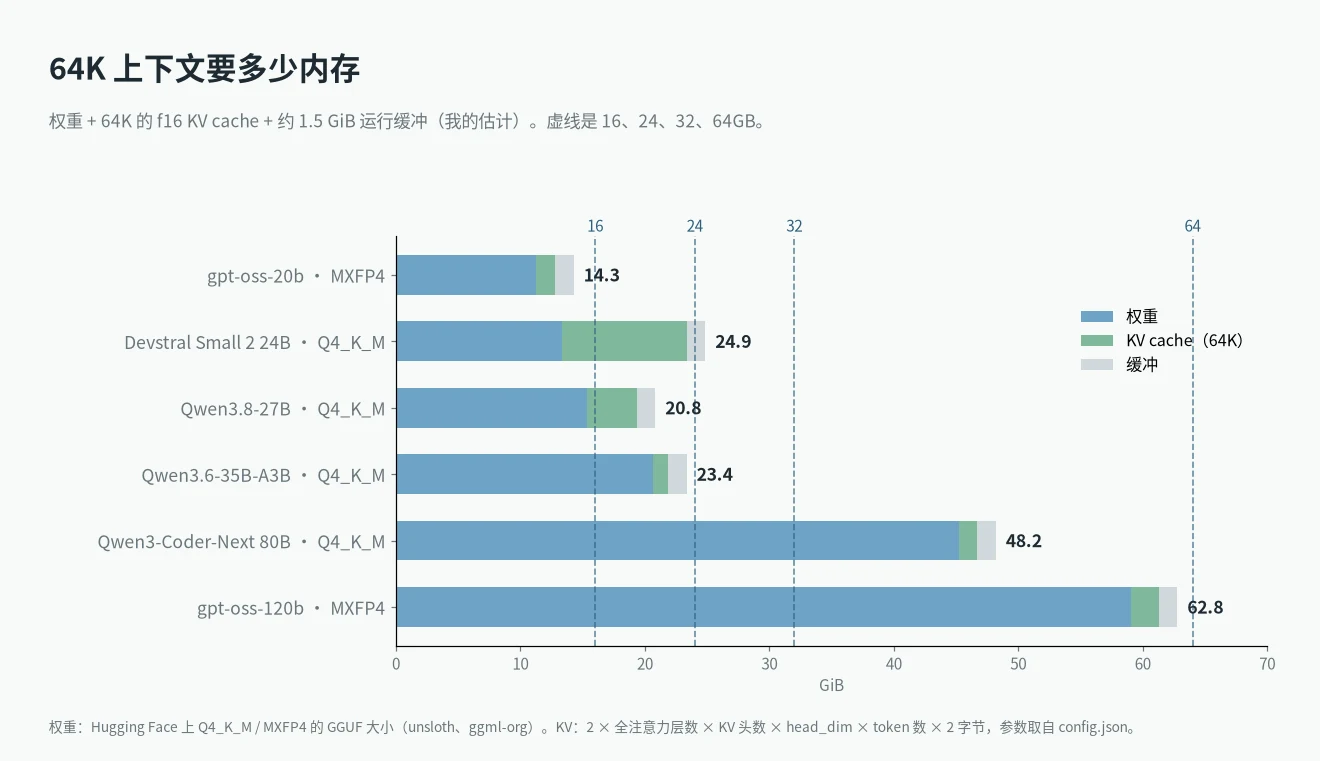
所以 Devstral Small 2 的文件虽然只有 13.35 GiB,实际却不好塞。64K 上下文合计大约 24.9 GiB,比 24GB 显卡多一点。Ollama 可以把 KV cache 存成 8 位,占用减半。Ollama FAQ 里有 OLLAMA_KV_CACHE_TYPE 这个设置,需要先开 flash attention。改成 q8_0 后,我估计合计大约 19.9 GiB。
这些合计都是我的估算:文件大小加 f16 的 KV cache,再加约 1.5 GiB 缓冲。实际使用可能差一两 GB。
2026 年本地大模型写代码值得试的模型
Qwen3.8-27B:24GB 显卡的首选
Qwen3.8-27B 在 2026 年 8 月 5 日发布,27B 稠密模型,原生上下文 262,144 token。它的 Hugging Face 模型卡上,SWE-bench Pro 是 61.7,测试用的是 Claude Code 框架、256K 上下文。Terminal Bench 2.1 是 73.0,LiveCodeBench v6 是 90.3。同一张卡上 Qwen3.6-27B 的 SWE-bench Pro 是 53.5。模型卡没有给 3.8 的 SWE-bench Verified 成绩。
unsloth 的 GGUF 在 UD-Q4_K_M 是 15.33 GiB。Q8_0 是 27.05 GiB,要 32GB 显卡或更大的 Mac。Ollama 模型库里 27B 的下载是 18GB,还有给 Apple 芯片用的 MLX 版本。
Qwen3.6-27B 和 Qwen3.6-35B-A3B
上一代 Qwen3.6-27B 的 SWE-bench Verified 是 77.2。MoE 版 Qwen3.6-35B-A3B 是 73.4。MoE 只激活 3B 参数,生成速度比 27B 稠密模型快。它的 Q4_K_M 文件 20.61 GiB,64K 上下文合计约 23.4 GiB。在 24GB 显卡上很紧,在 32GB 上很轻松。
Devstral Small 2 24B
Mistral 的 Devstral Small 2 在 SWE-bench Verified 上是 68.0%,Terminal Bench 2 是 22.5%。许可证是 Apache 2.0,模型卡说一张 RTX 4090 或 32GB 的 Mac 就能跑。KV cache 的问题看上面那段。
Qwen3-Coder-Next:给 64GB 机器
Qwen3-Coder-Next 在 2026 年 1 月 30 日发布。总参数 80B,激活 3B,上下文 256K。模型卡写明能配合 Claude Code、Qwen Code 和 Cline 使用。Qwen 官方 GGUF 的 Q4_K_M 是 45.09 GiB,Q8_0 是 78.99 GiB。Ollama 上标的是 52GB。
gpt-oss-20b 和 gpt-oss-120b
OpenAI 的 gpt-oss-20b 有 21B 参数,激活 3.6B,上下文 131,072 token,MXFP4 文件 11.28 GiB。更大的 gpt-oss-120b 有 117B 参数,激活 5.1B,一张 80GB 显卡放得下,文件 59.03 GiB。
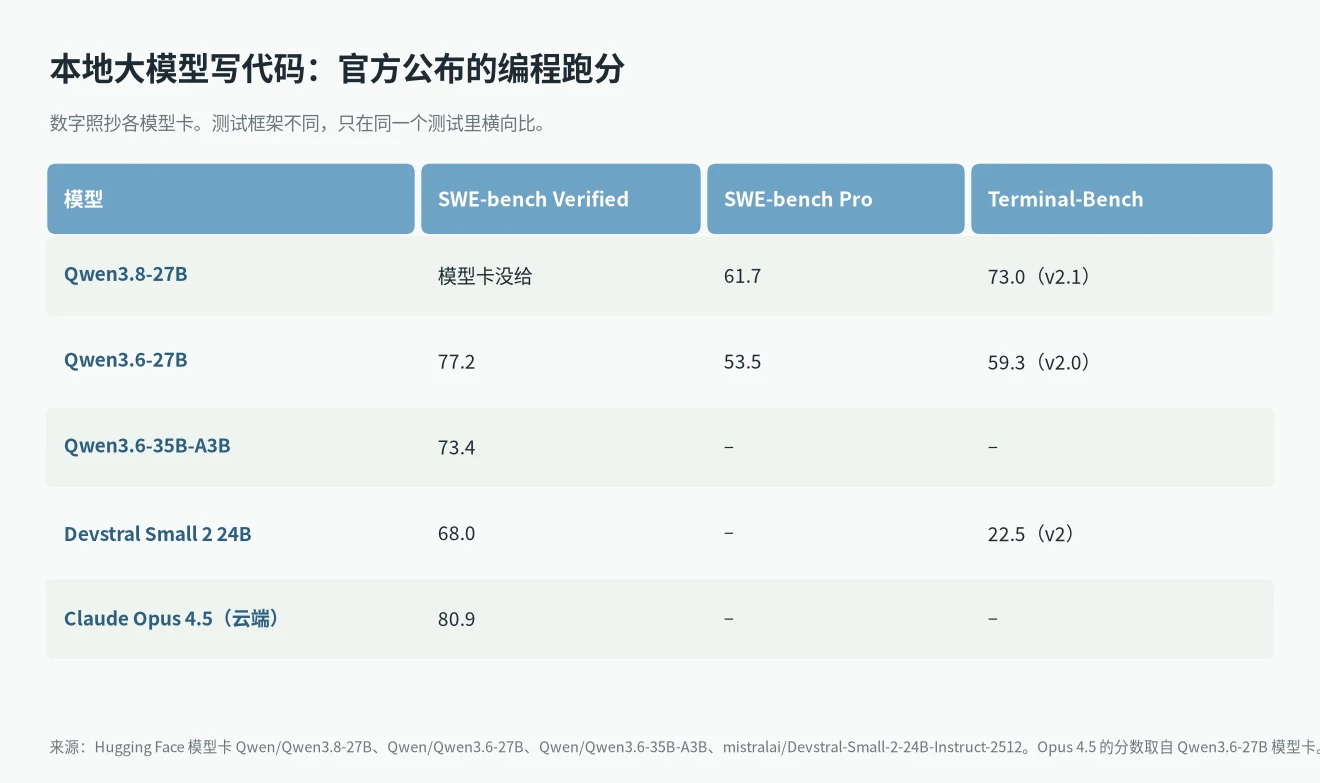
关于这些分数要说明一下。每家用自己的测试环境,两张卡差 3 分说明不了太多。可以参考的是最强的云端模型:Qwen3.6-27B 的模型卡上列了 Claude Opus 4.5,SWE-bench Verified 80.9。最好的本地模型在纸面上已经很接近。日常用下来,长而乱的任务还是云端模型处理得更好。
本地大模型写代码有多快
这里只用实测数据。Qwen3.8-27B 的 Q4_K_M 用 llama.cpp 跑,llm-speed 记录的 RTX 4090 是每秒 43 到 44 token,最好一次 44.2。8K 上下文时显存峰值 18.7 GiB。模型页上 RTX 3090 是 38.61 tok/s,RTX 5090 是 75.19 tok/s,不过 5090 那次用的是旧版本。有一次社区提交的测试开了 MTP 投机解码,4090 跑到 84.5 tok/s,见 llm-speed 这篇文章。
gpt-oss-20b 的数据来自 Hardware Corner:RTX 4090 在 4K 上下文是 190.6 tok/s。上下文越长越慢,64K 是 104.0 tok/s,128K 是 70.3 tok/s。
Qwen3-Coder-Next 我没找到可信来源的实测速度,所以这里不给数字。
在考虑 32GB 显卡的话,可以看RTX 5090 显存够跑什么。128GB 的机器,我比较过 AI Max+ 395 和 DGX Spark。
用 Ollama 接 Claude Code
按 Ollama 的发布说明,0.15 版加了 ollama launch。一条命令就能配好编程工具,并指向本地模型:
ollama pull qwen3.8
ollama launch claude --model qwen3.8
OpenCode 和 OpenClaw 也一样。OpenClaw 文档同样要求本地模型至少 64K 上下文。
ollama launch opencode --model qwen3.8
ollama launch openclaw --model qwen3.8
如果想自己启动 Claude Code,Ollama 从 0.14.0 开始提供兼容 Anthropic 的接口,见 Ollama 关于 Claude Code 的文章:
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_BASE_URL=http://localhost:11434
claude --model qwen3.8
记得先用 64K 上下文启动 Ollama。如果 Claude Code 找不到之前读过的文件,或者开始重复自己,我第一个会查上下文是不是太小。
本地还是订阅:算钱
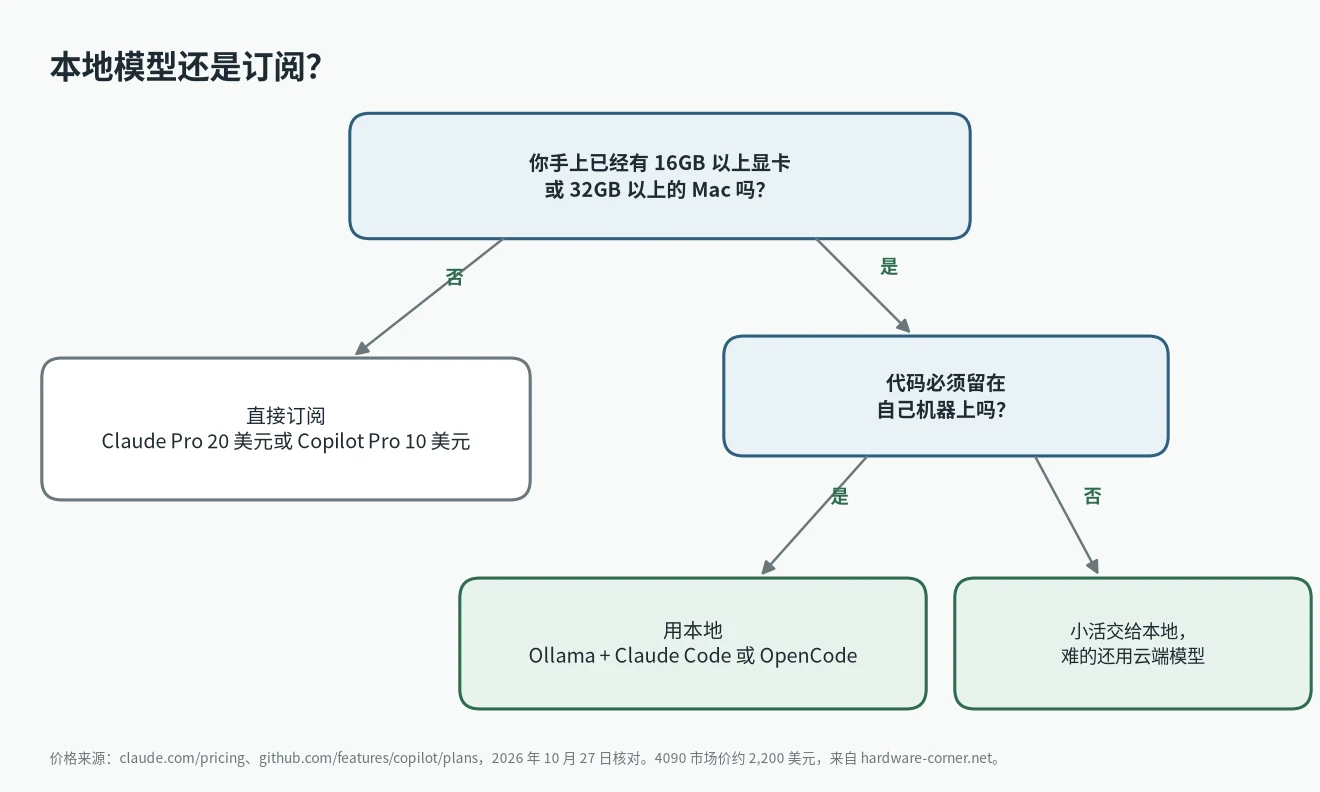
Claude Pro 每月 20 美元,按年付是每月 17 美元,包含 Claude Code。GitHub Copilot Pro 每月 10 美元。Hardware Corner 给的 RTX 4090 平均市场价是 2,200 美元,相当于 110 个月的 Claude Pro。
所以我不建议专门为本地大模型写代码去买显卡。已经有硬件、代码不能出本机、或者需要离线干活,这几种情况才值得。付费方案的对比,我写过 Claude Code 和 Codex 该买哪个,以及 AI 订阅怎么选。
我的建议
- 手上有 3090 或 4090,今天就可以装 Qwen3.8-27B,开 64K 上下文试试,不花钱。
- 16GB 显卡用 gpt-oss-20b 做小改动、问问题就好,别指望它做大重构。
- 打算为这个买 Mac 的话,64GB 才能跑 Qwen3-Coder-Next。什么时候买,可以看 Mac 现在买还是等。
- 难的任务留给云端模型。很多人日常活用本地模型,卡住了再切换。
常见问题
24GB 显卡用本地大模型写代码选哪个?
Qwen3.8-27B 的 Q4_K_M。按我的估算,64K 上下文大约 20.8 GiB,在放得下的模型里官方编程分最高。
Claude Code 能接本地模型吗?
能。Ollama 0.14.0 以后支持 Anthropic 接口,0.15 以后用 ollama launch claude --model qwen3.8 一步就能配好。
16GB 显存够吗?
跑 gpt-oss-20b 够。官方模型卡写明 16GB 内能跑,我估算 64K 上下文大约 14.3 GiB。更大的编程模型放不下够用的上下文。
本地模型能比得上 Claude 吗?
纸面差距比以前小:Claude Opus 4.5 的 SWE-bench Verified 是 80.9,Qwen3.6-27B 是 77.2。不过两者测试环境不同,只能当大致参考。