

AI Max 395 和 DGX Spark 怎么选?128GB 本地大模型主机哪台最值得买(2026 年 10 月)
AI Max 395 和 DGX Spark 怎么选?用 llama.cpp 实测数据对比:生成速度接近,DGX Spark 读提示词快 2 到 5 倍,AMD 主机每 GB 内存便宜一半。价格为 2026 年 10 月数据。
 buffer关于作者约 8 分钟阅读
AI Max 395 和 DGX Spark 怎么选,先看你主要拿它做什么:如果是聊天、写代码这类短提示词的场景,买 AI Max+ 395 主机;如果要喂长文档、跑 CUDA 软件,买 DGX Spark。两台都是 128GB 统一内存,带宽也差不多,一个 256 GB/s,一个 273 GB/s,所以生成速度接近。DGX Spark 读提示词快 2 到 5 倍,还能直接用 NVIDIA 的 CUDA 软件。价格差了一倍:2026 年 10 月,GMKtec EVO-X2 128GB 版 3500 美元,DGX Spark 在 NVIDIA 官方商店是 6950 美元。
我的建议是:平时用 llama.cpp、Ollama 或 LM Studio 聊天、辅助写代码,自己掏钱,选 AI Max+ 395 主机。工作离不开 CUDA、vLLM 或 TensorRT-LLM,每天要处理很长的文档,或者打算两台机器连起来用,选 DGX Spark。
这篇写于 2026 年 10 月 27 日。今年内存缺货,两边都涨了好几次价,所以下面每个价格都标了日期和来源。文中的“AI Max 395”指 Ryzen AI Max+ 395 芯片(代号 Strix Halo)的 128GB 版本。
AI Max 395 和 DGX Spark 参数对比
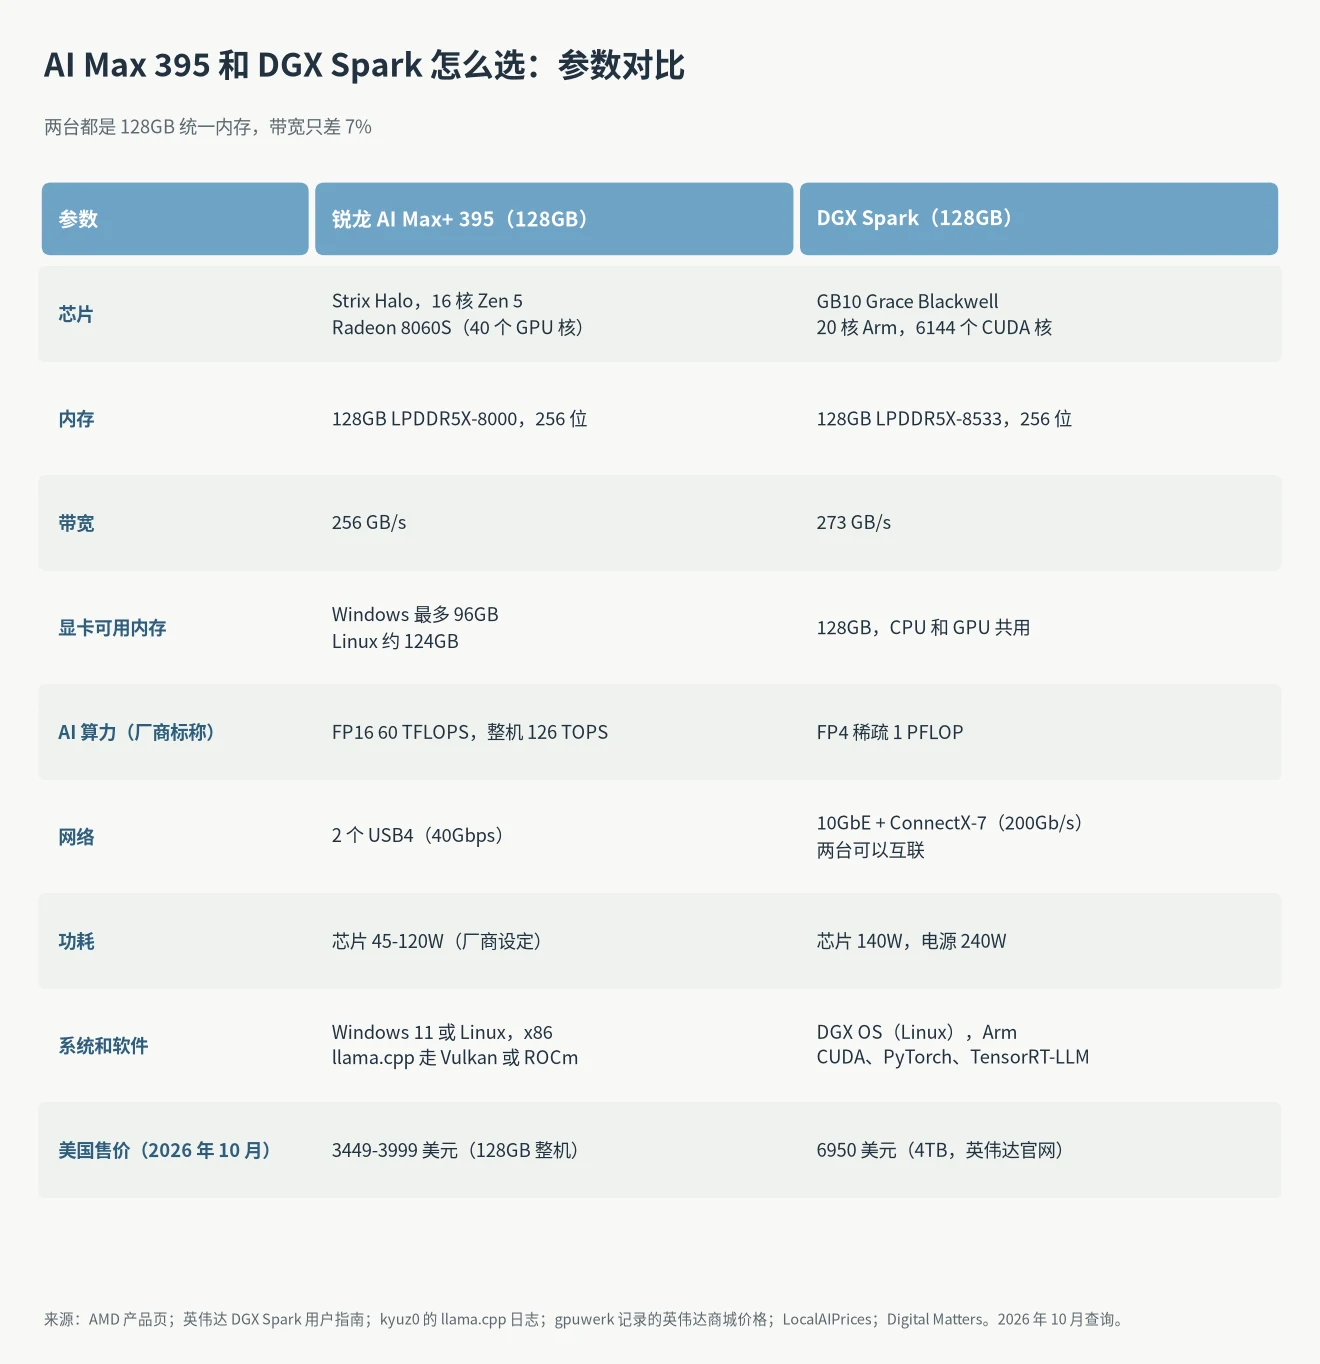
纸面上两台很像。都是 128GB LPDDR5X,256 位总线,CPU 和 GPU 共用。NVIDIA 给 DGX Spark 标的带宽是 273 GB/s(NVIDIA DGX Spark 用户指南)。AMD 给 Ryzen AI Max+ 395 标的是 LPDDR5X-8000、256 位(AMD 产品页),算下来 256 GB/s,差 7%。
真正的差别在下面几项:
- 算力:NVIDIA 标 GB10 芯片 FP4 稀疏算力 1 PFLOP,AMD 标 AI Max+ 395 的 FP16 是 60 TFLOPS,总算力 126 TOPS。两个数字的精度格式不同,不能直接相除。能确定的是 DGX Spark 读提示词时算力多很多。
- GPU 能用多少内存:Windows 下,AMD 驱动最多让 GPU 用 128GB 里的 96GB(AMD,2025 年 7 月 29 日)。Linux 下 GPU 能看到约 124GB,一份 Strix Halo 测试日志显示显存为 126976 MiB(kyuz0 日志)。DGX Spark 的 128GB 是一整块,和系统共用。
- 网络:DGX Spark 带 ConnectX-7 网卡,两个 QSFP 口,最高 200Gb/s,两台可以连起来当一台用。AMD 芯片有两个 40Gbps 的 USB4 口。
- 功耗:GB10 芯片 TDP 140W,整机配 240W 电源。AI Max+ 395 在 45W 到 120W 之间,具体看主机厂商怎么设。
2026 年 10 月价格和每 GB 单价
DGX Spark:首发 3999 美元,现在 6950 美元
DGX Spark 在 2025 年 10 月 15 日首发,价格 3999 美元。2026 年 2 月 23 日,NVIDIA 以内存供应为由涨到 4699 美元。根据 gpuwerk 的价格记录(2026 年 10 月 11 日查询),NVIDIA 官方商店现在的 128GB、4TB 创始版标价 6950 美元,Tech Insider 报的也是这个数。
现在还多了一个 64GB 版。NVIDIA 在 2026 年 10 月 2 日宣布,10 月 23 日起由合作厂商销售,起价 4999 美元(NVIDIA 博客),官方说能跑 1000 亿参数以内的模型。算下来每 GB 78 美元,是这次对比里最贵的。
AI Max+ 395 主机:3449 到 3999 美元
卖 128GB Ryzen AI Max+ 395 迷你主机的品牌很多。GMKtec EVO-X2 128GB 加 1TB 固态,美国售价 3500 美元,2026 年 10 月 27 日查询(LocalAIPrices)。Digital Matters 列出的铭凡 MS-S1 Max 128GB 是 3799 美元,AMD 自家 2026 年 6 月推出的 Ryzen AI Halo 128GB 是 3999 美元(Digital Matters)。
Framework Desktop 最能说明价格涨得多快。它发布时 128GB 版 1999 美元,2026 年 1 月因为内存成本涨到 2459 美元(The Verge),Digital Matters 现在列的是 3449 美元,而且缺货。内存为什么一直涨,可以看我写的DDR4 和 DDR5 价格倒挂。
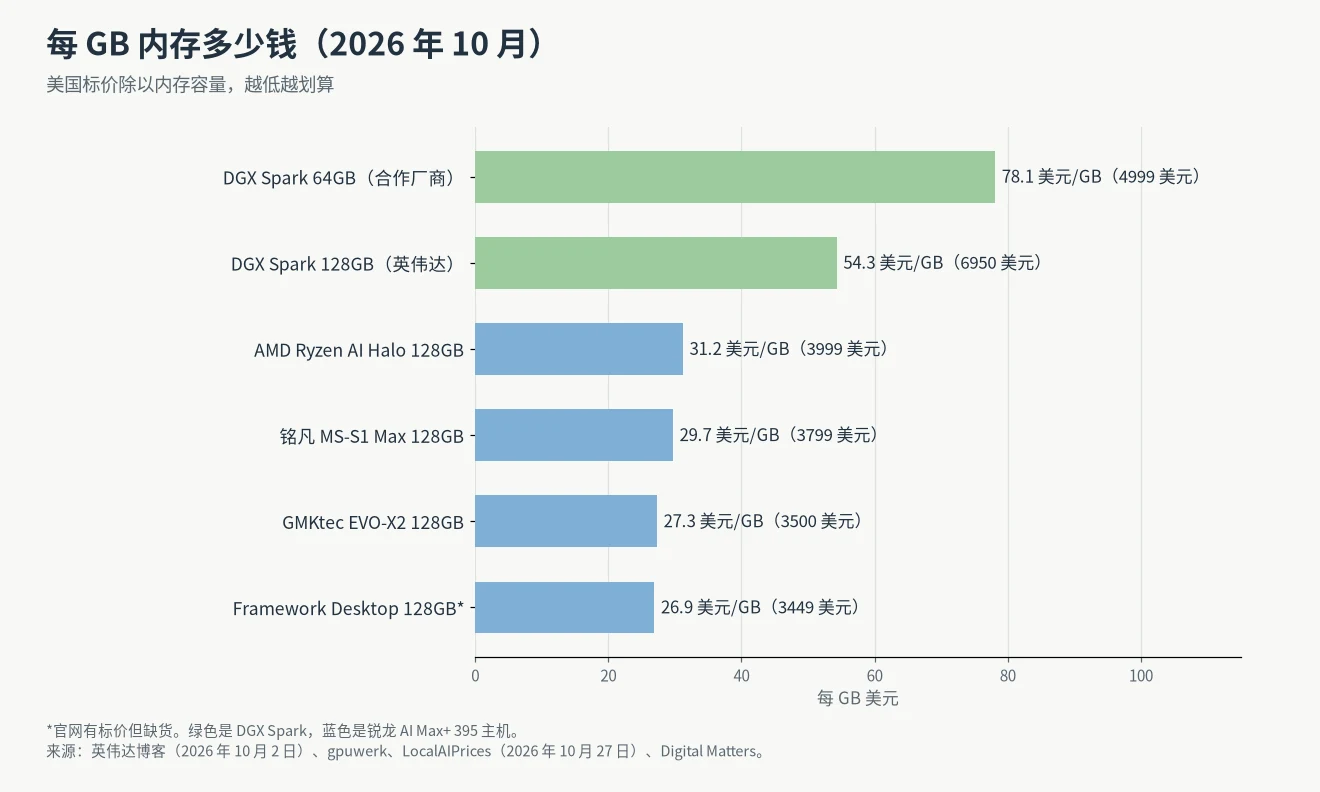
按每 GB 内存算,128GB 的 AI Max+ 395 主机是 27 到 31 美元,128GB 的 DGX Spark 是 54 美元。如果你买的主要是内存容量,AMD 这边同样的钱能买到约两倍。
实测速度:gpt-oss-120b 跑多少 tok/s
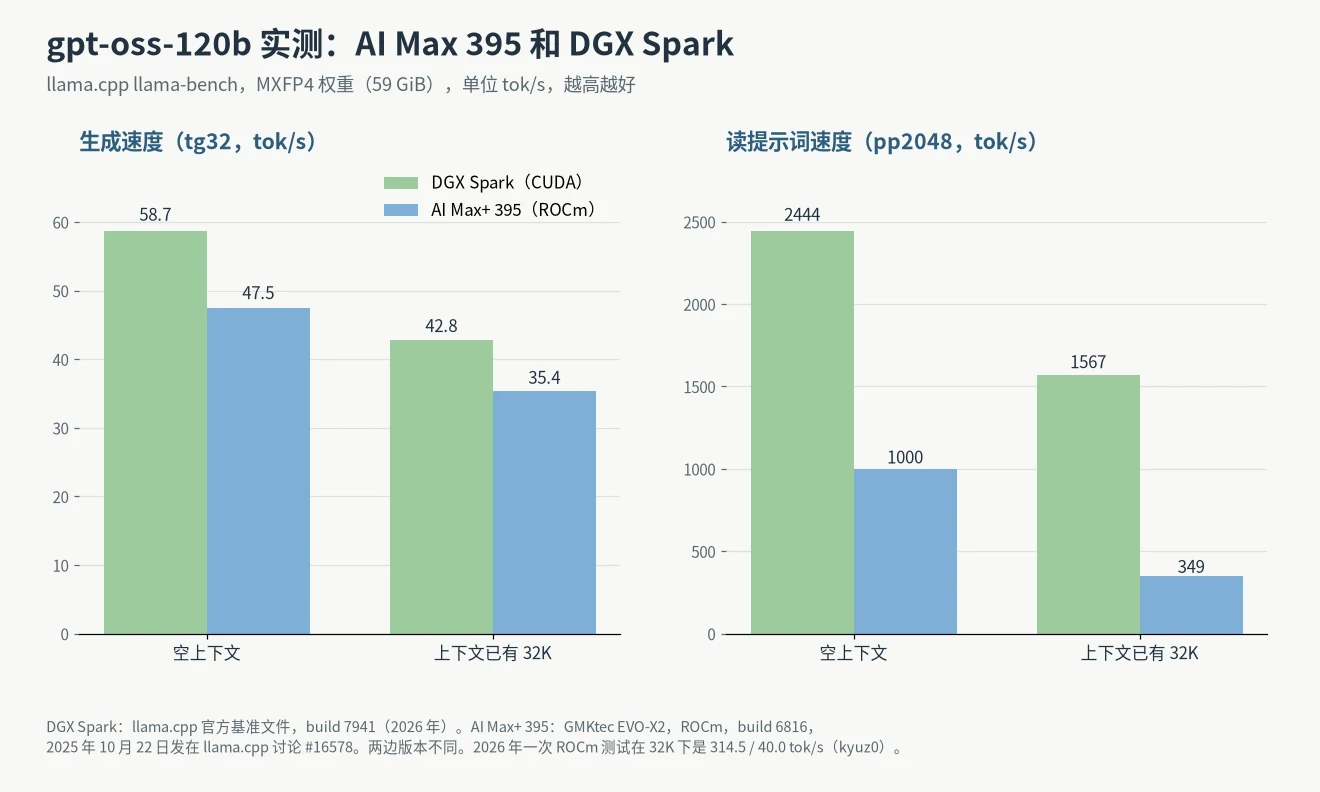
我找到最干净的对比是 gpt-oss-120b。这是一个 1170 亿参数的混合专家(MoE)模型,MXFP4 格式占 59 GiB,两台都装得下,还能留出上下文空间。下面的数字都来自 llama.cpp 自带的 llama-bench 工具。pp2048 是读 2048 个 token 提示词的速度,tg32 是生成新 token 的速度。
生成速度差不多
空上下文时,llama.cpp 官方测试文件里 DGX Spark 生成速度是 58.7 tok/s(llama.cpp DGX Spark 测试)。2025 年 10 月 22 日,llama.cpp 讨论区 #16578 里有人用 ROCm 测了装 AI Max+ 395 的 GMKtec EVO-X2,是 47.5 tok/s(GitHub)。上下文已有 32K token 时,两边分别是 42.8 和 35.4 tok/s。
这两组数字用的 llama.cpp 版本不同。同一篇帖子里,作者还用和 AMD 主机相同的版本测了 DGX Spark,生成速度 45.9 tok/s,比 AMD 略慢。之后软件更新让 Spark 跑到了前面。不管看哪组,生成速度差距都在 25% 以内,和带宽只差 7% 是对得上的。
读提示词是 DGX Spark 的优势
读提示词主要看算力,这一项 Spark 领先很多。空上下文 2444 tok/s,32K 时 1567 tok/s。2025 年 10 月那篇帖子里 AMD 主机是 1000 和 349 tok/s。2026 年一组更新的 ROCm 测试里,Strix Halo 在 32K 时是 314.5 tok/s(kyuz0)。也就是短提示词 Spark 快约 2.4 倍,长提示词快 4 到 5 倍。
实际用起来,差别体现在等待时间上。一段 3 万 token 的提示词,Spark 大约 20 秒读完,AMD 主机要一分多钟,然后才开始出第一个字。短对话感觉不到,一次贴进整个代码库或者一份长 PDF 就很明显。
稠密模型两台都慢
MoE 模型每生成一个 token 只读一小部分参数,所以两台都跑得快。稠密模型就不一样了。LMSYS 测了 DGX Spark 跑 Llama 3.1 70B FP8,生成速度 2.7 tok/s(LMSYS,2025 年 10 月 13 日)。我没找到可信的 AI Max+ 395 同条件稠密 70B 数据,所以不给数字。它带宽还少 7%,我不认为会更快。
模型大小上限:128GB 能装下什么
NVIDIA 说单台 DGX Spark 能跑 2000 亿参数以内的模型,两台连起来能到 4050 亿,都是 FP4(NVIDIA)。AMD 说 AI Max+ 395 在 Windows 下、GPU 内存上限 96GB 时,能跑 1280 亿参数以内的模型(AMD)。Linux 下 AMD 的 GPU 能用更多内存,实际上限和 Spark 接近。
举几个实际例子。59 GiB 的 gpt-oss-120b 两台都能跑,上面已经给了速度。Qwen3.5-122B-A10B 的 Q4 版也能装下,AI Max+ 395 生成速度 21 到 23 tok/s(Strix Halo 测试)。注意上下文也要占内存,模型本身占了 110GB 的话,两台都剩不下多少空间给长对话。
如果你在考虑 DeepSeek,满血版两台都装不下。哪个版本适合什么硬件,我在DeepSeek 本地部署硬件指南里写过。
软件生态:ROCm、Vulkan 和 CUDA
DGX Spark:CUDA 开箱即用
Spark 预装 DGX OS,这是 NVIDIA 基于 Ubuntu 的 Linux,自带 CUDA、Docker 和 NVIDIA 的 AI 软件。NVIDIA 列出支持 PyTorch 和 TensorRT-LLM。LMSYS 用现成的 Docker 镜像就在上面跑起了 SGLang(LMSYS)。大部分 AI 教程和研究代码默认用 CUDA,基本拿来就能跑。
有两点要注意。CPU 是 Arm 架构,不是 x86,有些 Python 包和 Docker 镜像需要 Arm 版本。另外它是一台 Linux 机器,不能装 Windows 软件,也不能打游戏。
AI Max+ 395:llama.cpp 加 Vulkan 或 ROCm
AMD 这边就是普通的 x86 电脑,能装 Windows 11 或 Linux,也能打游戏。跑本地大模型,大多数人用 llama.cpp 或者基于它的工具,比如 LM Studio 和 Ollama。llama.cpp 可以通过 Vulkan 或 AMD 的 ROCm 调用 GPU。
哪个更快要看模型。有一组覆盖两种后端的大规模测试显示,生成速度多数是 Vulkan 赢,读提示词则是 ROCm 和 AMD 的 Vulkan 驱动各有胜负(kyuz0 测试汇总)。建议两个都试一下。这边没有 CUDA,直接调用 CUDA 的代码跑不了,vLLM、TensorRT-LLM 这类工具也是先照顾 NVIDIA。
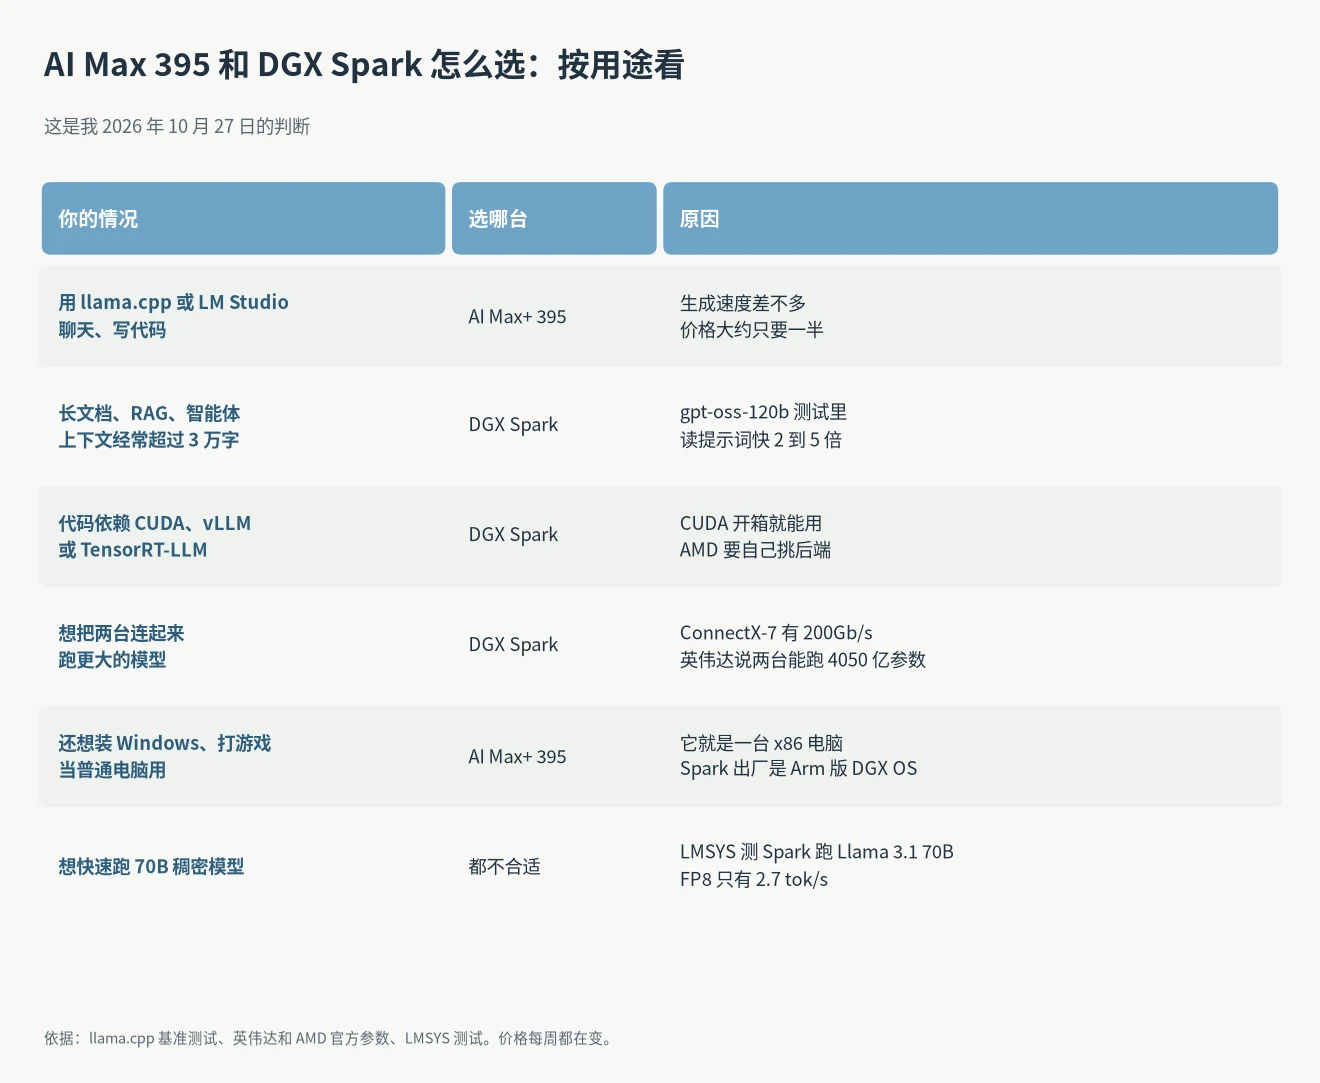
AI Max 395 和 DGX Spark 怎么选:按用途对号入座
这些情况买 AI Max+ 395 主机
- 主要用来聊天或辅助写代码,提示词在几千 token 以内。
- 用 llama.cpp、LM Studio 或 Ollama,不需要 CUDA。
- 想要一台既能跑模型、又能装 Windows 打游戏的电脑。
- 最看重每块钱买到的内存。每 GB 27 到 31 美元,约为 DGX Spark 的一半。
这些情况买 DGX Spark
- 要处理长文档、跑 RAG,或者用一次发 3 万 token 以上的编程智能体。
- 工作要用 CUDA、vLLM、SGLang 或 TensorRT-LLM,或者写的代码以后要部署到 NVIDIA 服务器上。
- 打算两台连起来跑 2000 亿参数以上的模型。
这些情况考虑别的方案
想要稠密 70B 模型跑得快,这两台都不行。独立显卡的带宽高好几倍,32GB 显存能装下什么,我在RTX 5090 显存与本地大模型里算过。如果你同时在看大内存的 Mac,可以先读Mac 现在买还是等等。
常见问题
DGX Spark 比 AI Max 395 快吗?
读提示词快,用 gpt-oss-120b 在 llama.cpp 里测是 2 到 5 倍。生成速度差距在 25% 以内,2025 年 10 月的一次同版本测试里 AMD 主机还略快一点。
AI Max 395 能跑 120B 模型吗?
能。公开测试里 gpt-oss-120b 约 47 tok/s,Qwen3.5-122B-A10B Q4 约 21 到 23 tok/s。Windows 下 GPU 最多用 96GB,跑大模型建议用 Linux。
DGX Spark 值 6950 美元吗?
只有在你需要 CUDA、需要快速读长提示词或者要两台互联时才值。用 llama.cpp 聊天和写代码,AI Max+ 395 主机生成速度差不多,价格约一半。
64GB 版 DGX Spark 值得买吗?
64GB 卖 4999 美元,每 GB 78 美元,比 128GB 版还贵。只有你需要 Spark 的软件,而且模型在 1000 亿参数以内时才考虑。
关于 AI Max 395 和 DGX Spark 怎么选,有新的测试数据或价格变化,我会更新这篇。