

本地大模型推荐(2026):8GB 到 128GB 显存各跑哪个模型,一张表直接选
本地大模型推荐:按显存或统一内存分档,告诉你 8GB 到 128GB 各跑哪个模型,文件大小按 Ollama 官方模型页在 2026 年 10 月 28 日核对。
 buffer关于作者约 4 分钟阅读
先说结论:本地大模型推荐按显存来选。8GB 先跑 Qwen3.5 4B,12GB 跑 Qwen3.5 9B 或 Gemma 4 12B,16GB 可以试 gpt-oss-20b,24GB 选 Qwen3.8 27B 或 Gemma 4 26B-A4B,32GB 选 Qwen3.6 35B-A3B,96GB 到 128GB 才轮到 gpt-oss-120b 和 Qwen3.5 122B-A10B。下面的文件大小都取自 Ollama 官方模型库,我在 2026 年 10 月 28 日逐个核对过。
这篇推荐只看一件事:模型文件能不能完整放进你的显存(Mac 是统一内存),并且还给上下文留出空间。放不进去的模型会部分转到内存或硬盘上跑,速度会明显变慢。想算得更精确,可以把参数量、量化和上下文填进 显存计算器。
本地大模型推荐:按显存分档
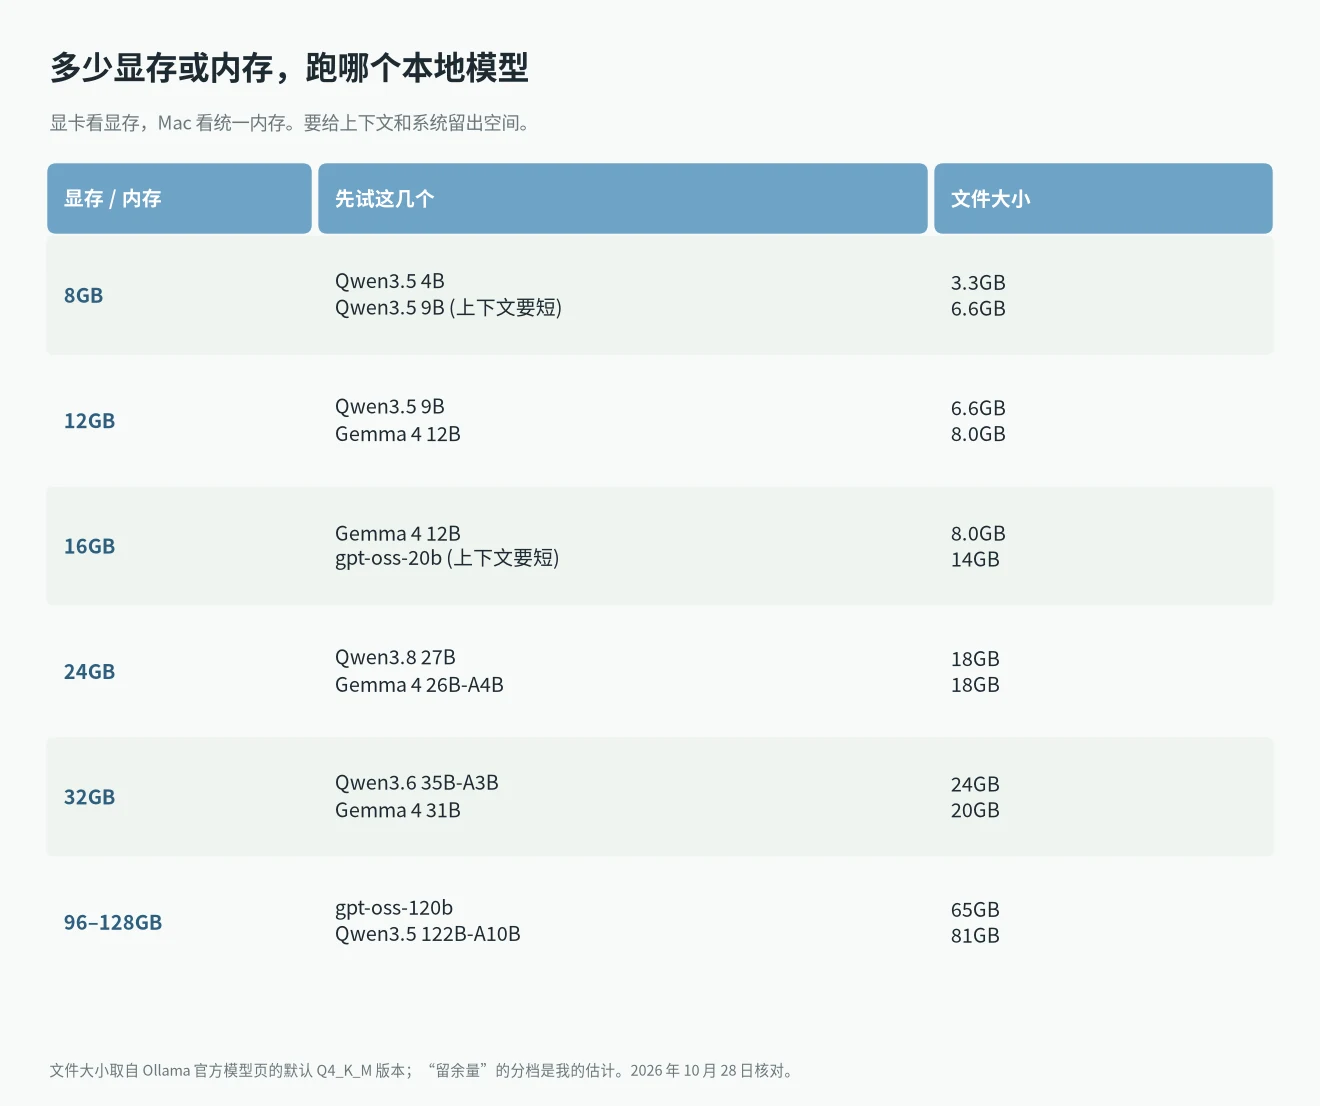
下面每一档我只列两三个最值得先试的模型,大小都是 Ollama 默认的 Q4_K_M 版本。
- 8GB:Qwen3.5 4B,文件 3.3GB,余量很足。Qwen3.5 9B 是 6.6GB,也能放下,但上下文只能开短一些。
- 12GB:Qwen3.5 9B(6.6GB)或 Gemma 4 12B(8.0GB)。这一档是日常聊天、翻译和总结文档最划算的选择。
- 16GB:Gemma 4 12B 可以开更长的上下文。gpt-oss-20b 文件是 14GB,能放下,但只剩 2GB 左右给上下文。
- 24GB:Qwen3.8 27B(18GB)和 Gemma 4 26B-A4B(18GB)。RTX 4090 和 RTX 3090 都在这一档,详见 RTX 4090 能跑多大的模型。
- 32GB:Qwen3.6 35B-A3B(24GB)或 Gemma 4 31B(20GB)。RTX 5090 就是 32GB,可以看 RTX 5090 显存够不够跑本地大模型。
- 96GB 到 128GB:gpt-oss-120b(65GB)和 Qwen3.5 122B-A10B(81GB)。这一档通常是 128GB 的 Mac Studio、DGX Spark 或 AI Max 395 主机,对比见 DGX Spark 和 Mac Studio 怎么选。
分档用的规则是我自己的估计:模型文件大小加 2GB 到 4GB,作为上下文和运行时的余量。上下文开到几万个 token 时,余量要更大。
各模型的文件大小
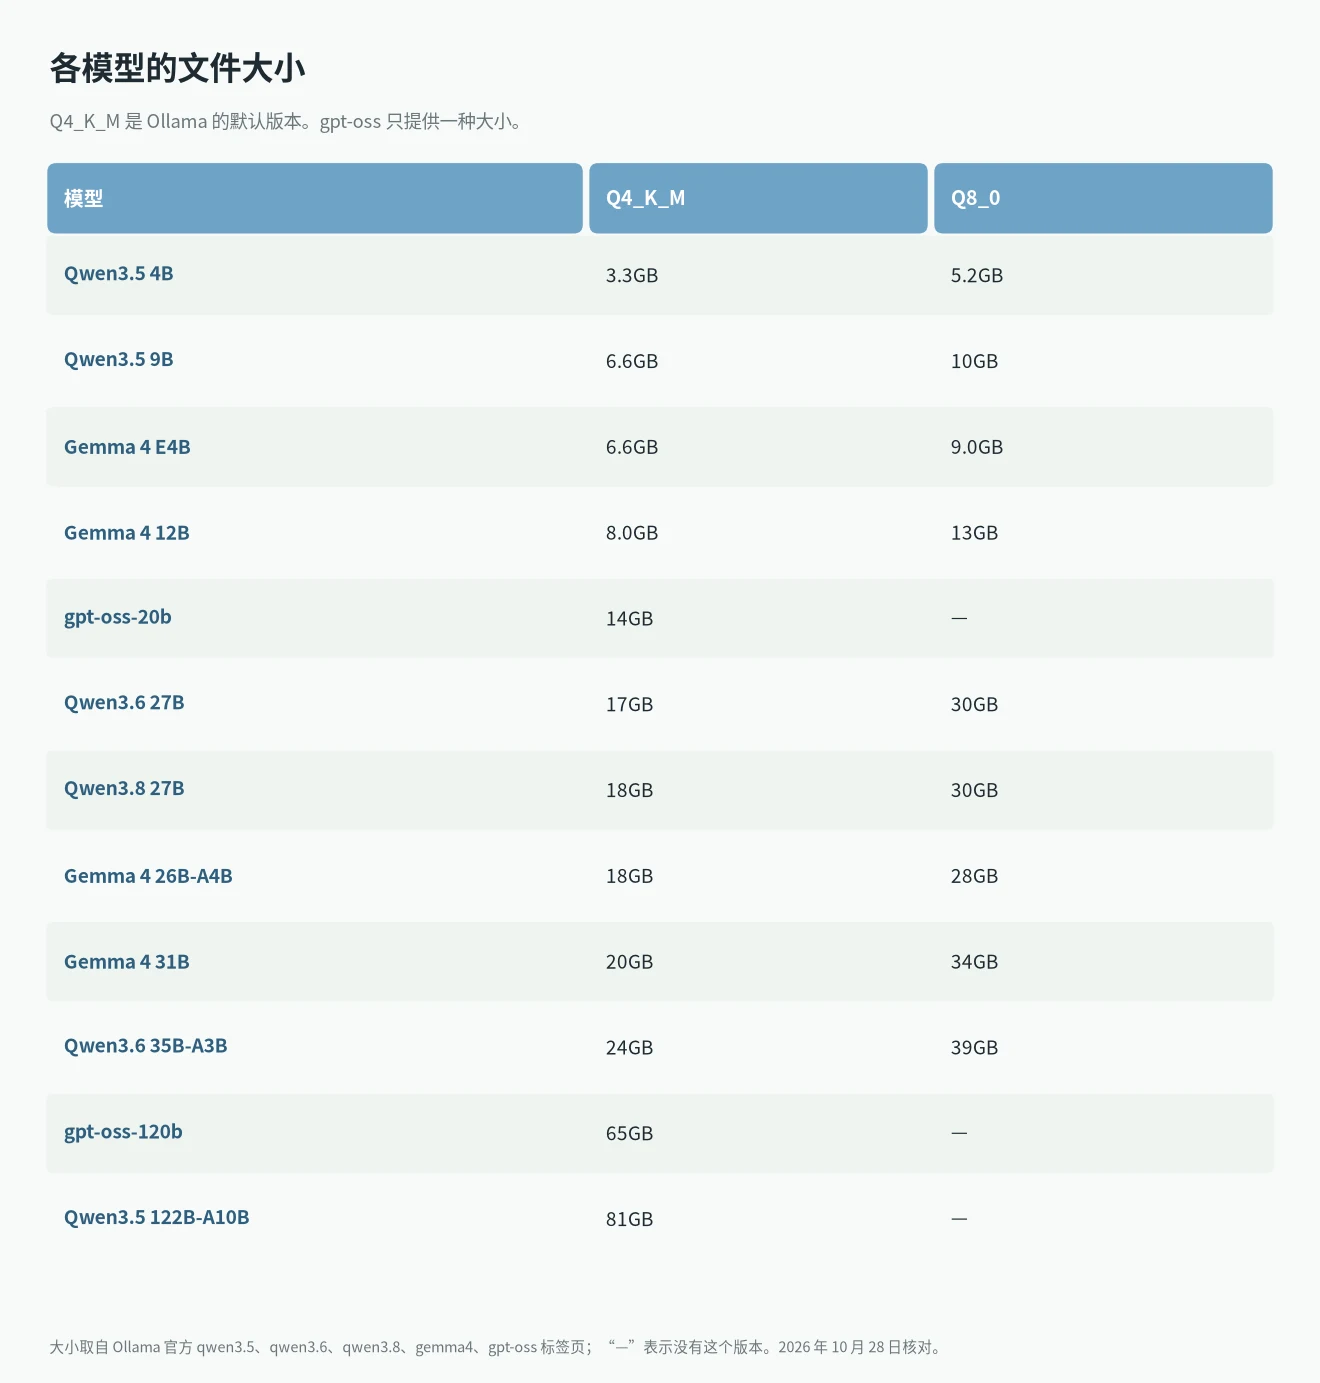
同一个模型,Q8_0 版本大约是 Q4_K_M 的 1.5 到 1.8 倍。比如 Qwen3.8 27B 的 Q4_K_M 是 18GB,Q8_0 是 30GB。Q8_0 更接近原始精度,但要多一倍左右的显存。显存紧张时,先用 Q4_K_M;有 48GB 或 64GB 时,可以换成 Q8_0。
gpt-oss 只提供一种大小:gpt-oss-20b 是 14GB,gpt-oss-120b 是 65GB。
名字里带 A3B、A4B 的模型
Qwen3.6 35B-A3B、Gemma 4 26B-A4B 和 Qwen3.5 122B-A10B 都是混合专家(MoE)模型。名字里的 A3B 表示每生成一个 token 只用到约 30 亿参数。它们生成速度比同样大小的普通模型快,但整个模型仍然要全部放进显存,所以选档时还是看文件大小。
各系列适合做什么
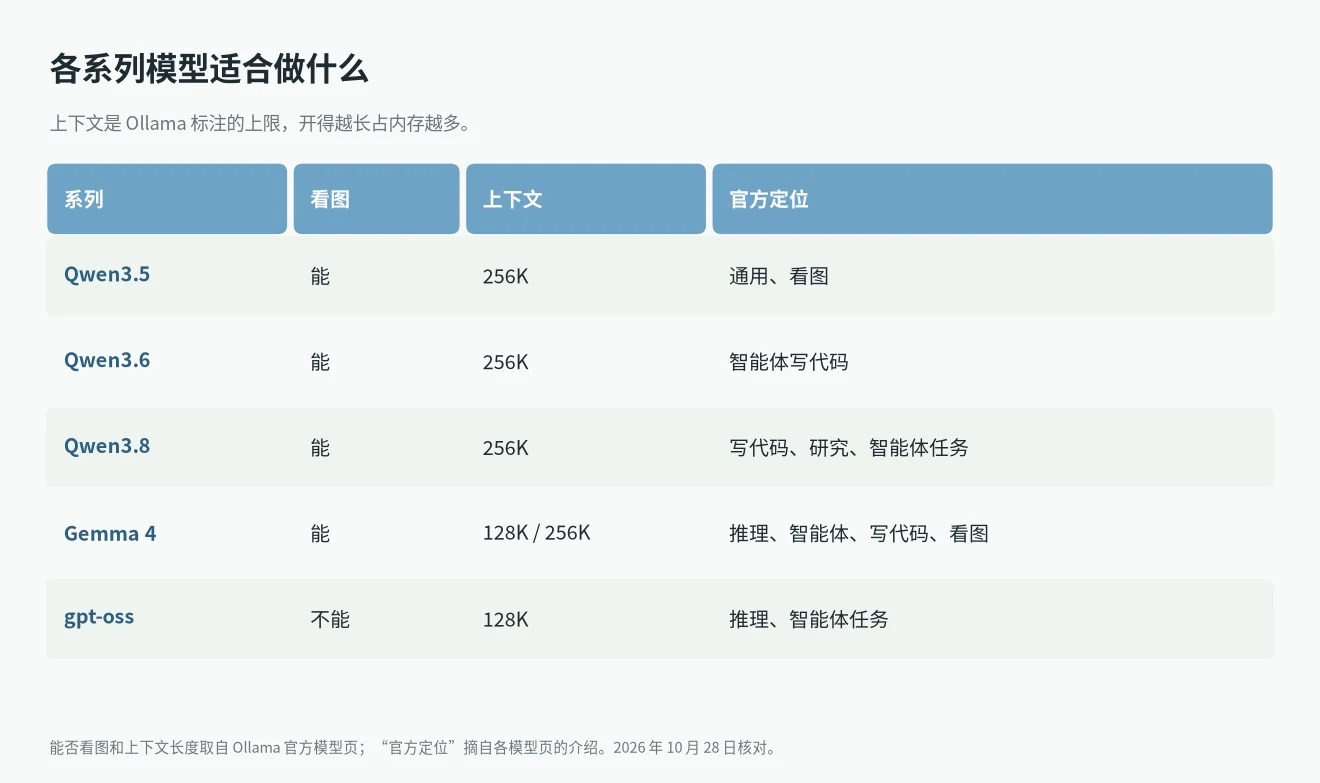
- Qwen3.8 27B:Ollama 页面说它在写代码、专业工作、研究和长任务智能体上有明显提升,是 24GB 这一档的首选。
- Qwen3.6:官方介绍重点是智能体写代码,适合配合编程工具使用。写代码选什么硬件,可以看 本地大模型写代码的硬件指南。
- Gemma 4:Google 的模型,能看图,E 系列上下文 128K,12B 及以上是 256K。
- gpt-oss:OpenAI 的开放权重模型,只能输入文字,上下文 128K。
需要识别图片时,选 Qwen 或 Gemma 4;gpt-oss 不能输入图片。
用 Mac 跑要注意什么
Mac 的显存就是统一内存,但 macOS 和其他程序也要占用一部分。所以 16GB 的 Mac mini 按 12GB 那一档选更稳,24GB 的 Mac 按 16GB 那一档选。具体配置可以参考 Mac mini 跑大模型指南 和 M5 跑本地大模型。
怎么开始
装好 Ollama 后,在终端输入一行命令就能下载并运行,比如 “ollama run qwen3.8:27b”。第一次运行会先下载模型文件,之后就能离线使用。想在本地跑 DeepSeek,可以看 DeepSeek 本地部署硬件指南。
常见问题
8GB 显存能跑本地大模型吗?
能。Qwen3.5 4B 只有 3.3GB,8GB 显存跑起来余量很足。这是 8GB 档最稳的本地大模型推荐。
本地大模型推荐 Q4 还是 Q8?
显存够就用 Q8_0,不够就用 Q4_K_M。Q4_K_M 是 Ollama 的默认版本,大小约为 Q8_0 的六成左右。
为什么模型能放下,速度还是很慢?
通常是上下文开得太长,占满了剩余显存,部分计算被转到了 CPU。把上下文调短,或者换小一档的模型。
这份推荐多久更新一次?
新模型出得很快。本文的模型和大小按 2026 年 10 月 28 日的 Ollama 模型库核对,之后有新版本会再更新。