

显存计算器:超实用的免费工具,跑本地大模型要多少显存,输入参数量、量化和上下文直接算(2026)
显存计算器加公式说明:本地大模型的显存由权重、KV 缓存和余量三部分组成,数据按 llama.cpp、Qwen3 官方配置和 Ollama 在 2026 年 10 月 28 日核对。
 buffer关于作者约 8 分钟阅读
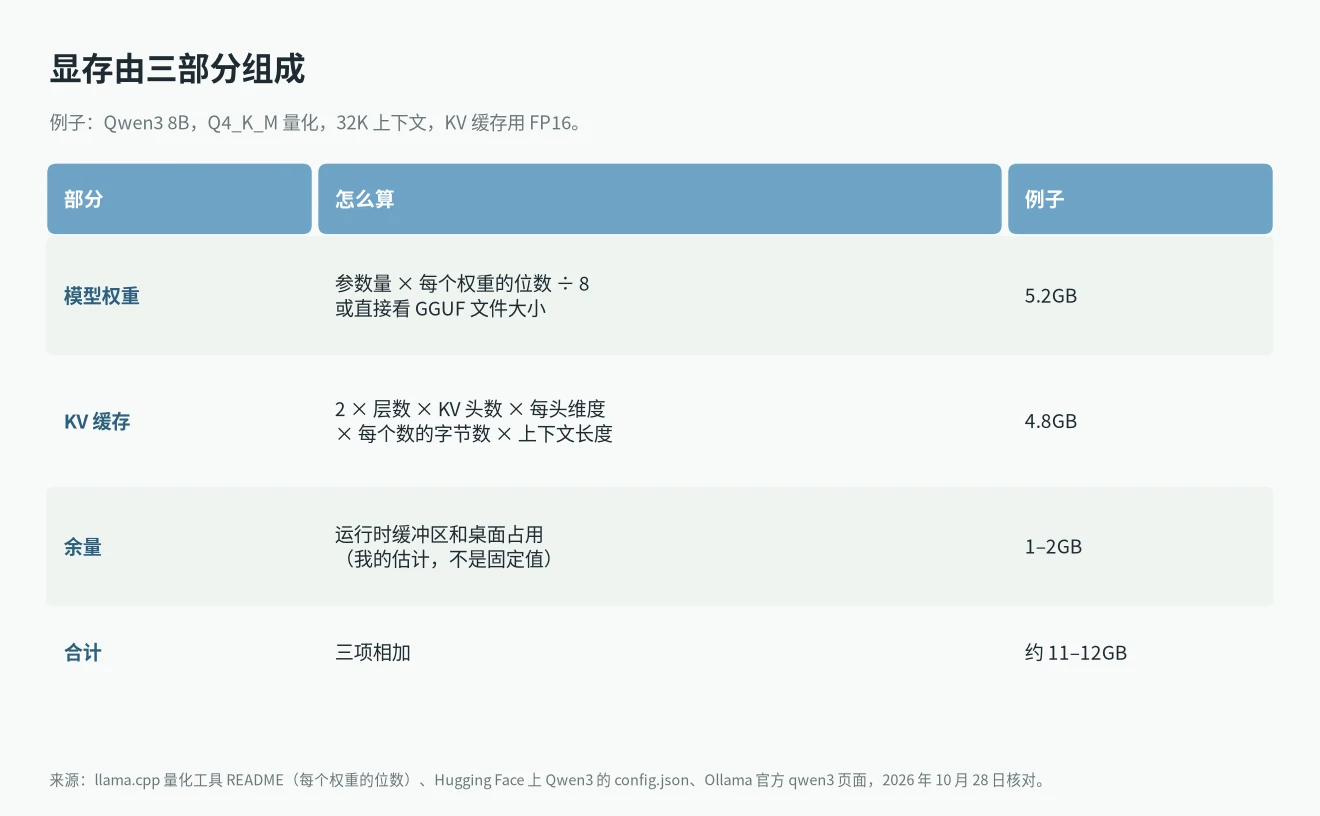
本地大模型要多少显存,可以拆成三项相加:模型权重、KV 缓存和余量。下面的显存计算器就是按这三项来算的。以 Qwen3 8B 为例,用 Q4_K_M 量化、开 32K 上下文,权重约 5.2GB,KV 缓存约 4.8GB,再留 1 到 2GB 余量,总共要 11 到 12GB。一个更快的估法是:Q4_K_M 量化下每 10 亿参数约占 0.6GB,再按上下文长度加上 KV 缓存。公式里每个权重的位数来自 llama.cpp 官方量化说明,层数和头数来自 Qwen3 在 Hugging Face 上的官方配置文件,文件大小来自 Ollama 官方模型页,我在 2026 年 10 月 28 日逐项核对过。不同显存具体选哪个模型,可以看本地大模型推荐。
先看结论
- 权重:参数量乘以每个权重的位数,再除以 8。Q4_K_M 每个权重约 4.89 位,Q8_0 约 8.5 位,FP16 是 16 位。
- KV 缓存:和上下文长度成正比。Qwen3 8B 开 8K 上下文约 1.2GB,开 32K 约 4.8GB,开 128K 约 19.3GB。
- 余量:运行时的缓冲区和桌面系统也要占显存,我一般留 1 到 2GB。这是我的经验值,不是固定数字。
- 最常见的错误:只看模型文件大小,忘了上下文。上下文开得越长,KV 缓存越大,有时比模型本身还大。
显存计算器
先选一个模型预设,再改量化方式和上下文长度,结果会自动更新。如果要算别的模型,选“自定义”,然后把参数量、层数、KV 头数和每头维度填进去。这几个数都写在模型的 config.json 文件里,对应的字段是 num_hidden_layers、num_key_value_heads 和 head_dim。
KV 缓存:
估算总显存:
结果是估算值,实际占用随软件和设置变化。
这个显存计算器默认的 KV 缓存类型是 f16,这也是 llama.cpp 的默认设置。余量默认填了 1.5GB,你可以按自己的情况改。
显存计算器用的公式
模型权重
权重占用 = 参数量 × 每个权重的位数 ÷ 8,单位是字节。llama.cpp 官方量化说明用 Llama 3.1 8B 实测了各种量化格式的位数:Q4_K_M 是 4.89 位,Q5_K_M 是 5.70 位,Q6_K 是 6.56 位,Q8_0 是 8.50 位,F16 是 16 位。所以 Qwen3 8B 有 82 亿参数,用 Q4_K_M 算出来约 5.0GB,Ollama 上的实际文件是 5.2GB,两者很接近。下载了 GGUF 文件的话,直接用文件大小更准。
KV 缓存
模型生成每个新 token 时,要用到前面所有 token 在每一层算出来的 K 和 V 两组数据,这些数据就存在 KV 缓存里。KV 缓存占用 = 2 × 层数 × KV 头数 × 每头维度 × 每个数的字节数 × token 数。Qwen3 8B 有 36 层、8 个 KV 头,每头维度是 128,按 f16 每个数 2 字节算,每个 token 要占 147,456 字节,32K 个 token 就是约 4.8GB。
余量
除了权重和 KV 缓存,推理程序还要给中间计算结果留缓冲区。如果显卡同时接着显示器,系统桌面也会占一部分显存。这部分随软件和设置变化,没有统一的官方数字,所以计算器把它做成了可以自己改的一项。
量化对权重大小的影响
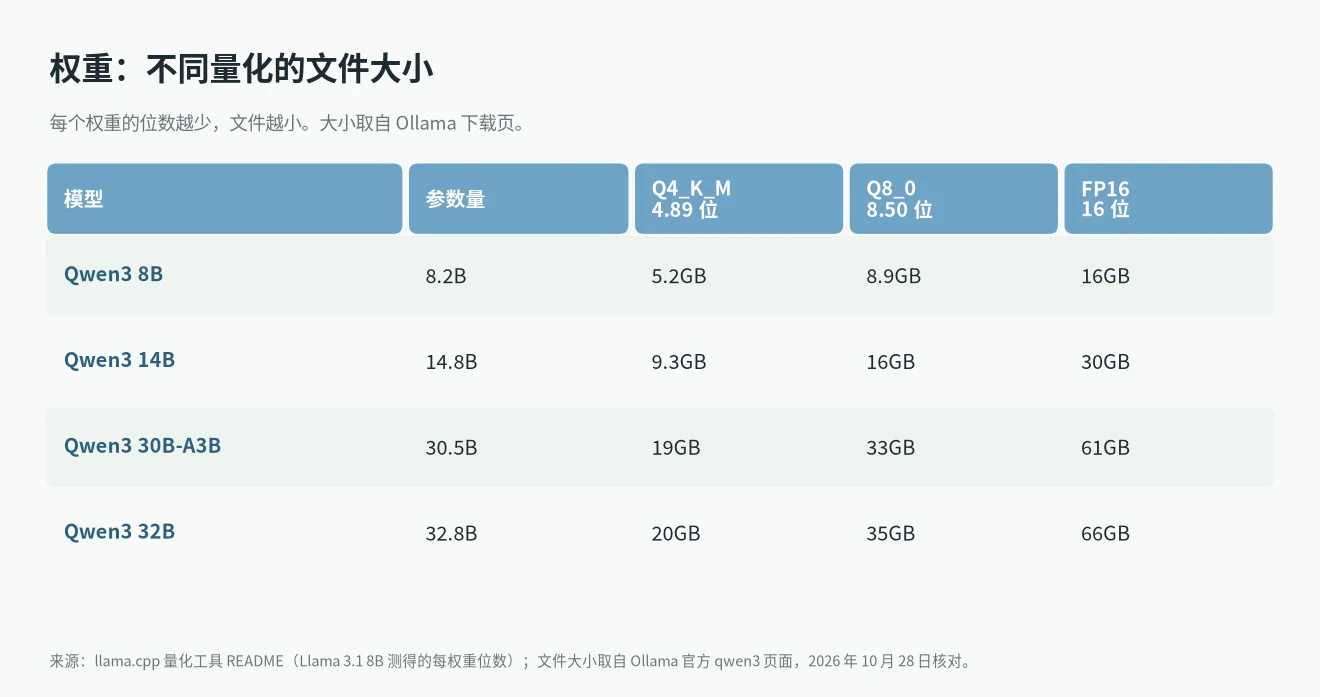
量化就是用更少的位数存每个权重。从 FP16 换成 Q8_0,文件大约小一半;换成 Q4_K_M,大约只剩三成。以 Qwen3 32B 为例,Ollama 上 FP16 版本是 66GB,Q8_0 是 35GB,Q4_K_M 是 20GB。日常聊天和写代码,Q4_K_M 是最常用的选择;如果显存够用,Q8_0 的效果更接近原版。
上下文对 KV 缓存的影响
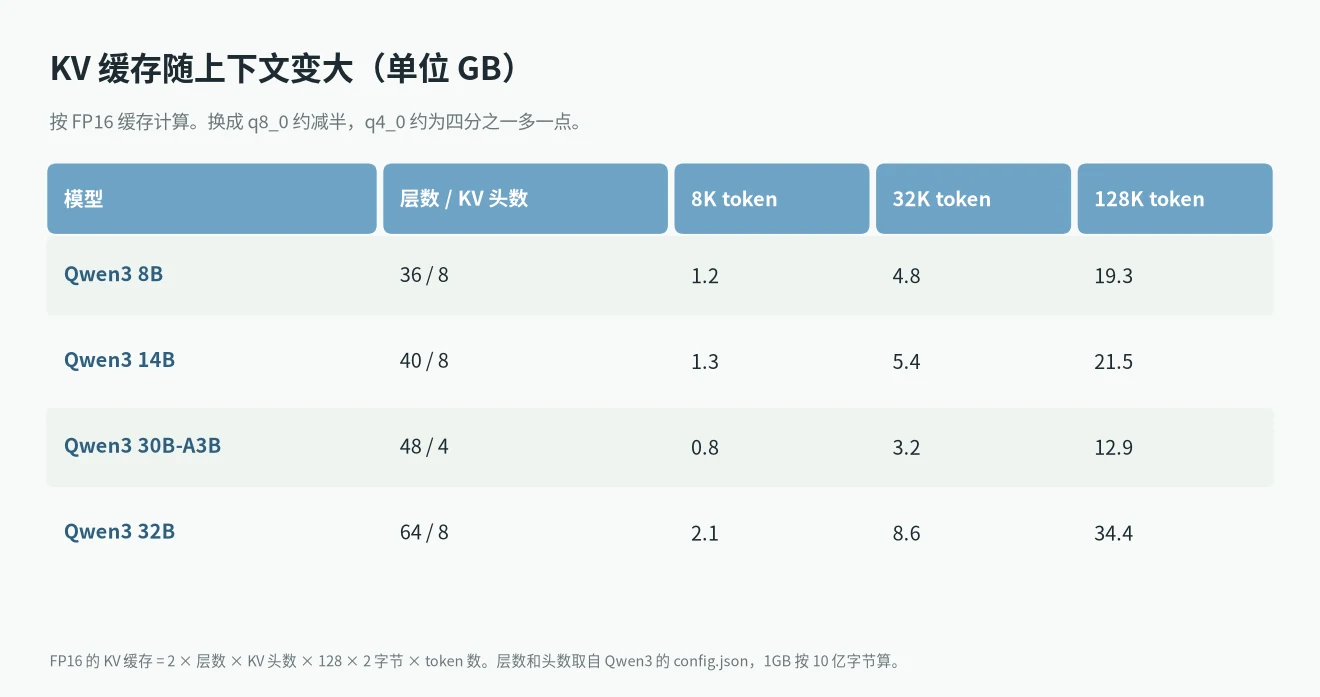
KV 缓存只看层数、KV 头数和上下文,和量化方式无关。Qwen3 32B 有 64 层,开 32K 上下文时 KV 缓存约 8.6GB;开到 128K 时约 34.4GB,比 Q4_K_M 的权重还大。要注意,Qwen3 官方说明里原生上下文是 32,768 个 token,要用到 131,072 个 token 需要开启 YaRN。
llama.cpp 可以用 -ctk 和 -ctv 两个参数把 KV 缓存换成 q8_0 或 q4_0。q8_0 每个数约 8.5 位,占用大约是 f16 的一半;q4_0 约 4.5 位,大约是四分之一多一点。
不同显存能跑多大的模型
下面按 Q4_K_M 量化、f16 KV 缓存、1.5GB 余量来算,数字都是用上面的计算器得出的:
| 模型 | 8K 上下文 | 32K 上下文 | 适合的显存 |
|---|---|---|---|
| Qwen3 8B | 约 7.9GB | 约 11.5GB | 12GB 起,16GB 更宽松 |
| Qwen3 14B | 约 12.1GB | 约 16.2GB | 16GB 起,长上下文要 24GB |
| Qwen3 30B-A3B | 约 21.3GB | 约 23.7GB | 24GB 起 |
| Qwen3 32B | 约 23.6GB | 约 30.1GB | 24GB 很紧,32GB 更稳 |
24GB 显卡能装下什么,可以看我写的 4090 能跑多大的模型;32GB 的情况见 5090 跑大模型值得买吗。
大模型需要多少显存?
简单说:权重文件大小,加上你要用的上下文对应的 KV 缓存,再加 1 到 2GB 余量。Q4_K_M 量化下,每 10 亿参数约 0.6GB,KV 缓存另算。按常见尺寸看,8B 模型要 12GB 显卡,14B 要 16GB,32B 要 24 到 32GB,70B 大约要 48GB 以上。大模型需要多少显存,主要看参数量和量化,跟显卡品牌关系不大。
大家问得最多的是 gpt-oss-120b 显存要多少。OpenAI 的 官方模型卡 写明它有 1170 亿参数(激活 51 亿),用自带的 MXFP4 权重可以放进一张 80GB 的 GPU(比如 H100)。Ollama 上的文件是 65GB。它的 config.json 有 36 层,但只有 18 层是全注意力(8 个 KV 头,头大小 64),另外 18 层只保留 128 个 token 的窗口,所以 KV 缓存很小:32K 约 1.2GB,开满 128K 约 4.8GB。加起来,32K 上下文约 68GB,128K 约 71GB。64GB 的机器装不下,80GB 显存或 96 到 128GB 统一内存可以。小一号的 gpt-oss-20b 在 Ollama 上是 14GB,总共要 16 到 19GB,官方说的“16GB 内跑”只在上下文较短时成立。
显存不够、把部分层放到内存时,道理一样:放不进显存的部分要放在系统内存里,显存加空闲内存要够总数。能跑,但会慢很多。
MoE 模型要按总参数量算
Qwen3 30B-A3B 是 MoE 模型,总参数 305 亿,每个 token 只激活 33 亿。激活的参数少,生成速度就快,但所有专家的权重仍然都要放进内存或显存里。所以用显存计算器算 MoE 模型时,参数量要填总参数量,不能填激活参数量。它的 KV 头数只有 4 个,所以同样的上下文下,KV 缓存比 Qwen3 8B 还小。
显存不够怎么办
- 换更低的量化:从 Q8_0 换成 Q4_K_M,权重差不多能减少四成。
- 缩短上下文:不需要读长文档时,把上下文设成 8K 或 16K,KV 缓存会小很多。
- 量化 KV 缓存:在 llama.cpp 里加上 -ctk q8_0 -ctv q8_0,KV 缓存大约减半。
- 部分放到内存:llama.cpp 的 -ngl 参数可以只把一部分层放到显卡上,其余放在内存里。这样能跑,但速度会明显变慢。
- 换统一内存的机器:Mac 和 AMD Ryzen AI Max+ 395 这类机器的内存由 CPU 和 GPU 共用,可以装下更大的模型。
Mac 和统一内存怎么算
Mac 没有独立显存,模型放在统一内存里,算法和上面一样:权重加 KV 缓存再加余量。区别是系统本身也要用这块内存,所以余量要多留一些。具体机型可以看 Mac mini 跑大模型 和 M5 跑大模型;预算更高的话,可以看 DGX Spark vs Mac Studio 对比。想用本地模型写代码,可以看 本地大模型写代码选哪个。
常见问题
7B 或 8B 模型要多少显存?
用 Q4_K_M 量化、8K 上下文,Qwen3 8B 约需 8GB;开到 32K 上下文约需 11.5GB。所以 12GB 显卡可以跑,16GB 更宽松。
显存计算器算出来的结果准吗?
权重和 KV 缓存是按官方配置算的,误差很小。余量部分随软件和设置变化,所以结果是估算值。实际使用时,最好比算出来的数再多留 1GB 左右。
为什么开长上下文显存会暴涨?
因为 KV 缓存和上下文长度成正比。上下文翻 4 倍,KV 缓存也翻 4 倍。Qwen3 32B 从 32K 开到 128K,KV 缓存从约 8.6GB 涨到约 34.4GB。
gpt-oss-120b 显存要多少?
32K 上下文约 68GB,128K 约 71GB:65GB 的 MXFP4 权重,加上很小的 KV 缓存和余量。OpenAI 官方说一张 80GB GPU 能放下。
Ollama 显示的模型大小就是要用的显存吗?
不是。Ollama 显示的是文件大小,也就是权重部分。实际运行时还要加上 KV 缓存和余量,可以用本页的显存计算器把这两项加上。