
12GB 显存能跑什么本地大模型?7 个模型各留多少上下文(KV 缓存实测核对)
12 GB 显卡能装下 8B 到 14B 的模型,但上下文决定能用多远。我们读了 GGUF 头信息,用 Ollama 0.40.16 日志核对了 KV 缓存公式,算出七个模型的最大上下文。
 buffer关于作者约 5 分钟阅读
12GB 显存跑本地大模型很紧,Ollama 库页面上的文件大小只说明了一半。上下文窗口同样要占内存,而且每多一个 token 就多一份。我们读了七个热门模型的 GGUF 头信息,用 Ollama 0.40.16 实际分配的缓存大小核对了公式,然后算出每个模型在 12 GB 显卡上还能留给你多少上下文。
简短回答
- Qwen3.5 9B 留的余地最大。 下载 6.6 GB,32K 上下文的 KV 缓存只有 1 GiB,因为它大多数层不保存缓存。按公式上限约 155K token,实际更低,未测:计算缓冲区会随上下文增长,128K 在我们的测试机上没能加载。
- 8B 模型很宽松。 qwen3:8b 和 llama3.1:8b 在默认精度下都能留出 32K 以上。
- 12B 到 14B 模型能装下,但上下文很短。 按我们的预算,用 f16 缓存时 mistral-nemo:12b 约 28K,qwen3:14b 约 14K,deepseek-r1:14b 约 13K,phi4:14b 约 12K。
- 8 位缓存大约能翻倍。 Ollama 的
OLLAMA_KV_CACHE_TYPE=q8_0在我们的测试里把缓存降到了 53%。 - gpt-oss:20b 装不下。 光权重就有 12.85 GiB。
为什么只看下载大小不够
内存里的模型是权重加 KV 缓存,再加计算缓冲区。权重就是那个文件。KV 缓存保存到目前为止每个 token 的 key 和 value,标准 Transformer 每个 token 的开销是 2 × 层数 × KV 头数 × 头维度 × 字节数。qwen3:14b 是 2 × 40 × 8 × 128 × 2 = 163,840 字节每 token,32K 就是 5 GiB,相当于文件大小的一半还多。
每个模型的数字我们都从 Ollama 注册表上的 GGUF 头信息里读取。不是每层都保存缓存的模型要用各自的规则。Qwen3.5 每四层才有一层保存,依据是它头信息里的 full_attention_interval = 4,所以每 token 是 32,768 字节。
我们用 Ollama 核对了公式
公式只有和软件实际行为一致才有用。我们在 Ollama 0.40.16 里按几种上下文大小加载模型,读服务端日志里的 llama_kv_cache: size 一行。它和我们的公式完全一致,包括混合结构的 Qwen3.5 和 8 位缓存。
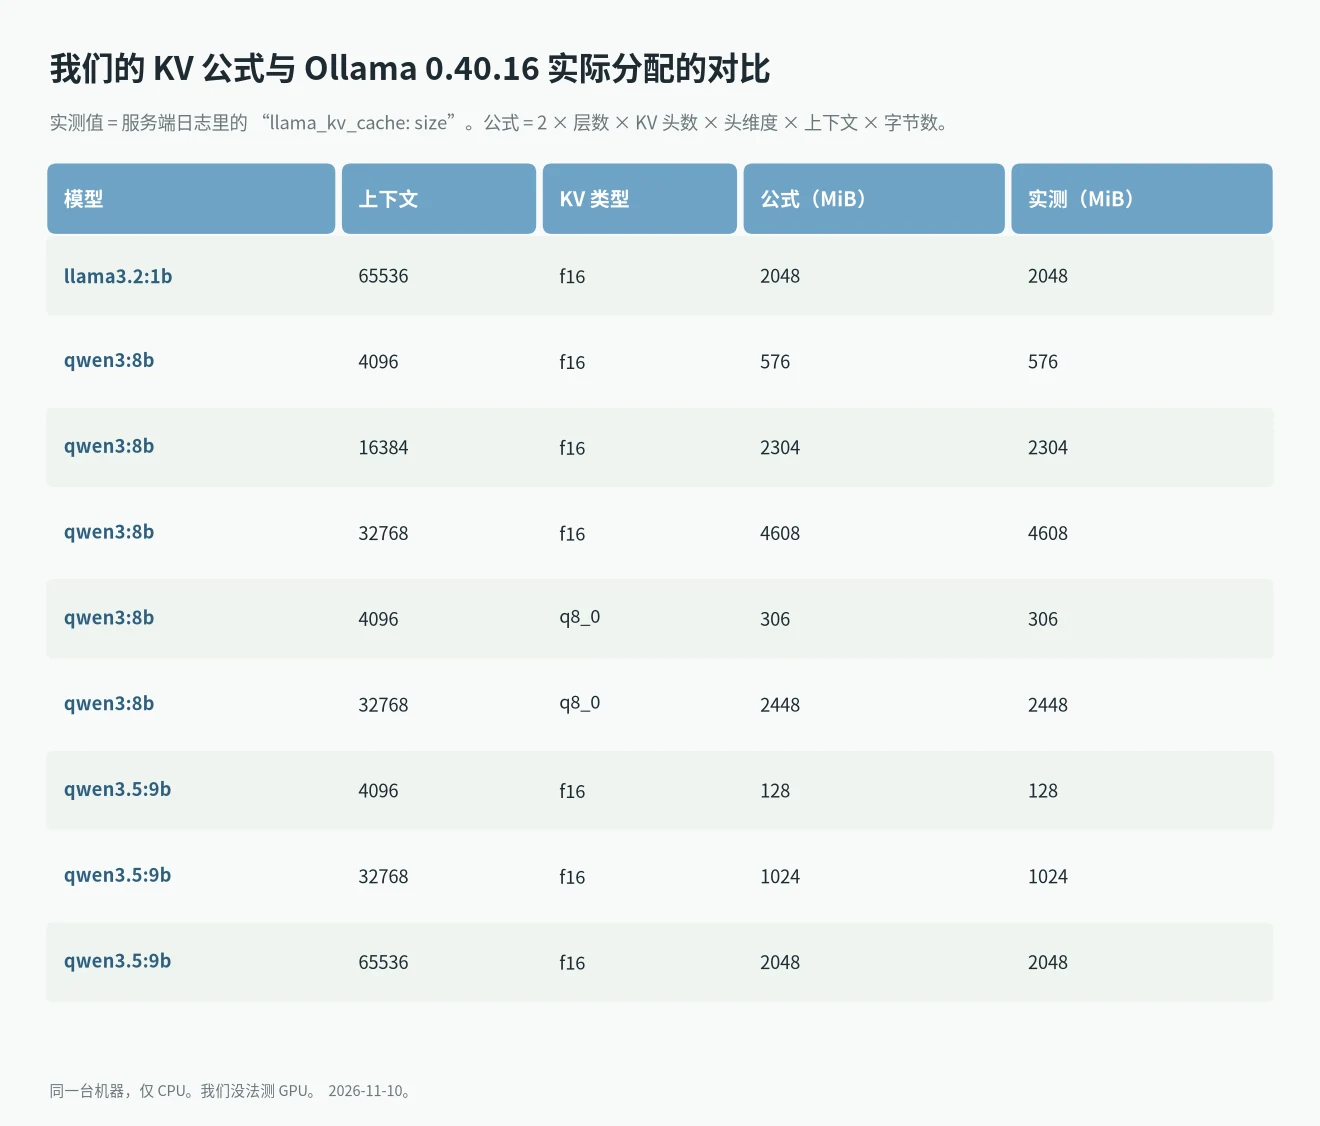
这台机器没有显卡,所以数字是内存而不是显存。缓存由同一段代码分配,但 GPU 那一侧我们没法确认。日志里还有计算缓冲区:qwen3:8b 在 4K 时 116 MiB,32K 时 288 MiB,qwen3.5:9b 在 64K 时 704 MiB。所以下面的表里我们留出了显卡的 1 GiB。
12 GB 里能放下什么
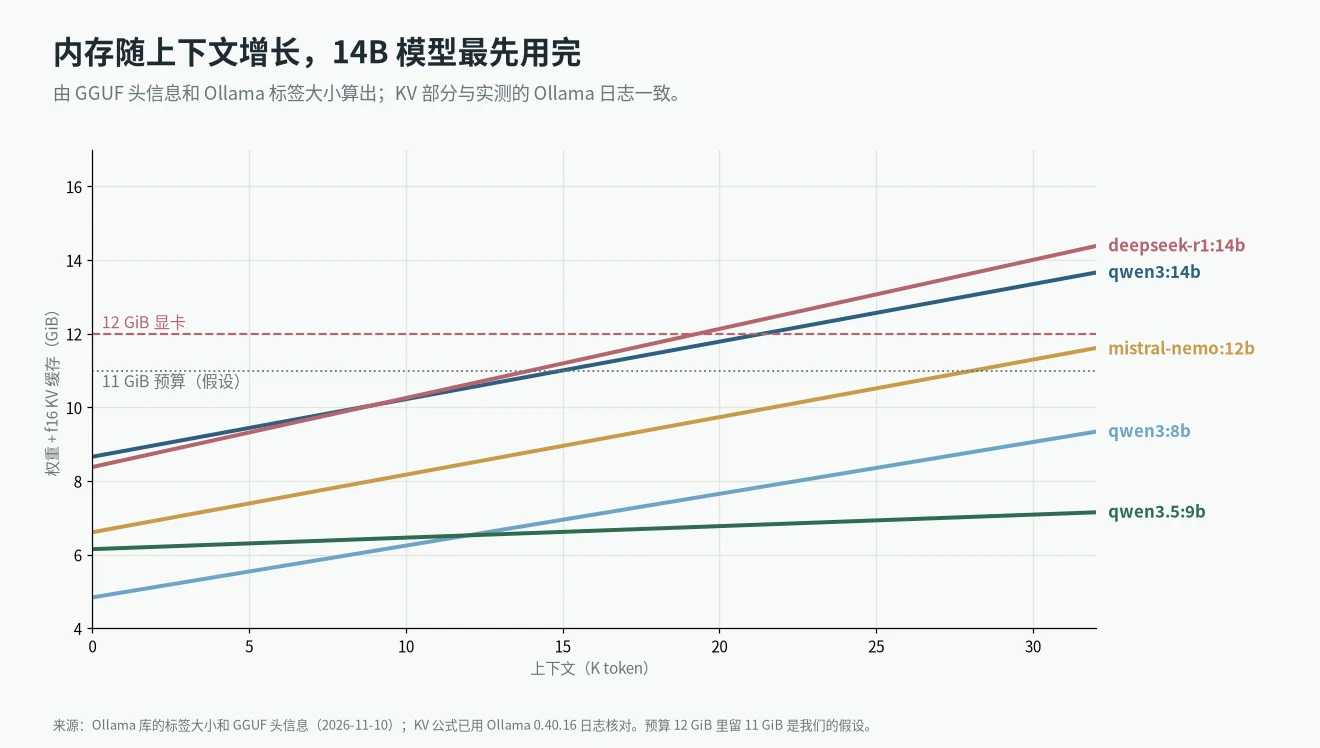
我们取一张 12 GiB 的卡,留 1 GiB 给驱动、显示和计算缓冲区。这个 11 GiB 的预算是我们的假设,不是实测。Windows 接多个显示器可能占得更多。表里是留给上下文的部分。K 指 1,024 token,向下取整:qwen3:14b 算出约 15.3K,表里写 14K。qwen3.5:9b 的数字只是公式上限,实际更低,未测:计算缓冲区会随上下文增长,128K 在我们的测试机上没跑起来。
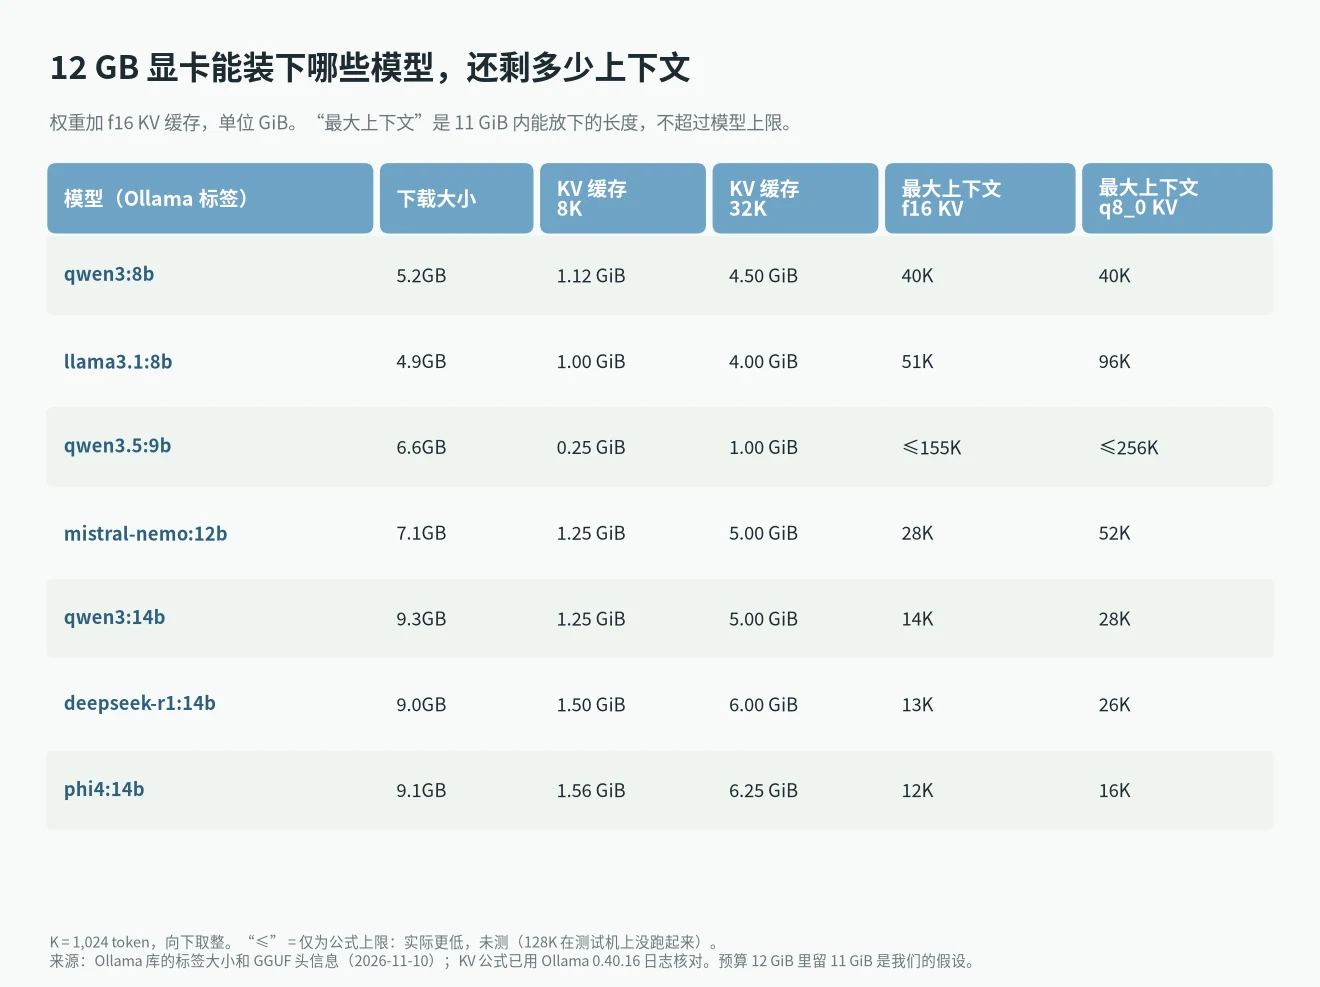
有两点值得注意。第一,12 GB 上不是模型越大越好:14K 的 qwen3:14b 和 最高 155K(公式上限,实际更低,未测)的 qwen3.5:9b 是不同的工具。第二,缓存类型和模型一样重要。需要长文档的话,用 9B 混合结构的模型,或者打开 8 位缓存。
8 位缓存:省多少、代价是什么
Ollama 的 FAQ 说 OLLAMA_KV_CACHE_TYPE 可以是 f16(默认)、q8_0 或 q4_0,需要 Flash Attention,并且对所有模型统一生效。它把 q8_0 描述为内存约减半、精度损失很小。我们在 qwen3:8b 上测了内存这一侧:4K 时 306 MiB 对 576 MiB,32K 时 2,448 对 4,608。
我们没有测质量。同一份 FAQ 提醒,GQA 数量高的模型可能受影响更大,并点名了 Qwen2。deepseek-r1:14b 的头信息写的架构是 qwen2,所以在依赖 q8_0 之前,请先用你自己的提示词测一下。
怎么选
- 长文档或智能体: qwen3.5:9b。它的架构比较新,先确认你的 Ollama 版本和客户端支持。
- 能装下的最好质量: 14B 模型,上下文设在 12K 到 14K 左右,需要更多就开 8 位缓存。自己设置
num_ctx,见 Ollama 上下文长度。 - 稳妥又快: 8B 模型。模型装不下时,Ollama 可能把一部分层放到 CPU 上,速度会变慢;Ollama 没用 GPU 讲了怎么检查。
更多模型见 按显存选本地大模型。其他显存大小见 Ollama 显存要求 和我们的 显存计算器,还在选显卡的话看 大模型推理显卡性价比。
哪些是测的,哪些是算的
- 2026 年 11 月 10 日实测,Ollama 0.40.16,仅 CPU:llama3.2:1b、qwen3:8b(f16 和 q8_0)、qwen3.5:9b 在几种上下文下的 KV 缓存大小。全部与公式一致。
- 计算得出:14B、12B 模型和 llama3.1:8b 的所有数字,以及“最大上下文”一列。输入是 GGUF 头信息和 Ollama 的标签大小。
- 假设:11 GiB 的预算。这里没有 12 GB 显卡,我们没有测真实显存占用、速度和质量。
- 没放进表里的:Gemma 3 和 Gemma 4。它们的层里混用局部和全局注意力,我们的 gemma4:12b 运行日志里有几个缓存缓冲区(4K 时 64、480、8、36 MiB),没法归结成一个数。qwen3:8b 的 64K 和 qwen3.5:9b 的 128K 在这台机器上加载失败,所以这两个点没有实测。
- 来源:Ollama 模型库 的标签、Ollama FAQ,以及 registry.ollama.ai 提供的 GGUF 头信息。
常见问题
12GB 显存能跑什么大模型?
4 位量化下约 14B 参数以内的模型能装下,但 14B 的在 f16 缓存下只剩 12K 到 14K token 的上下文。8B 和 9B 的模型余地大得多。
qwen3:14b 12GB 显存够吗?
权重放得下(约 8.7 GiB)。用 f16 缓存、留 1 GiB 余量,上下文上限在 14K token 左右;用 q8_0 缓存约 28K。
上下文窗口占多少显存?
标准模型是每 token 2 × 层数 × KV 头数 × 头维度 × 2 字节。qwen3:8b 每 token 147,456 字节,32K 是 4.5 GiB。
gpt-oss:20b 12GB 能跑吗?
没法完全放在 GPU 上。光权重就有 12.85 GiB,比卡还大。
该用 q8_0 的 KV 缓存吗?
在我们的测试里它把缓存内存减半。Ollama 的 FAQ 说精度损失很小,但提醒有些模型(比如 Qwen2)可能受影响更大。请用你自己的提示词测试。