
LLM con 12GB de VRAM: qué modelos locales caben y cuánto contexto puedes permitirte (caché KV medida)
Una tarjeta de 12 GB admite modelos de 8B a 14B, pero el contexto decide hasta dónde. Leímos cabeceras GGUF, contrastamos la fórmula de la caché KV con logs de Ollama 0.40.16 y calculamos el contexto máximo de siete modelos.
 bufferSobre el autor7 min de lectura
Usar un LLM con 12GB de VRAM es un ajuste justo, y el tamaño de archivo de la página de Ollama es solo la mitad de la respuesta. La ventana de contexto también necesita memoria, y crece con cada token. Leímos las cabeceras GGUF de siete modelos populares, contrastamos nuestra fórmula de caché con lo que Ollama 0.40.16 asignó de verdad y calculamos cuánto contexto deja cada modelo en una tarjeta de 12 GB.
La respuesta corta
- Qwen3.5 9B deja más margen. Se descarga en 6,6 GB y su caché KV ocupa solo 1 GiB con 32K de contexto, porque la mayoría de sus capas no guardan caché. Por fórmula el límite superior es de unos 155K tokens; el límite real es menor y no lo probamos, porque el búfer de cálculo crece con el contexto y 128K no llegó a cargar en nuestra máquina de pruebas.
- Los modelos de 8B van holgados. qwen3:8b y llama3.1:8b dejan sitio para 32K o más con la precisión por defecto.
- Los de 12B a 14B caben, pero con poco contexto. Con nuestro presupuesto y caché f16, mistral-nemo:12b llega a unos 28K, qwen3:14b a unos 14K, deepseek-r1:14b a unos 13K y phi4:14b a unos 12K.
- Una caché de 8 bits casi lo duplica.
OLLAMA_KV_CACHE_TYPE=q8_0redujo la caché al 53 % en nuestra prueba. - gpt-oss:20b no cabe. Solo sus pesos son 12,85 GiB.
Por qué no basta con el tamaño de descarga
Un modelo en memoria son los pesos más la caché KV, más un búfer de cálculo. Los pesos son el archivo. La caché KV guarda las claves y valores de cada token hasta ahora, y en un transformer estándar cuesta 2 x capas x cabezas KV x tamaño de cabeza x bytes por token. En qwen3:14b son 2 x 40 x 8 x 128 x 2 = 163.840 bytes por token, es decir 5 GiB a 32K tokens, más de la mitad del archivo otra vez.
Leímos los números de cada modelo en su cabecera GGUF del registro de Ollama. Los modelos que no guardan caché en todas las capas necesitan su propia regla. Qwen3.5 la guarda en una de cada cuatro capas, según full_attention_interval = 4 en su cabecera, así que cuesta 32.768 bytes por token.
Contrastamos la fórmula con Ollama
Una fórmula solo sirve si coincide con lo que hace el software. Cargamos modelos en Ollama 0.40.16 con varios tamaños de contexto y leímos la línea llama_kv_cache: size del log del servidor. Coincidió exactamente con nuestra fórmula, también con el Qwen3.5 híbrido y con la caché de 8 bits.
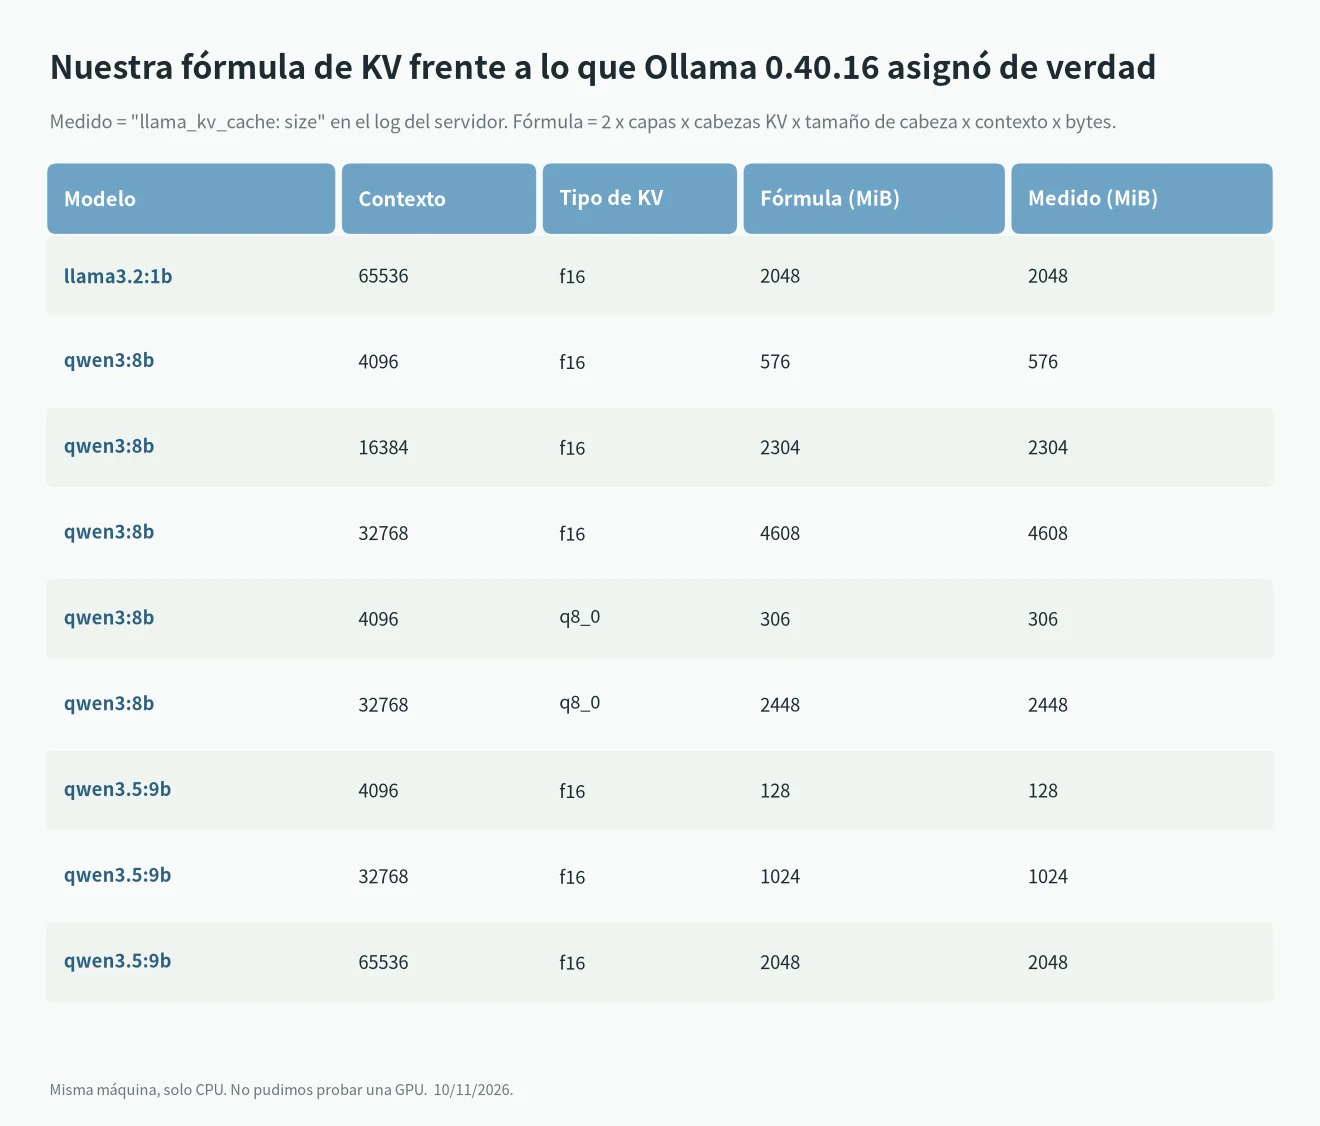
Esta máquina no tiene GPU, así que los números son de RAM y no de VRAM. La caché la asigna el mismo código, pero no pudimos confirmar el lado de la GPU. El log también mostró el búfer de cálculo: 116 MiB a 4K y 288 MiB a 32K en qwen3:8b, y 704 MiB a 64K en qwen3.5:9b. Por eso dejamos 1 GiB libre de la tarjeta en la tabla siguiente.
Qué cabe en 12 GB
Tomamos una tarjeta de 12 GiB y reservamos 1 GiB para el controlador, la pantalla y el búfer de cálculo. Ese presupuesto de 11 GiB es una suposición nuestra, no una medición. Windows con varios monitores puede consumir más. La tabla muestra lo que queda para contexto. K significa 1.024 tokens, redondeado hacia abajo: qwen3:14b sale en unos 15,3K y aparece como 14K. Para qwen3.5:9b las cifras son solo un límite superior de la fórmula; el límite real es menor y no está probado, porque el búfer de cálculo crece con el contexto y 128K no se ejecutó en nuestra máquina de pruebas.
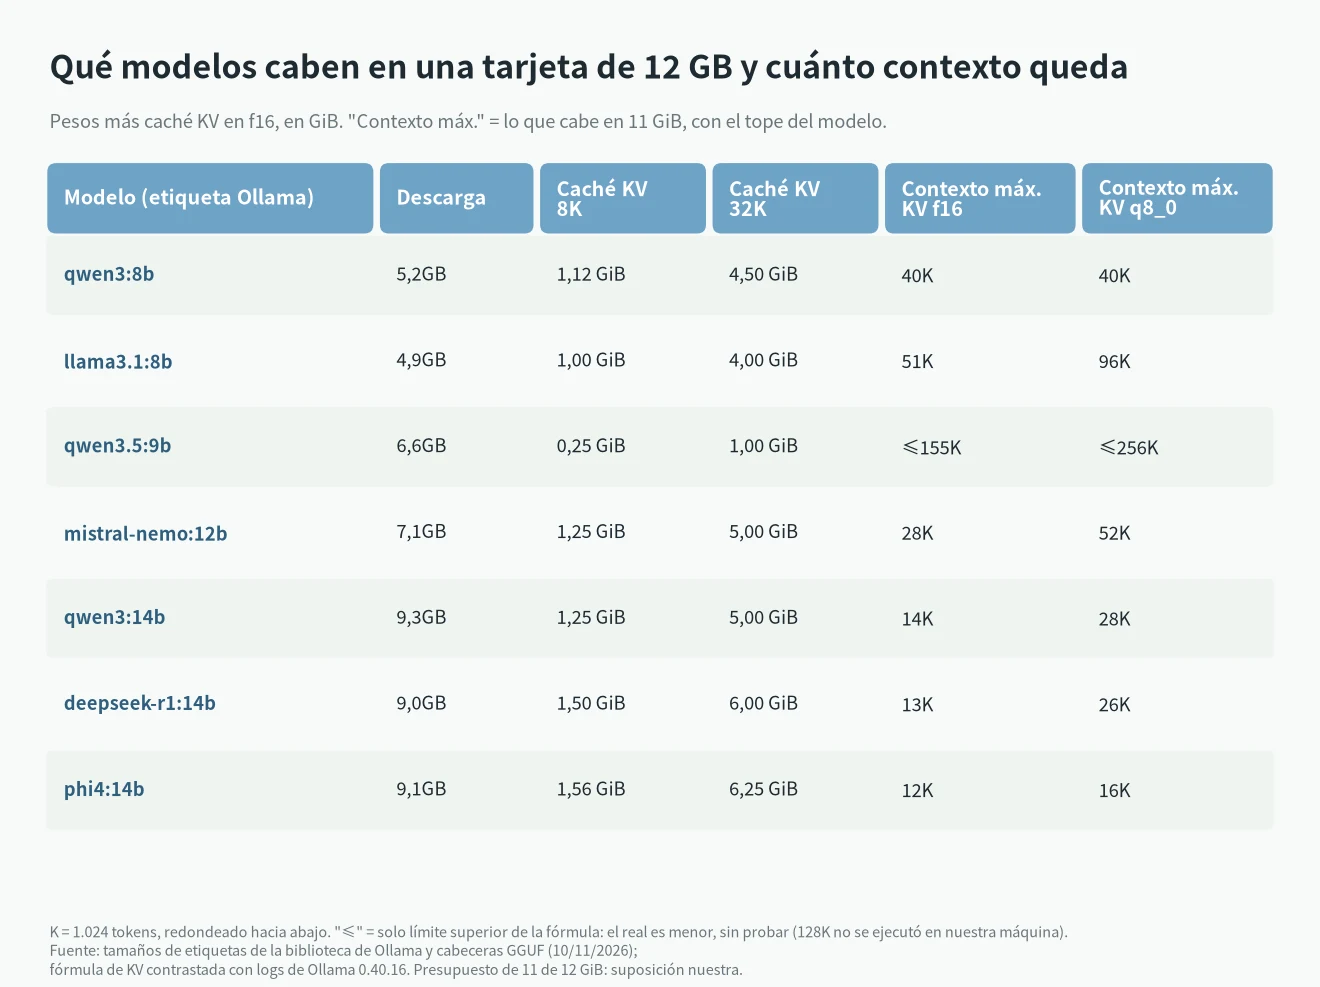
Dos cosas destacan. Primera: en 12 GB un modelo más grande no es simplemente «mejor»: qwen3:14b con 14K y qwen3.5:9b con hasta 155K (límite superior de la fórmula, real menor, sin probar) son herramientas distintas. Segunda: el tipo de caché importa tanto como el modelo. Si necesitas documentos largos, usa el híbrido de 9B o activa una caché de 8 bits.
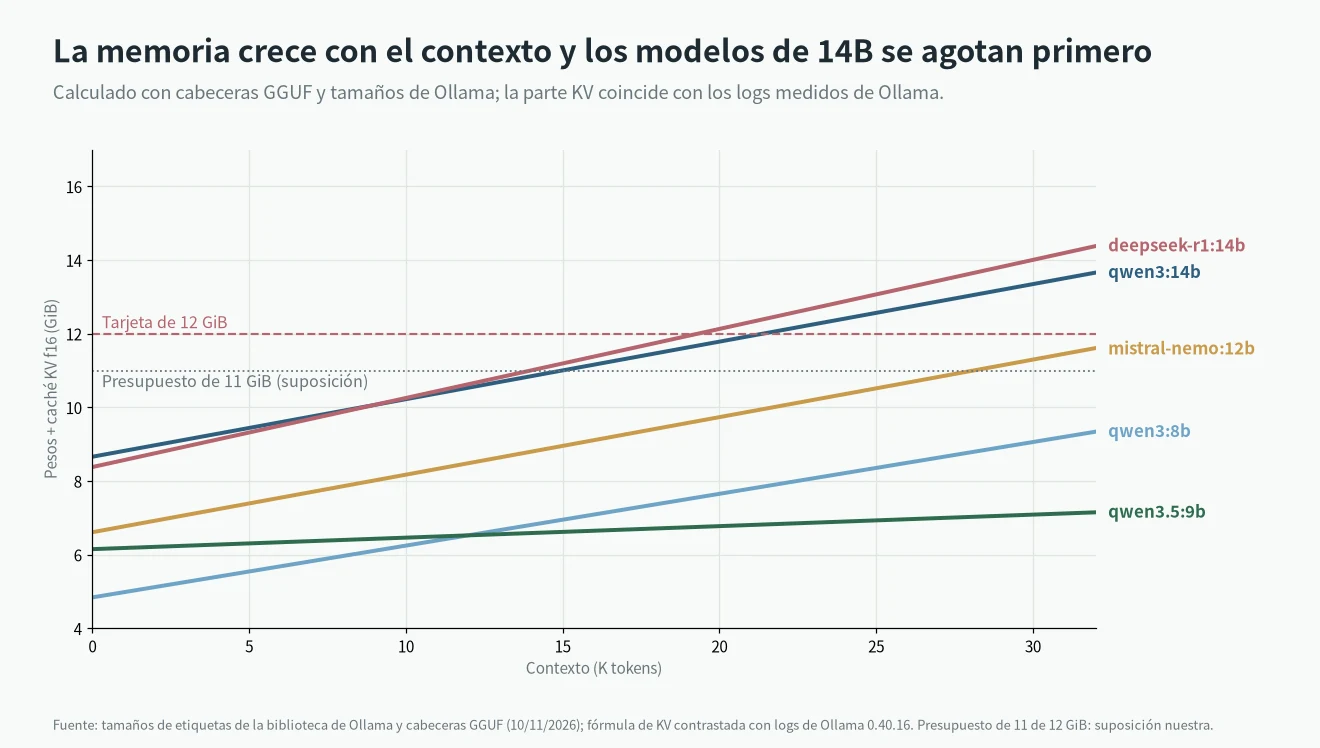
La caché de 8 bits: qué ahorra y qué cuesta
La FAQ de Ollama dice que OLLAMA_KV_CACHE_TYPE puede ser f16 (por defecto), q8_0 o q4_0, necesita Flash Attention y se aplica a todos los modelos a la vez. Describe q8_0 como la mitad de memoria con muy poca pérdida de precisión. Medimos el lado de la memoria en qwen3:8b: 306 MiB frente a 576 a 4K, y 2.448 frente a 4.608 a 32K.
No medimos la calidad. La misma FAQ avisa de que los modelos con muchos grupos GQA, y nombra a Qwen2, pueden verse más afectados. La cabecera de deepseek-r1:14b indica arquitectura qwen2, así que pruébalo con tus propios prompts antes de fiarte de q8_0.
Cómo elegir
- Documentos largos o agentes: qwen3.5:9b. Comprueba que tu versión de Ollama y tu cliente lo soportan, porque su arquitectura es nueva.
- La mejor calidad que aún cabe: un modelo de 14B con el contexto en unos 12K a 14K, y caché de 8 bits si necesitas más. Fija
num_ctxtú mismo; mira la longitud de contexto en Ollama. - Seguro y rápido: un modelo de 8B. Si un modelo no cabe, Ollama puede dejar algunas capas en la CPU y va más lento; Ollama no usa la GPU explica cómo comprobarlo.
Para una lista más amplia, mira los mejores LLM locales según VRAM. Para otros tamaños de tarjeta, los requisitos de GPU de Ollama por VRAM y nuestra calculadora de VRAM; y si aún eliges tarjeta, la mejor GPU calidad-precio para LLM.
Qué probamos y qué está calculado
- Medido el 10 de noviembre de 2026, Ollama 0.40.16, solo CPU: tamaño de la caché KV de llama3.2:1b, qwen3:8b (f16 y q8_0) y qwen3.5:9b con varios contextos. Todo coincidió con la fórmula.
- Calculado: todos los números de los modelos de 14B y 12B y de llama3.1:8b, y la columna de «contexto máx.». Los datos de entrada son las cabeceras GGUF y los tamaños de Ollama.
- Supuesto: el presupuesto de 11 GiB. Aquí no hay tarjeta de 12 GB y no medimos uso real de VRAM, velocidad ni calidad.
- Dejado fuera: Gemma 3 y Gemma 4. Sus capas mezclan atención local y global, y nuestra ejecución de gemma4:12b registró varios búferes de caché (64, 480, 8 y 36 MiB a 4K) que no pudimos reducir a un solo número. qwen3:8b a 64K y qwen3.5:9b a 128K tampoco cargaron en esta máquina, así que esos puntos no están medidos.
- Fuentes: las etiquetas de la biblioteca de modelos de Ollama, la FAQ de Ollama y las cabeceras GGUF que sirve registry.ollama.ai.
Preguntas frecuentes
¿Qué LLM puedo ejecutar con 12GB de VRAM?
Caben modelos de hasta unos 14B parámetros con cuantización de 4 bits, pero los de 14B dejan solo de 12K a 14K tokens de contexto con caché f16. Los de 8B y 9B dejan mucho más.
¿Cabe qwen3:14b en 12GB de VRAM?
Los pesos sí (unos 8,7 GiB). Con caché f16 y 1 GiB de margen, el contexto llega a unos 14K tokens. Con caché q8_0, a unos 28K.
¿Cuánta VRAM usa la ventana de contexto?
En un modelo estándar, 2 x capas x cabezas KV x tamaño de cabeza x 2 bytes por token. qwen3:8b usa 147.456 bytes por token, 4,5 GiB a 32K.
¿gpt-oss:20b funciona con 12GB?
No entero en la GPU. Solo sus pesos son 12,85 GiB, más que la tarjeta.
¿Debo usar caché KV q8_0?
En nuestra prueba reduce la memoria de la caché a la mitad. La FAQ de Ollama habla de muy poca pérdida de precisión, pero avisa de que algunos modelos, como Qwen2, pueden verse más afectados. Prueba con tus propios prompts.