
Requisitos de GPU de Ollama: cuánta VRAM según el tamaño del modelo (de 4 a 80 GB, probado en v0.40.16)
La documentación de Ollama indica GPU compatibles, no una VRAM mínima. Esta guía da los requisitos oficiales, qué cabe en nueve tamaños de VRAM de 4 a 80 GB con los tamaños de descarga de la biblioteca, y nuestra medición en v0.40.16 de cómo el contexto aumenta el uso de memoria.
 bufferSobre el autor7 min de lectura
Los requisitos de GPU de Ollama que publica la documentación oficial indican qué GPU son compatibles, no una cantidad mínima de VRAM: NVIDIA necesita capacidad de cálculo 5.0 o superior y controlador 550 o más reciente (570 o más reciente para las tarjetas de 5.0 a 6.2), AMD usa ROCm v7, Apple usa Metal y el resto de tarjetas puede usar Vulkan. La VRAM que necesitas depende de si caben el modelo y su contexto. Por eso esta guía tiene dos mitades: los requisitos oficiales y, después, nueve niveles de VRAM (4, 6, 8, 12, 16, 24, 32, 48 y 80 GB) con los tamaños de descarga reales de la biblioteca de Ollama. También medimos una cosa en Ollama v0.40.16: con el mismo modelo de 1,3 GB, subir el contexto de 4096 a 131072 llevó la memoria que muestra ollama ps de 2,0 GB a 6,9 GB. Fuentes consultadas el 10 de noviembre de 2026.
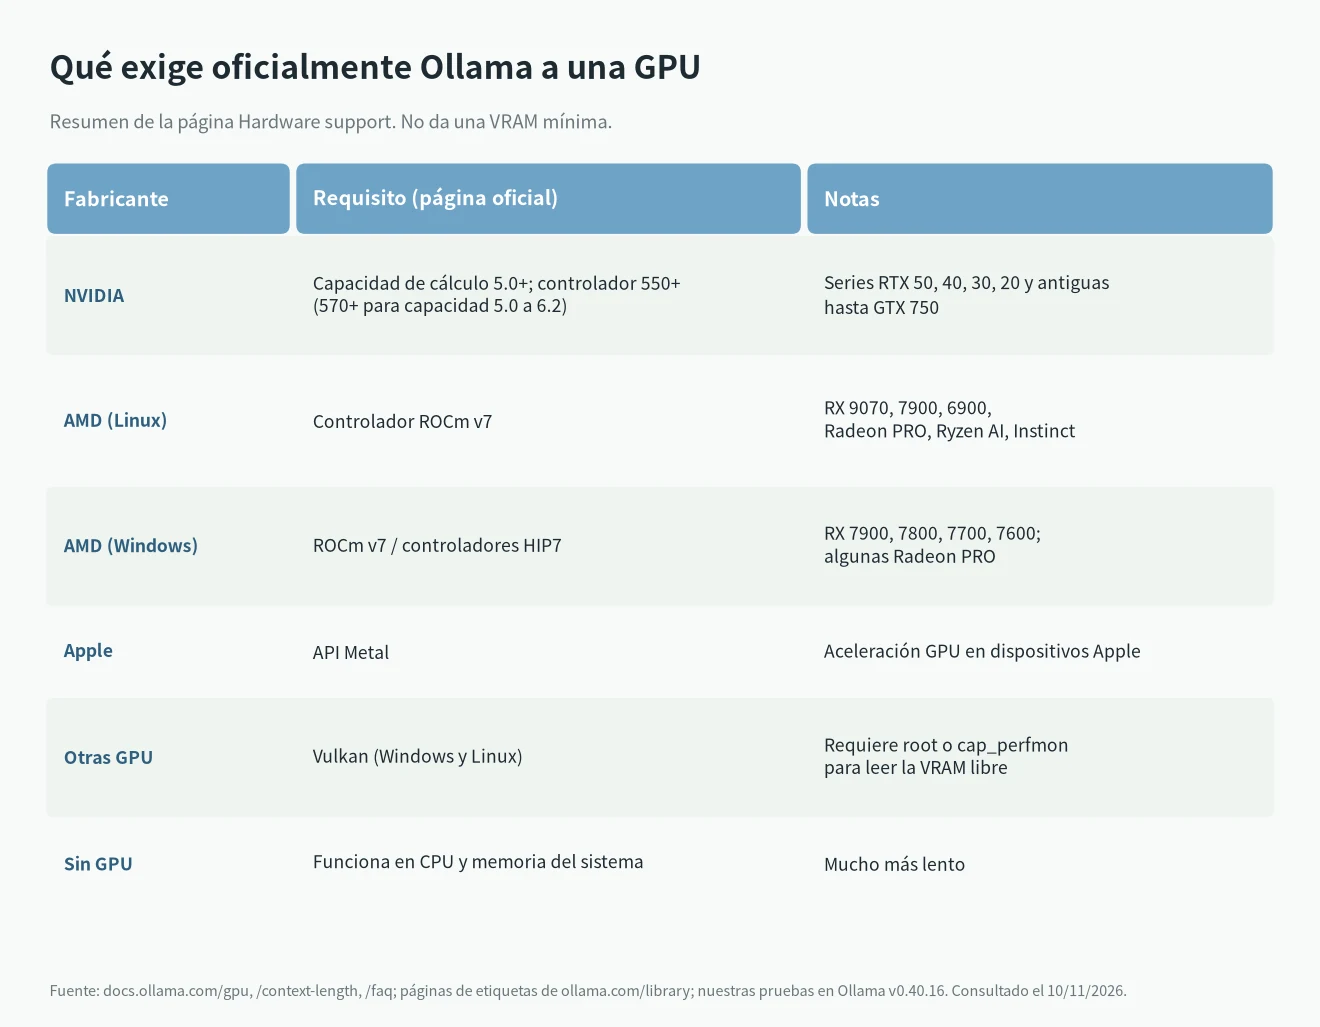
Qué exige oficialmente Ollama a una GPU
Este es el resumen de la página oficial Hardware support de Ollama.
Cosas que se pasan por alto con facilidad:
- No hay un mínimo oficial de VRAM. Si el modelo no cabe, Ollama no se niega a ejecutarlo: pone una parte en la memoria del sistema y la velocidad baja.
- Si una instalación nueva no usa tu GPU, comprueba primero la versión del controlador y la capacidad de cálculo. Las tarjetas antiguas (capacidad de cálculo de 5.0 a 6.2) necesitan controlador 570 o más reciente, y ahí se atascan muchos. Busca tu tarjeta en la página CUDA GPUs de NVIDIA.
- La lista de AMD para Windows es más corta que la de Linux: series RX 7900, 7800, 7700 y 7600 y algunas tarjetas PRO.
- La ruta Vulkan necesita una capacidad extra (root o
cap_perfmon) para leer la VRAM libre. Sin ella, Ollama estima a partir del tamaño de los modelos.
Qué cabe en cada tamaño de VRAM
Los tamaños de esta tabla salen de las páginas de etiquetas de la biblioteca de Ollama (cuantización por defecto, 10 de noviembre de 2026) y no incluyen el contexto. Las etiquetas siguen una regla práctica nuestra, no un estándar oficial: «cabe» significa que el archivo ocupa como máximo el 65 % de la VRAM, «justo» entre el 65 % y el 90 %, así que conviene un contexto corto, y «no» más del 90 %, de modo que parte del modelo irá a la CPU.
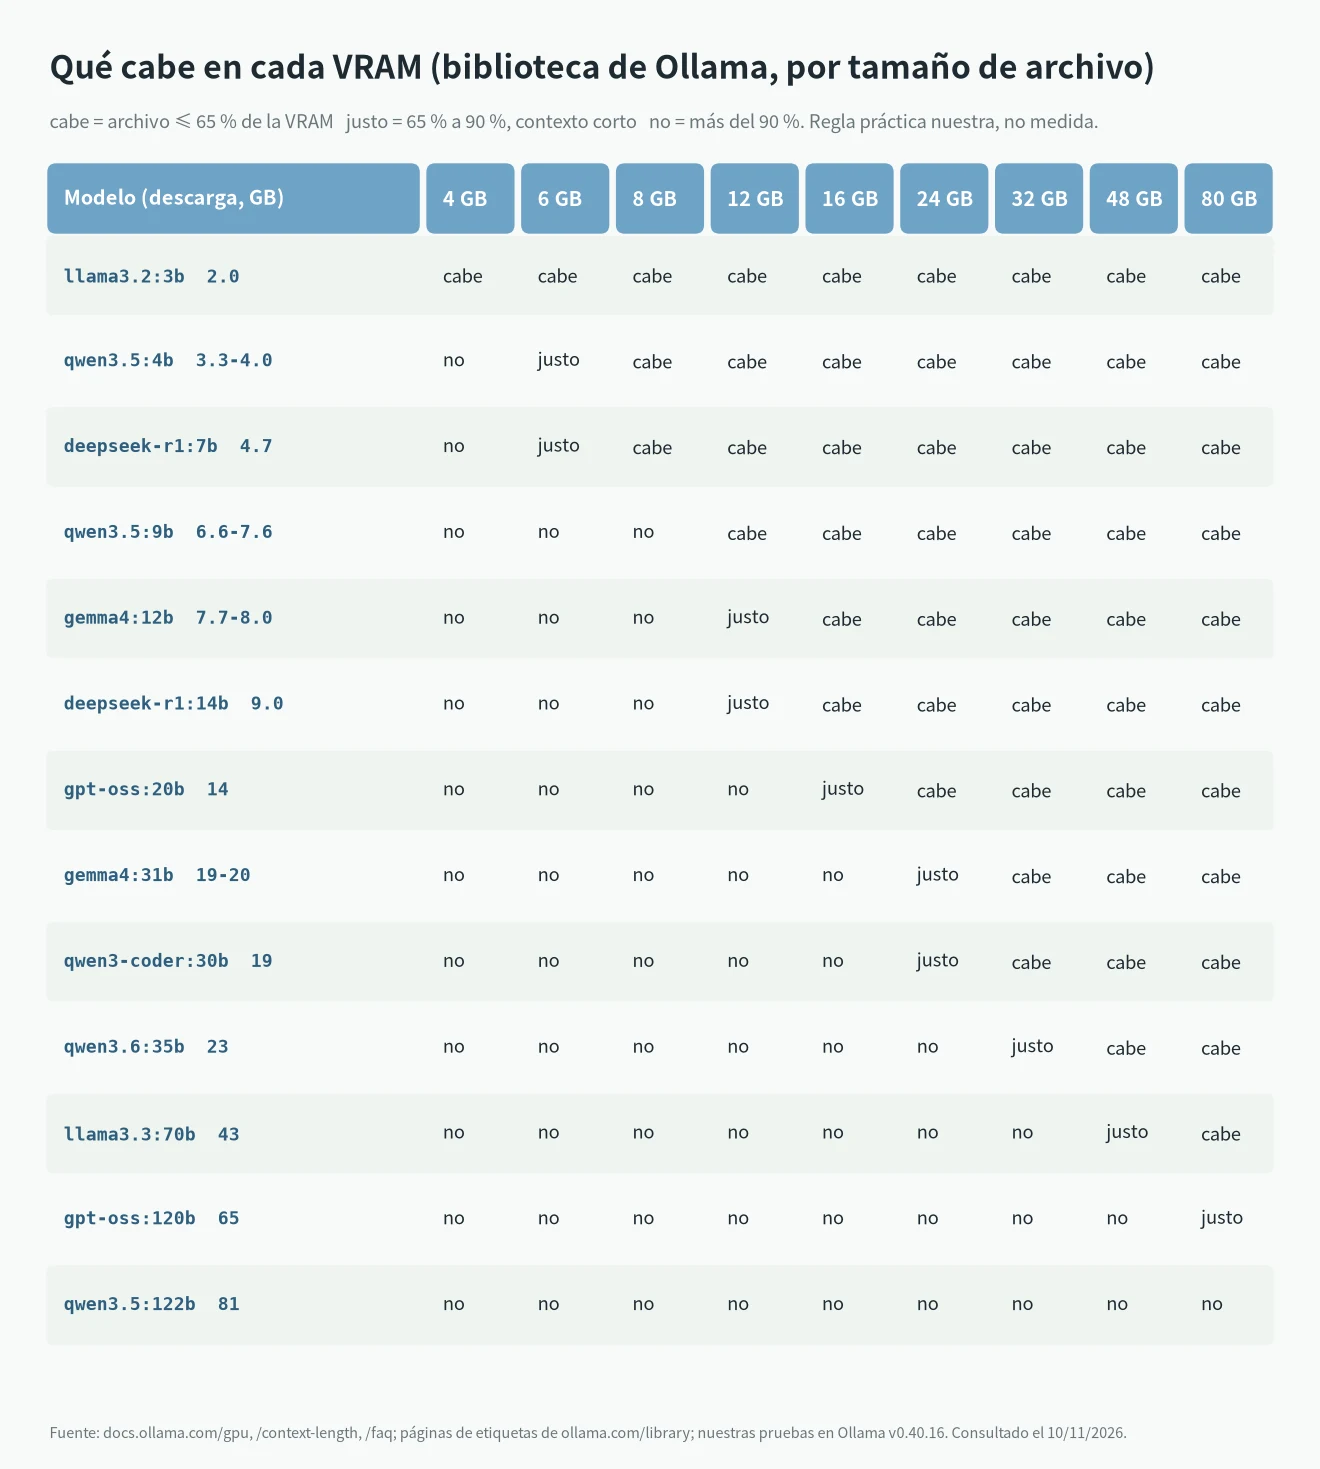
Cómo leerla:
- 4 GB: modelos pequeños de menos de 3B, como llama3.2:3b (2,0 GB).
- 6 a 8 GB: la clase de 7B a 8B. deepseek-r1:7b (4,7 GB) va cómodo con 8 GB y justo con 6 GB si no bajas el contexto.
- 12 GB: caben gemma4:12b (7,7 a 8,0 GB) y deepseek-r1:14b (9,0 GB), aunque el de 14B deja poco margen.
- 16 GB: gpt-oss:20b (14 GB) cabe con poco margen; la clase de 14B va holgada.
- 24 GB: la clase de 27B a 31B, como gemma4:31b (19 a 20 GB), qwen3-coder:30b (19 GB) y qwen3.6:27b (18 a 19 GB). El contexto decide cuánto margen queda.
- 32 GB: la clase de 35B: qwen3.6:35b (23 GB), qwen3.5:35b (22 GB).
- 48 GB: la clase de 70B (llama3.3:70b y deepseek-r1:70b ocupan 43 GB) cabe justo, con poco sitio para el contexto.
- 80 GB: cabe gpt-oss:120b (65 GB); qwen3.5:122b (81 GB) no.
Apple silicon y las máquinas de memoria unificada, como Ryzen AI Max, tienen sus propias reglas de memoria utilizable, que esta guía no cubre. Para cifras exactas usa la calculadora de VRAM, y para elegir modelo por nivel mira los mejores LLM locales según VRAM.
Cuánta VRAM se come el contexto
La página oficial Context length de Ollama dice que el contexto por defecto depende de la VRAM: 4k por debajo de 24 GiB, 32k de 24 a 48 GiB y 256k con 48 GiB o más. Para programación y agentes recomienda al menos 64000 tokens. Un contexto más largo necesita más memoria.
Lo medimos en Ollama v0.40.16 en una máquina Linux sin GPU. El modelo era llama3.2:1b (1,3 GB en la biblioteca), cada ejecución generó un solo token, solo cambió num_ctx y leímos la columna SIZE de ollama ps.
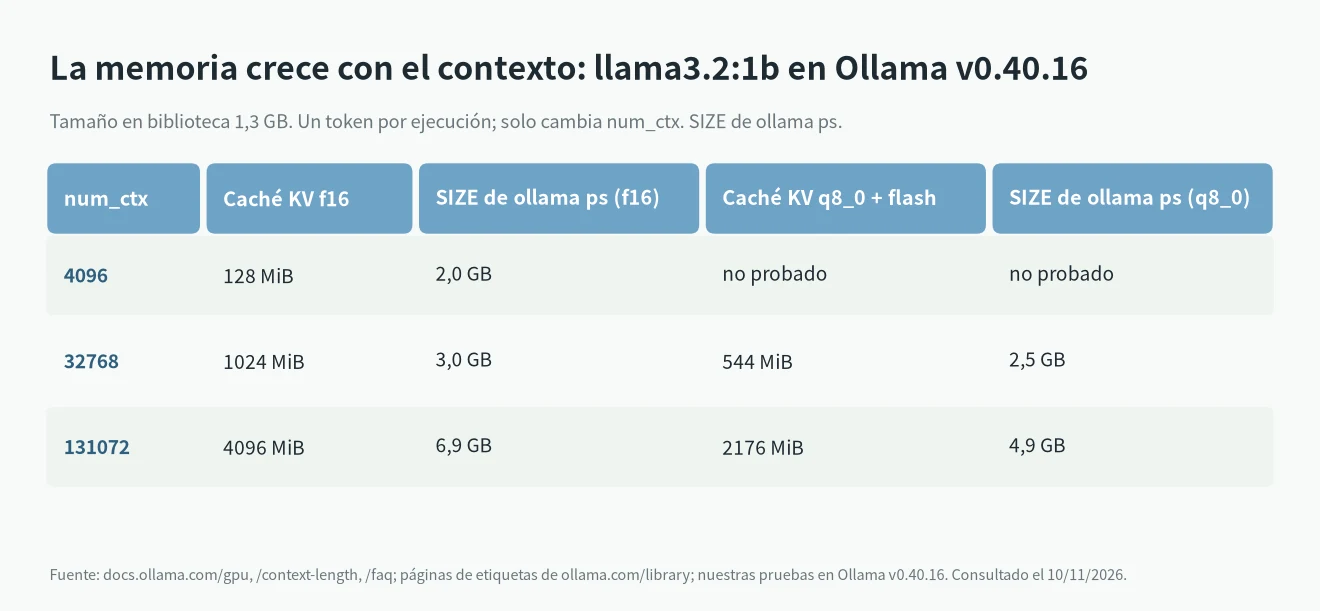
Resultado: el mismo modelo ocupó 2,0 GB con contexto 4096, 3,0 GB con 32768 y 6,9 GB con 131072. La caché KV (la línea llama_kv_cache del registro) fue de 128 MiB, 1024 MiB y 4096 MiB. Cuantizar la caché a q8_0 con Flash Attention activado (OLLAMA_KV_CACHE_TYPE y OLLAMA_FLASH_ATTENTION de la FAQ oficial) redujo la caché de 131072 a 2176 MiB, y ollama ps mostró 4,9 GB.
Este modelo es diminuto, así que la sobrecarga fija del motor pesa mucho en él. No apliques la proporción de 1,3 GB a 2,0 GB a modelos grandes. Lo que sí vale es la tendencia: el uso de memoria es mayor que la descarga y crece con el contexto. La FAQ oficial añade que con OLLAMA_NUM_PARALLEL mayor que 1, la memoria necesaria crece con OLLAMA_NUM_PARALLEL por OLLAMA_CONTEXT_LENGTH.
Los ajustes están en longitud de contexto en Ollama.
Cuando no cabe y cómo comprobarlo
La FAQ oficial explica que al cargar un modelo, Ollama compara la VRAM que necesita con la libre: si cabe en una GPU, va a ella; si no, se reparte entre las GPU, y lo que aún no cabe va a la memoria del sistema. La columna PROCESSOR de ollama ps muestra el resultado: 100% GPU, 100% CPU o una mezcla como 48%/52% CPU/GPU.
Un detalle que nos encontramos: en nuestra máquina sin GPU, la columna PROCESSOR también mostró 25%/75% CPU/GPU, 52%/48% y 79%/21%, mientras que el registro del servidor de las mismas ejecuciones decía inference compute id=cpu y total_vram="0 B". Así que no uses solo la columna PROCESSOR para decidir si se usa la GPU. Lee también la línea inference compute del registro del servidor y, en máquinas NVIDIA, nvidia-smi. Es una observación nuestra en v0.40.16 y no confirmamos la causa.
Para el error «model requires more system memory», mira esa guía de solución. Otros mensajes de Ollama están en la tabla de errores. Si Ollama usa la CPU aunque tengas tarjeta, mira Ollama no usa la GPU.
Qué probamos y qué viene de la documentación
- Probado (Ollama v0.40.16, Linux, 8 núcleos, 15,6 GiB de RAM, sin GPU): las líneas de registro
inference compute id=cpuyvram-based default context total_vram="0 B" default_num_ctx=4096; queOLLAMA_CONTEXT_LENGTH=64000aparece en la configuración del servidor; el SIZE deollama psde llama3.2:1b y el tamaño de la caché KV con distintos contextos; la caché q8_0 con Flash Attention; y el comportamiento de la columna PROCESSOR descrito arriba. - No probado: el uso de VRAM en ninguna GPU real, los requisitos de controlador NVIDIA y capacidad de cálculo, el soporte AMD ROCm, Vulkan, ni si cada modelo cabe realmente en cada nivel. Los tamaños salen de las páginas de la biblioteca de Ollama y cabe, justo y no salen de nuestra regla práctica, no de mediciones.
- Además: para descargar modelos en esta máquina hizo falta configurar un proxy en el proceso del servidor de Ollama, como cuenta nuestra guía de «max retries exceeded».
- Fuentes: Hardware support, Context length, FAQ, Ollama Library (páginas de etiquetas de gemma4, qwen3.5, qwen3.6, qwen3-coder, deepseek-r1, gpt-oss, llama3.2, llama3.3). Consultadas el 10 de noviembre de 2026.
Si estás comprando tarjeta, mira la guía de GPU calidad-precio.
Preguntas frecuentes
¿Qué GPU necesita Ollama como mínimo?
La página oficial dice NVIDIA con capacidad de cálculo 5.0 o superior y controlador 550 o más reciente (570 o más reciente en las antiguas), la lista de AMD con ROCm, Apple Metal y Vulkan como alternativa. No da un número mínimo de VRAM.
¿Puedo usar Ollama sin GPU?
Sí, funciona en CPU y memoria del sistema. Nuestra máquina de pruebas lo hizo así, y el registro mostró inference compute id=cpu. Es mucho más lento.
¿Qué se puede ejecutar con 4 GB de VRAM?
Modelos pequeños con una descarga de unos 2 GB, como llama3.2:3b (2,0 GB). Lo más grande pasa en parte a la memoria del sistema.
¿Por qué no cabe un modelo si su archivo es menor que mi VRAM?
Por la caché KV. En nuestra prueba, un modelo de 1,3 GB necesitó 6,9 GB con contexto 131072. Acorta el contexto, cuantiza la caché o baja un tamaño de modelo.
¿Ollama exige una GPU NVIDIA?
No. AMD usa ROCm, Apple usa Metal y otras tarjetas pueden usar Vulkan. La página oficial tiene los modelos compatibles exactos.