

Mejor GPU calidad-precio para LLM: guía esencial 2026 de VRAM y tokens por dólar
La mejor GPU calidad-precio para LLM depende de la VRAM que necesitas: la RTX 5060 Ti da más velocidad por dólar, una RTX 3090 usada es la de 24 GB más barata y la RTX 5090 es la opción de 32 GB. Revisado el 28/10/2026.
 bufferSobre el autor10 min de lectura
La mejor GPU calidad-precio para LLM depende de un solo dato: cuánta VRAM necesitan los modelos que quieres usar. Para modelos de hasta 14B, la RTX 5060 Ti de 16 GB a 429 dólares da más tokens por segundo por cada dólar que cualquier otra tarjeta que comparé. Para 24 GB, una RTX 3090 usada por unos 800 dólares sigue siendo la entrada más barata, y mueve modelos de 32B a unos 30 tokens por segundo. Para 32 GB, compra la RTX 5090 a 1.999 dólares: es la más rápida de la lista y cuesta lo mismo por GB que la 5080. Con los precios actuales, evita la RTX 5080 y una RTX 4090 nueva. Compra una RTX Pro 6000 solo si necesitas modelos de 70B o gpt-oss-120b en una sola tarjeta. Los precios son los de lanzamiento de NVIDIA o los de mercado que publica Hardware Corner, y las velocidades salen de las pruebas con llama.cpp de Hardware Corner. Lo revisé todo el 28 de octubre de 2026.
Respuesta corta
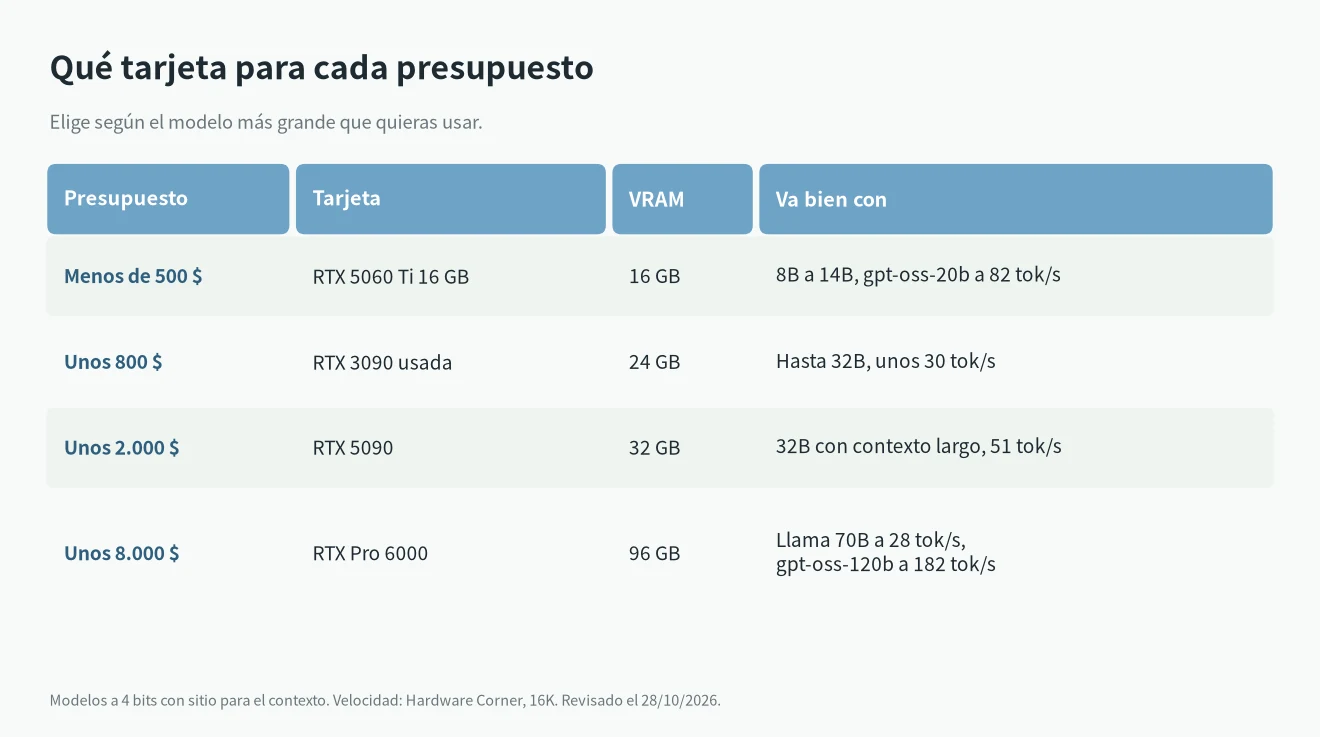
- Menos de 500 dólares: RTX 5060 Ti 16 GB. 12 tokens por segundo por cada 100 dólares en Qwen3 8B, la mejor relación de la lista.
- Unos 800 dólares: una RTX 3090 usada. 24 GB a unos 33 dólares por GB, suficiente para modelos de 32B.
- Unos 2.000 dólares: RTX 5090. 32 GB, 145 tokens por segundo en Qwen3 8B y 51 en Qwen3 32B.
- Unos 8.000 dólares: RTX Pro 6000. 96 GB, la única tarjeta de la lista que ejecuta Llama 70B y gpt-oss-120b sola.
- Evitar: la RTX 5080 (los mismos 16 GB que la 5070 Ti por 250 dólares más) y la RTX 4090 a unos 2.574 dólares, que hoy cuesta más que una 5090.
Cómo elegir la mejor GPU calidad-precio para LLM
Dos números deciden la mejor GPU calidad-precio para LLM. El primero es el precio por GB de VRAM. El modelo entero tiene que caber en la VRAM para ir a toda velocidad, así que la VRAM decide qué modelos puedes usar. A 4 bits, un modelo de 8B necesita unos 6 GB, uno de 14B unos 10 GB y uno de 32B unos 20 GB, más el espacio del contexto. Mi calculadora de VRAM hace esta cuenta para cualquier modelo.
El segundo es la velocidad por dólar. Si el modelo cabe, la velocidad de generación depende sobre todo del ancho de banda de memoria, porque la tarjeta lee los pesos una vez por cada token. Uso los tokens por segundo de Qwen3 8B con 16K de contexto del ranking de GPU de Hardware Corner, que prueba todas las tarjetas con la misma configuración de llama.cpp, y los divido por el precio.
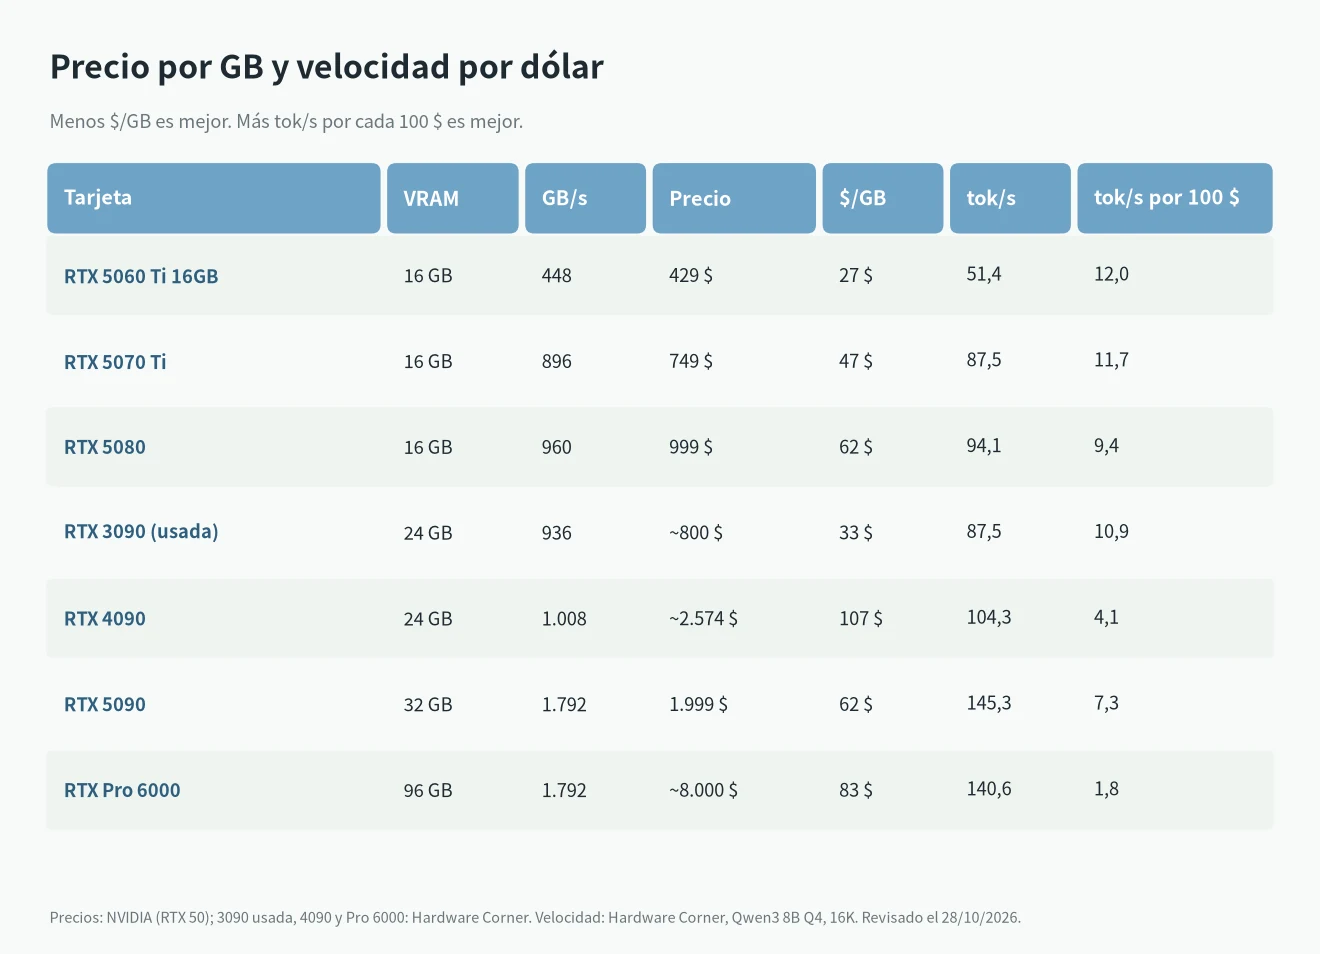
Para la serie RTX 50 uso los precios de lanzamiento de NVIDIA: 1.999 dólares la RTX 5090 y 999 la RTX 5080 (NVIDIA, enero de 2025), 749 la RTX 5070 Ti y 429 la RTX 5060 Ti de 16 GB (NVIDIA, abril de 2025). La RTX 3090 y la 4090 ya no se fabrican, y la RTX Pro 6000 no tiene precio público, así que para esas uso los precios de mercado de Hardware Corner. Los precios en tienda cambian cada semana, y con ellos la mejor GPU calidad-precio para LLM. Repite la división con el precio que veas.
Velocidad real de cada tarjeta
La velocidad es la otra mitad de la mejor GPU calidad-precio para LLM. Esta es la velocidad de generación en tokens por segundo de tres modelos comunes con 16K de contexto, todo de la misma prueba de Hardware Corner.
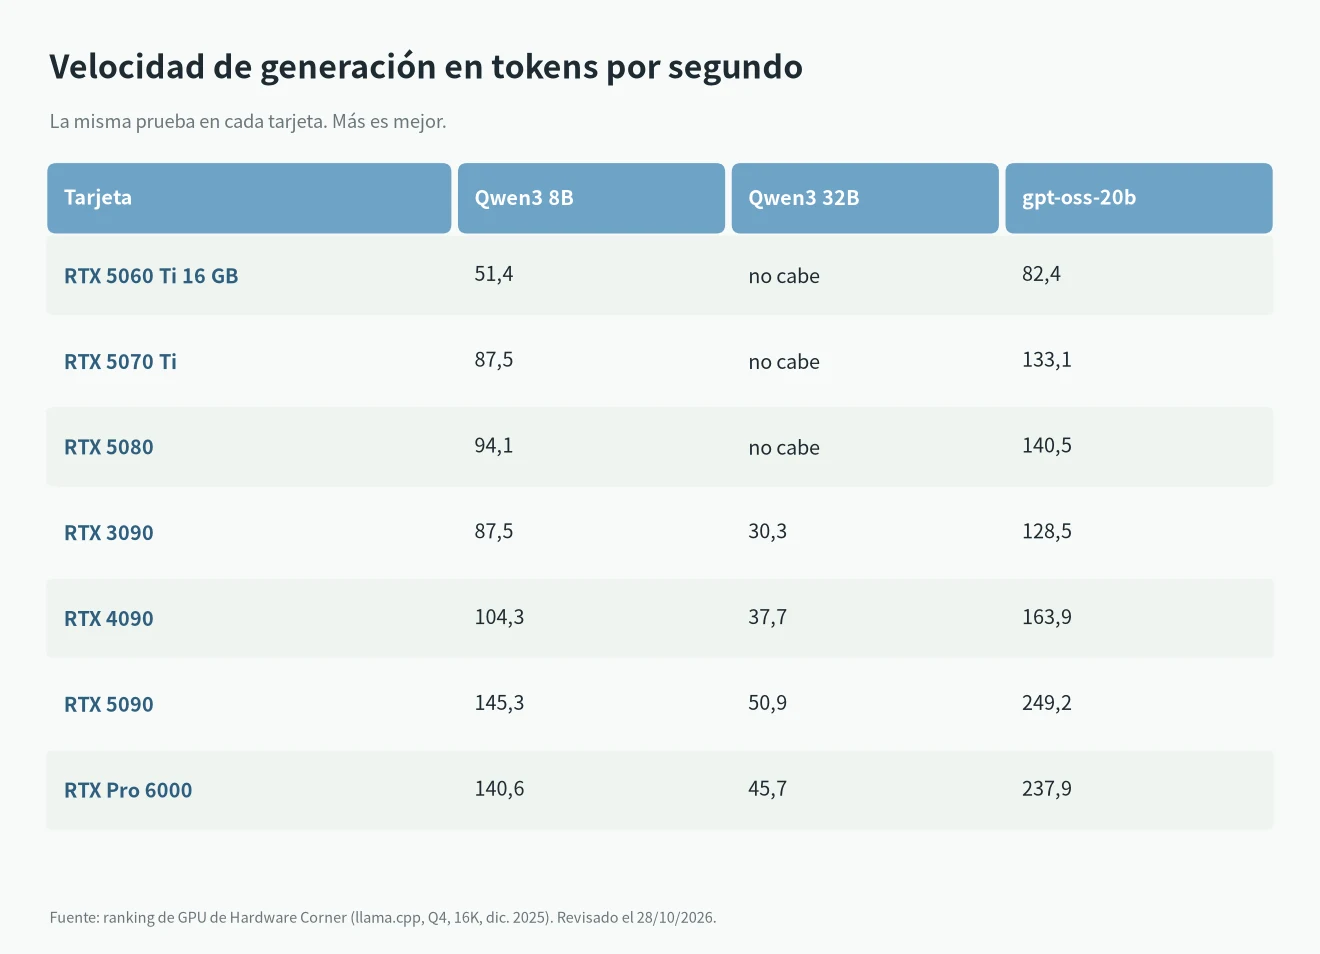
Hay tres cosas que destacan. Primero, las tarjetas de 16 GB no pueden ejecutar modelos de 32B, por rápidas que sean. Segundo, la RTX 3090 escribe Qwen3 8B igual de rápido que la RTX 5070 Ti (87,5 tokens por segundo las dos), porque su ancho de banda es parecido: 936 frente a 896 GB/s. Tercero, la RTX Pro 6000 no es más rápida que la RTX 5090 en modelos que caben en ambas. Las dos tienen 1.792 GB/s. Pagas por 64 GB más de VRAM, no por velocidad. Para ver la 5090 frente a la 4090 con más detalle, lee mi artículo sobre si la RTX 5090 para IA vale la pena.
La mejor GPU calidad-precio para LLM según tu presupuesto
Menos de 500 dólares: RTX 5060 Ti 16 GB
Por 429 dólares, la RTX 5060 Ti de 16 GB escribe 51,4 tokens por segundo en Qwen3 8B y 82,4 en gpt-oss-20b. Son 12 tokens por segundo por cada 100 dólares, la mejor relación de la lista. Su punto débil es el ancho de banda: 448 GB/s, la mitad que la 5070 Ti, así que se frena más con prompts y contextos largos. Es nueva, tiene garantía y consume mucho menos que una 3090. Si solo usas modelos de 8B a 14B, es la mejor GPU calidad-precio para LLM que puedes comprar nueva.
Unos 800 dólares: una RTX 3090 usada
Hardware Corner sitúa la RTX 3090 usada en unos 800 dólares. Son unos 33 dólares por GB, y ninguna tarjeta nueva da 24 GB por menos. 24 GB es el salto que importa: Qwen3 32B a 4 bits va a unos 30 tokens por segundo, y ninguna tarjeta de 16 GB lo puede cargar. El precio a pagar: es usada, sin garantía, consume mucho (350 W) y es grande. Pruébala antes de pagar y revisa los ventiladores y la temperatura de la memoria. Para ver qué cabe en 24 GB, lee mi guía de modelos que puede ejecutar la RTX 4090; la 3090 mueve los mismos modelos, solo que más despacio.
Si quieres nueva y 16 GB: RTX 5070 Ti
La RTX 5070 Ti a 749 dólares tiene el doble de ancho de banda que la 5060 Ti y escribe Qwen3 8B un 70 % más rápido, a 87,5 tokens por segundo. Por dólar queda cerca de la 5060 Ti. Elígela si te importa más la velocidad con modelos pequeños que el precio. La RTX 5080 a 999 dólares solo es un 8 % más rápida que la 5070 Ti y tiene los mismos 16 GB, así que no es la mejor GPU calidad-precio para LLM.
Unos 2.000 dólares: RTX 5090
La RTX 5090 es la tarjeta más rápida que comparé. Escribe Qwen3 32B a 50,9 tokens por segundo, frente a 37,7 de la 4090 y 30,3 de la 3090, y sus 32 GB dejan sitio para contextos largos con modelos de 32B. A 1.999 dólares de lanzamiento cuesta 62 dólares por GB, lo mismo que la 5080 con el doble de VRAM. Hardware Corner la lista a 2.499 dólares en tienda. Aun a ese precio es mejor compra que una RTX 4090 a unos 2.574 dólares.
Unos 8.000 dólares: RTX Pro 6000
La RTX Pro 6000 tiene 96 GB en una sola tarjeta. Es la única de la lista que ejecuta Llama 3.3 70B (28,2 tokens por segundo) y gpt-oss-120b (182,2 tokens por segundo) sin dividir el modelo. Por GB, a unos 83 dólares, sale más barata que una 4090. Si sobre todo necesitas mucha memoria y no te importa tanto la velocidad de CUDA, compárala también con un Mac o una DGX Spark en mi comparativa DGX Spark vs Mac Studio.
Tarjeta gráfica AMD para IA: RX 7900 XTX y RX 9070 XT
Si buscas la mejor tarjeta gráfica calidad-precio para IA y no quieres NVIDIA, AMD tiene dos opciones con sentido. La RX 7900 XTX trae 24 GB, como una RTX 3090 o 4090. La RX 9070 XT trae 16 GB, como la RTX 5070 Ti, y cuesta menos.
| Tarjeta | VRAM | Ancho de banda | Precio de lanzamiento | Dólares por GB | Llama 2 7B Q4_0, tg128 (Vulkan) |
|---|---|---|---|---|---|
| RX 7900 XTX | 24 GB | 960 GB/s | 999 $ | 41,6 | 182,6 tok/s |
| RX 9070 XT | 16 GB | 640 GB/s | 599 $ | 37,4 | 137,1 tok/s |
| RTX 4090 | 24 GB | 1.008 GB/s | 1.599 $ | 66,6 | 188,0 tok/s |
| RTX 3090 usada | 24 GB | 936 GB/s | unos 800 $ | 33,3 | 164,1 tok/s |
| RTX 5070 Ti | 16 GB | 896 GB/s | 749 $ | 46,8 | 135,6 tok/s |
Las velocidades salen de la tabla de Vulkan de llama.cpp, la misma prueba para todas las tarjetas, así que AMD y NVIDIA se comparan en igualdad. Los precios de AMD son los de sus notas oficiales de lanzamiento de la RX 7900 XTX y la RX 9070 XT. La 7900 XTX escribe casi igual de rápido que una 4090 con la misma VRAM y cuesta 600 dólares menos. La 9070 XT empata con la 5070 Ti. Con CUDA las NVIDIA sacan algo más: la RTX 5090 pasa de 263,6 tokens por segundo en Vulkan a 290 en la tabla de CUDA.
La pega es el software. llama.cpp, Ollama y LM Studio funcionan bien con Radeon, pero muchas herramientas para entrenar o afinar modelos, y casi todos los proyectos nuevos, salen primero para CUDA. Mi consejo: si solo vas a chatear con modelos en local, la RX 7900 XTX es la forma más barata de tener 24 GB en una tarjeta nueva. Si quieres afinar modelos o probar todo lo que sale, quédate con NVIDIA.
Sobre los euros: NVIDIA marca en España un PVPR de 2.099 € para la RTX 5090, unos 65,6 € por GB de VRAM. En 2026 muchas tiendas venden por encima del precio recomendado, así que haz la cuenta con el precio real: divide lo que cuesta la tarjeta entre sus GB y compara. Datos revisados el 28 de octubre de 2026.
¿Y dos tarjetas baratas?
Dos RTX 5060 Ti de 16 GB cuestan 858 dólares a precio de lanzamiento y suman 32 GB, más que una 3090. llama.cpp y Ollama pueden repartir un modelo entre las dos. Pero la velocidad no se suma: con un solo usuario, las tarjetas trabajan por turnos, así que obtienes más o menos la velocidad de una tarjeta con un modelo el doble de grande. También necesitas una placa con dos ranuras PCIe x16 y una fuente más potente. Dos RTX 3090 usadas (48 GB) son el camino barato habitual para 70B a 4 bits, pero es un proyecto, no una mejora de enchufar y listo.
Lo que no compraría para LLM
- Tarjetas de 8 GB: solo caben modelos de unos 7B a 4 bits. Gasta 50 dólares más en la 5060 Ti de 16 GB.
- La RTX 5080: 16 GB por 999 dólares. La 5070 Ti hace casi lo mismo por 250 dólares menos.
- Una RTX 4090 nueva a 2.500 dólares o más: 24 GB por más de lo que cuesta una RTX 5090 de 32 GB a precio de lanzamiento.
Si aún no sabes qué modelos vas a usar, empieza por mi lista de los mejores LLM locales para cada cantidad de VRAM y luego elige la tarjeta.
Preguntas frecuentes
¿Cuál es la mejor GPU calidad-precio para LLM en 2026?
Para modelos de hasta 14B, la RTX 5060 Ti de 16 GB a 429 dólares. Para 24 GB, una RTX 3090 usada por unos 800 dólares. Para 32 GB, la RTX 5090 a 1.999 dólares.
¿Sigue valiendo la pena una RTX 3090 usada para LLM?
Sí, si necesitas 24 GB con poco presupuesto. Por unos 800 dólares es la tarjeta de 24 GB más barata y mueve Qwen3 32B a unos 30 tokens por segundo. Pruébala antes de comprarla, porque no tiene garantía.
¿La RTX 5090 es mejor compra que la RTX 4090 para LLM?
Con los precios actuales, sí. La 5090 tiene 32 GB en lugar de 24 GB, genera tokens entre 1,35 y 1,5 veces más rápido, y su precio de lanzamiento de 1.999 dólares es menor que los unos 2.574 dólares a los que se vende la 4090.
¿Merece la pena una tarjeta gráfica AMD para IA?
Sí, si vas a ejecutar modelos con llama.cpp, Ollama o LM Studio. La RX 7900 XTX da 24 GB por 999 dólares de lanzamiento y en Vulkan va casi igual que una RTX 4090 (182,6 frente a 188,0 tokens por segundo). Para entrenar o afinar modelos, NVIDIA sigue siendo más cómoda por CUDA.
¿Cuánta VRAM necesito para ejecutar LLM en local?
16 GB para modelos de 8B a 14B, 24 GB para modelos de 32B y 48 GB o más para modelos de 70B, todo a 4 bits. Los contextos largos necesitan más.