

Ollama «model requires more system memory»: 6 soluciones probadas paso a paso
Ollama no carga el modelo y muestra "model requires more system memory (X GiB) than is available (Y GiB)". Lo reprodujimos con qwen2.5:14b en un equipo de 15,6 GiB, medimos cuánto cambia la estimación con el contexto y comprobamos cada solución con el código, el FAQ y los issues de Ollama.
 bufferSobre el autor9 min de lectura
Ya descargaste el modelo, escribes ollama run y en vez del prompt aparece ollama model requires more system memory: Error: 500 Internal Server Error: model requires more system memory (14.0 GiB) than is available (10.3 GiB). No siempre hace falta comprar más RAM: buena parte del primer número depende de la configuración. Reprodujimos el error en un equipo Linux con 15,6 GiB de RAM, sin swap y sin GPU, con Ollama 0.24.0 y qwen2.5:14b (archivo de 9,0 GB). Todas las cifras de este artículo salen de esa máquina, y cada solución está contrastada con el código fuente de Ollama, su FAQ oficial y los issues de GitHub.
Qué significan los dos números de ollama model requires more system memory
El primer número es la memoria que Ollama calcula que necesita esta carga. El segundo, la que cree que tienes libre. En el código de Ollama v0.24.0 la comprobación está en verifyLayout, dentro de llm/server.go. Lo necesario son los pesos del modelo que quedan en la CPU, más la caché KV (la memoria que ocupa el contexto), más el grafo de cálculo. Lo disponible es la memoria libre más la swap libre. Si lo primero es mayor, Ollama no carga el modelo y devuelve el error ollama model requires more system memory. En macOS esta comprobación no se hace, así que lo verás sobre todo en Linux y Windows.
En Linux, la «memoria libre» es MemAvailable de /proc/meminfo, el mismo valor que la columna available de free -h. En la prueba free -h marcaba 10Gi disponibles y el log de Ollama decía available="10.3 GiB": coinciden. En contenedores el cálculo cambia; lo vemos en la solución 6.
Hay dos salidas: bajar el primer número o subir el segundo. Los pesos casi no cambian. Lo que más pesa es la longitud del contexto.
Nuestra prueba: mismo modelo, solo cambia el contexto
Con la configuración por defecto, qwen2.5:14b cargó y respondió. Luego reiniciamos el servidor con OLLAMA_CONTEXT_LENGTH=32768, lo volvimos a ejecutar y salió el error. Pasar num_ctx en una petición a la API da el mismo resultado. Esta es la salida real de la terminal. El puerto 11435 es el de la segunda instancia de Ollama que usamos para la prueba; el tuyo por defecto es 11434.
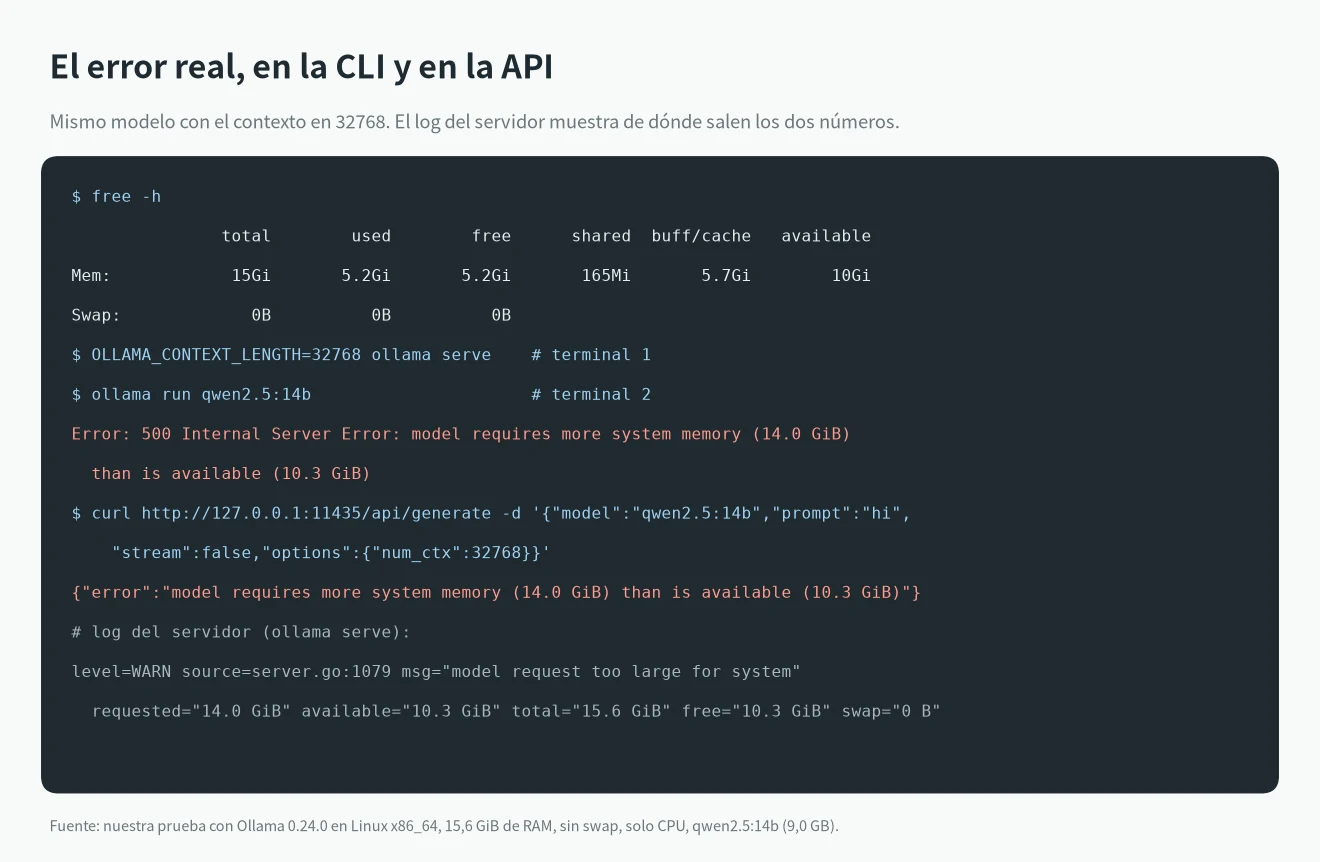
La línea del log model request too large for system deja claras las cifras: requested="14.0 GiB" available="10.3 GiB" total="15.6 GiB" free="10.3 GiB" swap="0 B". Después cambiamos solo num_ctx y probamos varios valores:
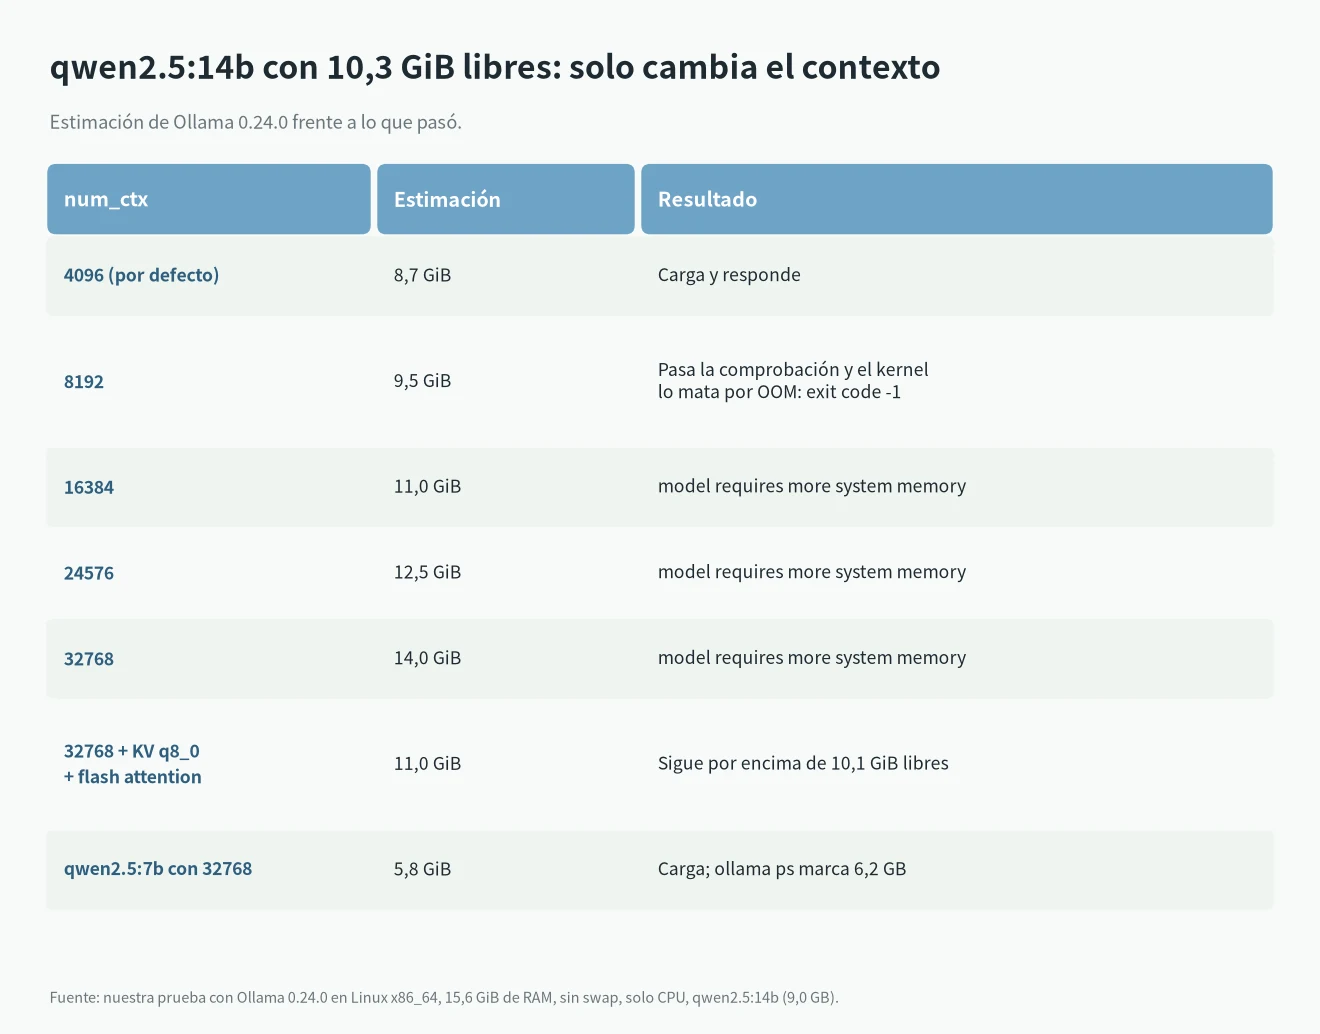
De 4096 a 32768, la estimación sube de 8,7 GiB a 14,0 GiB con el mismo archivo. Un resultado merece aviso: con 8192 la estimación fue de 9,5 GiB y pasó la comprobación, pero el OOM killer del kernel mató el proceso durante la carga. La API devolvió llama runner process has terminated with exit code -1 y en dmesg aparecía Out of memory: Killed process. Si la estimación queda justo por debajo de lo disponible, puede fallar igual, así que deja margen.
6 soluciones para ollama model requires more system memory
1. Baja la longitud del contexto (num_ctx)
Es lo más rápido. Según el FAQ de Ollama, el contexto por defecto es de 4096 tokens. Si tú o alguna herramienta lo subieron, la memoria necesaria sube con él. Se puede fijar en tres sitios; cambia el que realmente uses:
# en todo el servidor (afecta a todas las peticiones)
OLLAMA_CONTEXT_LENGTH=8192 ollama serve

# dentro de una sesión de ollama run
/set parameter num_ctx 8192

# en cada petición a la API
curl http://localhost:11434/api/generate -d '{"model":"qwen2.5:14b","prompt":"hi","options":{"num_ctx":8192}}'
Muchas veces no lo tocaste tú, sino un plugin. En el issue #7423, un usuario que llamaba a Ollama en Docker desde el plugin Continue de IntelliJ recibió este error, y rick-github, mantenedor de Ollama, apuntó a que Continue usaba una ventana de contexto grande. Si en la terminal funciona y en el plugin del editor falla, revisa primero el contexto en la configuración del plugin. Luego la columna CONTEXT de ollama ps te dice qué valor se aplicó de verdad.
Las cinco formas de fijar el contexto y el orden en que Ollama las aplica están en nuestra guía de longitud de contexto en Ollama.
2. Revisa OLLAMA_NUM_PARALLEL
El FAQ oficial dice que la RAM necesaria escala con OLLAMA_NUM_PARALLEL * OLLAMA_CONTEXT_LENGTH. Hoy el valor por defecto es 1, y el log de arranque de nuestra 0.24.0 mostraba OLLAMA_NUM_PARALLEL:1. Si en systemd, en un docker compose o en tu shell pusiste 4 u 8, la caché KV se multiplica por ese número. El issue #7423 es de 2024, cuando el valor por defecto todavía era 4, y aquel usuario lo resolvió poniendo OLLAMA_NUM_PARALLEL en 1 y pasando a un modelo más pequeño. Si solo lo usas tú, con 1 basta.
3. Cuantiza la caché KV
El FAQ explica OLLAMA_KV_CACHE_TYPE=q8_0, que necesita Flash Attention (OLLAMA_FLASH_ATTENTION=1). En la misma máquina, la estimación de qwen2.5:14b con 32768 de contexto bajó de 14,0 GiB a 11,0 GiB:
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serveSon 3 GiB menos, pero seguía por encima de los 10,1 GiB libres en ese momento, así que el error se mantuvo. Sirve cuando te falta poco; si te falta mucho, combínalo con la solución 1. Según el FAQ, q8_0 usa más o menos la mitad de memoria que el f16 por defecto, con una pérdida de precisión muy pequeña que normalmente no se nota, aunque avisa que modelos con un GQA alto como Qwen2 pueden verse más afectados.
4. Usa un modelo más pequeño o una cuantización menor
Si de verdad necesitas un contexto largo, lo que tiene que bajar son los pesos. Cambiamos a qwen2.5:7b (archivo de 4,7 GB) con el mismo contexto de 32768: la estimación fue de 5,8 GiB, cargó sin problema y ollama ps mostró 6,2 GB, 100% CPU, CONTEXT 32768. Para calcular la memoria según el modelo y el contexto puedes usar nuestra calculadora de VRAM para LLM locales, y para ver qué cabe en un equipo de 16 GB, nuestra lista de mejores LLM locales.
5. Libera memoria o añade swap
La memoria disponible se mide en el momento de la carga, así que otros programas la reducen. Ejecuta ollama ps para ver si queda otro modelo cargado y descárgalo con ollama stop . Un navegador con muchas pestañas también ocupa bastante. Quien abrió el issue #7423 acabó contando que lo que lo arregló fue cerrar el navegador, que tenía demasiadas ventanas abiertas.
Como el código suma la swap libre a lo disponible, añadir swap también permite pasar la comprobación. En el issue #7942 un usuario tenía useMmap activado y aun así recibía model requires more system memory (17.7 GiB) than is available (13.6 GiB); rick-github respondió que mmap no influye en la comprobación y recomendó añadir swap. En el issue #8667, sobre deepseek-r1:671b (446,3 GiB necesarios) en un equipo de 40 GB, la salida propuesta también fue un archivo de swap grande. No medimos la velocidad con swap; solo podemos decir que la comprobación la cuenta, no que te dé más RAM.
6. Sube el límite de memoria en Docker o LXC
Dentro de un contenedor, Ollama no usa MemAvailable. En el código de v0.24.0, discover/cpu_linux.go lee los archivos de cgroup memory.max y memory.current y toma el total menos memory.current como memoria libre. El problema es que memory.current incluye la caché de archivos. Después de leer el modelo una vez, esa caché puede ocupar varios GB, y Ollama ve poca memoria libre aunque casi toda se pueda recuperar.
El issue #15704 describe justo esto: un contenedor LXC de Proxmox con 32 GiB, MemAvailable de unos 31,9 GiB y aun así model requires more system memory (18.3 GiB) than is available (12.6 GiB). En agosto de 2026 otro usuario confirmó el mismo cálculo en la 0.32.9 dentro de Docker. La corrección del PR #13782 todavía no se ha fusionado y el issue sigue abierto. Mientras tanto, dale al contenedor un límite de memoria más alto o ejecuta Ollama directamente en el host, y usa las soluciones 1 a 4 para bajar lo necesario.
¿Desaparece el error al actualizar Ollama?
Comparamos el código de varias versiones. De la v0.21.2 a la v0.24.0, llm/server.go contiene model requires more system memory (%s) than is available (%s). Desde la v0.30.0 hasta la v0.40.0 esa frase ya no aparece en el código de producción. Las versiones nuevas cargan los modelos con llama-server y fallan de otra forma cuando falta memoria.
En la misma máquina probamos la 0.40.13 actual con llama3.2:3b y un contexto de 131072. El log dijo primero projected to use 15468 MiB of host memory vs. 16002 MiB of total host memory, luego failed to fit params to free device memory: was unable to fit model into system memory by reducing context, abort, y la API devolvió llama-server process has terminated: signal: killed. O sea, tras actualizar puede que ya no veas ollama model requires more system memory, pero la falta de memoria sigue ahí y las soluciones de arriba siguen sirviendo. Según el código, las versiones nuevas reintentan con un contexto menor tras un OOM al cargar solo si no fijaste num_ctx tú mismo.
Si tu error de carga es otro, búscalo por su texto exacto en nuestra lista de errores de Ollama y llama.cpp.
Preguntas frecuentes
El archivo del modelo pesa 9 GB. ¿Por qué pide 14 GB?
El archivo solo tiene los pesos. Al cargar también se reserva memoria para la caché KV y el grafo de cálculo, y la caché KV crece con el contexto y con las peticiones en paralelo. En nuestra prueba, el mismo qwen2.5:14b de 9,0 GB se estimó en 8,7 GiB con 4096 de contexto y en 14,0 GiB con 32768.
¿En Mac también sale este error?
En el código de v0.24.0 esta comprobación solo se hace en Linux y Windows. En macOS (darwin) se usa otra regla, y el comentario del código lo justifica porque macOS asigna la swap de forma dinámica. Por eso en Mac casi no verás este mensaje.
¿Puede pasar con GPU?
Sí. Las capas que no caben en la VRAM van a la RAM del sistema, y la comprobación cuenta la parte que queda en la CPU. Nuestra máquina de prueba no tiene GPU, así que esta respuesta se basa en el código fuente.