
Ollama «llama runner process has terminated»: arréglalo según el exit status (3 causas reproducidas en v0.40.16)
El mensaje solo dice que el proceso del modelo murió. La causa está en lo que sigue: exit status 1 y una línea de carga, un código de Windows o una señal de Linux. Reprodujimos tres fallos en Ollama v0.40.16 y ordenamos 65 issues por código.
 bufferSobre el autor9 min de lectura
«Error: llama runner process has terminated» significa que el proceso que ejecuta el modelo murió, pero no dice por qué. El motivo está justo después de los dos puntos: exit status 1 con una línea «error loading model», un código de Windows como 0xc0000409 o una señal de Linux como signal: killed. En Ollama v0.40.16 el mensaje dice «llama-server process has terminated» (56 de las 65 issues de GitHub abiertas desde junio de 2026 usan esa redacción), pero es el mismo fallo que la gente sigue buscando como «llama runner process has terminated». Esta guía ordena esos reportes según lo que sigue a los dos puntos y muestra tres fallos que reprodujimos en v0.40.16, con el texto exacto de cada uno. Todo se comprobó el 10 de noviembre de 2026.
El mismo error con otra redacción
Las versiones antiguas de Ollama imprimían llama runner process has terminated. Las actuales imprimen llama-server process has terminated y, a veces, llama-server process no longer running cuando el proceso ya no existe. El binario de v0.40.16 contiene las dos cadenas de llama-server y no la antigua. En las issues de GitHub abiertas desde el 1 de junio de 2026, 56 usan la redacción nueva y una la antigua. Si tu mensaje difiere del de una guía que encontraste, probablemente es el mismo error.
El mensaje tiene tres partes y solo las dos últimas ayudan:
Error: 500 Internal Server Error:solo indica que la API devolvió un fallo.llama-server process has terminated:indica que el proceso del modelo terminó.- Lo que sigue es el código de salida o la señal, más las últimas líneas que imprimió el proceso. Ahí está la pista.
Dónde ver el texto completo: ejecuta ollama serve en una terminal y léelo ahí, o abre los registros que describe la página de solución de problemas de Ollama (~/.ollama/logs/server.log en Mac, journalctl -u ollama en Linux, %LOCALAPPDATA%\Ollama en Windows, docker logs en un contenedor). La línea justo encima de «terminated» suele ser la causa real.
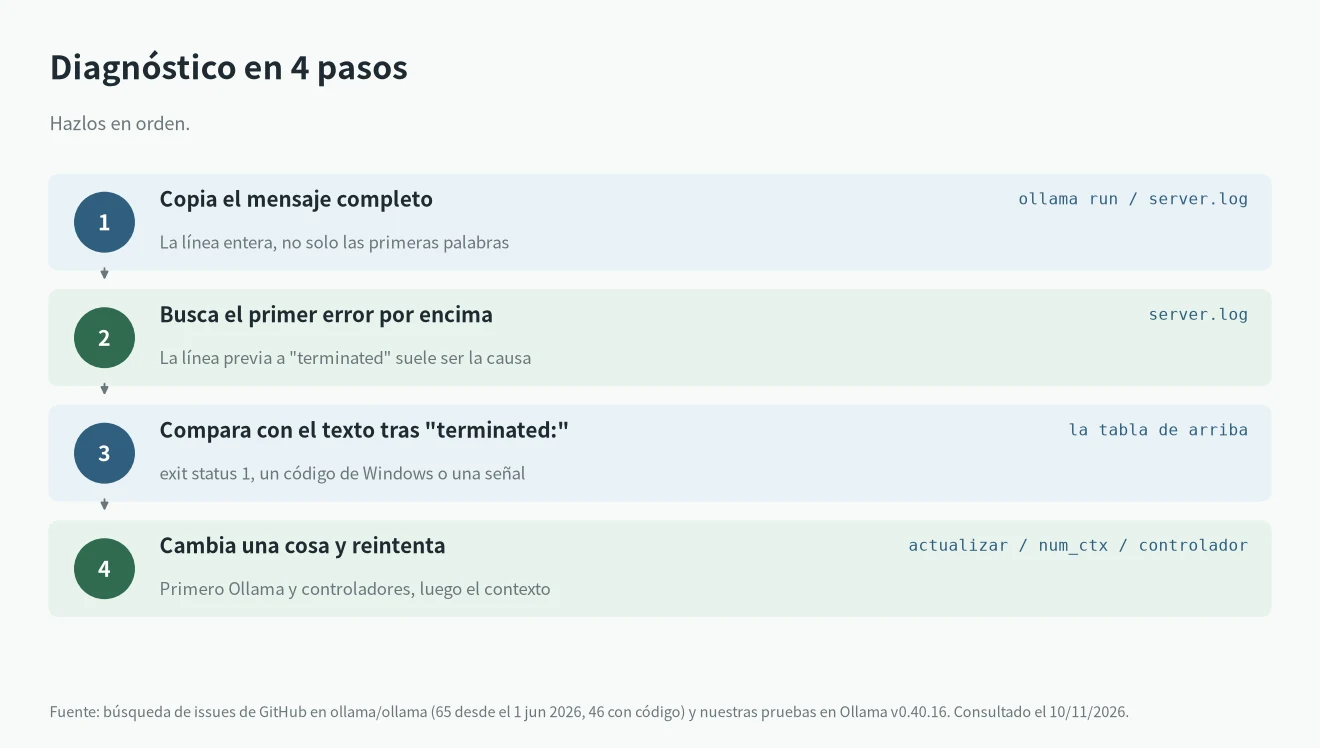
Compara con el texto tras «terminated:»
Buscamos en el repositorio ollama/ollama las issues que contienen «process has terminated» creadas desde el 1 de junio de 2026. Salieron 65 y 46 citan un estado o una señal. La tabla las agrupa.
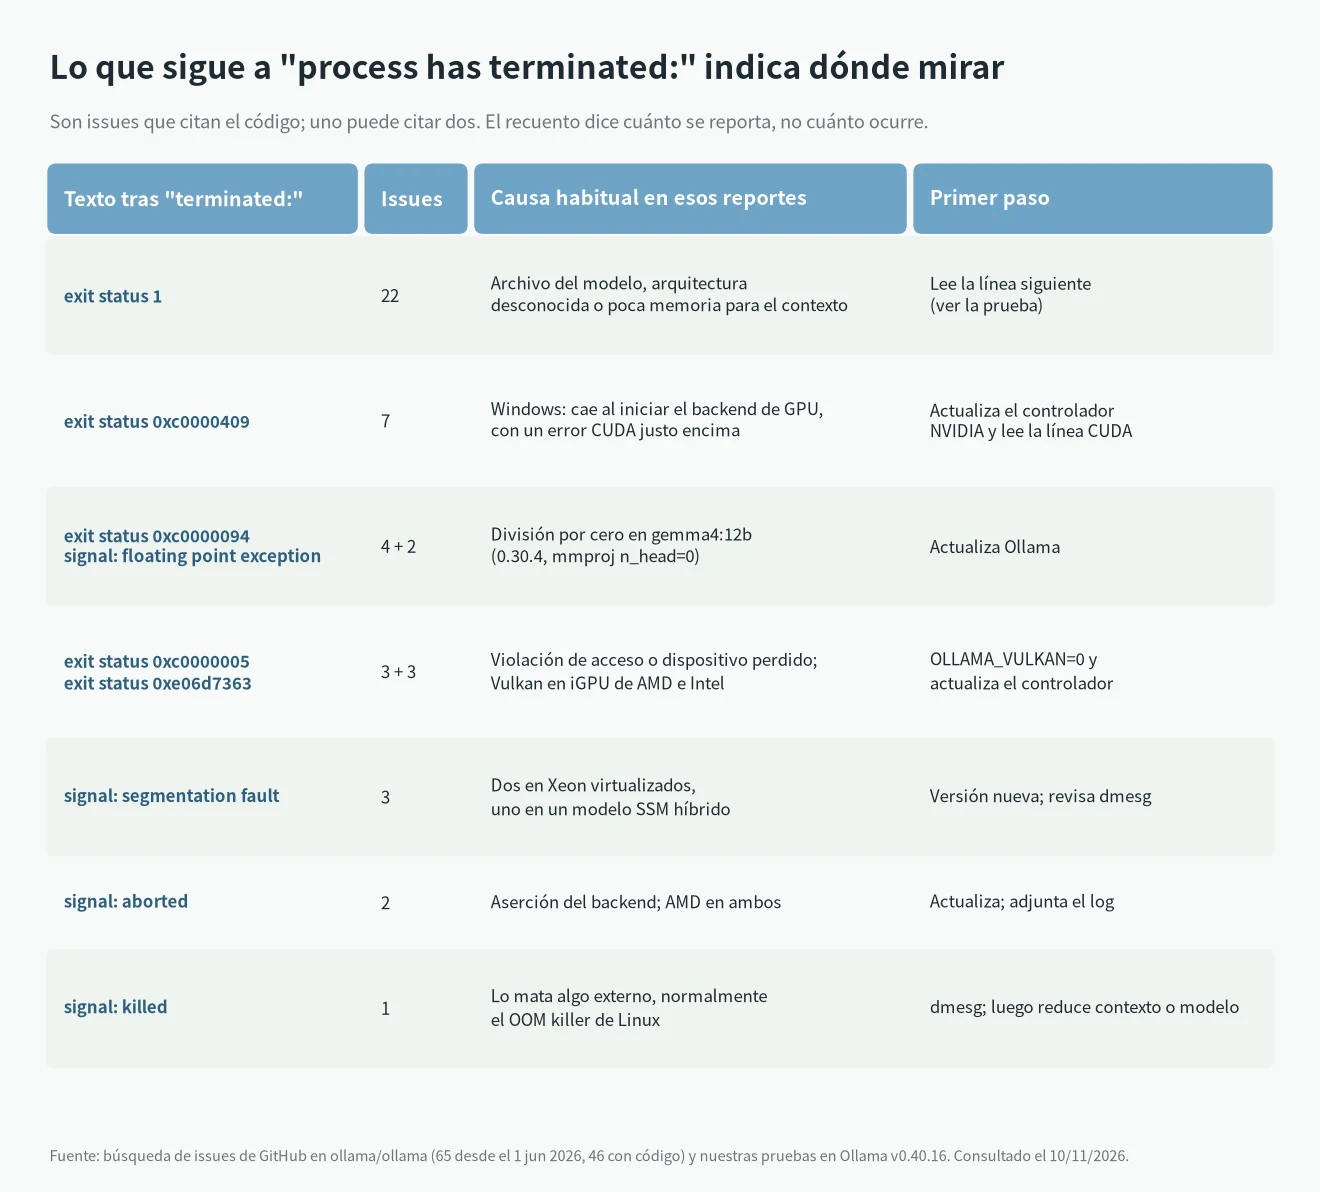
Los números indican con qué frecuencia se reporta cada código, no con qué frecuencia ocurre, y una issue puede citar dos códigos. No encontramos «exit status 2» en ninguna de las 65. Si tu mensaje dice exit status 2, copia el texto completo y mira las líneas anteriores; ese código no pudimos reproducirlo en v0.40.16.
exit status 1: lo que reprodujimos
Es el grupo más grande (22 issues) y la línea siguiente nombra la causa. Reprodujimos tres.
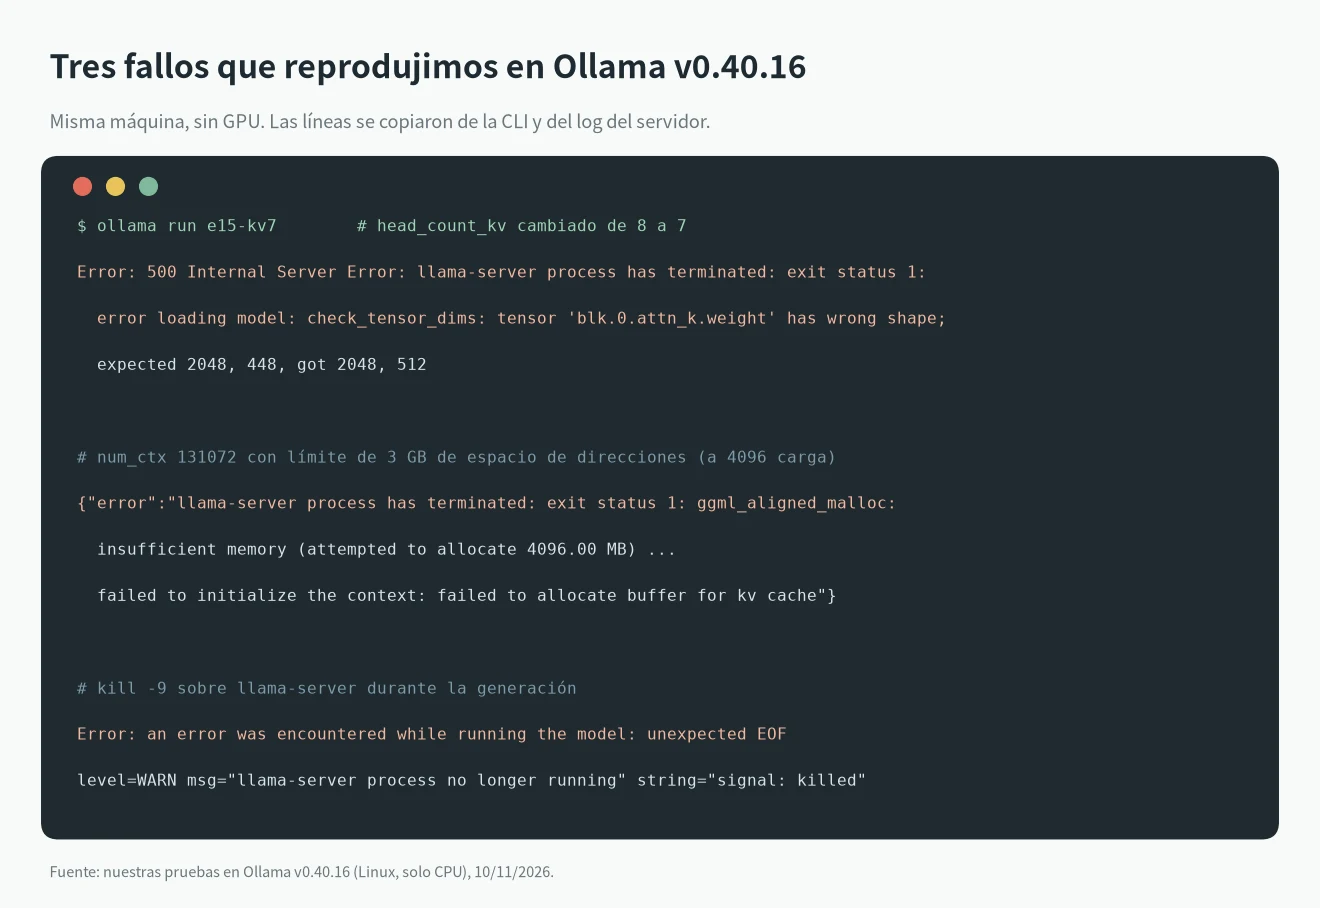
1. El archivo del modelo no coincide con sus propios metadatos. Copiamos llama3.2:1b (1,3 GB), cambiamos un número de la cabecera GGUF y lo importamos con ollama create. La creación funcionó las cinco veces y ollama run falló:
attention.head_count_kvde 8 a 7:check_tensor_dims: tensor 'blk.0.attn_k.weight' has wrong shape; expected 2048, 448, got 2048, 512block_countde 16 a 17:tensor 'blk.16.attn_norm.weight' not foundembedding_lengthde 2048 a 1024:tensor 'token_embd.weight' has wrong shapeattention.head_counta 0:tensor 'blk.0.attn_q.weight' has wrong shape; expected 2048, 0attention.key_lengtha 7:error loading model hyperparameters: invalid n_rot: 64, expected 7
Los archivos truncados o aleatorios ni llegan hasta ahí. Una copia de 600 MB del archivo de 1,3 GB, un archivo aleatorio de 5 MB y uno con solo la cabecera fueron rechazados por ollama create con offset+size exceeds file size, unsupported file type y error reading GGUF item 25: EOF. Así que, en una versión actual, un «terminated» con check_tensor_dims suele apuntar a un archivo convertido o editado mal, o a un modelo cuyos metadatos se escribieron para otra versión. Vuelve a descargar el modelo de la biblioteca, o el GGUF, y compara tamaño y SHA-256 con el origen.
2. Arquitectura desconocida. error loading model: unknown model architecture: 'name' significa que tu Ollama es más antiguo que el modelo. Las issues #19347 (v0.40.12, lfm3) y #19186 (v0.40.8-rc0, flint) son ejemplos. Actualiza Ollama; nuestra guía de unknown model architecture explica por qué el pull funciona y el run falla.
3. Poca memoria para el contexto. Arrancamos un segundo servidor con un límite de 3 GB de espacio de direcciones (prlimit --as=3000000000, como sustituto de un límite de memoria) y cargamos el mismo modelo de 1,3 GB. Con el contexto por defecto, 4096, cargó y respondió. Con num_ctx en 131072, cuya caché KV es de 4 GiB, falló:
llama-server process has terminated: exit status 1: ggml_aligned_malloc: insufficient memory (attempted to allocate 4096.00 MB) ... failed to initialize the context: failed to allocate buffer for kv cache
Si ves failed to allocate o unable to allocate CUDA_Host buffer (como en #16455), reduce primero el contexto. Longitud de contexto en Ollama explica cómo, y Requisitos de GPU de Ollama muestra cuánta memoria ocupa el contexto. El mensaje distinto «model requires more system memory» está en esta guía.
Otro caso de exit status 1 es un modelo nuevo en una versión vieja: la #18898 (Gemma4Assistant requires ctx_other to be set, v0.40.2) se cerró cuando el autor confirmó que funciona en 0.40.4.
Códigos de Windows: 0xc0000409, 0xc0000094, 0xc0000005
La lista NTSTATUS de Microsoft llama a 0xc0000409 STATUS_STACK_BUFFER_OVERRUN, a 0xc0000005 STATUS_ACCESS_VIOLATION y a 0xc0000094 STATUS_INTEGER_DIVIDE_BY_ZERO. En los reportes de Ollama, el nombre dice menos que el texto impreso antes:
- 0xc0000409 con una línea CUDA. La #19485 (v0.40.13, GTX 1080) imprimió
CUDA error: the provided PTX was compiled with an unsupported toolchainy el autor escribió que actualizar el controlador de NVIDIA (a 582.78) lo arregló. Las #19122 y #17627 imprimenCUDA error: shared object initialization failed; en la #19122 otros usuarios lo relacionaron con poca memoria de compromiso libre (RAM más archivo de paginación) y la issue sigue abierta. Entonces: actualiza el controlador, cierra otros programas y comprueba que el archivo de paginación no esté limitado. - 0xc0000409 sin línea CUDA. La #16650 ocurrió con Phi4 y caché KV cuantizada (
OLLAMA_KV_CACHE_TYPE); prueba a quitar esa variable. La #16576 describe una condición de carrera con Gemma 4 en Windows y un truco: iniciarollama serveen una terminal antes de ejecutar el modelo. Ambos son reportes de usuarios y no los probamos. - 0xc0000094 o
signal: floating point exception. Seis issues a principios de junio, todas congemma4:12ben builds 0.30.4; la #16495 llegó ammproj n_head=0. Las seis están cerradas. Actualiza Ollama. - 0xc0000005 y 0xe06d7363. En las #18557, #19158 y #19558 el fallo ocurre con Vulkan en GPU integradas de AMD o Intel (
ggml_vulkan: device losten la #19158). La página oficial de GPU indica desactivar Vulkan conOLLAMA_VULKAN=0oGGML_VK_VISIBLE_DEVICES=-1, y forzar la CPU en NVIDIA conCUDA_VISIBLE_DEVICES=-1. No tenemos GPU, así que no pudimos probar estos interruptores.
Si tras aplicarlos Ollama acaba en la CPU, es otro problema; mira Ollama no usa la GPU.
Señales en Linux y Mac
- signal: killed. Algo ajeno a Ollama mató el proceso; en Linux suele ser el OOM killer. Comprueba con
dmesg | grep -i -E "out of memory|killed process". Usamoskill -9sobre llama-server para ver cómo lo reporta Ollama: durante la generación la API devolvió500 an error was encountered while running the model: unexpected EOF, el log del servidor mostróWARN llama-server process no longer running ... string="signal: killed"y la siguiente petición arrancó un runner nuevo y funcionó. O sea, una muerte no siempre llega al cliente como «has terminated». Si se repite, usa un modelo o un contexto más pequeño. - signal: segmentation fault. Tres issues: la #17249 (una máquina virtual Granite Rapids en GCP) y la #17006 (Sapphire Rapids bajo VMware ESXi) son Xeon virtualizados, y la #17236 un modelo SSM híbrido que funcionaba en llama.cpp principal. Prueba una versión más nueva e indica CPU e hipervisor.
- signal: aborted. Dos issues, ambas con GPU AMD (#16572, #16626). Actualiza y adjunta el log.
Qué probamos y qué viene de los reportes
- Probado en Ollama v0.40.16 (Linux, 8 núcleos, 15,6 GiB de RAM, sin GPU) con llama3.2:1b: rechazo de archivos truncados, aleatorios o solo con cabecera en
ollama create; cinco cambios de cabecera que fallan al cargar conexit status 1; el límite de 3 GB con contexto 4096 frente a 131072;kill -9durante la generación y en reposo; las cadenas dentro del binario. - No probado: ninguna GPU, el comportamiento en Windows o Mac, los arreglos de CUDA, ROCm y Vulkan, ni las variables de la tabla. Vienen de issues de GitHub y de la documentación oficial, y lo decimos donde importa. El límite de espacio de direcciones no equivale a quedarse sin RAM; produce el mismo fallo de asignación en una máquina.
- Los recuentos de issues vienen de la búsqueda de GitHub del 10 de noviembre de 2026 (
repo:ollama/ollama "process has terminated" created:>2026-06-01 is:issue). La búsqueda coincide por palabras, no por frase exacta; tómalos como una instantánea. - Fuentes: las páginas de solución de problemas y GPU de Ollama, la lista NTSTATUS de Microsoft y las issues citadas de github.com/ollama/ollama.
Para otros mensajes de Ollama, mira la consulta rápida de errores.
Preguntas frecuentes
¿Qué significa «llama runner process has terminated»?
Que el proceso que carga y ejecuta el modelo terminó y tu petición falló. La causa está en el texto tras los dos puntos: un código de salida con una línea de log, o una señal.
¿Ahora es «llama runner» o «llama-server»?
Las versiones actuales dicen llama-server. Nuestra prueba en v0.40.16 y 56 de las 65 issues recientes usan esa redacción; el significado es el mismo.
¿Cómo arreglo «exit status 1: error loading model»?
Lee la línea siguiente. unknown model architecture pide un Ollama más nuevo; check_tensor_dims apunta a un archivo malo o editado, así que vuelve a descargarlo; failed to allocate pide un contexto o modelo menor.
¿Qué significa exit status 0xc0000409 en Ollama?
Windows lo etiqueta como desbordamiento de búfer de pila. En los reportes aparece con errores CUDA, así que actualiza primero el controlador de NVIDIA y lee la línea anterior.
¿»signal: killed» significa que me quedé sin RAM?
A menudo sí en Linux, pero confírmalo con dmesg.