

Ollama «unknown model architecture»: guía esencial para un error frustrante (2026)
Ollama muestra "error loading model: unknown model architecture" cuando el archivo usa una arquitectura que su llama.cpp interno aún no conoce. Actualiza Ollama, usa la versión de la biblioteca o ejecuta el GGUF en un llama.cpp más nuevo. Lo reprodujimos con el GGUF de LFM3 en Ollama 0.40.12.
 bufferSobre el autor5 min de lectura
Respuesta corta: Ollama muestra error loading model: unknown model architecture: 'nombre' cuando el archivo del modelo usa una arquitectura que el llama.cpp incluido en tu Ollama todavía no conoce. Pasa sobre todo con modelos recién salidos: un GGUF descargado de Hugging Face, o un modelo de la biblioteca en una versión de Ollama que aún no lo soporta. Revisa ollama -v, actualiza si una versión nueva menciona el modelo y, si es un GGUF que ninguna versión soporta todavía, ejecútalo con un llama.cpp actual o espera. Lo reprodujimos el 29 de octubre de 2026 (hora de Pekín) con el GGUF de LFM3 en Ollama 0.40.12 y ejecutamos el mismo archivo con llama.cpp.
El mensaje completo de unknown model architecture
Normalmente aparece al ejecutar o cargar el modelo, no al descargarlo:
Error: 500 Internal Server Error: llama-server process has terminated: exit status 1: error loading model: unknown model architecture: 'lfm3'El nombre entre comillas es la arquitectura guardada en el GGUF. ollama show muestra ese mismo valor en la línea architecture, así que puedes comprobarlo antes de ejecutar nada.
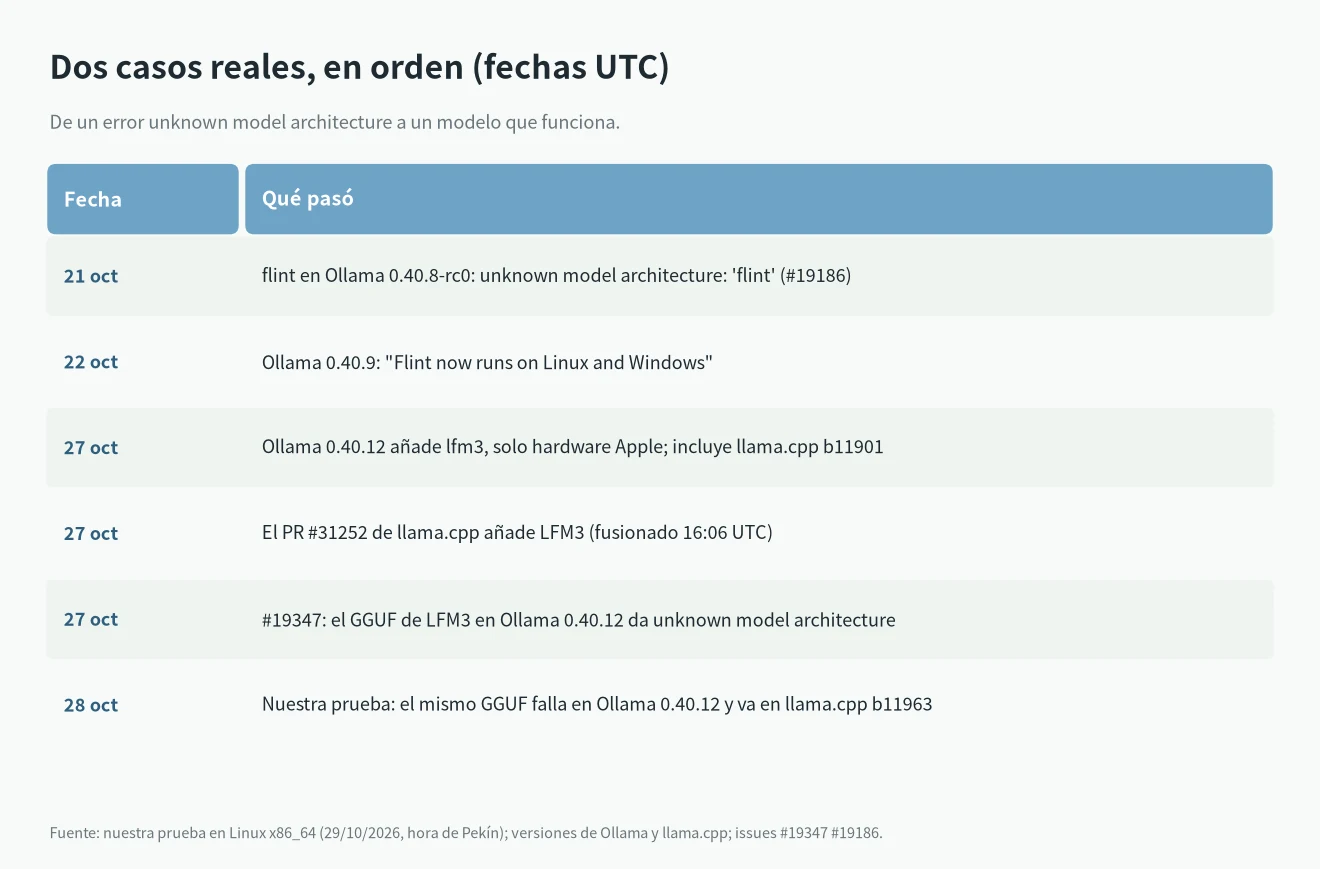
El mensaje viene de llama.cpp, no de Ollama. Ollama ejecuta muchos modelos con una copia interna de llama.cpp, y cada versión de Ollama fija un build concreto. Si la arquitectura se añadió a llama.cpp después de ese build, la carga falla con este error. Un mantenedor de Ollama lo resumió en el issue #19347: «GGUF support depends on llama.cpp.»
Nuestra prueba: el GGUF de LFM3 en Ollama y en llama.cpp
Descargamos el LFM3-1.7B-Q4_K_M.gguf oficial del repositorio de LiquidAI en Hugging Face y lo importamos en Ollama 0.40.12 con un Modelfile de una línea (FROM ./LFM3-1.7B-Q4_K_M.gguf), como indica la documentación oficial de importación.
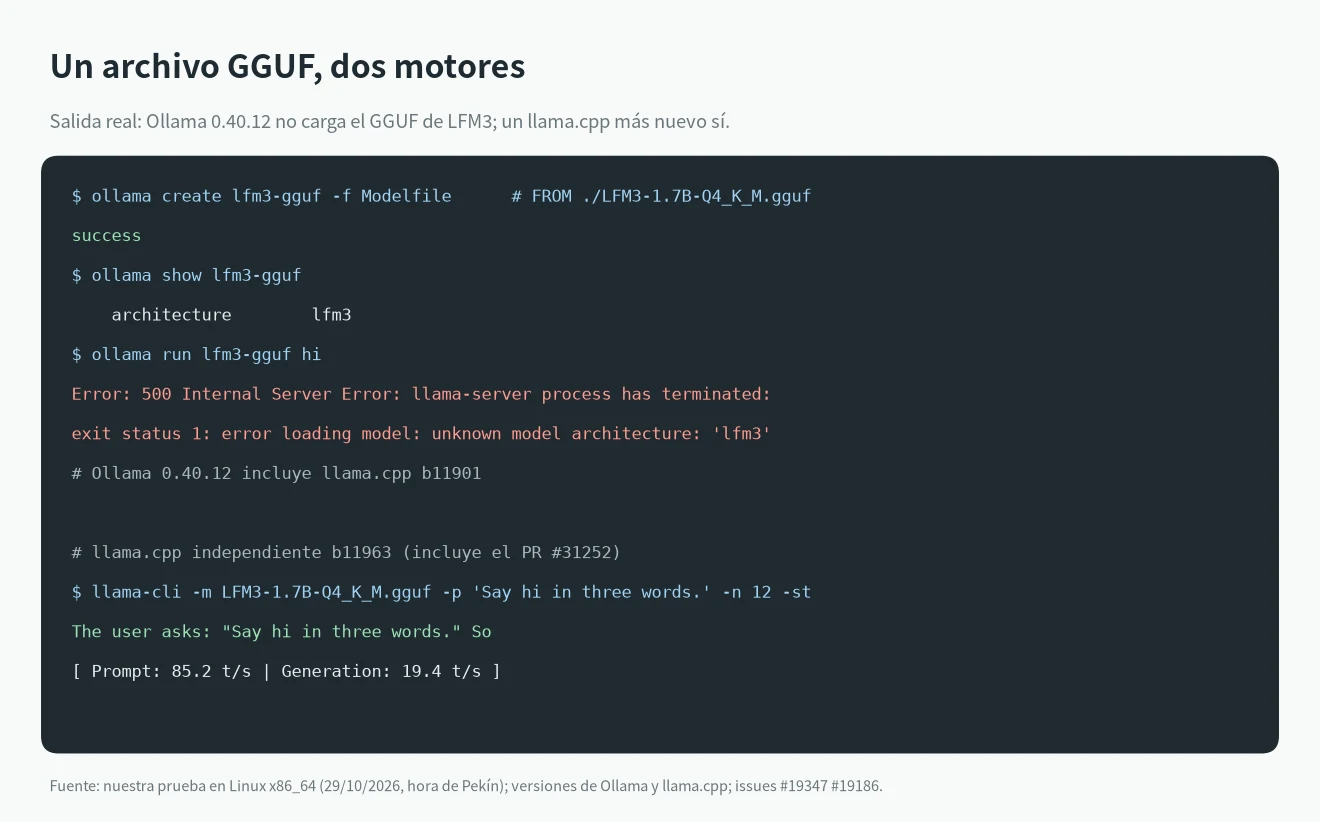
ollama createterminó bien yollama showmostró la arquitecturalfm3, 1.7B parámetros y contexto de 262144. Importar no comprueba si el motor puede cargar el archivo.ollama run lfm3-gguf hifalló conunknown model architecture: 'lfm3', la misma línea del #19347.- El código de Ollama v0.40.12 fija llama.cpp
b11901. LFM3 llegó a llama.cpp con el PR #31252, fusionado el 27 de octubre de 2026 a las 16:06 UTC, después de ese build. - Un llama.cpp independiente, build
b11963, cargó el mismo archivo y generó texto a unos 85 tokens/s en el prompt y 19 tokens/s en la generación, en nuestra máquina solo con CPU.
El archivo está bien. El motor de esta versión de Ollama es más antiguo que el modelo.
Las tres causas habituales
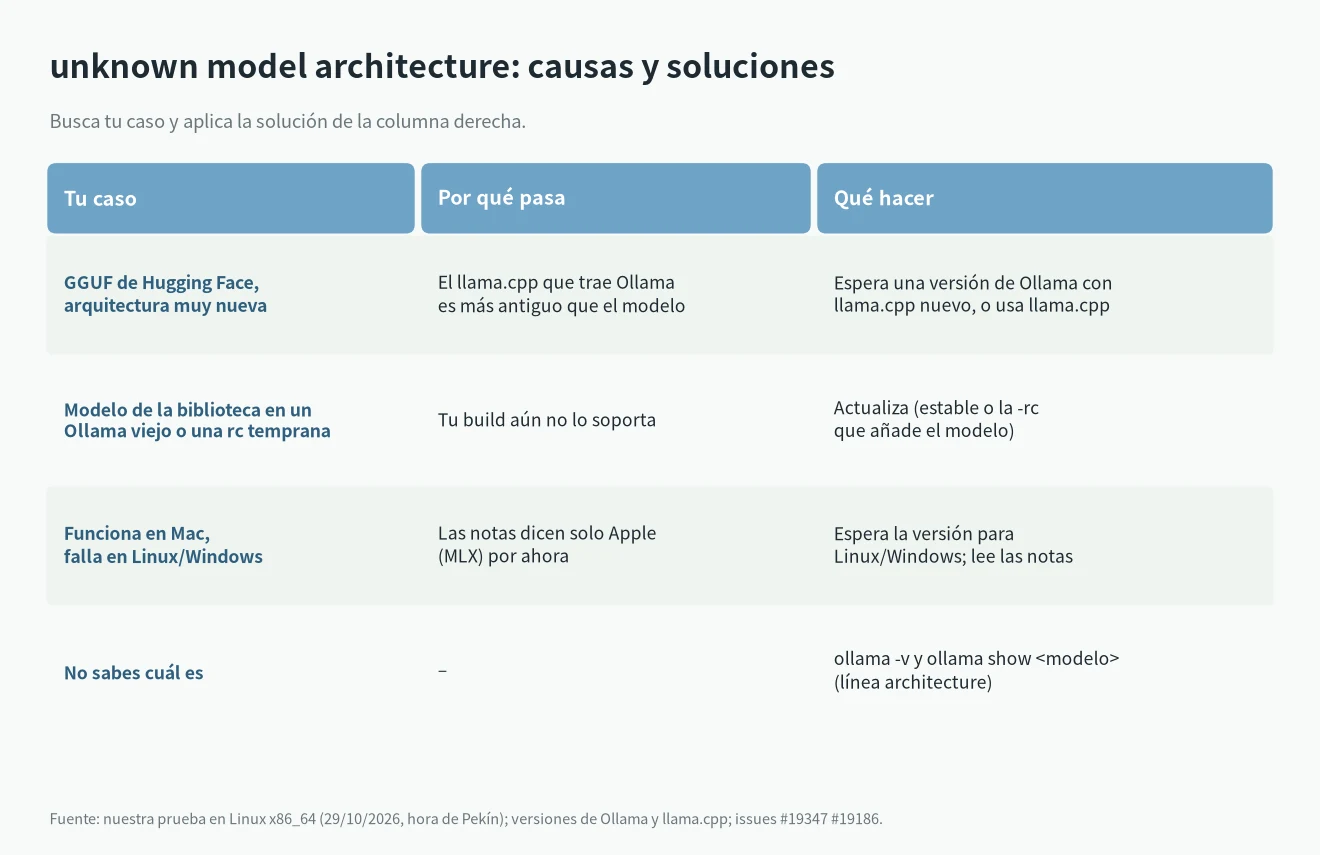
1. Un GGUF de Hugging Face más nuevo que el llama.cpp de Ollama
Es nuestro caso de prueba y el del #19347. También ocurre con ollama run hf.co/...: el autor del issue usó ollama run hf.co/LiquidAI/LFM3-1.7B-GGUF:Q8_0. Actualizar Ollama solo ayuda cuando sale una versión con un llama.cpp que ya incluye esa arquitectura. Hasta entonces, ninguna versión de Ollama puede cargar ese archivo.
2. Un modelo de la biblioteca en una versión que aún no lo soporta
En el issue #19186, un usuario instaló la versión previa 0.40.8-rc0 para probar el nuevo flint y recibió unknown model architecture: 'flint'. Un mantenedor respondió «Not supported in llama.cpp yet» y enlazó el PR de llama.cpp. Al día siguiente, las notas de v0.40.9 decían «Flint now runs on Linux and Windows». Bastó con actualizar.
3. El modelo, de momento, solo funciona en Apple
Algunos modelos nuevos llegan primero con MLX para hardware de Apple. Las notas de v0.40.12 dicen que lfm3 y d1 2b «are supported on Apple hardware in this release. Support for Linux/Windows coming soon.» En Linux, la descarga desde la biblioteca falla con this model requires MLX support, but the MLX runtime is not available, y la vía del GGUF falla al cargar. Los dos significan lo mismo: todavía no en esta plataforma.
Cómo solucionar unknown model architecture
1. Ejecuta ollama -v y ollama show . Apunta la versión y el nombre de la arquitectura.
2. Busca el modelo o la arquitectura en las notas de versión de Ollama. Si una versión nueva lo menciona, actualiza como indican las preguntas frecuentes oficiales. En Linux es curl -fsSL https://ollama.com/install.sh | sh.
3. Si solo lo soporta una versión previa, fíjala como explica la documentación de Linux, con la etiqueta exacta. En el #19186, OLLAMA_VERSION=0.40.9 devolvió un 404 porque en ese momento la etiqueta era 0.40.9-rc1.
4. Si el modelo está en la biblioteca, úsalo en lugar de un GGUF de terceros. Las notas de versión dicen qué versión lo añadió y en qué plataformas funciona.
5. Si ninguna versión de Ollama soporta aún la arquitectura, ejecuta el GGUF directamente con llama.cpp: llama-cli -m modelo.gguf. Los parámetros están en nuestra guía para cargar modelos en llama.cpp.
6. Volver a descargar el mismo archivo no sirve. No está dañado; el motor es antiguo.
Preguntas rápidas
¿Por qué ollama create funcionó si el modelo no carga?
En nuestra prueba, ollama create solo importó el archivo y ollama show leyó sus metadatos. Ninguno cargó los pesos, así que el error apareció al ejecutar.
¿unknown model architecture es lo mismo que un error 412?
No. El 412 (pull model manifest: 412) sale al descargar y significa que el registro pide un Ollama más nuevo; se arregla actualizando. Este error sale al cargar y significa que el motor interno no reconoce el archivo.
¿Qué modelo uso mientras tanto?
Uno que tu Ollama ya soporte. Nuestra guía de LLM local para programar y los mejores LLM locales ordenan los modelos actuales por VRAM.