

llama.cpp «error: --model or -hf is required»: guía esencial para solucionarlo fácil (2026)
llama.cpp muestra "error: --model or -hf is required" cuando llama-cli arranca sin modelo. Pásale un GGUF local con -m o un repositorio de Hugging Face con -hf. llama-server funciona distinto: sin modelo arranca en modo router. Revisado con el código de ggml-org/llama.cpp el 28/10/2026.
 bufferSobre el autor7 min de lectura
Respuesta corta: llama.cpp muestra error: --model or -hf is required cuando arrancas llama-cli (o el nuevo llama cli) sin indicarle qué modelo cargar. Añade un archivo GGUF local con -m /path/to/model.gguf o un repositorio de Hugging Face con -hf user/repo:quant y arrancará. llama-server es la excepción: sin modelo no se detiene, arranca en modo router. Todo lo de abajo se revisó con el código de ggml-org/llama.cpp y la documentación de Ollama el 28 de octubre de 2026.
Qué dice el error y por qué aparece
El mensaje completo es una sola línea:
error: --model or -hf is requiredViene del analizador de argumentos en common/arg.cpp. Después de leer tus opciones, llama.cpp comprueba si indicaste un modelo con -m/--model, -hf, --model-url o --docker-repo. Si no hay ninguno, lanza este error y se cierra.
El texto es nuevo. El pull request #31242, fusionado el 27 de octubre de 2026, cambió el mensaje anterior error: --model is required por error: --model or -hf is required, para que el error nombre las dos formas de arreglarlo. Las notas de la versión v0.8.0 lo resumen como «CLI: --model or -hf is now required». Si usas una versión anterior y ves error: --model is required, es la misma comprobación y la misma solución.
Las formas más habituales de encontrarlo:
- Ejecutar
llama-cliollama clisin opciones. - Un script o servicio que depende de la variable
LLAMA_ARG_MODEL, pero esa variable no está definida en la terminal, la unidad de systemd o el contenedor. - Copiar un comando de un tutorial antiguo que cargaba el modelo en otro paso.
Lo que obtuvimos al probarlo
El 28 de octubre de 2026 descargamos la compilación oficial b11963 para Linux x64 (llama-cli --version muestra version: 0.8.0-dev (build 11963, commit 39febd2ad)) y probamos los casos anteriores:
llama-clisin opciones mostróerror: --model or -hf is requiredy salió con código 1.llama-cli -msin ruta dio otro error:error while handling argument "-m": expected value for argument. Si ves ese, la opción está pero falta la ruta; casi siempre es una variable como$MODELvacía.llama-cli -hf ggml-org/Qwen3.5-0.8B-GGUF -p "Reply with one word: hello" -n 16 -stdescargó el modelo y respondió en unos 51 segundos. Ese repositorio no tiene archivo Q4_K_M, así que llama.cpp eligióQwen3.5-0.8B-Q8_0.gguf, como indica la ayuda.- Después,
llama-cli -cllistóggml-org/Qwen3.5-0.8B-GGUF:Q8_0, guardado en~/.cache/huggingface/hub/models--ggml-org--Qwen3.5-0.8B-GGUF/. LLAMA_ARG_MODEL=funcionó sinllama-cli -p "Say OK" -n 4 -st -m.llama-serversin modelo no falló: registróstarting server in router mode. models will be automatically loaded on-demand.
No probamos la ruta de los blobs de Ollama ni las versiones de Windows y macOS.
Windows en español: «Usuarios» no es la ruta real
En un Windows en español, el Explorador muestra la carpeta como «Usuarios», pero la ruta real sigue siendo C:\Users\.... Así lo explica una respuesta en Microsoft Q&A: lo importante es que la carpeta siga en C:\Users\Usuario\..., y la ruta real se ve en Propiedades > Ubicación. Si escribes «C:\Usuarios\…» a mano en -m, comprueba antes esa ruta en Propiedades. En PowerShell, la variable de entorno se define así:
$env:LLAMA_ARG_MODEL = "C:\Users\tu_usuario\modelos\modelo.gguf"
llama-cli
No probamos la versión de Windows; la sintaxis de PowerShell es la estándar para variables de entorno. Si la ruta tiene espacios, ponla entre comillas también con -m.
Cómo solucionar –model or -hf is required
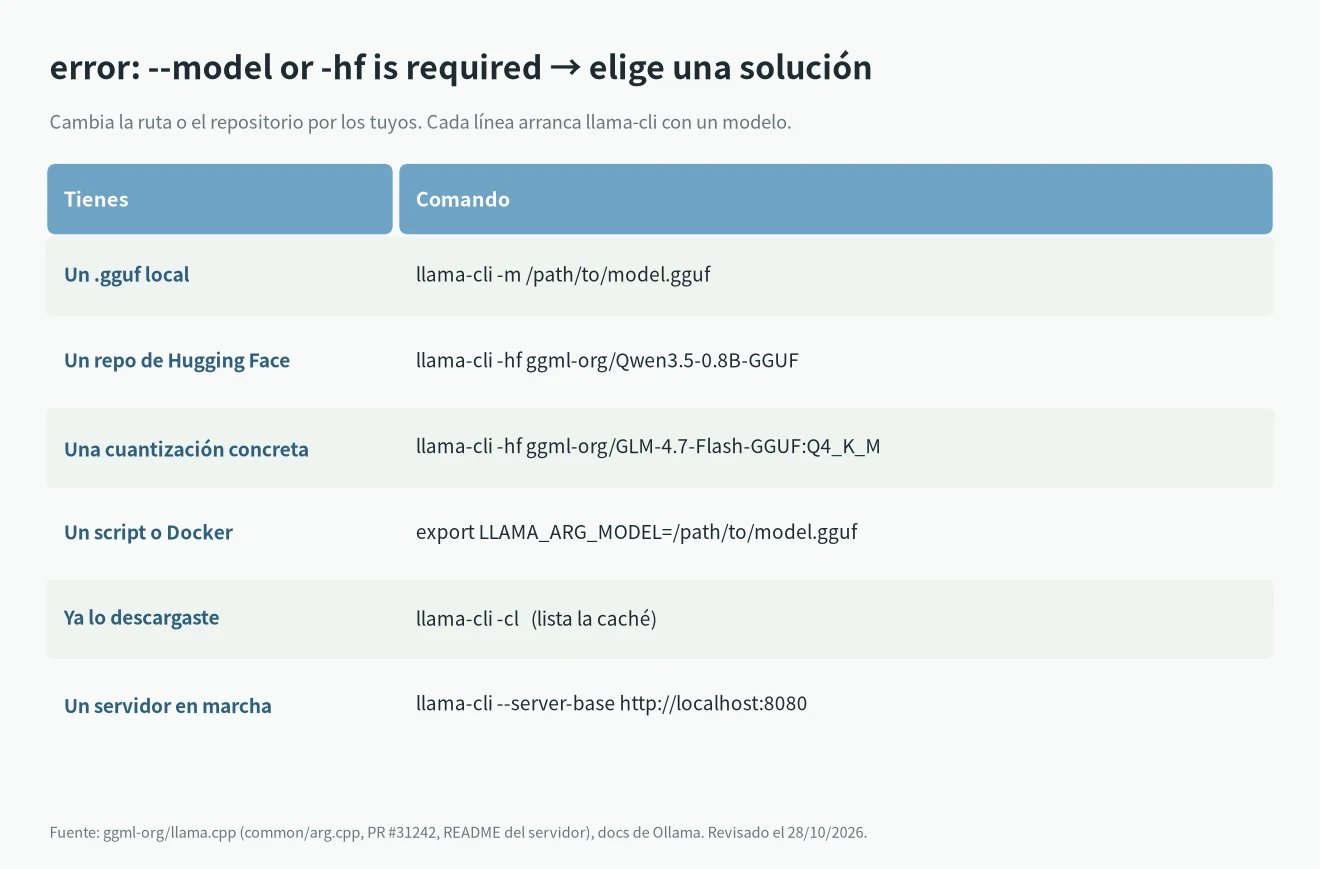
Elige la línea que corresponde a lo que tienes y cambia la ruta o el repositorio por los tuyos.
Tienes un archivo GGUF en el disco
llama-cli -m /path/to/model.gguf-m y --model son la misma opción. La ayuda la describe como «model path to load».
Quieres descargarlo de Hugging Face
llama-cli -hf ggml-org/Qwen3.5-0.8B-GGUFEs el ejemplo del README de llama.cpp. Para elegir la cuantización, añádela después de dos puntos:
llama-cli -hf ggml-org/GLM-4.7-Flash-GGUF:Q4_K_MSegún la ayuda, la cuantización no distingue mayúsculas y por defecto es Q4_K_M. Si el repositorio no tiene Q4_K_M, llama.cpp toma el primer archivo. Si hay un proyector de visión (mmproj), también se descarga; añade --no-mmproj para omitirlo. Para repositorios con acceso restringido, pasa un token con -hft o define HF_TOKEN.
Lo arrancas desde un script o Docker
Cada opción tiene su variable de entorno. Define una antes de ejecutar el comando:
export LLAMA_ARG_MODEL=/path/to/model.gguf
# o bien
export LLAMA_ARG_HF_REPO=ggml-org/Qwen3.5-0.8B-GGUF
El README del servidor usa LLAMA_ARG_MODEL: /models/my_model.gguf en su ejemplo de Docker Compose. Si sigues viendo --model or -hf is required, la variable no llega al proceso: revisa el bloque environment:, la línea Environment= de systemd o si la exportaste en otra terminal.
Ya tienes un servidor en marcha
llama-cli puede conectarse a un servidor existente en lugar de cargar su propia copia del modelo:
llama-cli --server-base http://localhost:8080La comprobación de arg.cpp no exige modelo cuando se usa --server-base. Usa la dirección y el puerto reales de tu servidor.
¿llama-server necesita –model o -hf?
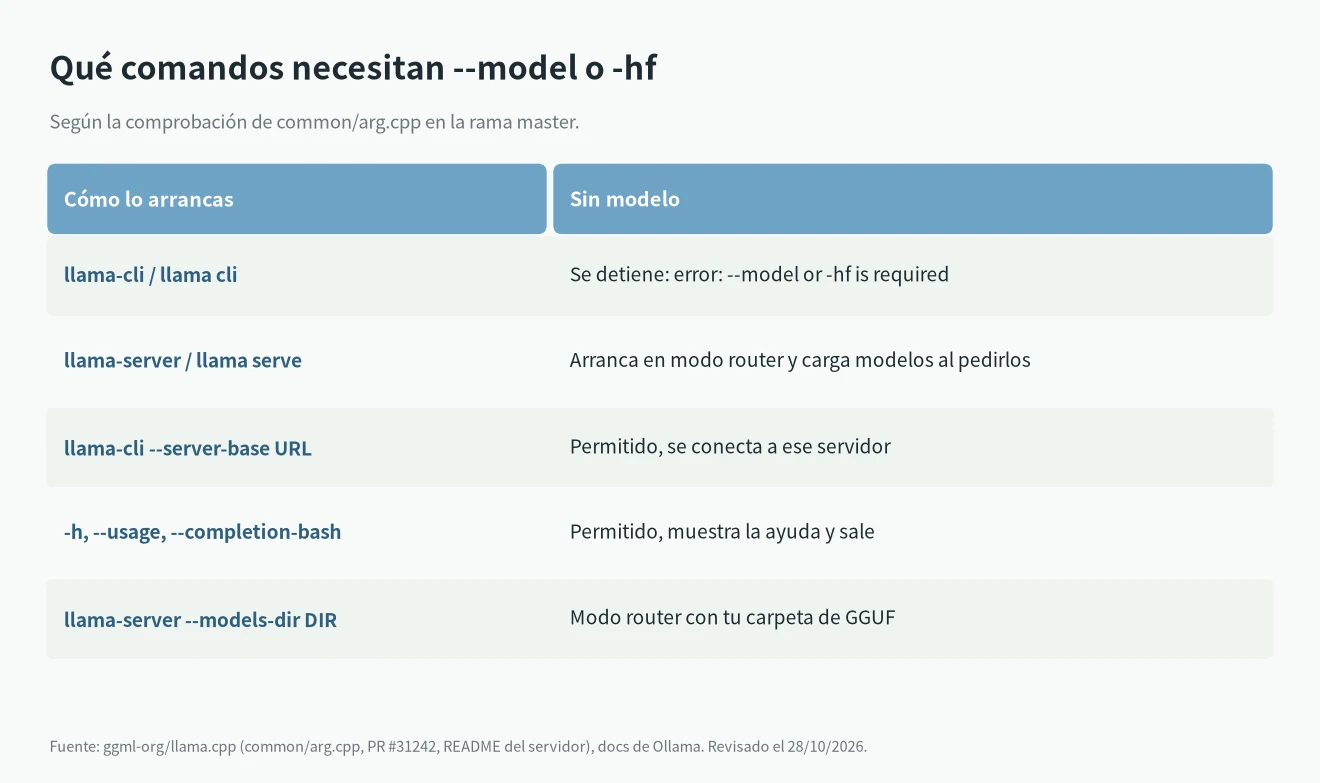
No. El servidor queda fuera de esta comprobación. El README del servidor dice: «To start in router mode, launch llama-server without specifying any model«. En modo router, el servidor carga los modelos cuando llegan peticiones y los busca en tres sitios:
- La caché, que llenas con
llama-server -hf(reinicia el servidor después de añadir un modelo)./ : - Una carpeta con archivos GGUF:
llama-server --models-dir ./models_directory. - Un archivo de presets:
llama-server --models-preset ./my-models.ini.
El detalle está en las peticiones. En modo router, cada petición a la API debe incluir el campo model. Si falta, el servidor responde model name is missing from the request. Si quieres el comportamiento de un solo modelo, arráncalo con -m o -hf como arriba.
Las opciones de ayuda, como -h, --usage y --completion-bash, también funcionan sin modelo.
Encuentra un modelo que ya descargaste
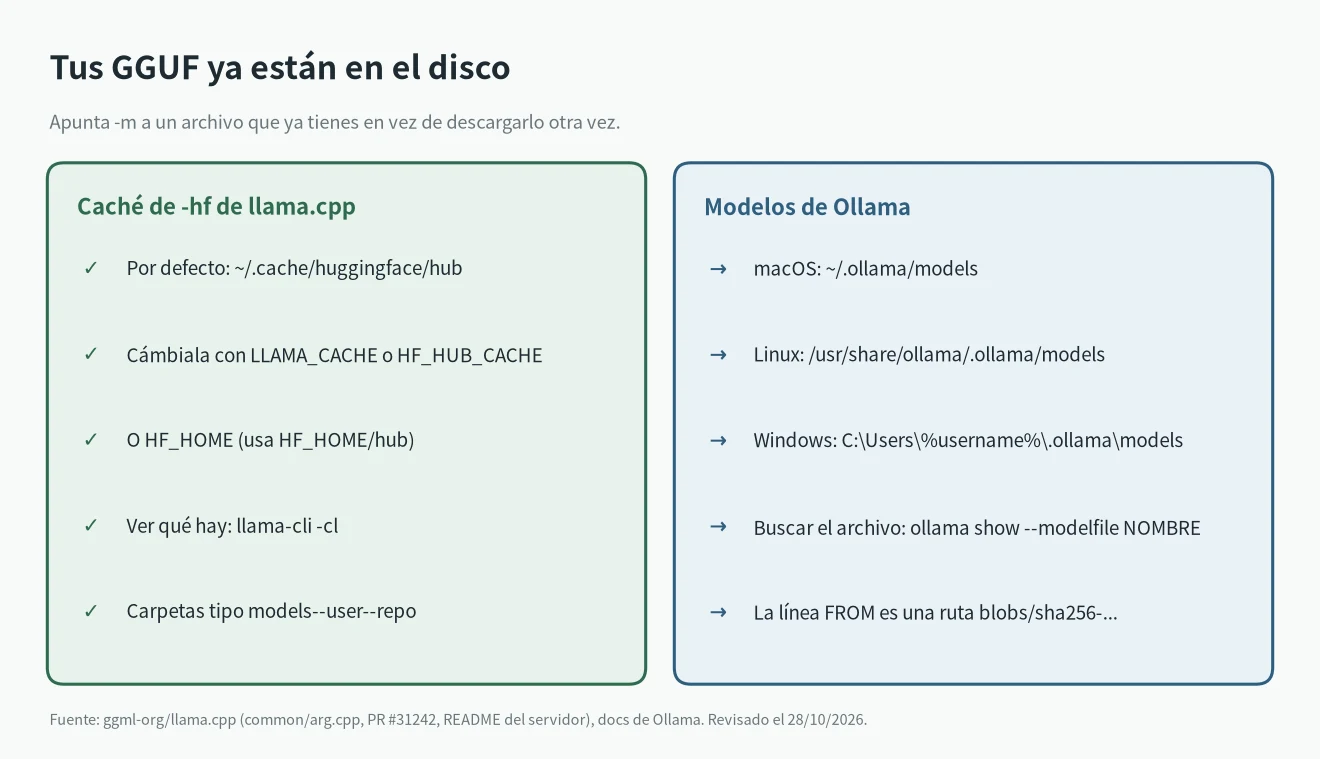
Antes de volver a descargar varios gigas, mira qué tienes en el disco.
Modelos descargados con llama.cpp -hf
Lista la caché:
llama-cli -clPor defecto, las descargas de -hf van a ~/.cache/huggingface/hub. llama.cpp revisa primero LLAMA_CACHE y después HF_HUB_CACHE, HUGGINGFACE_HUB_CACHE, HF_HOME/hub y XDG_CACHE_HOME/huggingface/hub. Repetir el mismo comando -hf reutiliza el archivo en caché.
Modelos descargados con Ollama
Las preguntas frecuentes de Ollama indican dónde se guardan los modelos:
- macOS:
~/.ollama/models - Linux:
/usr/share/ollama/.ollama/models - Windows:
C:\Users\%username%\.ollama\models
La variable OLLAMA_MODELS cambia esa ubicación. Los archivos se nombran por hash, así que pide la ruta exacta a Ollama:
ollama show --modelfile llama3.2La documentación del Modelfile muestra la salida: la línea FROM apunta a un archivo como ~/.ollama/models/blobs/sha256-.... Pasa esa ruta a llama.cpp:
llama-cli -m ~/.ollama/models/blobs/sha256-<hash>Ninguno de los dos proyectos documenta esto como un flujo compatible, así que un blob puede fallar si la versión de Ollama del modelo necesita algo que llama.cpp no maneja. Si falla, descarga el GGUF con -hf.
Preguntas frecuentes
¿Por qué empezó después de actualizar?
La comprobación ya existía. Lo que cambió el 27 de octubre de 2026 fue el texto del error (PR #31242) y el README, que ahora empieza con llama cli -hf .... Si un comando antiguo funcionaba, busca un -m que falte o una variable de entorno que ya no está definida.
¿Qué modelo cargo?
Para una primera prueba, un modelo pequeño como ggml-org/Qwen3.5-0.8B-GGUF carga en casi cualquier equipo. Para más opciones, mira nuestros mejores LLM locales y LLM locales para programar.
¿Cabe el modelo en mi GPU?
Compruébalo antes de descargar con nuestra calculadora de VRAM. Un modelo que no cabe da otro error al cargar, no --model or -hf is required.