
Ollama 报 llama runner process has terminated 怎么办?按 exit status 分 7 类,3 种在 v0.40.16 上复现
这句话只说模型进程挂了,原因在后面:exit status 1 加 error loading 行、Windows 状态码,或 Linux 信号。我们在 Ollama v0.40.16 上复现了三种失败,并把 65 条 GitHub issue 按状态码分了类。
 buffer关于作者约 8 分钟阅读
“Error: llama runner process has terminated” 说的是运行模型的那个进程挂了,但它没告诉你为什么。原因在冒号后面:exit status 1 加一行 “error loading model”,或者 0xc0000409 这样的 Windows 状态码,或者 signal: killed 这样的 Linux 信号。Ollama v0.40.16 里这句话写成 “llama-server process has terminated”(2026 年 6 月以来的 65 条 GitHub issue 里有 56 条是这个写法),其实是同一个故障,只是大家搜的还是 “llama runner process has terminated”。这篇按冒号后面的内容把报告分了类,并给出我们在 v0.40.16 上复现的三种失败,每种都附原文输出。以下全部在 2026 年 11 月 10 日核对。
同一个报错,换了个写法
旧版 Ollama 打印 llama runner process has terminated,新版打印 llama-server process has terminated,进程已经不在时有时打印 llama-server process no longer running。v0.40.16 的可执行文件里有这两个 llama-server 字符串,没有旧写法。2026 年 6 月 1 日以来的 GitHub issue 里,56 条用新写法,1 条用旧写法。所以你看到的报错和某篇教程措辞不同,多半还是同一个问题。
这句话分三段,只有后两段有用:
Error: 500 Internal Server Error:只是接口返回了失败。llama-server process has terminated:说明模型进程退出了。- 后面是退出码或信号,加上进程最后打印的几行。线索就在这里。
完整文本在哪看:在终端里运行 ollama serve 直接看,或者按 Ollama 排错页说的位置找日志(Mac 是 ~/.ollama/logs/server.log,Linux 是 journalctl -u ollama,Windows 是 %LOCALAPPDATA%\Ollama,容器里用 docker logs)。”terminated” 上面那一行往往才是真正的原因。
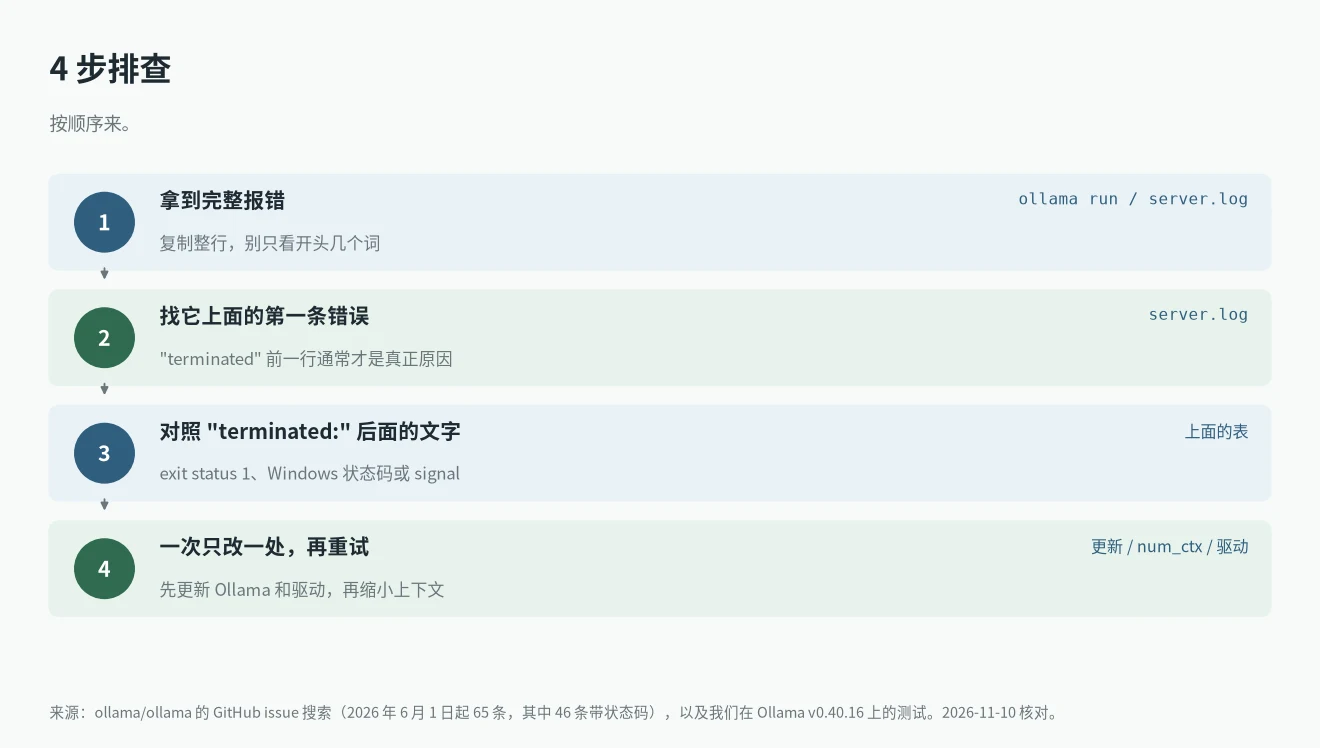
对照 “terminated:” 后面的文字
我们在 ollama/ollama 仓库搜了 2026 年 6 月 1 日以来包含 “process has terminated” 的 issue,一共 65 条,其中 46 条引用了状态码或信号。下表是分组结果。
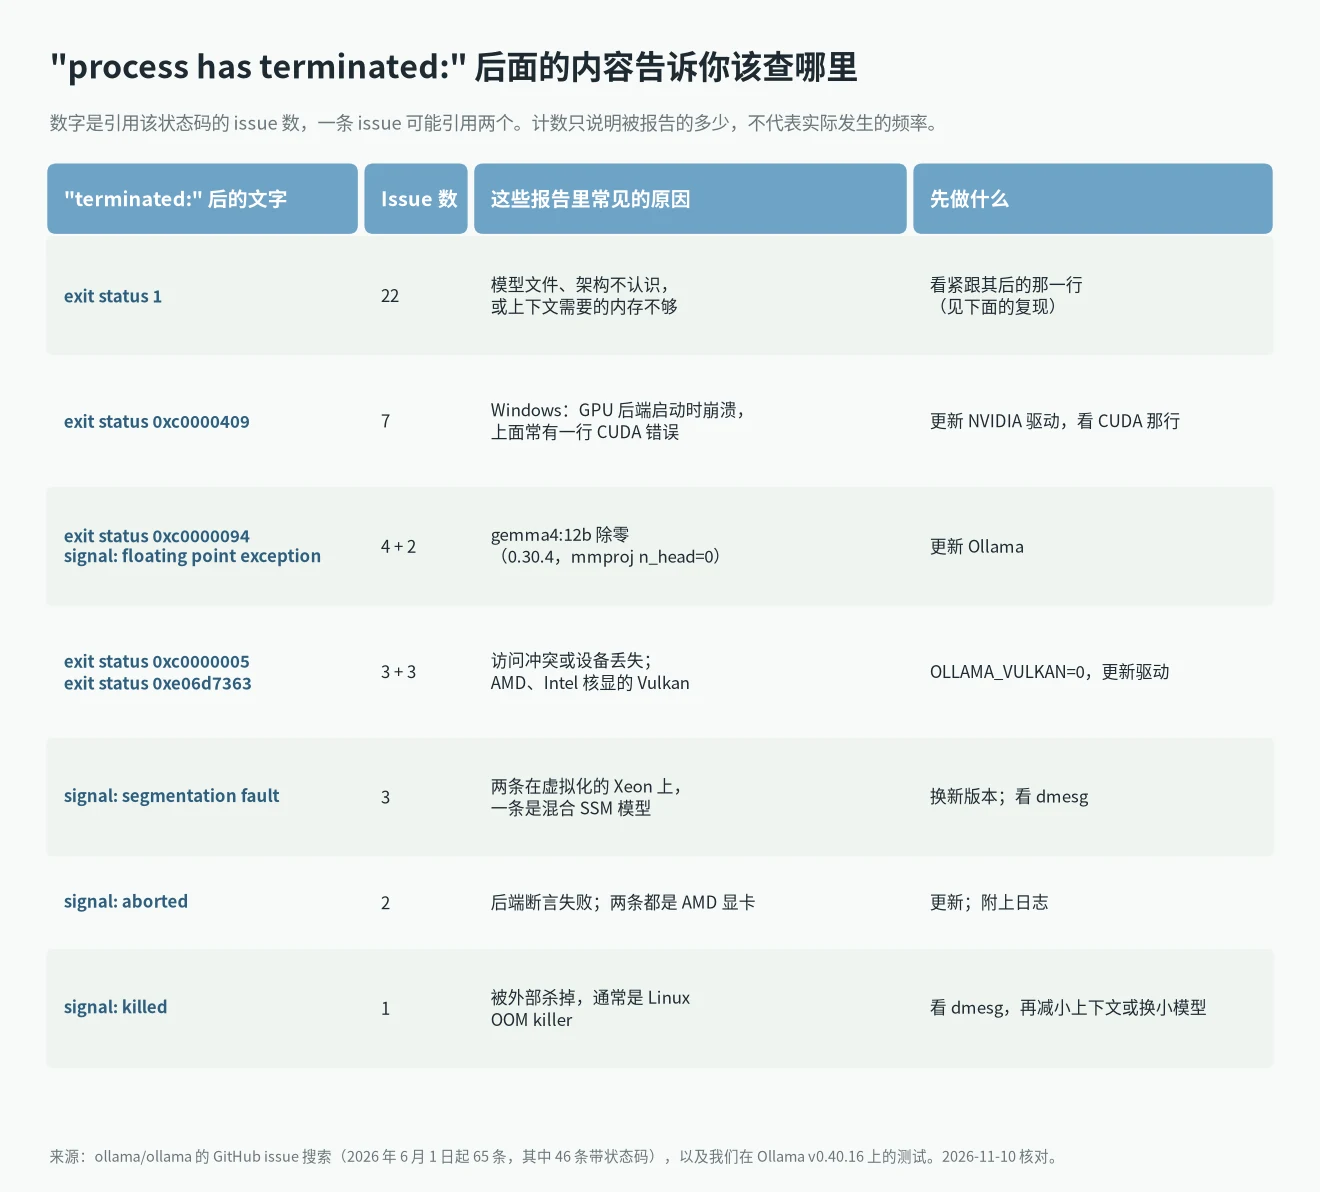
数字只说明每种报错被提到的次数,不代表实际发生的频率,一条 issue 也可能引用两个状态码。65 条里我们没有找到 “exit status 2″。如果你的报错写的是 exit status 2,请复制完整文本,看它上面的几行;这个状态码我们在 v0.40.16 上没能复现。
exit status 1:我们复现的三种
这是最大的一组(22 条 issue),紧跟其后的那一行会说出原因。我们复现了三种。
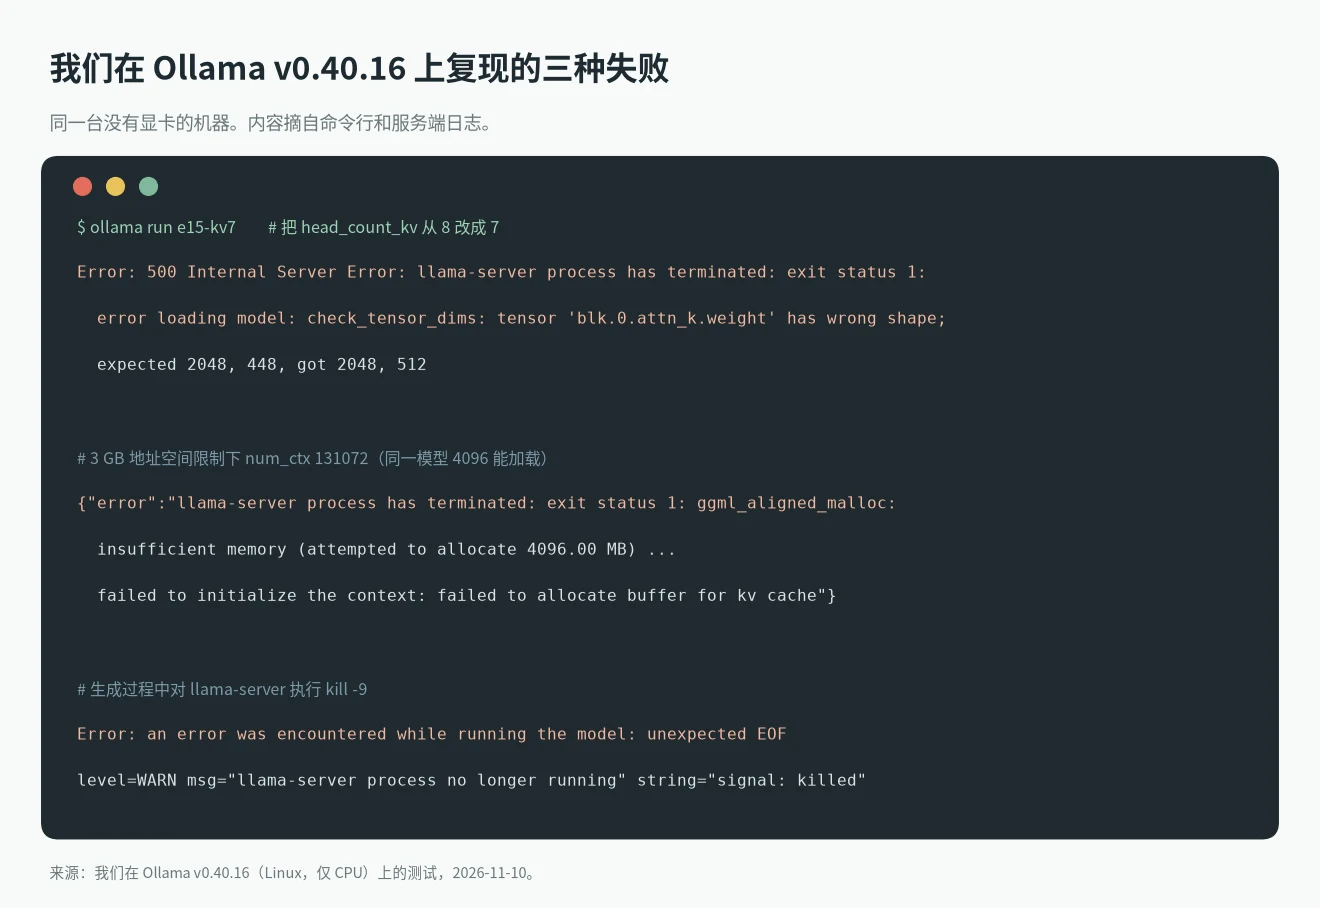
1. 模型文件和自己的元数据对不上。 我们复制了 llama3.2:1b(1.3 GB),改掉 GGUF 文件头里的一个数字,再用 ollama create 导入。五次创建都成功了,ollama run 都失败了:
attention.head_count_kv从 8 改成 7:check_tensor_dims: tensor 'blk.0.attn_k.weight' has wrong shape; expected 2048, 448, got 2048, 512block_count从 16 改成 17:tensor 'blk.16.attn_norm.weight' not foundembedding_length从 2048 改成 1024:tensor 'token_embd.weight' has wrong shapeattention.head_count改成 0:tensor 'blk.0.attn_q.weight' has wrong shape; expected 2048, 0attention.key_length改成 7:error loading model hyperparameters: invalid n_rot: 64, expected 7
截断的或随机的文件走不到这一步。1.3 GB 文件的 600 MB 截断副本、5 MB 随机文件、只有文件头的文件,都在 ollama create 时被拒绝,分别报 offset+size exceeds file size、unsupported file type 和 error reading GGUF item 25: EOF。所以在当前版本里,带 check_tensor_dims 的 “terminated” 多半说明文件转换或编辑有误,或者模型的元数据是按另一个版本写的。重新从模型库拉取,或者重新下载 GGUF,并对照来源核对大小和 SHA-256。
2. 架构不认识。 error loading model: unknown model architecture: 'name' 说明你的 Ollama 比模型旧。issue #19347(v0.40.12,lfm3)和 #19186(v0.40.8-rc0,flint)就是例子。更新 Ollama;我们的unknown model architecture 指南讲了 pull 成功、run 失败的原因。
3. 上下文需要的内存不够。 我们另起了一个服务端,给它 3 GB 的地址空间上限(prlimit --as=3000000000,用来代替内存限制),加载同一个 1.3 GB 模型。默认 4096 上下文能加载并回答。把 num_ctx 设成 131072(KV 缓存 4 GiB)就失败了:
llama-server process has terminated: exit status 1: ggml_aligned_malloc: insufficient memory (attempted to allocate 4096.00 MB) ... failed to initialize the context: failed to allocate buffer for kv cache
看到 failed to allocate 或 unable to allocate CUDA_Host buffer(见 #16455)时,先把上下文调小。Ollama 上下文长度讲了怎么设,Ollama 显卡要求讲了上下文占多少内存。单独的 “model requires more system memory” 提示见这篇。
exit status 1 还有一种情况:新模型跑在旧版本上。#18898(Gemma4Assistant requires ctx_other to be set,v0.40.2)在报告者确认 0.40.4 能用之后关闭了。
Windows 状态码:0xc0000409、0xc0000094、0xc0000005
微软的 NTSTATUS 列表里,0xc0000409 是 STATUS_STACK_BUFFER_OVERRUN,0xc0000005 是 STATUS_ACCESS_VIOLATION,0xc0000094 是 STATUS_INTEGER_DIVIDE_BY_ZERO。在 Ollama 的报告里,名字能告诉你的不如它前面打印的文字多:
- 0xc0000409 加一行 CUDA。 #19485(v0.40.13,GTX 1080)打印了
CUDA error: the provided PTX was compiled with an unsupported toolchain,报告者说把 NVIDIA 驱动更新到 582.78 就好了。#19122 和 #17627 打印CUDA error: shared object initialization failed;#19122 里其他用户把它和可用提交内存(内存加页面文件)不足联系起来,这条 issue 还没关。所以:更新驱动,关掉其他程序,确认页面文件没被限制得太小。 - 0xc0000409 但没有 CUDA 行。 #16650 出在开了量化 KV 缓存(
OLLAMA_KV_CACHE_TYPE)的 Phi4 上,可以试试去掉这个变量。#16576 报告了 Gemma 4 在 Windows 上的竞态,办法是先在终端里启动ollama serve再运行模型。两条都是用户报告,我们没有测过。 - 0xc0000094 或
signal: floating point exception。 6 月初 6 条 issue,都是 0.30.4 版本上的gemma4:12b;#16495 查到原因是mmproj n_head=0。六条都已关闭。更新 Ollama。 - 0xc0000005 和 0xe06d7363。 #18557、#19158、#19558 都出在 AMD 或 Intel 核显的 Vulkan 上(#19158 里有
ggml_vulkan: device lost)。官方 GPU 页面说,可以用OLLAMA_VULKAN=0或GGML_VK_VISIBLE_DEVICES=-1关掉 Vulkan,NVIDIA 上用CUDA_VISIBLE_DEVICES=-1可以强制走 CPU。我们没有显卡,这些开关没法测。
如果用了这些开关后 Ollama 跑到了 CPU 上,那是另一个问题,见 Ollama 不用 GPU。
Linux 和 Mac 的信号
- signal: killed。 Ollama 之外的东西杀了这个进程,在 Linux 上通常是内存不足的 OOM killer。用
dmesg | grep -i -E "out of memory|killed process"查。我们对 llama-server 执行了kill -9,看 Ollama 怎么报:生成过程中接口返回500 an error was encountered while running the model: unexpected EOF,服务端日志是WARN llama-server process no longer running ... string="signal: killed",下一个请求会新起一个 runner 并且成功。所以进程被杀时,客户端看到的不一定是 “has terminated”。如果反复出现,换小一点的模型或上下文。 - signal: segmentation fault。 三条 issue:#17249(GCP 上的 Granite Rapids 虚拟机)和 #17006(VMware ESXi 下的 Sapphire Rapids)是虚拟化的 Xeon,#17236 是一个在主线 llama.cpp 里能跑的混合 SSM 模型。换新版本试试,并报告 CPU 和虚拟化平台。
- signal: aborted。 两条 issue,都是 AMD 显卡(#16572、#16626)。更新,并附上日志。
哪些是我们测的,哪些来自报告
- 在 Ollama v0.40.16(Linux,8 核,15.6 GiB 内存,无显卡)上用 llama3.2:1b 测过:
ollama create拒绝截断、随机和只有文件头的文件;改文件头的五种情况都以exit status 1加载失败;3 GB 地址空间限制下 4096 与 131072 上下文的对比;生成中和空闲时的kill -9;可执行文件里的字符串。 - 没测:任何显卡、Windows 或 Mac 上的行为、CUDA、ROCm、Vulkan 的修复办法,以及表里的各个环境变量。这些来自 GitHub issue 和官方文档,关键处文中已经说明。地址空间限制不等于真的耗尽内存,只是在一台机器上产生了同样的分配失败。
- issue 数量来自 2026 年 11 月 10 日的 GitHub 搜索(
repo:ollama/ollama "process has terminated" created:>2026-06-01 is:issue)。搜索按词匹配,不是精确短语,数字只当作一个快照。 - 来源:Ollama 的排错和 GPU 页面,微软 NTSTATUS 列表,以及 github.com/ollama/ollama 上文中提到的 issue。
其他 Ollama 报错见报错速查。
常见问题
“llama runner process has terminated” 是什么意思?
运行模型的进程退出了,所以你的请求失败。原因在冒号后面的文字里:一个退出码加一行日志,或者一个信号。
现在是 “llama runner” 还是 “llama-server”?
现在的版本写 llama-server。我们在 v0.40.16 上的测试和近期 65 条 issue 里的 56 条都是这个写法,意思一样。
“exit status 1: error loading model” 怎么修?
看下一行。unknown model architecture 要更新 Ollama;check_tensor_dims 说明文件有问题或被改过,重新拉取;failed to allocate 就缩小上下文或换小模型。
Ollama 里的 exit status 0xc0000409 是什么意思?
Windows 把它标成栈缓冲区溢出。在报告里它总和 CUDA 错误一起出现,所以先更新 NVIDIA 驱动,再看它上面的那一行。
“signal: killed” 是不是内存不够了?
在 Linux 上经常是,但要用 dmesg 确认。