

llama.cpp 报错「error: --model or -hf is required」怎么办?超简单,一条命令解决(2026)
llama.cpp 报「error: --model or -hf is required」,是 llama-cli 启动时没拿到模型。用 -m 指向本地 GGUF,或者用 -hf 写上 Hugging Face 仓库就行。llama-server 不一样,不带模型会进入路由模式。2026 年 10 月 28 日对照 ggml-org/llama.cpp 源码核对。
 buffer关于作者约 6 分钟阅读
先说结论:llama.cpp 报 error: --model or -hf is required,是因为启动 llama-cli(或新的 llama cli)时没告诉它要加载哪个模型。用 -m /path/to/model.gguf 指向本地 GGUF,或者用 -hf user/repo:quant 写上 Hugging Face 仓库,就能正常启动。llama-server 是例外:不带模型不会报这个错,而是进入路由模式。下面的内容在 2026 年 10 月 28 日对照 ggml-org/llama.cpp 源码和 Ollama 官方文档核对过。
报错原文和出现原因
完整报错只有一行:
error: --model or -hf is required它来自 common/arg.cpp 里的参数解析。llama.cpp 读完你的参数后,会检查有没有通过 -m/--model、-hf、--model-url 或 --docker-repo 指定模型。一个都没有,就抛出这个报错并退出。
这句话是新改的。2026 年 10 月 27 日合并的 PR #31242 把原来的 error: --model is required 改成了 error: --model or -hf is required,让报错直接写出两种解决办法。v0.8.0 的发布说明里写的是「CLI: --model or -hf is now required」。如果你用的是旧版本,看到的是 error: --model is required,检查逻辑和修法都一样。
最常见的 --model or -hf is required 触发情况:
- 直接运行
llama-cli或llama cli,什么参数都没带。 - 脚本或服务依赖环境变量
LLAMA_ARG_MODEL,但当前终端、systemd 服务或容器里没设置这个变量。 - 照着旧教程复制命令,漏掉了加载模型那一步。
我们实际跑了一遍
2026 年 10 月 28 日,我们在一台 Linux 测试机上下载了官方的 b11963 构建(llama-cli --version 显示 version: 0.8.0-dev (build 11963, commit 39febd2ad)),把上面几种情况都试了:
- 什么参数都不带运行
llama-cli,输出error: --model or -hf is required,退出码是 1。 - 只写
llama-cli -m不跟路径,报的是另一句:error while handling argument "-m": expected value for argument。看到这句说明参数写了但路径是空的,通常是脚本里$MODEL这类变量没赋值。 llama-cli -hf ggml-org/Qwen3.5-0.8B-GGUF -p "Reply with one word: hello" -n 16 -st自动下载模型并回答,全程约 51 秒。这个仓库里没有 Q4_K_M 文件,llama.cpp 就按帮助说明取了Qwen3.5-0.8B-Q8_0.gguf。- 之后运行
llama-cli -cl,列出了ggml-org/Qwen3.5-0.8B-GGUF:Q8_0,文件在~/.cache/huggingface/hub/models--ggml-org--Qwen3.5-0.8B-GGUF/下面。 - 用
LLAMA_ARG_MODEL=<这个文件> llama-cli -p "Say OK" -n 4 -st,不写-m也能跑。 - 不带模型启动
llama-server没有报错,日志是starting server in router mode. models will be automatically loaded on-demand。
Ollama blob 路径的用法和 Windows、macOS 版本我们没有测。
换下载地址:MODEL_ENDPOINT
-hf 默认从 https://huggingface.co/ 下载。llama.cpp 在 PR #12664(contrib: support modelscope community,2025 年 4 月合并) 里加了环境变量 MODEL_ENDPOINT,源码 common/common.cpp 会先读它,没有再读 HF_ENDPOINT。这个 PR 是魔搭(ModelScope)社区贡献的,用来从其他兼容地址下载模型:
export MODEL_ENDPOINT=https://你能访问的兼容地址/
llama-cli -hf ggml-org/Qwen3.5-0.8B-GGUF
我们测试用的 b11963 的 --help 里没有单独的 ModelScope 参数,换地址只靠这个环境变量;换成别的地址这一步我们没有实测。也可以先把 .gguf 文件下载到本地,再用 -m 指过去,同样不会再报 –model or -hf is required。
–model or -hf is required 的修法
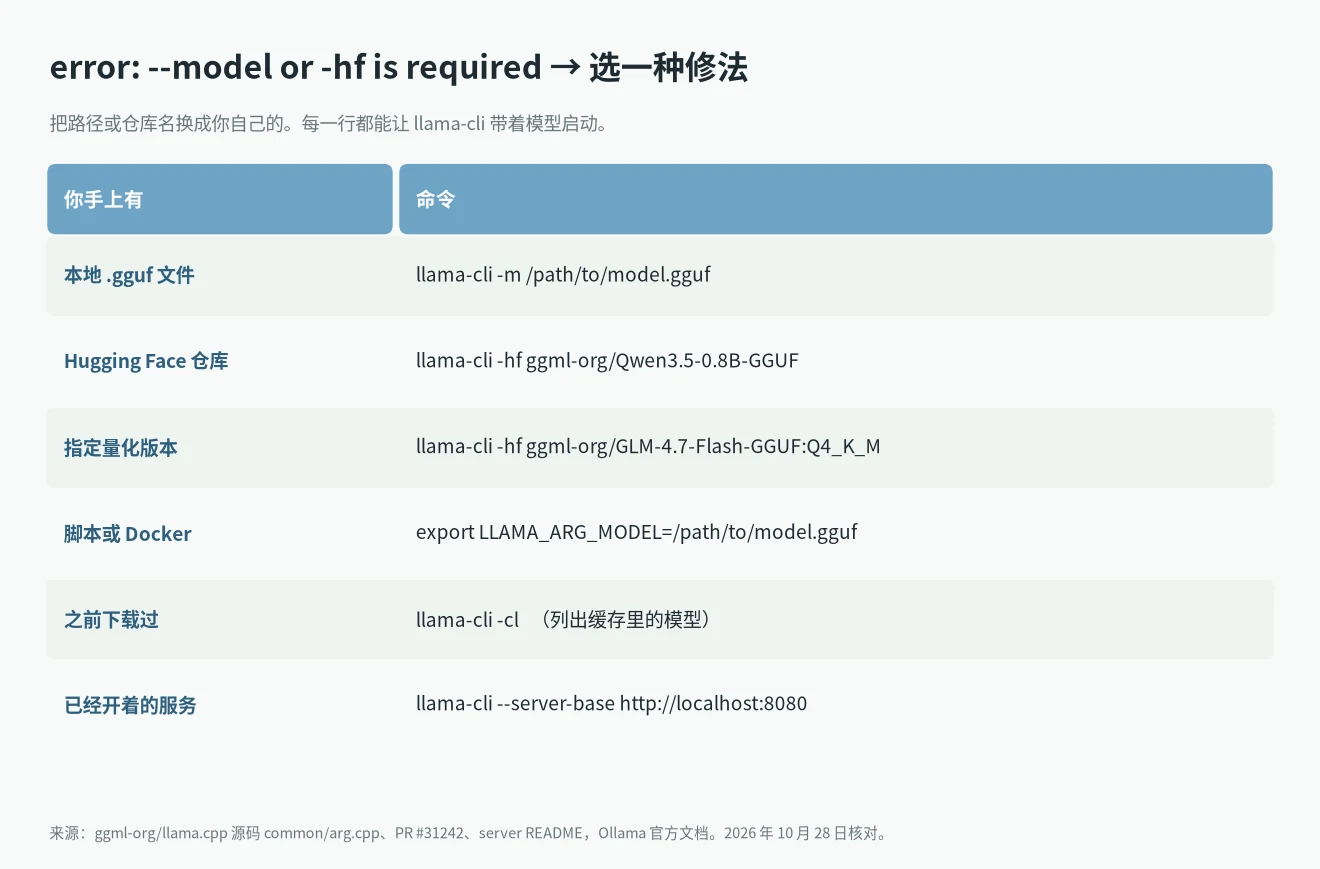
按你手上有什么选一行,把路径或仓库名换成自己的。
硬盘上已经有 GGUF 文件
llama-cli -m /path/to/model.gguf-m 和 --model 是同一个参数,帮助里的说明是「model path to load」。
想从 Hugging Face 下载
llama-cli -hf ggml-org/Qwen3.5-0.8B-GGUF这是 llama.cpp README 里的示例。想指定量化版本,在冒号后面写上:
llama-cli -hf ggml-org/GLM-4.7-Flash-GGUF:Q4_K_M按帮助说明,量化名不区分大小写,默认是 Q4_K_M;仓库里没有 Q4_K_M 时会取第一个文件。仓库里有视觉投影文件(mmproj)也会一起下载,不需要的话加 --no-mmproj。需要授权的仓库,用 -hft 传 token,或者设置 HF_TOKEN。
用脚本或 Docker 启动
每个参数都有对应的环境变量,在命令运行前设置其中一个:
export LLAMA_ARG_MODEL=/path/to/model.gguf
# 或者
export LLAMA_ARG_HF_REPO=ggml-org/Qwen3.5-0.8B-GGUF
server README 的 Docker Compose 示例里写的就是 LLAMA_ARG_MODEL: /models/my_model.gguf。设置了还是报 --model or -hf is required,说明变量没传进进程:检查 environment: 配置、systemd 的 Environment= 行,或者是不是在另一个终端里 export 的。
已经有一个服务在跑
llama-cli 可以直接连现有的服务,不用自己再加载一份模型:
llama-cli --server-base http://localhost:8080设置了 --server-base 时,arg.cpp 会跳过模型要求,不会报 --model or -hf is required。地址和端口换成你服务实际监听的。
llama-server 需要 –model 或 -hf 吗?
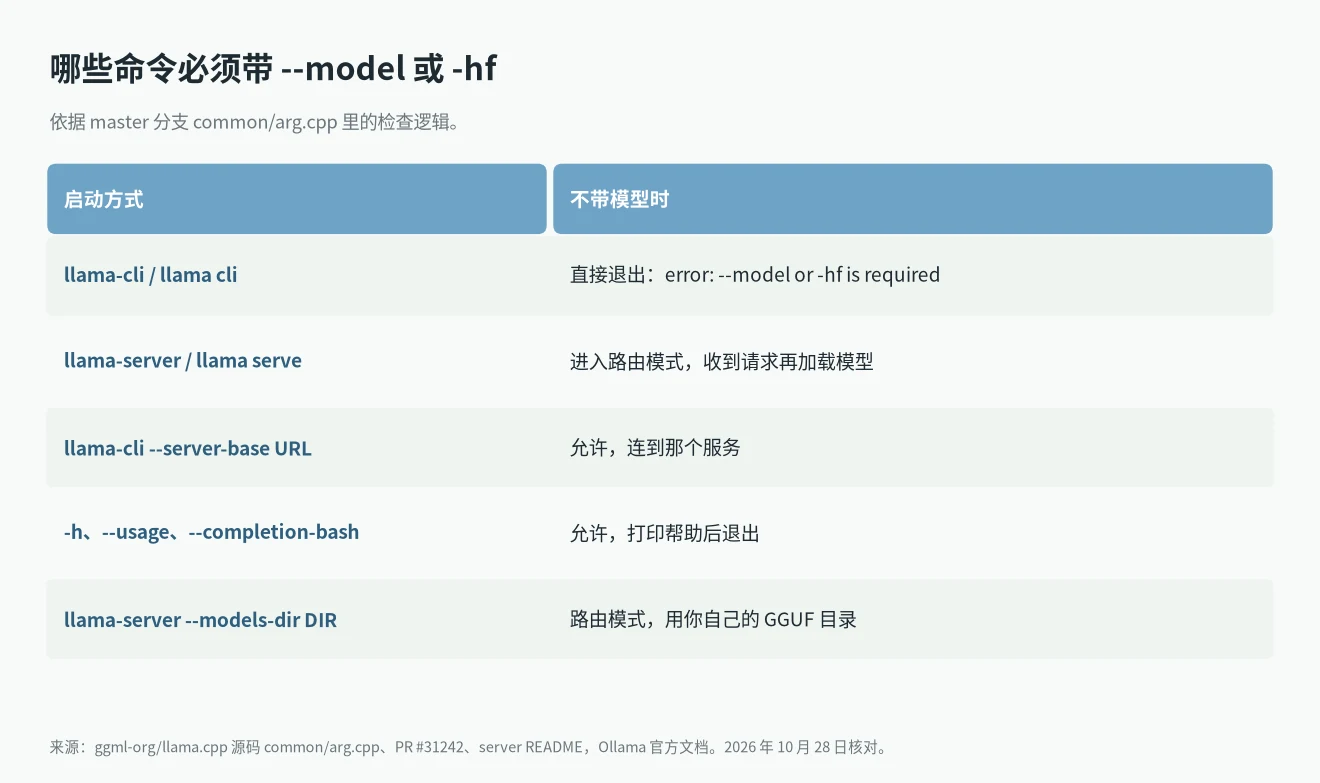
不需要,llama-server 不会报 --model or -hf is required,服务端不走这个检查。server README 原文是:「To start in router mode, launch llama-server without specifying any model」。路由模式下,服务收到请求才加载模型,模型来源有三种:
- 缓存:用
llama-server -hf加进去(加完要重启服务)。/ : - 一个放 GGUF 文件的目录:
llama-server --models-dir ./models_directory。 - 预设文件:
llama-server --models-preset ./my-models.ini。
要注意的是请求这一侧。路由模式下每个 API 请求都必须带 model 字段,不带的话服务会返回 model name is missing from the request。想要原来那种只跑一个模型的方式,就像上面一样用 -m 或 -hf 启动。
-h、--usage、--completion-bash 这类只打印帮助的参数,也不需要模型。
找到已经下载过的模型
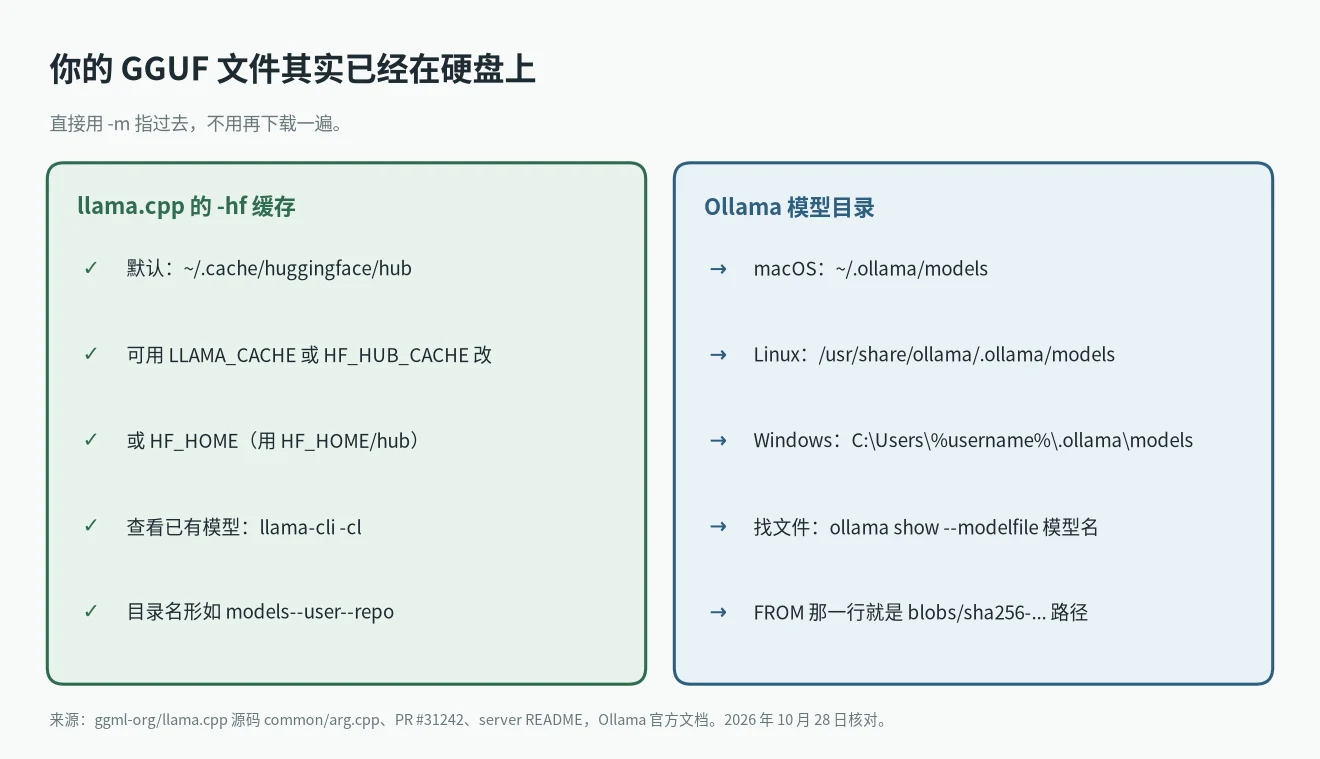
遇到 --model or -hf is required 时,重新下载几个 GB 之前,先看看硬盘上有什么。
用 llama.cpp -hf 下载的模型
列出缓存:
llama-cli -cl-hf 下载的文件默认放在 ~/.cache/huggingface/hub。llama.cpp 会依次检查 LLAMA_CACHE、HF_HUB_CACHE、HUGGINGFACE_HUB_CACHE、HF_HOME/hub 和 XDG_CACHE_HOME/huggingface/hub。再次运行同一条 -hf 命令会直接用缓存里的文件。
用 Ollama 下载的模型
Ollama FAQ 写明了模型存放位置:
- macOS:
~/.ollama/models - Linux:
/usr/share/ollama/.ollama/models - Windows:
C:\Users\%username%\.ollama\models
设置 OLLAMA_MODELS 可以改这个位置。文件是按哈希命名的,所以让 Ollama 直接告诉你路径:
ollama show --modelfile llama3.2Modelfile 文档里展示了输出:FROM 那一行指向 ~/.ollama/models/blobs/sha256-... 这样的文件。把这个路径交给 llama.cpp:
llama-cli -m ~/.ollama/models/blobs/sha256-<hash>两个项目都没有把这种用法写成官方支持的流程。如果 Ollama 版本的模型需要 llama.cpp 不支持的东西,可能加载失败,这时改用 -hf 下载 GGUF。
常见问题
为什么更新后才开始报 –model or -hf is required?
检查本身早就有了。2026 年 10 月 27 日改的是报错文字(PR #31242),以及 README 现在让新用户从 llama cli -hf ... 开始。如果旧命令以前能跑,看看是不是少了 -m,或者某个环境变量没了。
该加载哪个模型?
第一次测试可以用 ggml-org/Qwen3.5-0.8B-GGUF 这种小模型,大部分电脑都能跑。更多选择可以看我们的本地大模型推荐和本地写代码模型与硬件指南。
显存够不够?
下载前用我们的显存计算器估一下。显存不够时加载阶段会报别的错,不是 --model or -hf is required。