

mac mini 可以跑大模型吗?16GB 到 64GB 能跑什么、跑多快(2026)
mac mini 可以跑大模型吗,按 Apple 官网规格和价格、Ollama 模型大小、llama.cpp 跑分 2026 年 10 月 28 日核对:各档内存能装多大的模型,M6 和 M5 Pro 跑多快,怎么选。
 buffer关于作者约 5 分钟阅读
mac mini 可以跑大模型吗?可以。先说结论:16GB 的入门款能跑 8B 到 14B 的 4bit 模型;想跑 gpt-oss-20b、Qwen3-30B-A3B 这一级,买 24GB 或 32GB 的 M6 版;想跑 70B 的 4bit 模型,要选 64GB 的 M5 Pro 版。gpt-oss-120b 这样的模型文件有 65GB,任何一台 Mac mini 都装不下。速度方面,M6 版跑 7B 的 4bit 模型每秒能生成约 36 个 token,M5 Pro 版约 68 个,日常对话都够用。下面的规格和价格来自 Apple 官网,模型大小来自 Ollama 的官方模型页,速度来自 llama.cpp 的跑分帖,我在 2026 年 10 月 28 日(北京时间)逐条核对过。
简短回答
- 能不能跑:能。Mac mini 的 CPU 和 GPU 共用统一内存,模型放进内存后由 GPU 计算,不需要另配显卡。
- 能跑多大:看内存。16GB 适合 14B 以下的 4bit 模型,32GB 能装下 32B 的 4bit 模型,64GB 能装下 70B 的 4bit 模型。
- 能跑多快:看内存带宽。M6 是 153GB/s 或 170GB/s,M5 Pro 是 307GB/s,同一个模型 M5 Pro 版的生成速度接近 M6 版的两倍。
- 怎么买:只想试试本地模型,买 M6 的 16GB 就行;想长期用,至少 24GB;要跑 70B,直接上 64GB 的 M5 Pro。
Mac mini 各配置的内存和带宽
现在的 Mac mini 有两种芯片。按 Apple 官网技术规格页:M6 版是 12 核 CPU、12 核 GPU,16GB 内存起,可以选配 24GB 或 32GB;16GB 版的带宽是 153GB/s,24GB 和 32GB 版是 170GB/s。M5 Pro 版是 15 核 CPU、16 核 GPU,24GB 内存起,可以选配 48GB 或 64GB,带宽 307GB/s,还可以升级到 18 核 CPU、20 核 GPU 的 M5 Pro。
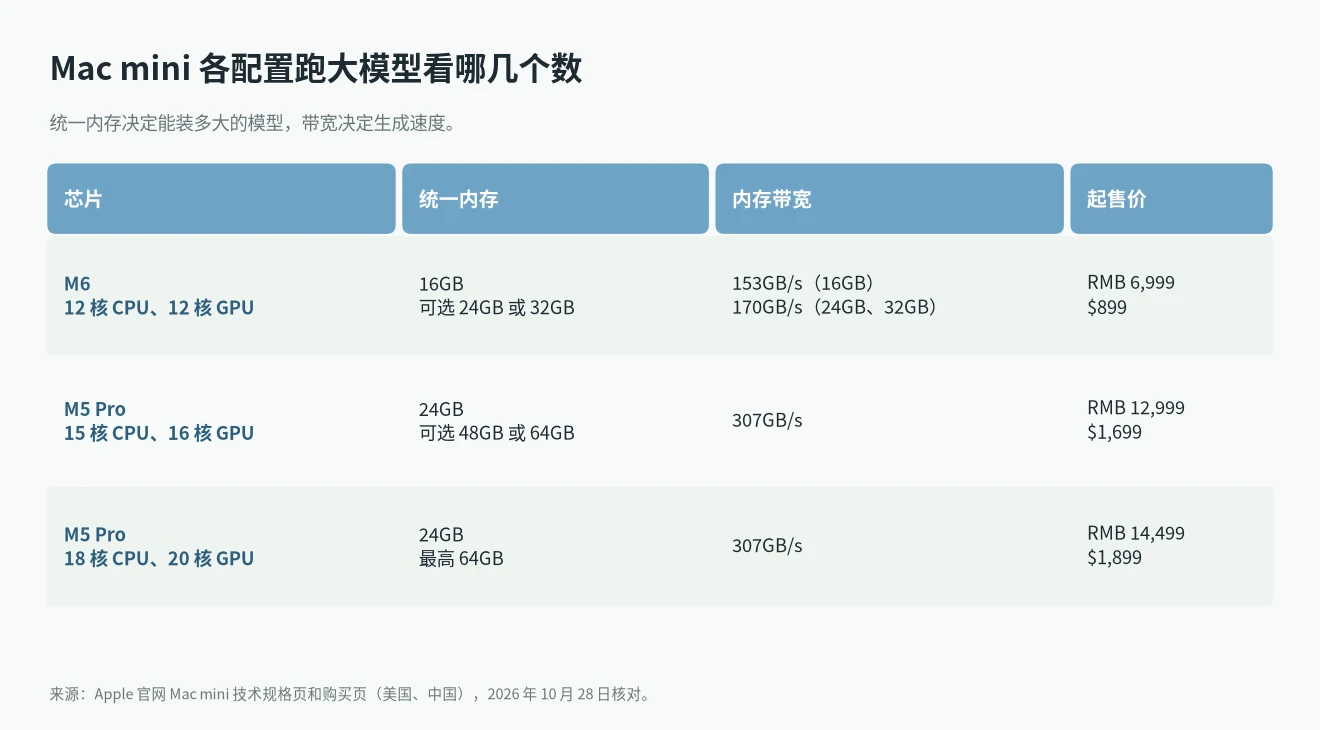
价格按 Apple 中国官网购买页:M6 版 RMB 6,999 起,M5 Pro 版 RMB 12,999 起,20 核 GPU 的 M5 Pro 版 RMB 14,499 起。加内存要另外付钱,具体价格以下单页为准。
有一点要注意:Mac mini 的内存和芯片封装在一起,买了以后不能再加。所以跑模型这件事,内存要一次买够。
mac mini 可以跑大模型吗:按内存看能装多大
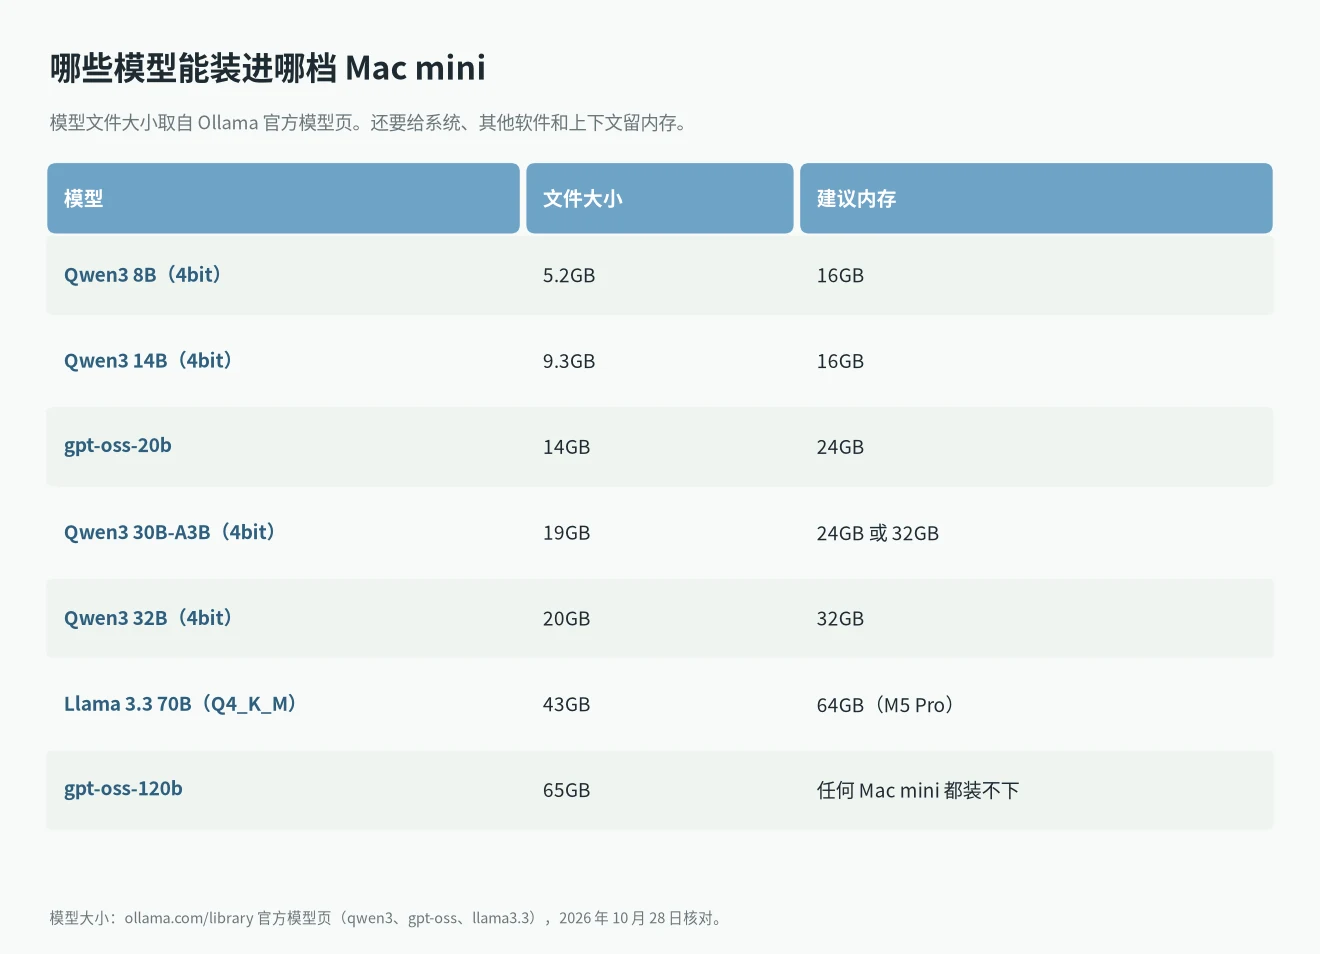
判断一个模型能不能跑,先看模型文件有多大。下表的文件大小来自 Ollama 的 Qwen3 模型页、gpt-oss 模型页和 Llama 3.3 模型页。实际占用比文件大一些,因为上下文也要占内存,系统和其他软件也要留出空间。
按内存分:
- 16GB:Qwen3 8B 的 4bit 版是 5.2GB,14B 的 4bit 版是 9.3GB,都能跑。再大就很紧张了。
- 24GB:可以跑 gpt-oss-20b(14GB)和 Qwen3 30B-A3B(19GB)。Apple 在 24GB 的 M5 MacBook Pro 上用 MLX 实测,4bit 的 Qwen3-30B-A3B 占了 17.31GB,原话是 24GB 的机器能轻松装下(Apple 的 MLX 测试)。
- 32GB:Qwen3 32B 的 4bit 版是 20GB,能装下,还能给上下文留些空间。这是 M6 版的上限。
- 48GB 和 64GB:只有 M5 Pro 版能选。Llama 3.3 70B 的 Q4_K_M 版是 43GB,64GB 才比较宽裕。
- 装不下的:gpt-oss-120b 是 65GB,超过了 Mac mini 最高的 64GB。这一级要看 128GB 的机器,我在 AI Max 395 和 DGX Spark 怎么选 里比过。
想本地跑 DeepSeek 的话,满血版需要的内存远超 Mac mini,可以先看 DeepSeek 本地部署要什么配置。
跑多快:M6 和 M5 Pro 对比
生成回答时,每出一个 token 都要把模型权重从内存里读一遍,所以生成速度主要看内存带宽。token 是什么、和字数怎么换算,可以看 token是什么意思。
llama.cpp 的 Apple 芯片跑分帖里有两台 Mac mini 的成绩,测的都是 Llama 2 7B。32GB 的 M6 版,4bit(Q4_0)每秒生成 35.74 个 token;64GB、16 核 GPU 的 M5 Pro 版是 67.59 个。不量化的 F16 版,两台分别是 11.59 和 21.39 个。这些是用户提交的数据,不是 Apple 官方测的。
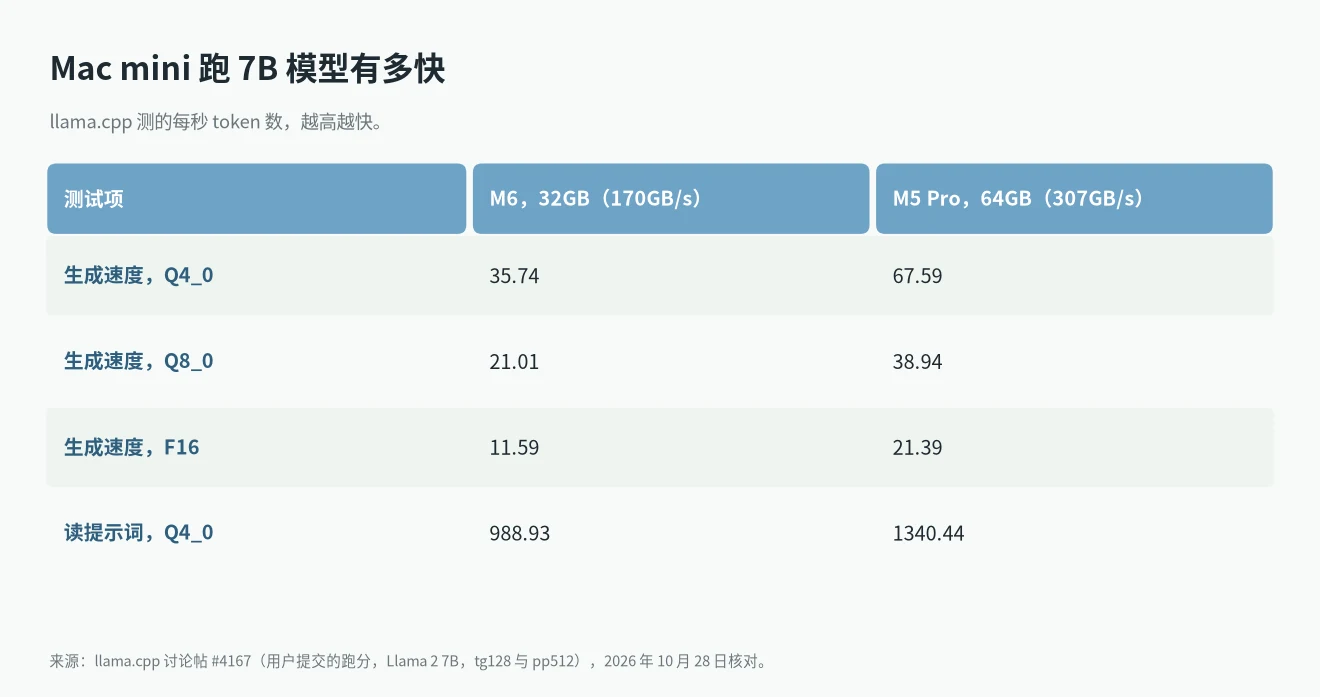
模型越大,生成越慢。粗略地说,速度和模型文件大小成反比,同一台机器跑 70B 会比跑 7B 慢很多。读提示词的速度主要看 GPU 算力,M5 Pro 版也更快。M6 和 M5 Pro 的 GPU 都带神经网络加速器(Apple 规格页),用 MLX 跑模型时能用上。
用什么软件跑
- Ollama:有 macOS 版,装好后一条命令下载并运行模型,上面表格里的模型大小就是它的。
- MLX:Apple 的开源框架,pip install mlx-lm 后用 mlx_lm.chat 就能对话,见 mlx-lm 项目。
- llama.cpp:上面的速度就是用它测的,适合想自己调参数的人。
第一次跑建议从 Ollama 开始。安装后在终端里输入 ollama run qwen3:8b,它会先下载 5.2GB 的模型文件,下载完就能直接在终端里对话。跑的时候可以打开“活动监视器”的内存页看“内存压力”,如果一直是黄色或红色,说明模型对这台机器来说太大了,换小一号的模型或者更低的量化版本。
怎么选:16GB、24GB、32GB、64GB
- 只想试试本地模型:M6 的 16GB 版,RMB 6,999 起。能跑 8B 到 14B 的模型,用来写写东西、做翻译。
- 想长期用、写代码:至少 24GB,最好 32GB。写代码用什么模型,看 本地大模型写代码选哪个。
- 要跑 70B 或更快的速度:64GB 的 M5 Pro 版。带宽 307GB/s,生成速度接近 M6 版的两倍。
M5 系列其他机型的对比,看 M5 跑大模型;想知道现在下手还是再等等,看 Mac 现在买还是等。
常见问题
mac mini 可以跑大模型吗,16GB 够不够?
够跑 14B 以下的 4bit 模型。Qwen3 14B 的 4bit 版是 9.3GB,16GB 的机器还要留内存给系统和其他软件,再大的模型就不建议了。
Mac mini 能跑 70B 的模型吗?
能,但要 64GB 的 M5 Pro 版。Llama 3.3 70B 的 Q4_K_M 版是 43GB,M6 版最高只有 32GB,装不下。
M6 版和 M5 Pro 版差在哪?
内存上限和带宽。M6 版最高 32GB、带宽最高 170GB/s;M5 Pro 版最高 64GB、带宽 307GB/s。同一个 7B 模型,M5 Pro 版的生成速度接近 M6 版的两倍。
我没能确认的
- Apple 官网没有公布 Mac mini 跑模型的速度,上面的速度是 llama.cpp 用户提交的,换软件、换模型结果会不一样。
- 24GB 的 M6 版和 48GB 的 M5 Pro 版没有找到跑分,只能按带宽推断。
- 加内存的具体差价我没有在购买页上逐项核对,所以文中只写了各款的起售价。