

Ollama 报错「pull model manifest: 412」怎么办?别慌,先升级(附实测)
Ollama 报「Error: pull model manifest: 412」,意思是你要拉的模型需要比当前更新的 Ollama。按官方方法升级,再用 ollama -v 确认。我们在 Linux 上用 0.40.8 复现了这个报错,并用 0.40.12 拉了同一个模型。
 buffer关于作者约 5 分钟阅读
先说结论:Ollama 拉模型时报 Error: pull model manifest: 412,意思是这个模型要求的 Ollama 版本比你装的新,模型仓库检查了你的版本号后拒绝下载。按官方方法升级 Ollama,用 ollama -v 确认版本变了,再拉一次就行。我们在 2026 年 10 月 29 日(北京时间)用一台 Linux 测试机复现了这个报错:0.40.8 报 412,换成 0.40.12 后同一个模型过了这一步。
pull model manifest: 412 报错原文
版本太旧时,完整输出是这样的:
pulling manifest
Error: pull model manifest: 412:
The model you are attempting to pull requires a newer version of Ollama.

Please download the latest version at:

        https://ollama.com/download
412 是 HTTP 状态码「Precondition Failed」,这里的前提条件就是你的 Ollama 版本。麻烦的是,模型页面不一定写了最低版本。GitHub issue #18414 里就有用户提到,在 Ollama 0.32.3 上拉 qwen3.8:27b 报 pull model manifest: 412,可模型页上找不到任何版本要求。
还有一种写法。如果模型需要的版本还在预发布阶段,后半句会变:
Error: pull model manifest: 412:
The model you are attempting to pull requires a newer version of Ollama that may be in pre-release.

Please see https://github.com/ollama/ollama/releases for more details.
这是 issue #19085 里报告的:用户在当时最新的正式版 0.40.5 上拉 bonsai-2:9b,新版本发布后 issue 关闭。看到「may be in pre-release」,说明光升到最新正式版还不够,要么装预发布版,要么等正式版。
我们的实测:0.40.8 和 0.40.12 对比
我们在同一台 Linux 机器上并排装了两个官方版本,拉的是 lfm3。这个模型是 2026 年 10 月 27 日发布的 Ollama v0.40.12 新加的。
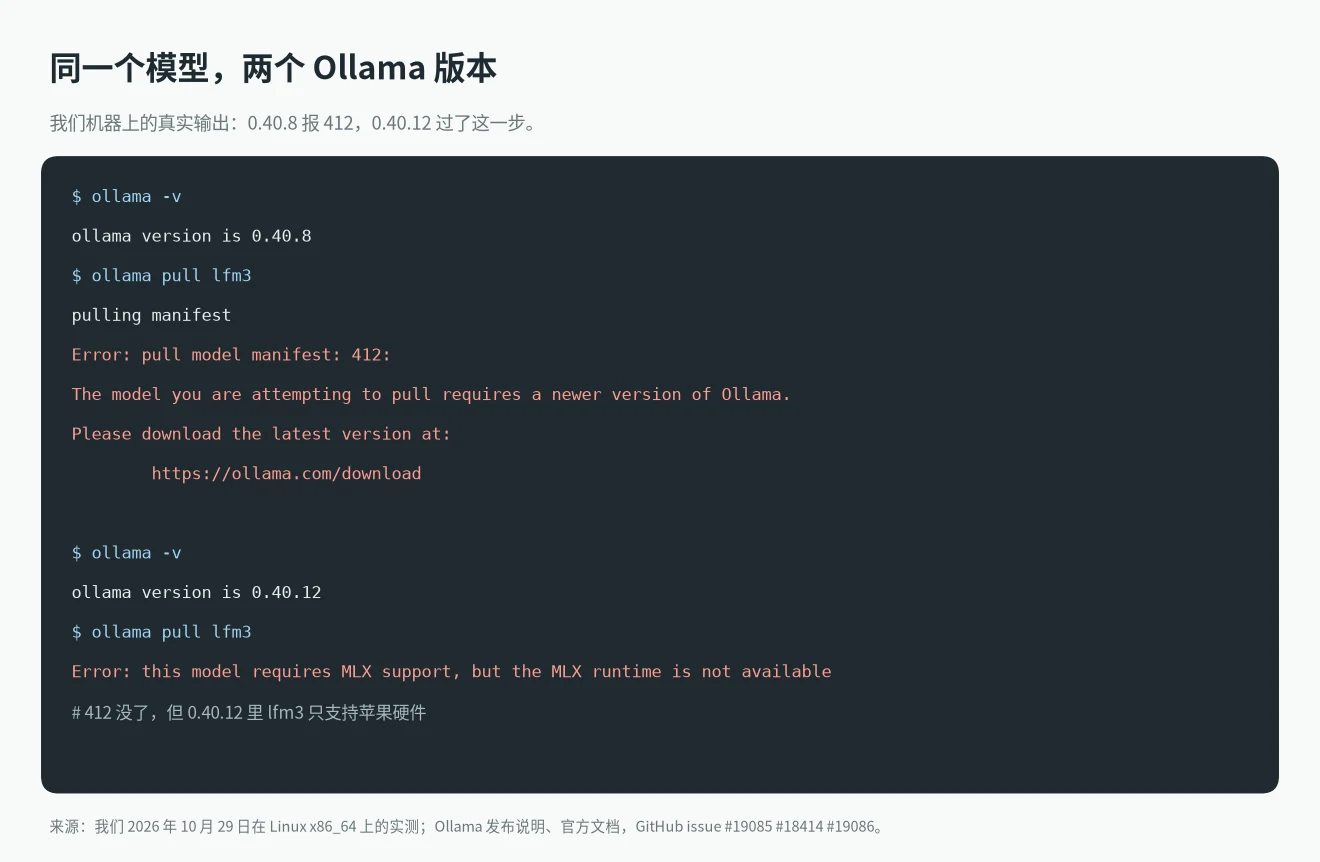
- 0.40.8 上运行
ollama pull lfm3,输出和上面的 pull model manifest: 412 原文一字不差。直接调 API(POST /api/pull),error字段里也是同样的文字。 - 同样是 0.40.8,拉
nemotron-3.5-bolt和d3都过了 manifest 这一步。所以 412 是按模型判断的,不是「版本旧就一律拒绝」。 - 换到 0.40.12,412 没了,但拉取停在另一句:
Error: this model requires MLX support, but the MLX runtime is not available。
最后这句别忽略。v0.40.12 的发布说明写着:「lfm3 and d1 2b are supported on Apple hardware in this release. Support for Linux/Windows coming soon.」也就是这一版里 lfm3 只支持苹果硬件。我们的测试机是 Linux,升级解决了版本检查,接着就碰到了平台限制。如果你在 Linux 或 Windows 上拉刚发布的新模型,先看一眼加入这个模型的那版发布说明,别在 412 上白折腾。
pull model manifest: 412 的解决步骤
1. 看版本:运行 ollama -v。客户端和服务端版本不一致时,会多一行 Warning: client version is …。模型仓库看的是服务端版本。
2. 去 GitHub releases 对照最新版本,在发布说明里搜模型名,看它是哪个版本加入的。
3. 升级。官方 FAQ 写了各系统的方法,见下表。
4. 再运行 ollama -v 确认,然后重新拉模型。版本够了,pull model manifest: 412 就不会再出现。
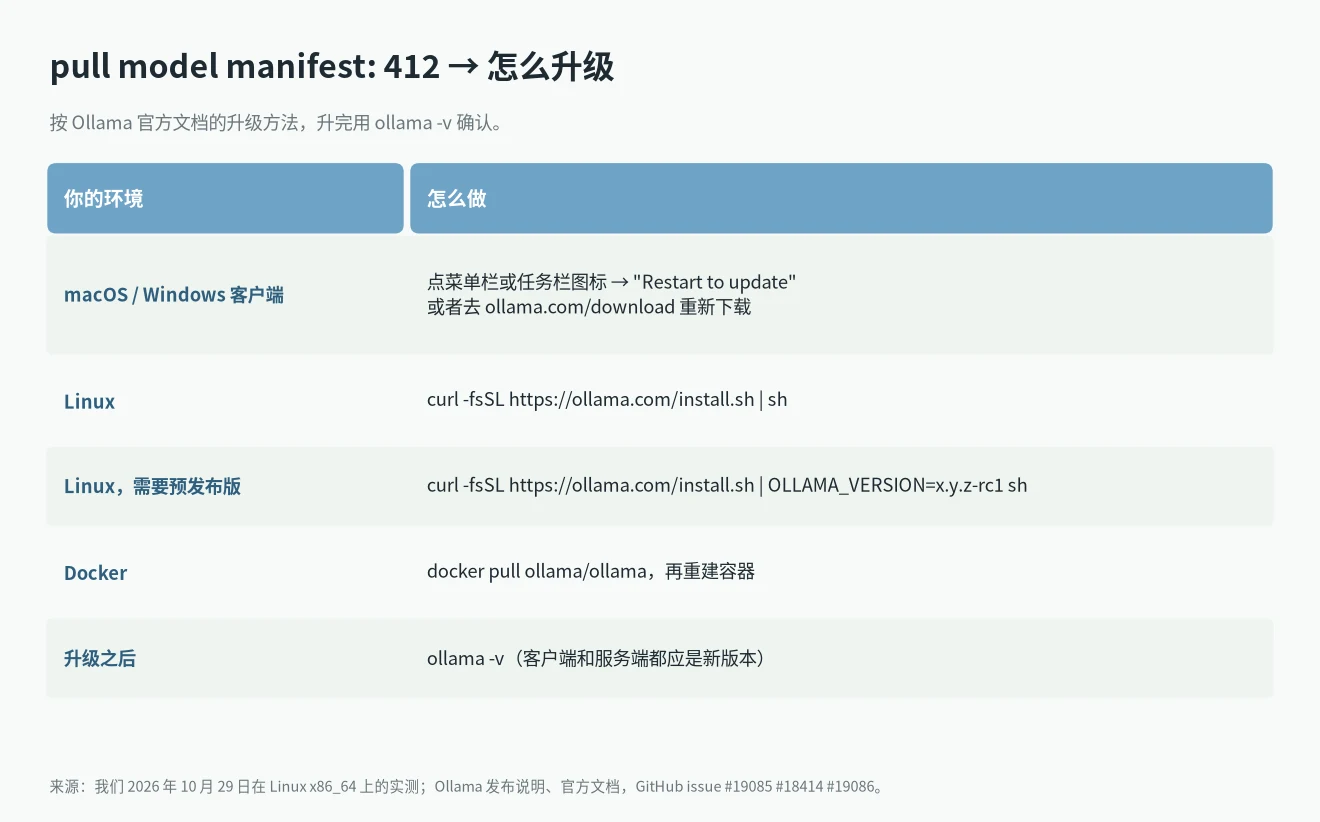
macOS 和 Windows
桌面版会自动下载更新。点菜单栏(macOS)或任务栏(Windows)里的 Ollama 图标,出现「Restart to update」就点它。也可以从 ollama.com/download 下载最新安装包直接覆盖安装。
Linux
重新运行安装脚本,它会替换旧版本:
curl -fsSL https://ollama.com/install.sh | sh需要预发布版时,Linux 文档写了怎么指定版本,候选版也能装:
curl -fsSL https://ollama.com/install.sh | OLLAMA_VERSION=0.40.12 sh把版本号换成 GitHub releases 里你需要的那个。如果 Ollama 是 systemd 服务,升级后看一下 systemctl status ollama,确认在跑的是新版本。
Docker
镜像名是 ollama/ollama。拉新镜像,重建容器,模型目录挂载到原来的路径,已下载的模型就还在。
自己导入的模型
Modelfile 里也能用 REQUIRES 指令声明最低版本。旧客户端拉这类模型时,提示是 model requires ollama version X or newer (current version is vY),修法一样,升到 X 以上。我们实测,本地用 REQUIRES 0.99.0 创建的模型照样能运行,因为这个检查发生在拉取时,本地 create 不检查。
看着像 412,其实不是
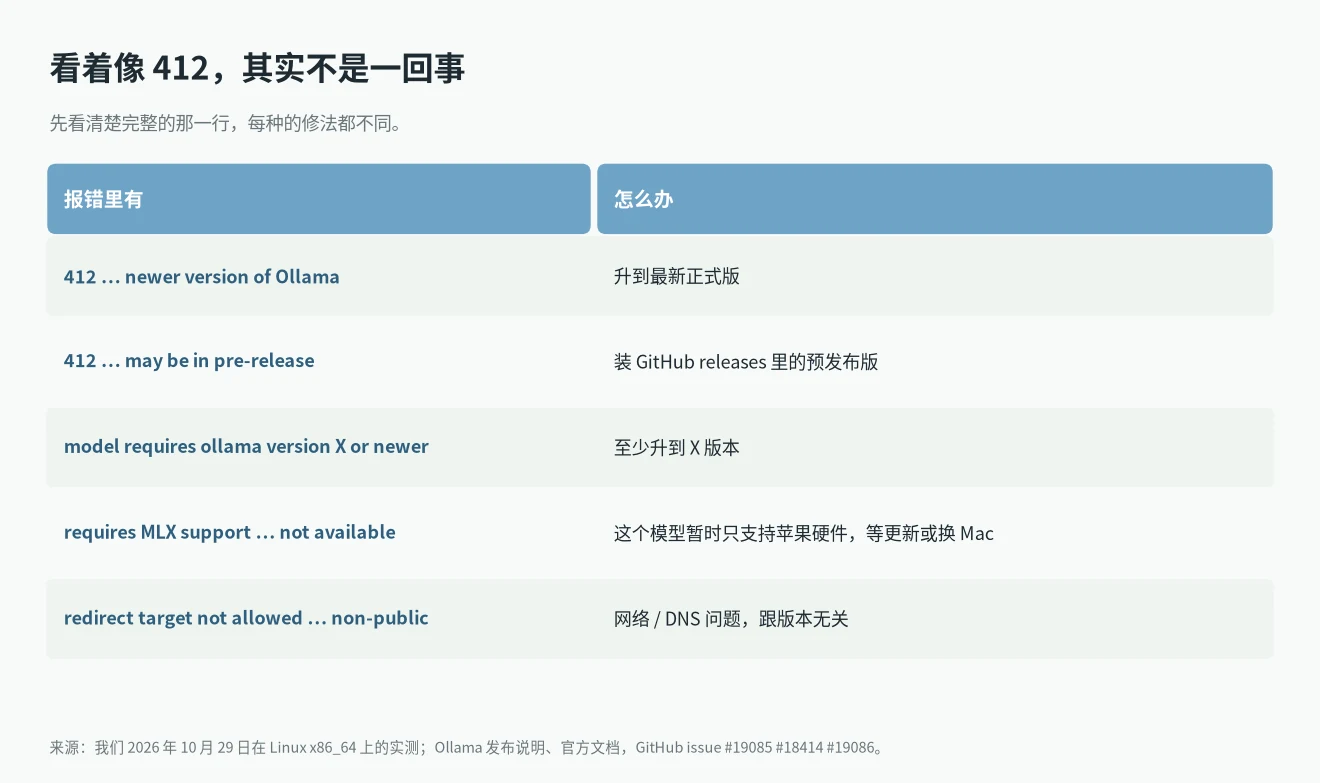
下面两种报错常被当成 pull model manifest: 412,但原因不同。
redirect target not allowed … resolves to non-public
这是网络问题,和版本无关。Ollama 不允许从解析到内网或保留地址的主机下载模型文件。issue #19086 的提问者在路由器上为 VPN 做了 DNS 劫持,用的是 198.18.0.0/15 这段 fake-ip,结果报 redirect target not allowed: … resolves to non-public 198.x.x.x。我们的测试机也走 fake-ip DNS,报了同一句。提问者关闭 issue 时说加 --insecure 能绕过,但在我们的网络里,0.40.12 上运行 ollama pull --insecure d3:2b 返回的是 Error: pull model manifest: 500:。这个参数的说明是「Use an insecure registry」,不建议常用。更稳的办法是让下载域名解析到真实公网地址,比如在代理工具里把 *.r2.cloudflarestorage.com 和 registry.ollama.ai 排除出 fake-ip。
unknown model architecture
如果拉取成功,但加载时日志里是 unknown model architecture,说明模型文件比 Ollama 内置的推理引擎新。这是另一回事,见Ollama 报 unknown model architecture 的解决方法。
常见问题
报 pull model manifest: 412 是模型坏了吗?
不是。模型没问题,是你的 Ollama 比这个模型要求的版本旧。
升级了还是报 pull model manifest: 412?
先跑 ollama -v。Linux 上可能旧服务还在运行,macOS 和 Windows 上可能应用还没重启。如果已经是最新正式版,多半是模型需要预发布版,对照上面「may be in pre-release」那种提示。
不升级能用这个模型吗?
从 Ollama 模型库拉不行。如果你手里有 GGUF 文件,可以直接用 llama.cpp 跑,见llama.cpp 加载本地 GGUF 的方法。按显卡选模型可以看本地大模型写代码的模型和硬件对照和本地大模型推荐。