
决策模型,能让我们少等一会儿吗?
从 GPT-3.5 那会儿开始,我最想把大模型用在自己的客服工作里。最难界定的,是人工什么时候介入,以及 AI 的服务边界在哪里。
 buffer关于作者约 7 分钟阅读
从 GPT-3.5 那会儿开始,把大模型接进自己的客服工作,就是我最想尝试、也最先想到的 AI 应用。当时最难界定的,是人工应该在哪个节点介入,以及 AI 的服务边界究竟在哪里。
最近读到决策模型的密集发布,我又想起了当时这道题。这类模型主要负责判断和选择,比如一条消息该交给哪个部门,信息够不够调用工具,是否需要请人接手。这些小判断,可能影响一次求助要绕多少路。
在客服窗口里输入“转人工”时,我们往往已经试过几种办法。订单查了,帮助页翻了,问题也描述过一遍。再收到一段周到的回复,当然好;只是这时候,更希望有人能接着往下处理。
另一头的客服也未必轻松。等问题终于转过来,聊天记录可能很长,订单信息却在另一个系统里。有时双方的耐心,就消耗在这些来回之间。我希望 AI 能帮上的忙,也包括让这样的交接顺一点。
决策模型处理的是流程里的小判断
拿售后来举个例子。一位顾客说快递显示签收,自己却没收到。系统接下来可以查物流、请顾客补充信息,或转给有权限处理的同事。这里先要做的是理解当前情况,从已有流程里选出合适的一步;至于怎样解释得清楚、怎样安慰焦急的人,可以由后面的对话和服务继续完成。
这也解释了决策模型与聊天模型的分工。聊天模型通常逐步生成文字回答,决策模型则更偏向返回程序能直接使用的选项、评分或概率。两者可以放在同一个产品里。此前写过的 Liquid AI d1,就是这条路线上的一个具体例子,输入限制和部署条件在那篇里有更细的介绍。
分类、打分本来就是机器学习熟悉的工作。如今值得留意的是,厂商开始把理解自然语言、接受任务说明、输出固定选项这些能力,做成可复用的服务。开发者有机会少维护一些零散规则,也少为一次简单分流等待一整段文字。
一笔融资背后,几家公司在做相近的事
10 月 9 日,TypeSafe 宣布获得 8.7 亿美元融资,估值 75 亿美元,由 a16z 领投。它的首款模型是 Jev,主要根据给定的材料和问题返回结构化判断。这笔融资让决策模型受到更多关注,我也好奇,这些投入最后会变成哪些日常用得上的功能。
微软也推出了 Microsoft-Decision-1,面向是非判断、选项选择和评分等任务。微软披露,Xbox Research 已把它用于分析一万多条玩家反馈。这类工作很能说明它的位置:先把大量意见整理成可处理的信号,让人更容易找到值得继续看的问题。
Cloudflare 则在 10 月 9 日更新了 Clef 系列,增加能接收图像、音频和视频的 Clef-omni,同时给 Clef-flash 降价。几家公司的产品形态并不完全相同,但它们都在争取进入软件中反复发生的判断环节。相比再开一个聊天窗口,这些功能可能藏得更深,用户未必知道自己用过它们。
一次判断便宜下来,才有机会经常用
把公开报价换到同一个单位后,这个方向的价格就比较容易理解了。截至 2026 年 10 月 10 日,Jev 与 Microsoft-Decision-1 的输入价格都是每百万 token 0.042 美元;Clef-flash 降到了 0.038 美元。这里的 token 是模型处理文本等输入时使用的计量单位,各模型的能力、上下文限制和分词方式仍有差异。
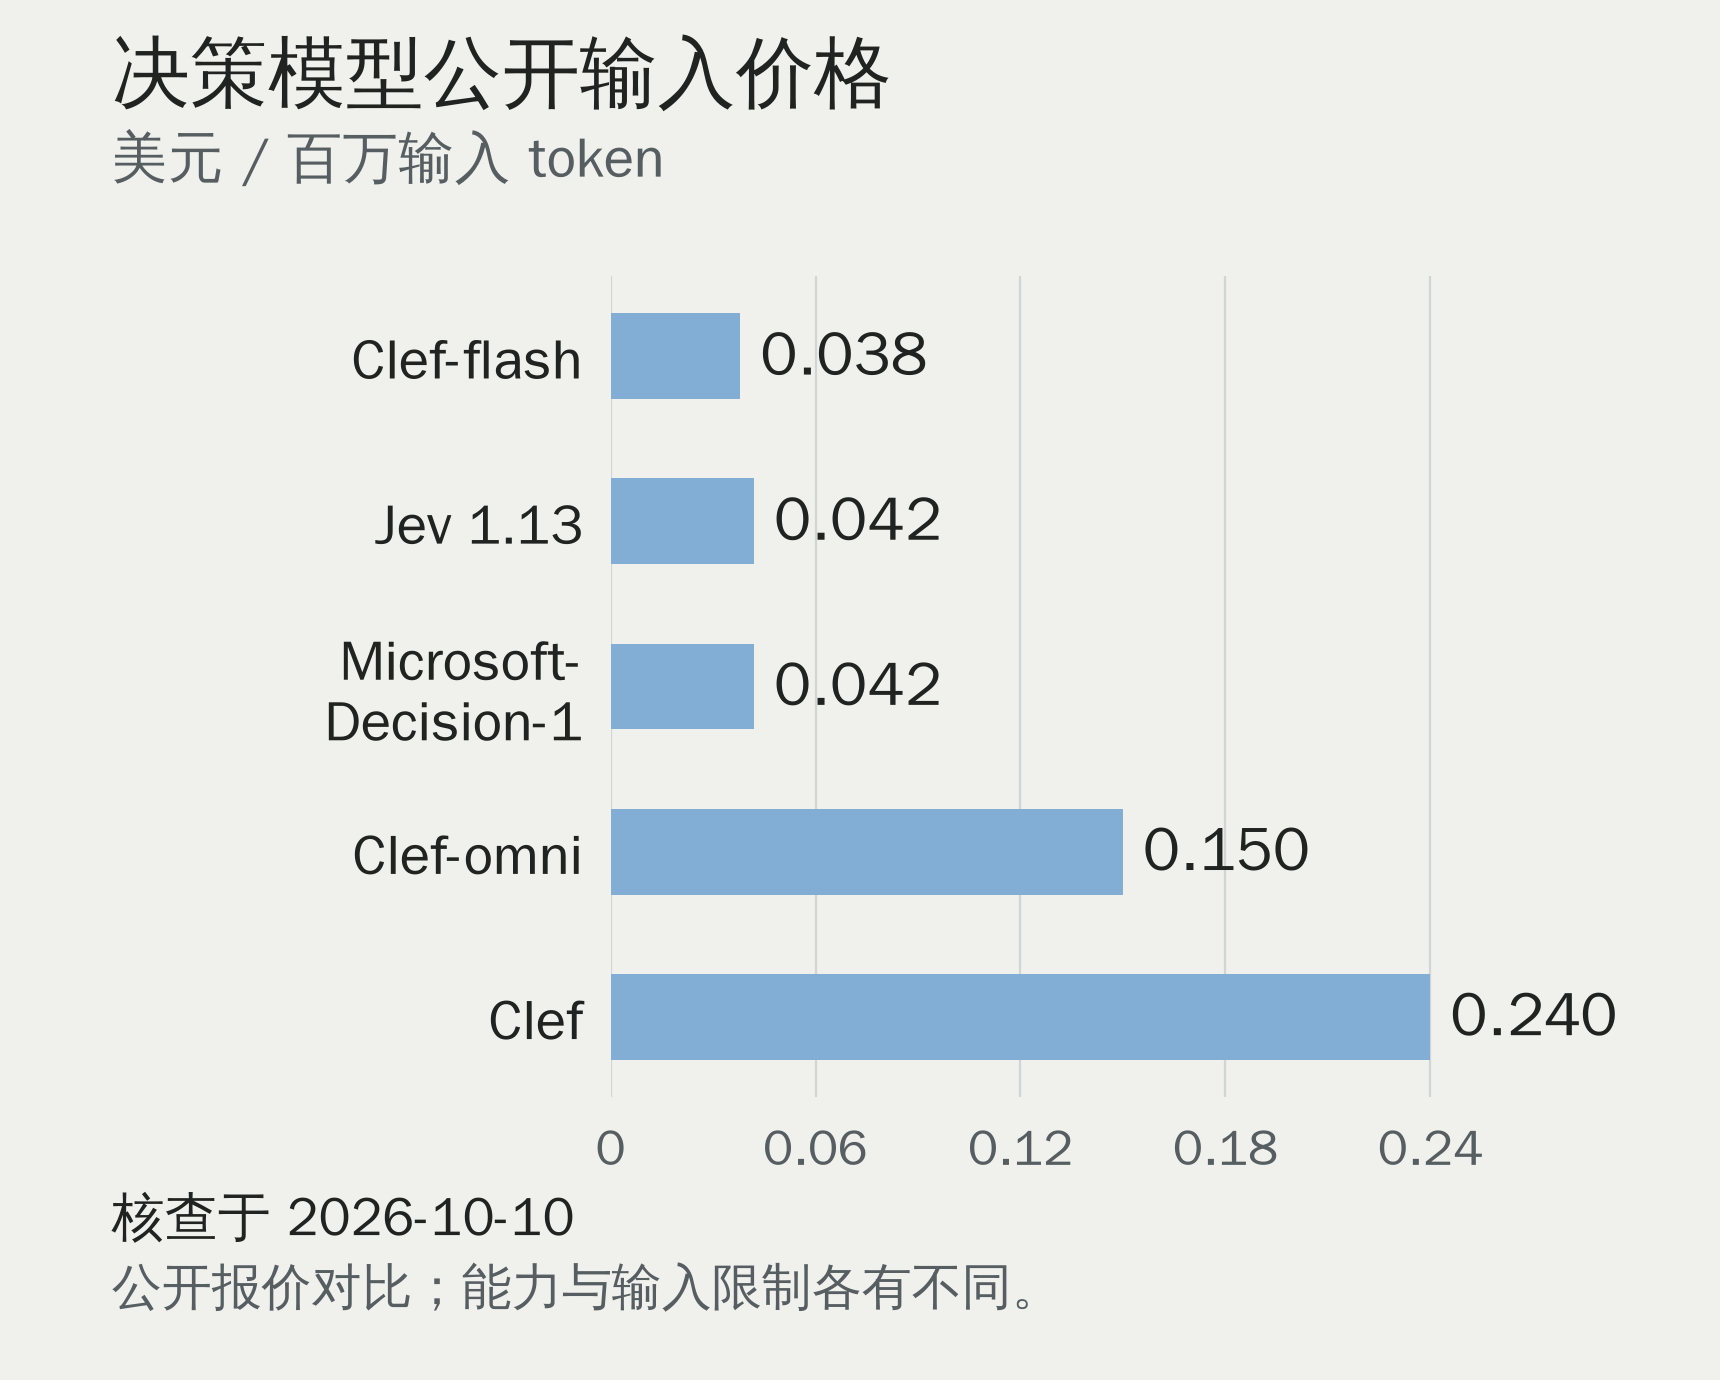
做一个单纯的费用示例:假设每次判断连同任务说明、候选选项等,完整输入合计 500 token,调用一百万次就是五亿 token。按 0.042 美元的单价,输入费为 21 美元。Jev 和微软这款模型的输出都不另收费,不过,这只是其中一个判断步骤的模型费用,查订单、后续对话和人工处理仍有各自的成本。
我之前在 DeepSeek × 华为那篇文章里也聊过,接口降价要走过一段路,才会变成使用者能感受到的实惠。放到这里,我比较期待的变化是:一些原本不值得单独做的小功能,可以开始认真做了。比如更早发现资料缺了一项,或在排队前就把问题送到合适的组。
便宜也会伴随取舍。Cloudflare 这次把托管版 Clef-flash 的上下文窗口从 64k 缩到 24k。简短分流也许够用,长聊天记录却可能需要另一种安排。对开发者来说,选型因此更像是在看自己的工作量和材料,而不是只比较价目表上最小的那个数。
换一道题,成绩就会换个顺序
价格之外,公开评测里有一个很直观的细节。Cloudflare 的同一张测试表中,Jev 在 When2Call 上领先,而 Clef-omni 在 BANKING77 上更好。前者涉及何时调用工具等判断,后者是银行客服意图分类;下面只取这两项,看看任务变化会带来多大差别。
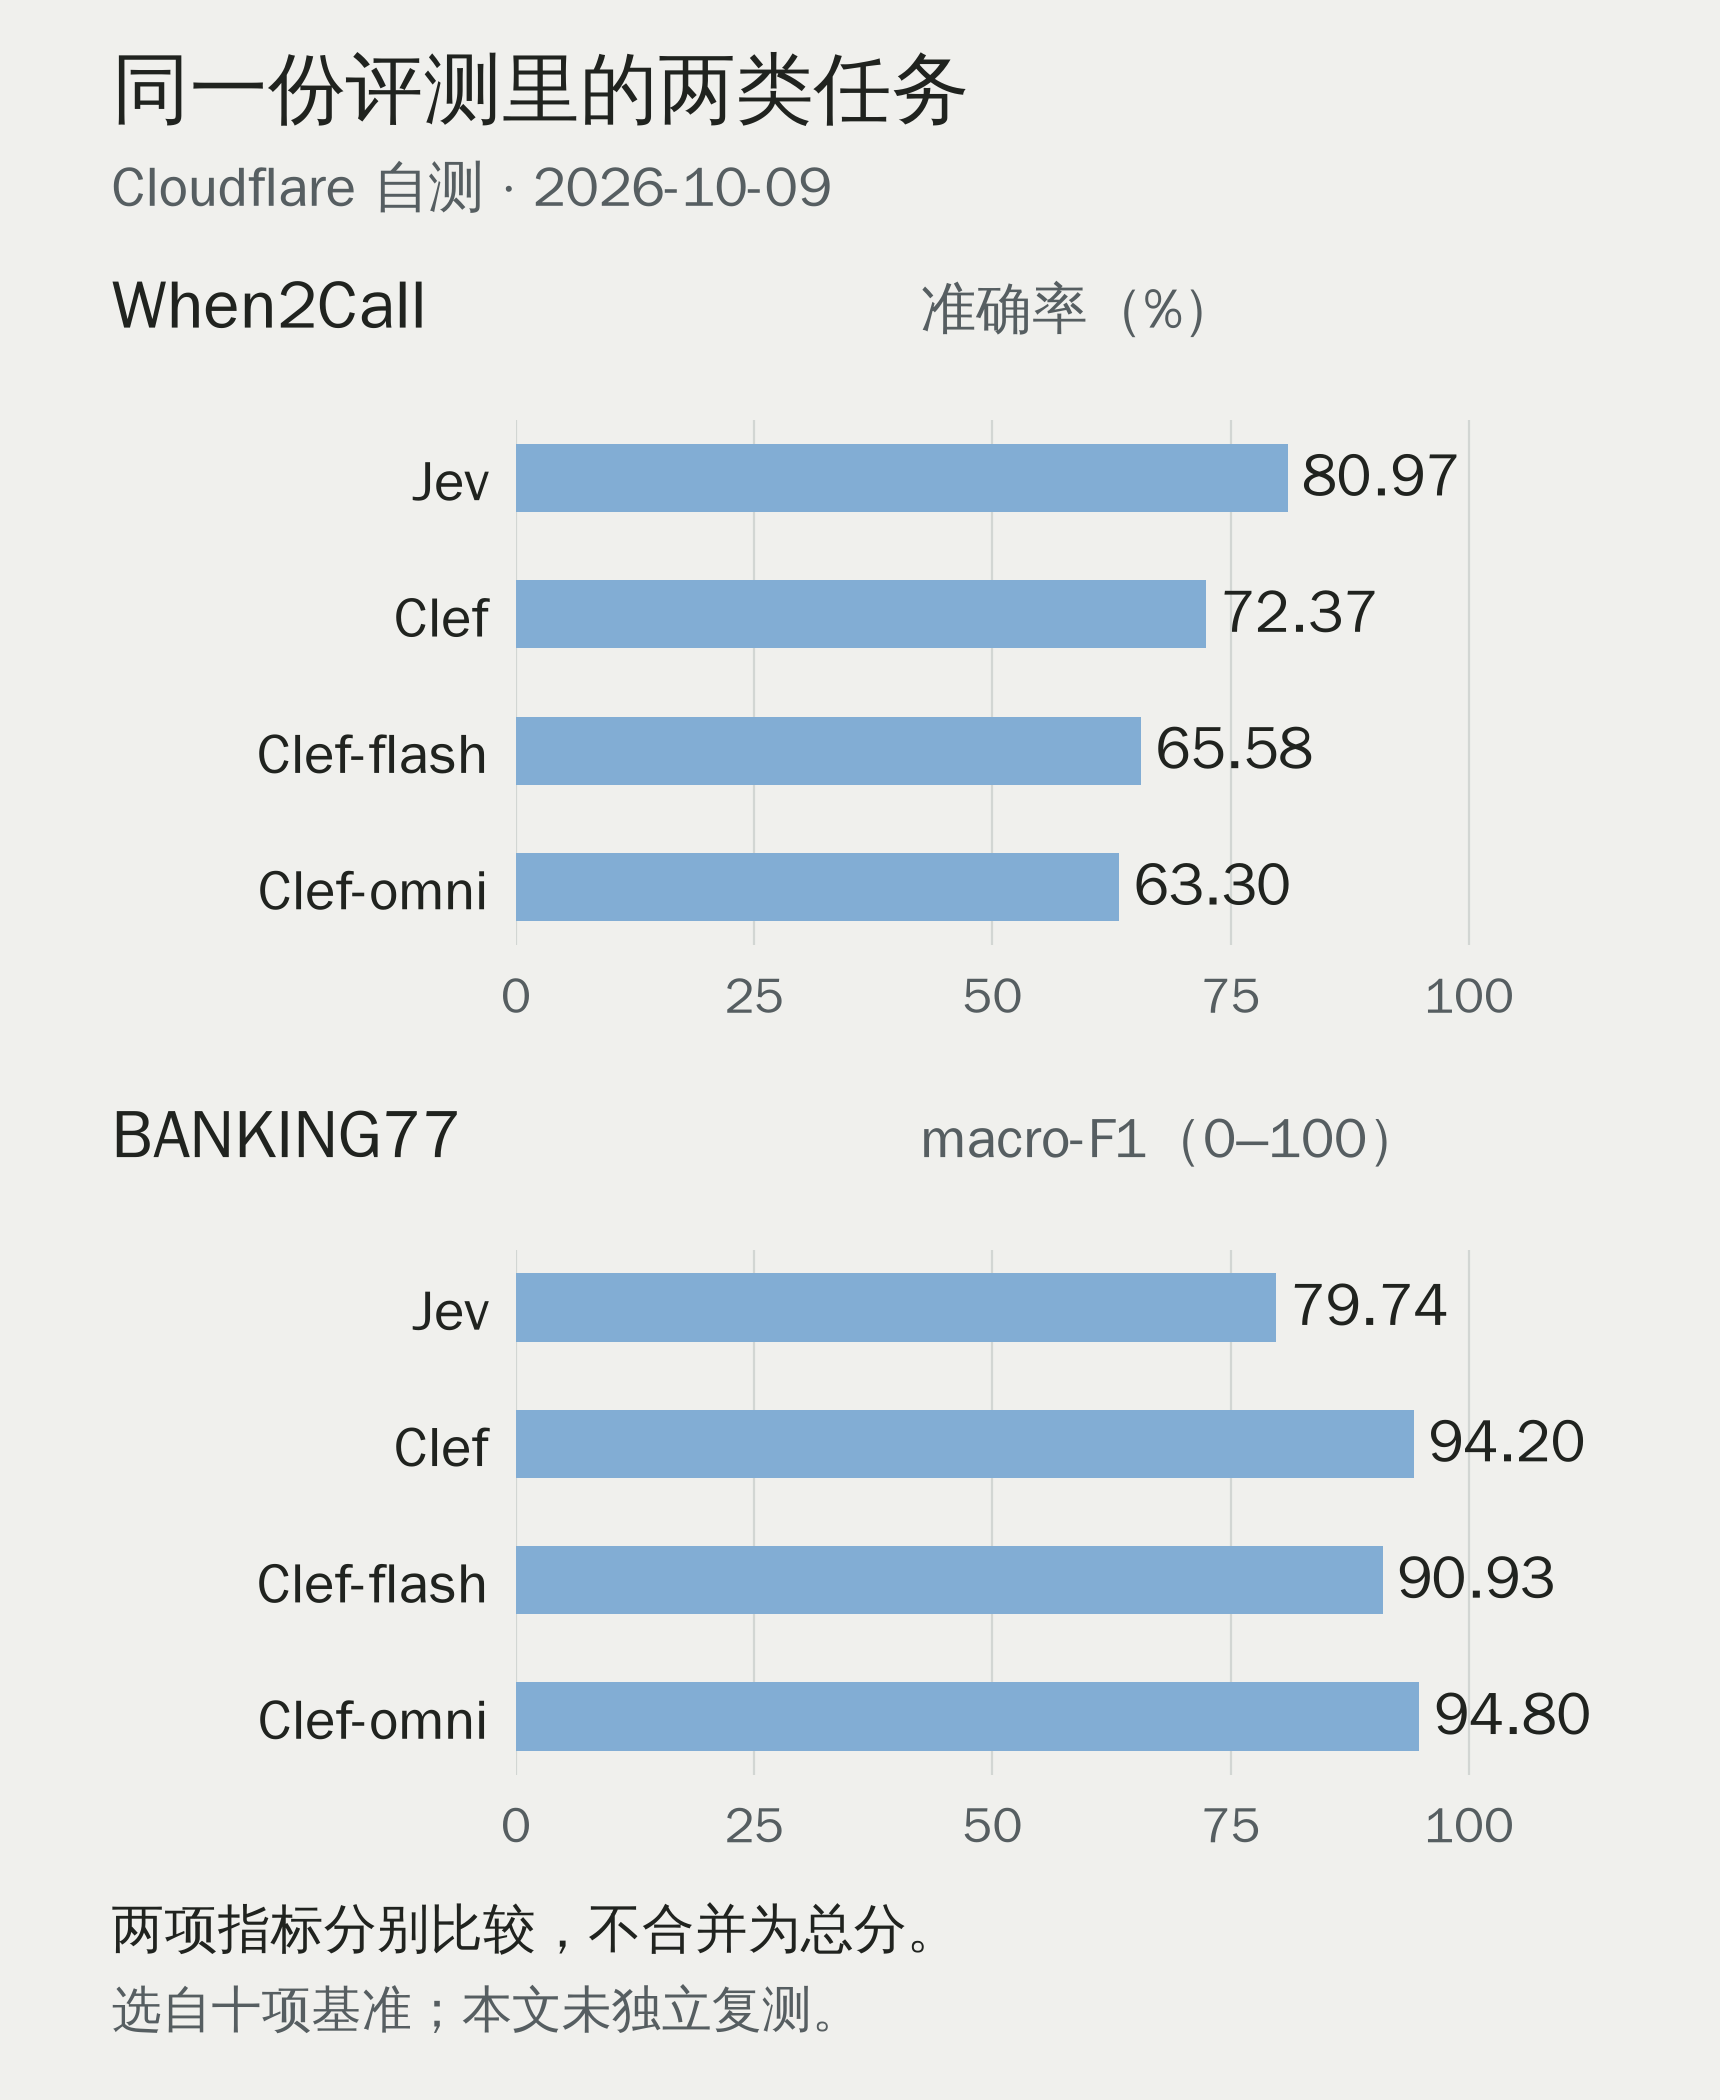
这组结果由 Cloudflare 自行公布,我没有独立复测。两项成绩用的指标也不同,适合在各自任务内比较。它们给我的启发很具体:一个模型擅长把客户问题分门别类,未必同样擅长判断此刻该不该调用工具。放进同一套客服流程的不同位置,合适的选择可能也会不同。
中文使用还有一层需要留意。TypeSafe 的模型文档说明,Jev 当前在英语上表现最好。真实工单里的省略、错别字、中英混写,以及一句话里同时提到几件事,都值得放进试用材料。拿团队熟悉的一小批案例看它怎么分,通常比照着总榜猜测更容易发现问题。
回到当时最难界定的服务边界
回到最初想把 AI 接进客服工作的念头,退款就是一个很具体的例子。识别出用户想退款、确认是否符合规则、真正执行退款,是几件不同的事。模型可以帮忙识别请求,服务允许它做到哪一步,则要结合权限和处理流程来安排。
决策模型给出的结果更规整,确实方便程序接着运行。但选项合法,仍可能选错。比如模型认定某件事属于物流问题,实际上顾客已经和物流沟通过,只能由商家继续处理。多读懂这一层前情,可能比更快地给出同一个分类更有帮助。
也有一些等待来自模型之外:接口没有接通、退款需要权限、接手的同事正在忙。决策模型能参与分流,却不会自动补齐这些条件。它的价值,最终还是要和后面的流程一起看。若能让客服少翻几页记录,让顾客少重复一次订单号,已经是很具体的改善。
我也希望,用户明确提出想找人时,这个选择能被顺畅地接住。系统拿不准的情况,可以早点交出去,并把已经确认的信息一并带上。接手的人知道前面试过什么,求助的人也知道接下来由谁处理、还要等多久。这样的交接,需要前面几个判断彼此配合。
这也是我会继续关注决策模型的原因。最初那个把 AI 用进客服工作的想法,依然很吸引我;现在更期待的,是服务边界清楚一些,人与系统之间交接得自然一些。少一点重复,或许就能给求助的人和接手的人,都留出一点耐心。
资料与价格核查于 2026 年 10 月 10 日。封面为 AI 生成的概念图;数据图按所链接的官方资料重绘。费用示例为假设计算,评测成绩为厂商公布,本文未进行模型 API 实测。