
Modelos de decisión: cuándo dar paso a una persona
La atención al cliente fue el primer uso que imaginé para un gran modelo de lenguaje. Desde la época de GPT-3.5, lo más difícil era decidir hasta dónde debía llegar la IA.
 bufferSobre el autor7 min de lectura
Desde la época de GPT-3.5, la atención al cliente fue el primer uso que se me ocurrió para un gran modelo de lenguaje y el que más quería probar en mi propio trabajo. Lo más difícil de definir era en qué momento debía intervenir una persona. ¿Hasta dónde podía llegar la IA dentro del servicio?
Los recientes anuncios de modelos de decisión me han hecho volver a aquella pregunta. Estos modelos se especializan en elegir el equipo al que enviar una solicitud, comprobar si hay información suficiente para usar una herramienta o identificar un caso que necesita revisión. Son pasos pequeños, aunque de ellos puede depender cuánto tarda alguien en recibir ayuda.
Cuando una persona escribe «quiero hablar con alguien», quizá ya ha consultado su pedido, leído la página de ayuda y explicado el problema una vez. Una respuesta amable se agradece. A esas alturas, también necesita que alguien pueda seguir con la gestión.
Quien recibe la consulta puede encontrarse con una conversación larga y los datos del pedido en otro sistema. Parte de la paciencia de ambos se pierde en ese recorrido. Me gustaría que esta tecnología ayudara precisamente ahí.
Qué hacen los modelos de decisión en la atención al cliente
Pensemos en un paquete que figura como entregado, pero que el cliente no ha recibido. El siguiente paso podría ser consultar el seguimiento, pedir un dato que falta o pasar el caso a alguien con permiso para resolverlo. Antes de redactar otra respuesta, hay que escoger cómo continuar.
Un modelo conversacional suele generar una respuesta de texto. Un modelo de decisión tiende a devolver una opción permitida, una puntuación o una probabilidad que el programa puede utilizar directamente. Los dos pueden convivir en el mismo servicio. En el artículo sobre Liquid AI d1 expliqué un caso concreto, con sus límites de entrada y sus requisitos para ejecutarlo localmente.
Clasificar y puntuar son tareas habituales del aprendizaje automático desde hace tiempo. Lo interesante ahora es cómo se están combinando la comprensión del lenguaje, las instrucciones de cada tarea y las respuestas acotadas en servicios reutilizables. Para quien desarrolla el sistema, eso podría reducir las reglas sueltas que debe mantener y el texto que hay que generar para una simple asignación.
Varias empresas están apostando por estas pequeñas decisiones
El 9 de octubre de 2026, TypeSafe anunció una ronda de 870 millones de dólares, con una valoración de 7500 millones, liderada por a16z. Su primer modelo, Jev, devuelve resultados estructurados a partir del material y las preguntas que recibe. La cifra ha dado visibilidad a los modelos de decisión. A mí me interesa qué funciones de uso cotidiano pueden salir de esa inversión.
Microsoft también ha presentado Microsoft-Decision-1, orientado a responder preguntas de sí o no, escoger opciones y asignar puntuaciones. Según Microsoft, Xbox Research lo utilizó para clasificar más de 10 000 comentarios y reseñas. Es una función fácil de entender: ordenar muchas opiniones para que una persona encuentre antes lo que merece revisar.
Cloudflare actualizó la familia Clef el 9 de octubre. Añadió la entrada de imágenes, audio y vídeo con Clef-omni y redujo el precio de Clef-flash. Los productos tienen diferencias, pero todos buscan un lugar en las decisiones que un programa repite a menudo. Es posible que quien utilice el servicio nunca llegue a ver el nombre del modelo.
Un coste menor puede hacer viables algunas mejoras pequeñas
Las tarifas resultan más claras al expresarlas en la misma unidad. A 10 de octubre de 2026, Jev y Microsoft-Decision-1 anuncian un precio de entrada de 0,042 dólares por millón de tokens. Clef-flash cuesta 0,038 dólares. Los tokens son las unidades con las que se mide la entrada del modelo; las capacidades, los límites de contexto y la forma de dividir el texto siguen siendo distintos.
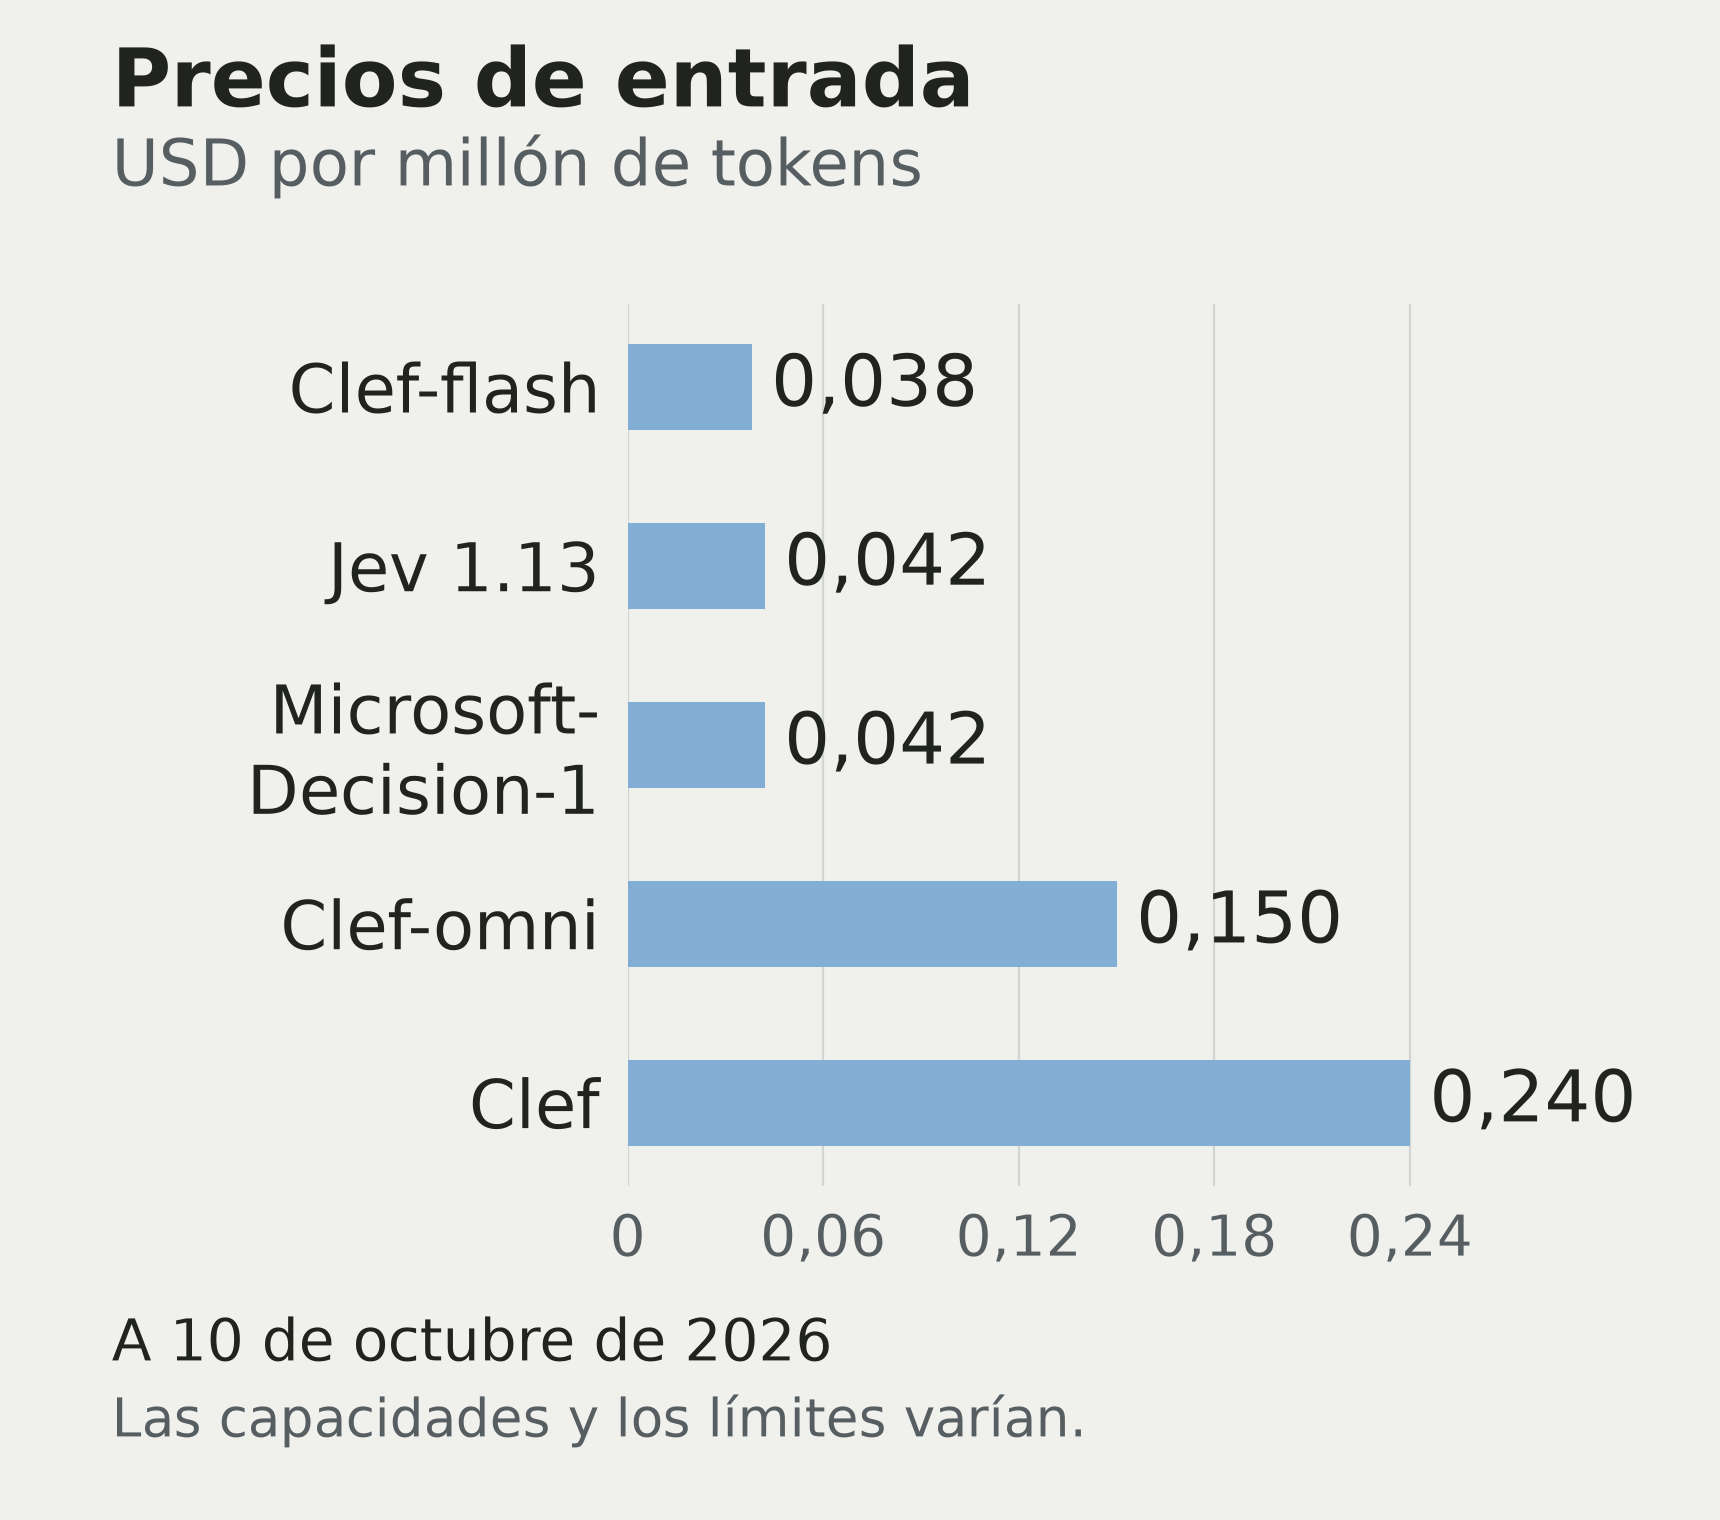
Veamos un cálculo hipotético. Si cada decisión utiliza 500 tokens de entrada en total, incluidas las instrucciones y las opciones de respuesta, un millón de llamadas sumaría 500 millones de tokens. A la tarifa de 0,042 dólares, la entrada costaría 21 dólares. Jev y el modelo de Microsoft no cobran por la salida. Ese importe corresponde a un solo paso; consultar pedidos, continuar la conversación y dedicar tiempo de personal tiene otros costes.
En el artículo sobre DeepSeek y Huawei comenté la distancia entre abaratar una API y que el usuario note el ahorro. En este caso, me gustaría que el menor coste permitiera dedicar atención a mejoras modestas: detectar antes que falta un dato o enviar la consulta al equipo adecuado antes de que alguien espere en la cola equivocada.
También hay concesiones. Cloudflare redujo la ventana de contexto de la versión alojada de Clef-flash de 64k a 24k tokens al bajar el precio. Puede bastar para una consulta breve, mientras que una conversación extensa podría necesitar otra solución. La elección tiene más sentido cuando se parte del material que va a procesar el servicio.
Al cambiar de tarea, cambia el modelo que obtiene mejores resultados
La tabla de evaluación de Cloudflare muestra una diferencia útil. Jev obtiene el mejor resultado de los cuatro modelos en When2Call, mientras que Clef-omni encabeza BANKING77. When2Call evalúa decisiones sobre cuándo usar herramientas; BANKING77 trata la clasificación de intenciones en consultas bancarias. La gráfica recoge esas dos tareas para mostrar el contraste.
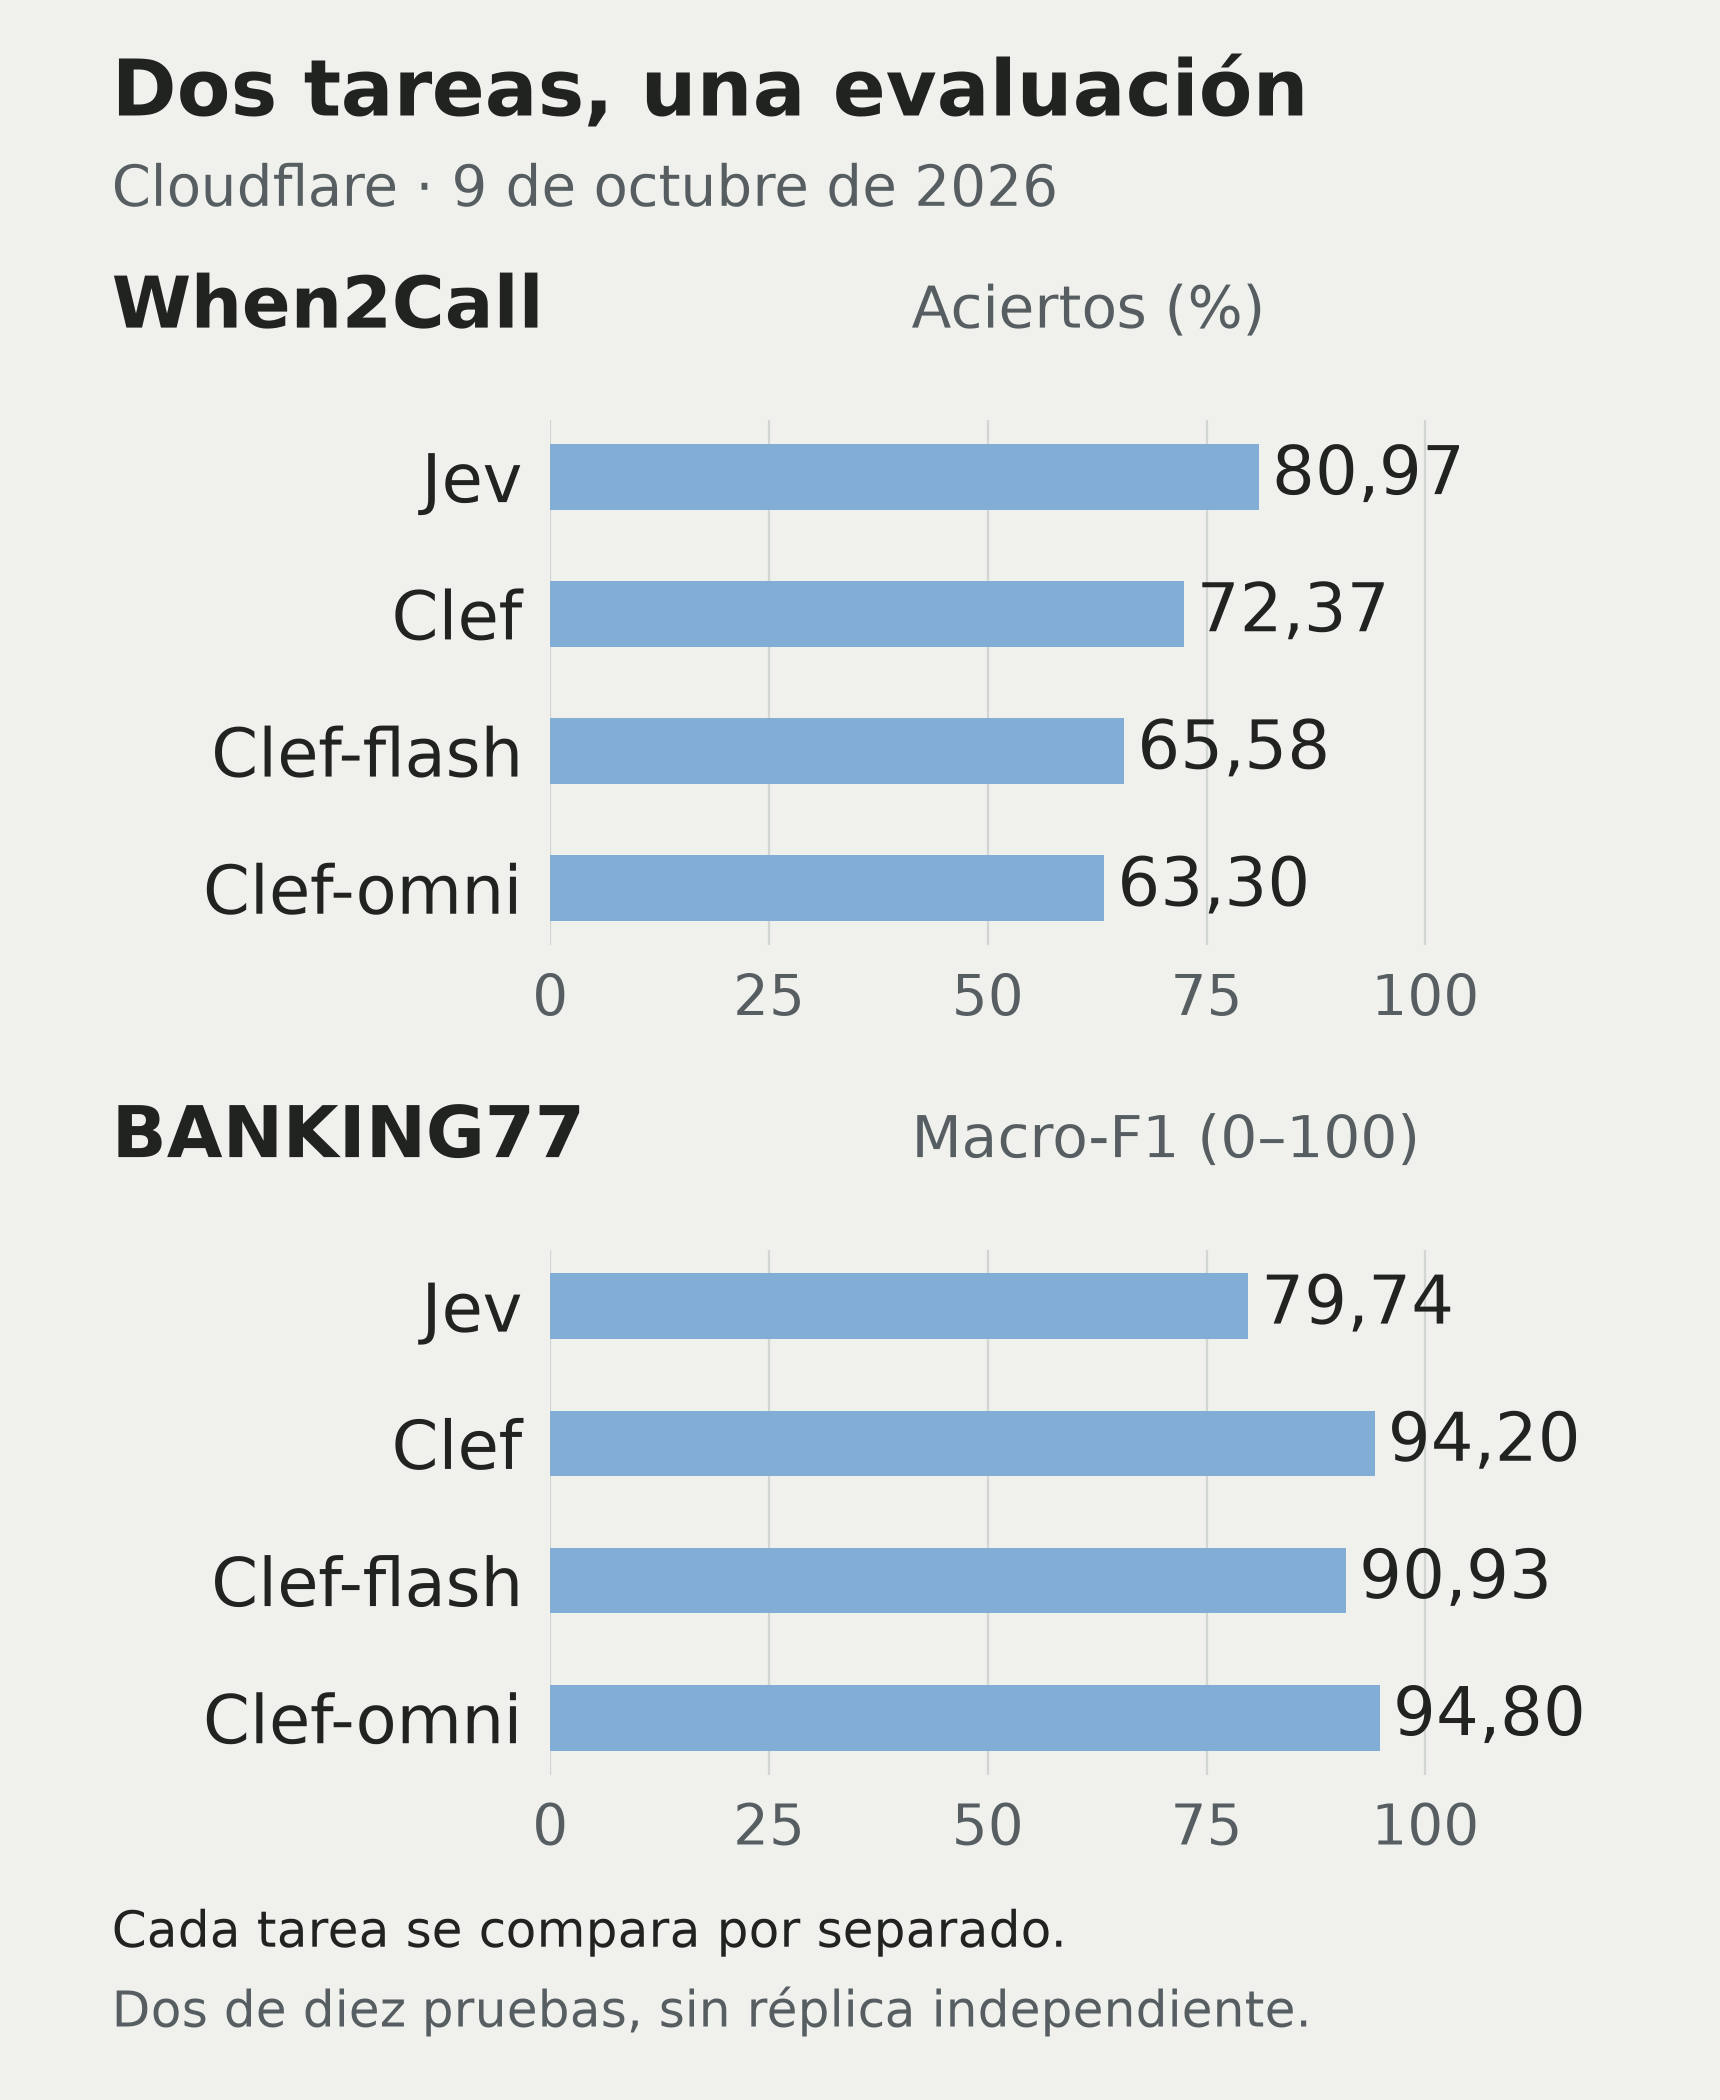
Los resultados los publicó Cloudflare y no los he reproducido de forma independiente. Además, cada prueba usa una métrica distinta, por lo que la comparación corresponde a cada panel. Un modelo que clasifica bien las consultas puede tener otro rendimiento al decidir si procede usar una herramienta. Incluso dentro del mismo servicio, cada paso puede encajar mejor con un modelo diferente.
Para un servicio en español, el idioma merece su propia comprobación. La documentación de TypeSafe indica que Jev funciona mejor actualmente en inglés. Las abreviaturas, las faltas de ortografía, las distintas formas de nombrar un problema y los mensajes que mezclan idiomas pueden influir en el resultado. Un pequeño conjunto de casos conocidos por el equipo daría una referencia más cercana que asumir que la clasificación general se trasladará sin cambios.
El límite que quería entender cuando pensaba en usar IA
Al volver a aquella idea para mi trabajo, un reembolso me ayuda a explicar el límite. Detectar que alguien pide una devolución, comprobar si cumple las condiciones y ejecutar el pago son pasos distintos. El modelo puede ayudar a reconocer la solicitud; el servicio necesita definir qué acciones tiene permitido realizar después.
Que una respuesta esté entre las opciones admitidas tampoco garantiza que sea la adecuada. El modelo podría enviar un caso a logística cuando el cliente ya ha hablado con el transportista y necesita que lo atienda la tienda. Entender ese antecedente puede ser más útil que devolver la misma categoría con mayor rapidez.
Hay esperas que dependen de otras cosas: una conexión entre sistemas que falta, una autorización pendiente o una persona ocupada. Los modelos de decisión pueden ayudar a repartir el trabajo, pero los pasos siguientes también tienen que estar conectados. Si permiten que un compañero revise menos historial y que el cliente repita una vez menos el número de pedido, ya aportan algo concreto.
También me gustaría que pedir hablar con una persona fuera una opción fácil de respetar. Quien necesita ayuda no debería tener que esforzarse todavía más para convencer al programa. Cuando el sistema tenga dudas, transferir lo que ya sabe puede darle a quien continúa una mejor forma de empezar.
Por eso sigo interesado en los modelos de decisión. Me sigue atrayendo la idea de usar IA en atención al cliente, con límites más claros y una forma más sencilla de dar paso a otra persona. Reducir un poco las repeticiones puede dejar más paciencia a ambos lados de la conversación.
Fuentes y precios comprobados el 10 de octubre de 2026. La portada es una imagen conceptual generada con IA. Las gráficas reproducen los datos oficiales enlazados. El cálculo de costes es hipotético y los resultados de las pruebas proceden del proveedor; no he realizado una evaluación independiente mediante las API.