
DeepSeek y Huawei: ya toca una IA más barata
DeepSeek abre herramientas para los chips Ascend de Huawei. ¿Llegará el ahorro al usuario? Analizamos los resultados técnicos, las rebajas de las API y el precio de las suscripciones.
 bufferSobre el autor8 min de lectura
Lo primero que le pido a la IA es bastante poco glamuroso: que salga más barata.
El 30 de septiembre de 2026, DeepSeek anunció la apertura del código de varias herramientas de cálculo y comunicación para los chips Ascend de Huawei. Reuters recogió el anuncio y citó la explicación de DeepSeek: Huawei apoyó el desarrollo y ambas empresas trabajaron en optimizar un sistema basado en chips Ascend 950.
Las herramientas de DeepSeek y Huawei están dirigidas a equipos que ejecutan modelos en hardware compatible. Como usuario, mi pregunta es más sencilla: si el proveedor ahorra dinero, ¿puedo pagar menos?
El progreso técnico también debería notarse en lo que pagamos. Para defender esa idea, conviene distinguir tres cuentas: la eficiencia del chip, el coste de prestar el servicio y el precio que paga el cliente.
DeepSeek y Huawei: dónde se podrían reducir costes
Una frase que escribimos en una aplicación de IA se convierte en muchos cálculos dentro de un servidor. Los modelos grandes suelen necesitar varios chips, y los datos tienen que circular entre ellos. Si el cálculo o la comunicación se quedan atrás, un hardware caro puede pasar parte del tiempo esperando.
DeepGEMM-Ascend optimiza la multiplicación de matrices y otras operaciones básicas que los modelos repiten constantemente. Los desarrolladores pueden utilizar las implementaciones de esta biblioteca sin tener que escribirlas desde cero. El proyecto se desarrolla y valida actualmente sobre la familia Ascend 950.
DeepEP-Ascend se ocupa de la comunicación entre chips. Por ejemplo, un modelo puede repartir el trabajo entre módulos «expertos» alojados en distintos procesadores. Los datos deben llegar a esos módulos y los resultados deben reunirse después. Esta biblioteca busca hacer más eficientes esas transferencias.
TileLang ayuda a los ingenieros a programar las operaciones de cálculo, dejando parte de la planificación y de los detalles del hardware en manos del compilador. Ya era de código abierto en 2025. La actualización del 30 de septiembre añadió soporte nativo para Ascend 950.
Adaptar el software también cuesta dinero. Las herramientas CUDA de Nvidia incluyen compiladores, bibliotecas de cálculo y utilidades de depuración. Cambiar de hardware obliga a revisar los programas creados para ese entorno. DeepGEMM-Ascend conserva las interfaces del DeepGEMM original, lo que deja margen para reutilizar código. Que un modelo completo funcione de forma estable requiere pruebas aparte.
Las herramientas de DeepSeek y Huawei ofrecen vías para reducir el trabajo de cálculo, comunicación y adaptación. Para medir el ahorro hay que usarlas en un servicio real: con una calidad de respuesta y unos requisitos de rapidez comparables, ¿cuántos recursos consume completar un conjunto de tareas? El código abierto, por sí solo, no aporta esa cuenta de costes.
El 95 % del rendimiento máximo no fija el precio de una suscripción
Una cifra llamativa aparece en la explicación técnica de FlashMLA publicada por DeepSeek. Según el proyecto, con cargas de trabajo típicas de su modelo V4.1, una rutina de atención dispersa para Ascend alcanza el 95 % del máximo teórico del hardware probado al procesar la entrada.
La referencia es el máximo teórico de ese chip y la medición corresponde a una operación concreta. Producir una respuesta completa implica otros pasos. El proveedor también paga máquinas, electricidad y mantenimiento. El resultado merece atención, pero no indica cuánto se abarata el servicio completo.
Ni siquiera descargar el código garantiza obtener las mismas cifras. Las notas sobre el entorno de DeepEP-Ascend aclaran que sus resultados publicados utilizaron una versión de prueba del HDK facilitada a DeepSeek, con ajustes manuales adicionales. Esa configuración no se distribuye públicamente. La documentación también enumera funciones pendientes y experimentales.
Estas condiciones deben acompañar a los datos más vistosos. Los documentos no comparan el coste total del servicio manteniendo la misma calidad de respuesta y los mismos requisitos de rapidez. Predecir una rebaja a partir de un solo resultado sería sacar conclusiones demasiado pronto.
Los precios de la IA ya estaban bajando
Pedir una IA más barata no debería borrar las rebajas que ya se han producido.
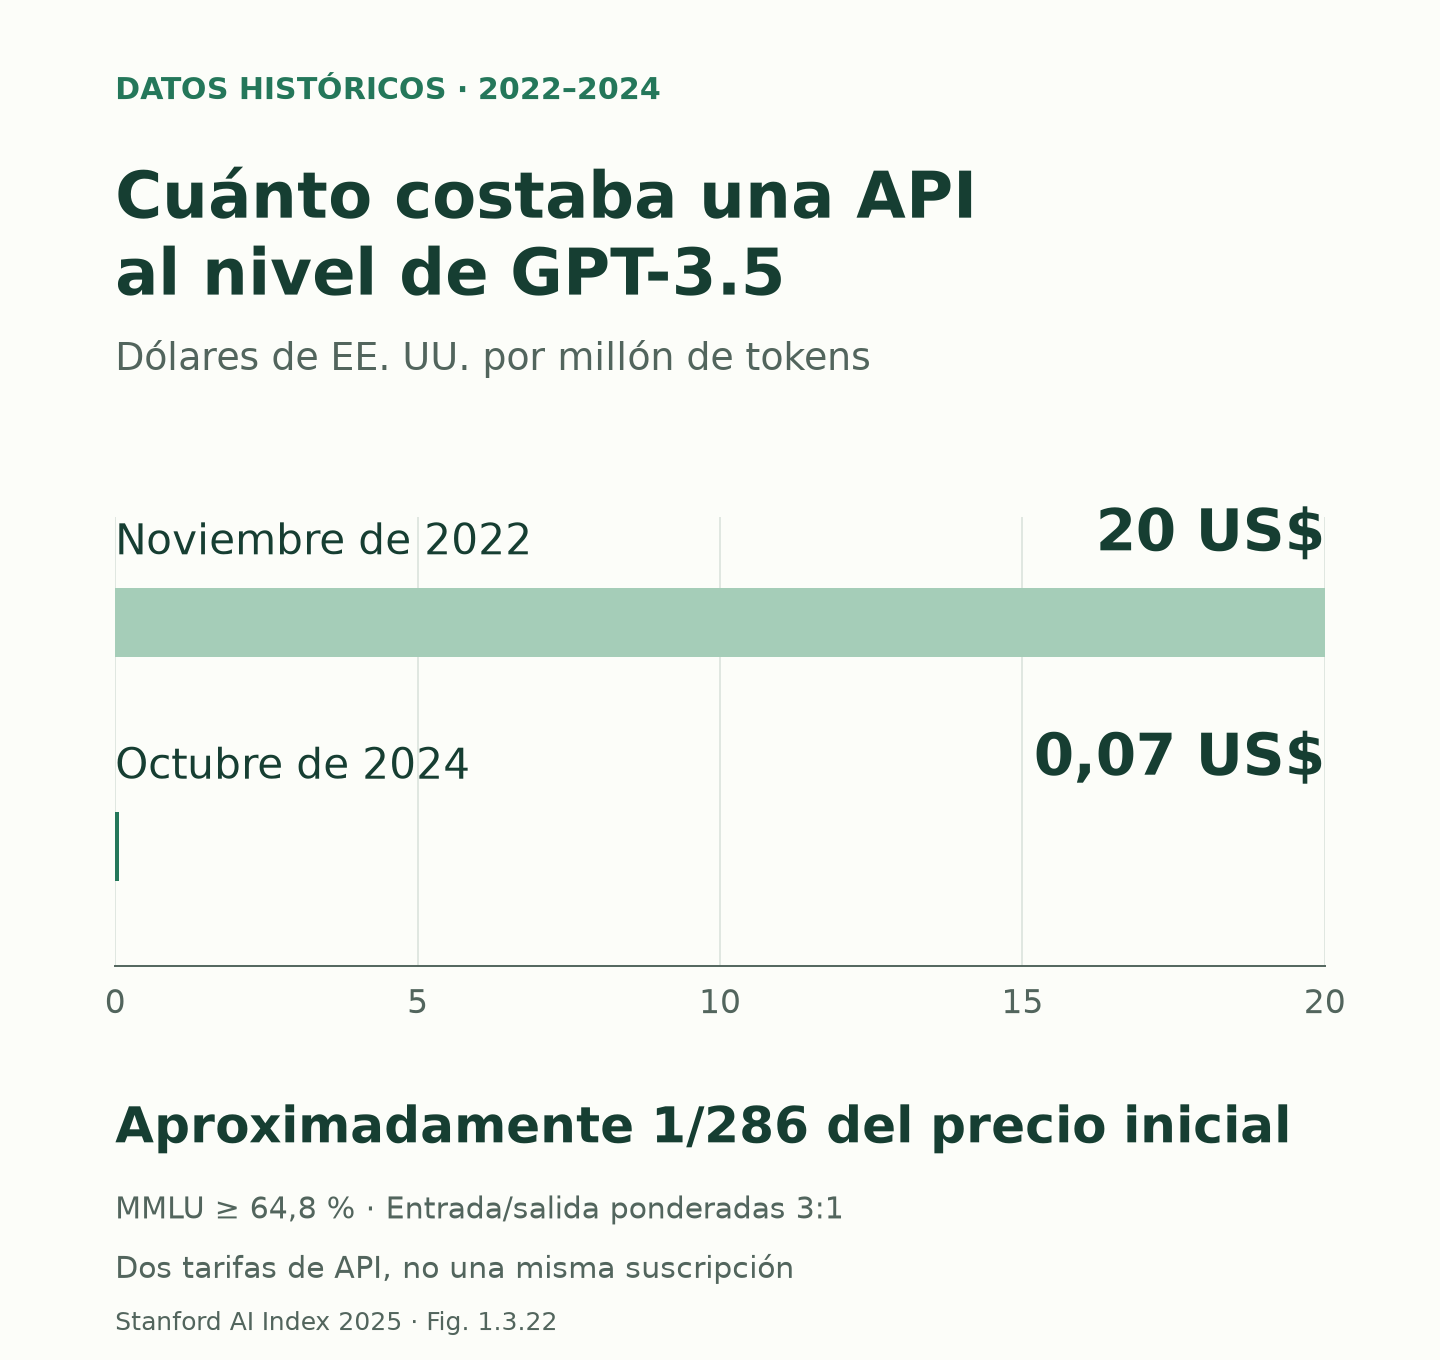
El AI Index 2025 de Stanford HAI recogió un cambio considerable: para los modelos que alcanzaban el nivel de GPT-3.5 en la prueba de conocimientos MMLU, el precio por millón de tokens pasó de 20 dólares estadounidenses en noviembre de 2022 a 0,07 dólares en octubre de 2024. Es aproximadamente 1/286 del precio inicial.
Los tokens son las unidades con las que un modelo procesa el texto; una API es la interfaz que permite a otras aplicaciones utilizar ese modelo. Las cifras comparan tarifas de API para un nivel concreto de rendimiento. El capítulo 1 del informe pondera los precios de entrada y salida en una proporción de 3 a 1. Mide cuánto se abarató acceder a esa capacidad evaluada; no describe la rebaja de una misma suscripción ni garantiza que los modelos funcionen igual de bien en todas las tareas.
Hay un ejemplo más reciente en el registro de cambios de DeepSeek del 10 de septiembre: con el lanzamiento de V4.1 Flash, la empresa anunció una reducción de las tarifas de su API. Fue antes del anuncio de código abierto del día 30. La documentación disponible no establece cuánto influyeron estas herramientas en los costes, así que no podemos atribuir sin más aquella rebaja al anuncio de DeepSeek y Huawei.
La competencia en precios ya existe. La siguiente pregunta es si el usuario corriente puede comprar esas capacidades, cada vez más asequibles, en un producto que encaje con lo que necesita.
Por qué una API más barata no siempre abarata la suscripción
Los desarrolladores suelen pagar por el uso de la API. En la tabla de precios de DeepSeek, la factura depende de la entrada, la salida, los aciertos de caché y el horario. Una suscripción a una aplicación de IA puede incluir acceso al modelo, procesamiento de documentos, almacenamiento y otras funciones. Son productos con formas de cobro distintas.
Veámoslo con una cuenta hipotética: operar un servicio cuesta 100 euros, de los cuales 30 corresponden a llamadas al modelo. Si estas pasan a costar la mitad y el resto no cambia, el total baja a 85 euros. Una partida se ha abaratado un 50 %; el coste total ha bajado un 15 %. Son cantidades inventadas para explicar el cálculo, no las cuentas de ninguna empresa.
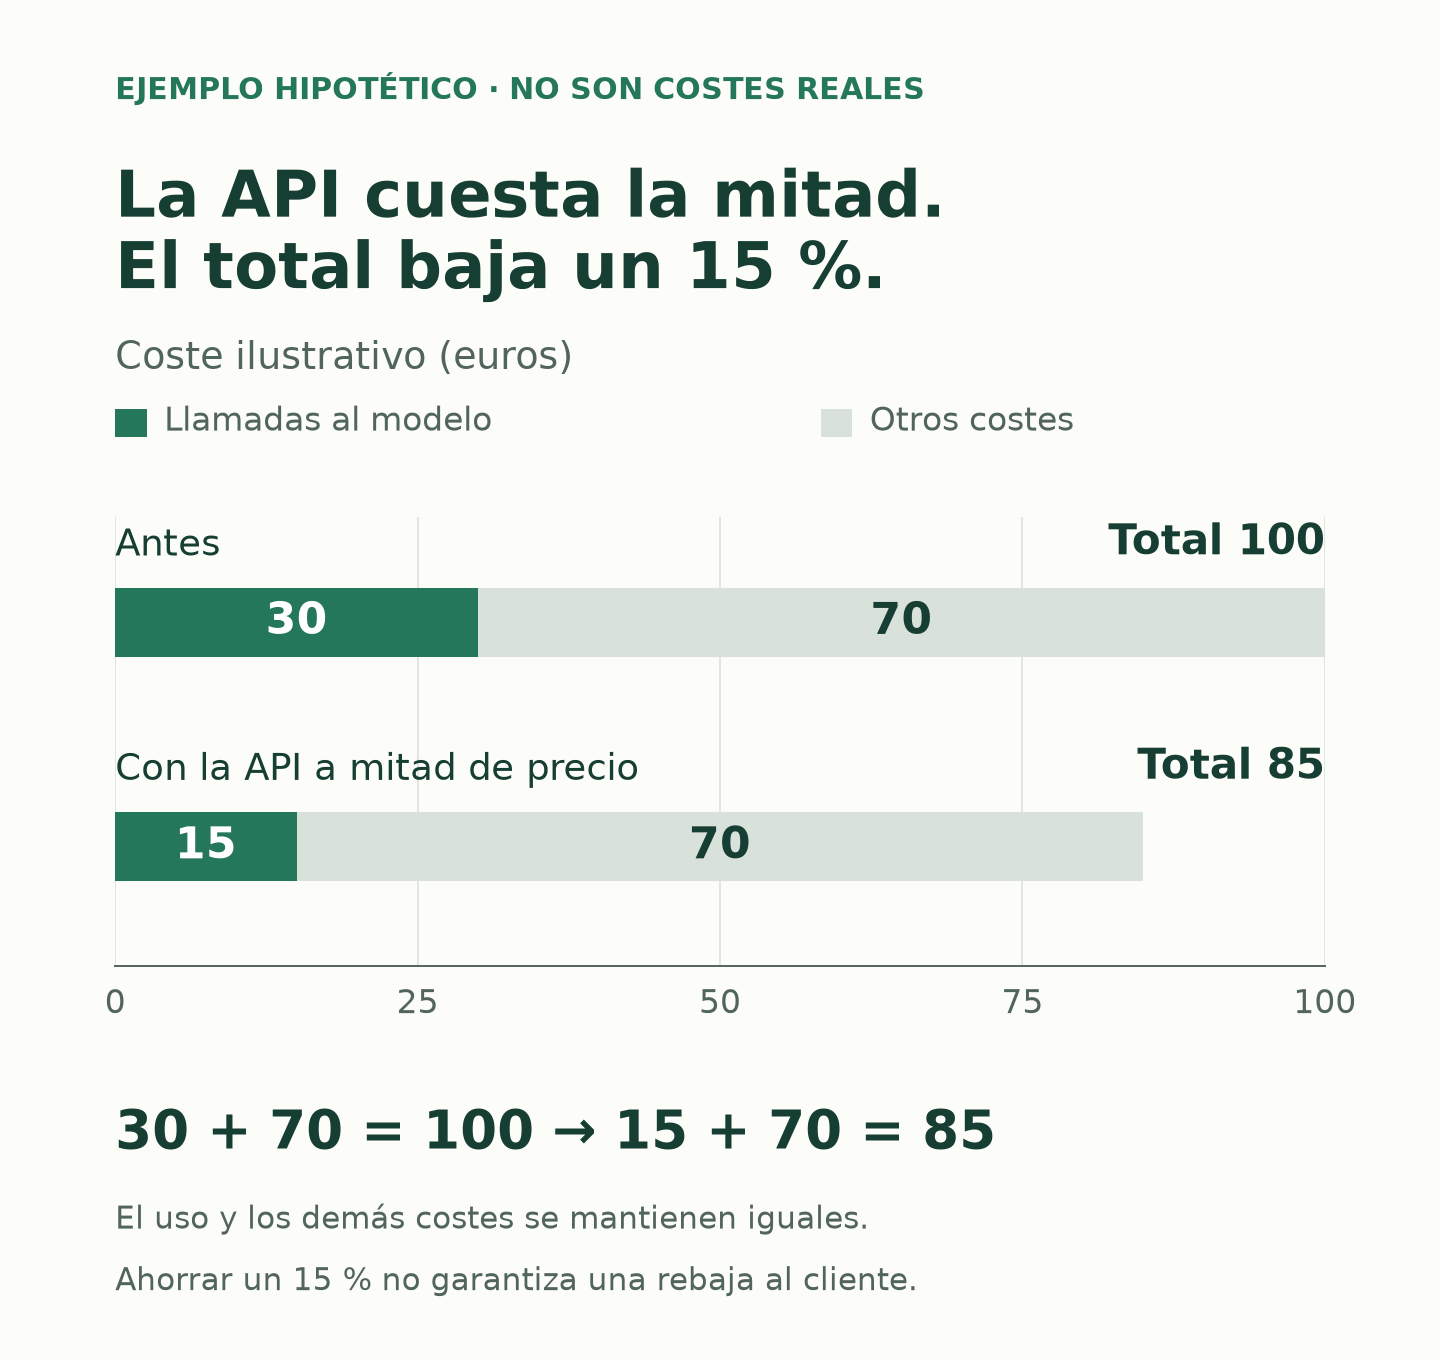
Después viene la decisión sobre el precio. La empresa puede reducir la cuota, ampliar los límites de uso, invertir en funciones nuevas o conservar más margen. Sin sus datos de costes y condiciones del plan, una cuota idéntica no demuestra que se haya quedado con todo el ahorro. Del mismo modo, decir que «el modelo es más inteligente» no prueba que el usuario obtenga más valor por su dinero en sus tareas habituales.
Lo que espero de DeepSeek y Huawei es que estas herramientas faciliten ofrecer servicios a precios más competitivos sobre Ascend. Cuando el usuario puede cambiar a un producto de calidad comparable y menor precio, los demás proveedores sienten una presión más directa para ajustar sus tarifas.
Es una expectativa sobre la competencia futura, que habrá que contrastar con productos y precios reales. El anuncio de DeepSeek y Huawei tampoco permite deducir cuánto cobrarán las plataformas que no utilicen estas herramientas.
Una IA más capaz puede justificar un precio mayor. Una IA que ya resuelve lo que necesito también debería tener opciones asequibles. Quien solo quiere revisar unos correos u organizar documentos no debería acabar escuchando siempre los resultados de la última prueba del modelo más avanzado cuando pregunta por el precio.
| Cifra y fuente | Cómo interpretarla |
|---|---|
| FlashMLA: 95 % del máximo teórico Dato publicado por el proyecto | Una operación se acerca al máximo teórico del chip probado. No mide el ahorro del servicio completo ni una rebaja de la suscripción. |
| AI Index: 20 → 0,07 dólares Por millón de tokens, nov. 2022 → oct. 2024 | La tarifa de API bajó para un mismo nivel en MMLU. Compara modelos distintos, no una misma suscripción, y es anterior al anuncio sobre Ascend. |
| Costes del ejemplo: 100 → 85 euros Cálculo hipotético | Si las llamadas son el 30 % del coste y pasan a la mitad, el total baja un 15 %, manteniendo el resto igual. No son cuentas empresariales ni una previsión de precios. |
Cuánto cuesta terminar una tarea de verdad
Para el consumidor, la comparación útil es cuánto paga por completar la misma tarea.
Pensemos en un documento largo. ¿El plan permite procesar tanto texto o hay que comprar uso adicional? Si el resultado exige repetir el trabajo, ¿se vuelve a cobrar? El gasto real del mes, más el tiempo dedicado a comprobar y corregir la respuesta, se acerca más al coste efectivo que una tarifa anunciada «desde» cierta cantidad por llamada. Esa era también mi preocupación al hablar de Claude Mods: cuánto trabajo queda en manos de la persona después de la entrega.
Completar más tareas con una calidad aceptable por la misma cuota también beneficia al usuario. Pero los límites, los cargos por exceso de uso y las funciones de pago adicional deberían estar claros antes de contratar. Mostrar solo la cifra más baja obliga a descubrir las condiciones a mitad de una tarea.
La próxima vez que un anuncio prometa un gran salto de eficiencia, iré primero a la página de precios.
Fuentes comprobadas el 6 de octubre de 2026. La información del anuncio procede de Reuters y de la documentación de los proyectos; la evolución histórica de precios, del AI Index de Stanford. Reuters recogió declaraciones de la empresa y no realizó pruebas independientes del hardware. No he probado hardware Ascend: las cifras de rendimiento son las publicadas por el proyecto. El ejemplo de costes es hipotético y el análisis de precios al consumidor corresponde al autor.