
DeepSeek × 华为:AI 该卷价格了
DeepSeek 与华为开源昇腾工具,能让普通用户少花钱吗?从项目性能数据、斯坦福的历史价格研究和 DeepSeek 已公布的降价,分清技术进步与消费者账单之间的距离。
 buffer关于作者约 7 分钟阅读
我对 AI 的一个期待很俗:便宜点。
2026 年 9 月 30 日,DeepSeek 宣布为华为昇腾开源计算、通信等底层工具。路透社当天的报道引述 DeepSeek 的公告称,华为参与支持了开发,双方也共同优化了基于昇腾 950 芯片的系统。
这批工具直接服务的是在兼容昇腾硬件上部署模型的团队。到了普通用户这里,我最关心的问题很简单:如果服务商省下了钱,我能不能少付一点?
技术进步的收益,也该出现在我们的账单上。不过,要提出这个要求,得先把芯片效率、服务成本和产品售价这三笔账算清楚。
DeepSeek 这次开源,省的是哪笔钱
我们发给 AI 的一句话,到了服务器里,会变成大量计算。大型模型往往需要多块芯片协作,数据还得在它们之间来回传。计算和传输只要有一头跟不上,昂贵的硬件就可能花时间等待。
DeepGEMM-Ascend优化的是矩阵乘法等基础运算。这类计算会在模型里反复执行,开发者可以直接调用这个库里的实现。项目目前基于昇腾 950 系列开发与验证。
DeepEP-Ascend处理芯片之间的通信。例如,模型把任务分给不同的“专家”模块,模块分布在多块芯片上,就需要把数据送过去,再把结果汇总回来。这个库的工作,是让这些传输更高效。
TileLang则帮助工程师编写底层计算程序,由编译工具处理一部分调度和硬件细节。它在 2025 年就已开源,9 月 30 日的更新新增了对昇腾 950 的原生支持。
软件适配也是一笔开销。英伟达的 CUDA 工具链包含编译器、计算库和调试工具;换硬件时,围绕原平台写好的程序需要重新检查。DeepGEMM-Ascend 沿用原版 DeepGEMM 的接口,给复用现有代码留出了空间。完整模型能否稳定运行,还得单独测试。
这些工具提供了降低计算、通信和适配开销的办法。真正能省多少,要把它们放进业务里测:相同质量的回答、相同的响应要求,完成一批任务总共用了多少资源?开源代码本身还给不出这张成本表。
95% 的峰值性能,算不出会员该降多少钱
一个容易吸引眼球的数字来自 DeepSeek 的 FlashMLA 技术说明:按项目方披露,在其 V4.1 模型的典型工作负载下,昇腾稀疏注意力算子在处理输入时,达到了被测硬件理论峰值的 95%。
这里的分母是芯片自己的理论峰值,测量对象是特定计算环节。一次完整回答还包含其他步骤,服务商还要支付机器、电力和运维费用。这个数字足以让人关注这项优化,但推不出整套服务便宜了几成。
甚至“下载代码,就能跑出同样成绩”也要打个问号。另一项工具 DeepEP-Ascend 的环境说明写明,公开性能数据使用了提供给 DeepSeek 的概念验证版 HDK,以及额外的手动配置;这一配置并非公开发行版本。文档也列出了尚未实现和仍处于实验阶段的功能。
这些部署条件,需要和亮眼数字一起看。以上资料没有给出在相同回答质量和响应要求下,整套服务能省多少钱的对照。只拿其中一个性能数字预测降价,账就算得太早了。
先承认一件事:AI 已经在降价
喊“AI 该卷价格了”,不能把已经发生的降价抹掉。
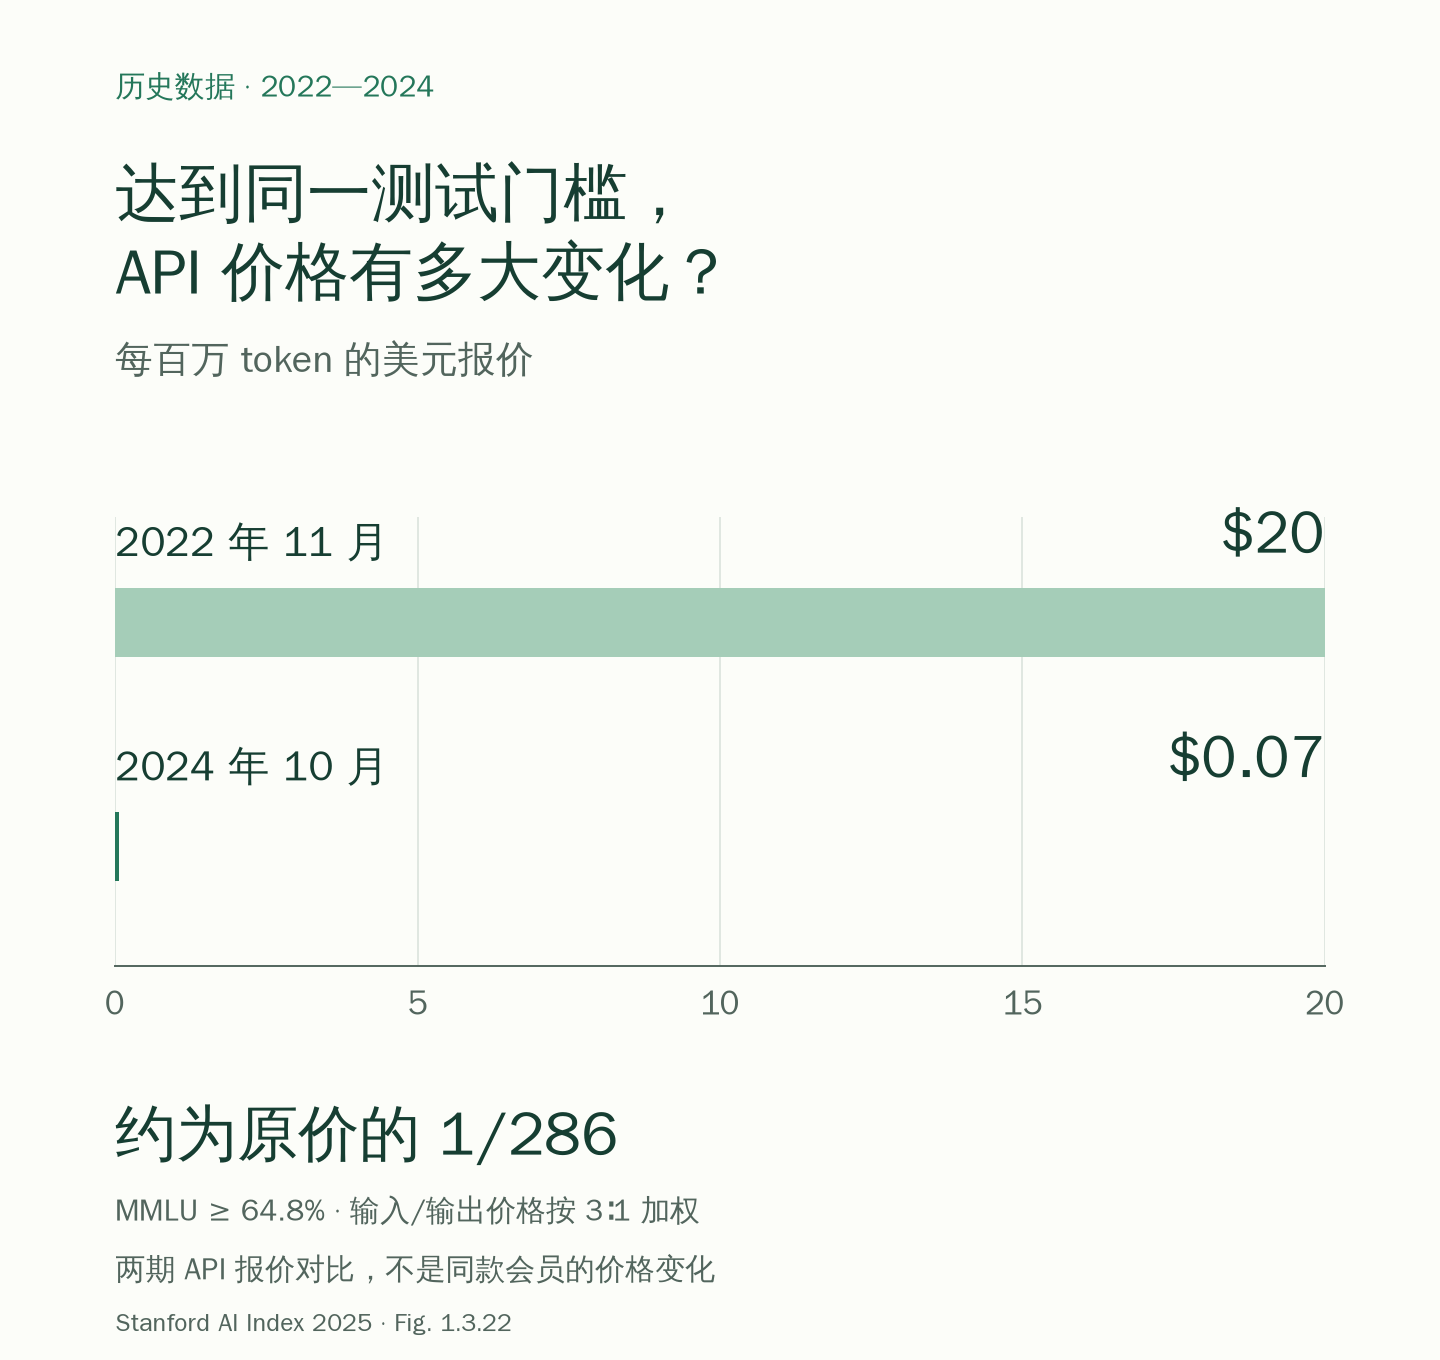
斯坦福 HAI 的 《2025 AI Index》记录过一个很大的变化:达到 GPT-3.5 在 MMLU 知识测试中成绩门槛的模型,调用价格从 2022 年 11 月的每百万 token 20 美元,降到了 2024 年 10 月的 0.07 美元,约为原来的 1/286。
token 是模型处理文本的计量单位,API 则是供其他应用调用模型的接口。上面的数字比较的是达到同一测试门槛的 API 报价,报告第 1 章对输入、输出价格按 3∶1 加权。它衡量的是特定能力变得多便宜,不能当成同一款会员的降价幅度,也不能保证这些模型在所有任务上都一样好用。
更近的例子就在 DeepSeek 自己的 9 月 10 日更新日志里:随着 V4.1 Flash 发布,官方宣布下调 API 价格。这比 9 月 30 日的开源公告还早。现有资料没有披露两者的成本因果关系,不能直接把这轮降价记成此次开源的成绩。
所以,价格竞争早就在发生。接下来该追问的是:已经变便宜的能力,普通人能不能以合适的价格买到?
便宜的 API,为什么未必变成便宜的会员
开发者买 API,通常按用量付费。以 DeepSeek 的价表为例,输入、输出、缓存命中与使用时段都会影响费用。普通用户买一个 AI 应用的会员,买到的则可能是模型调用、文件处理、存储和其他功能组成的套餐。两者的收费单位不同。
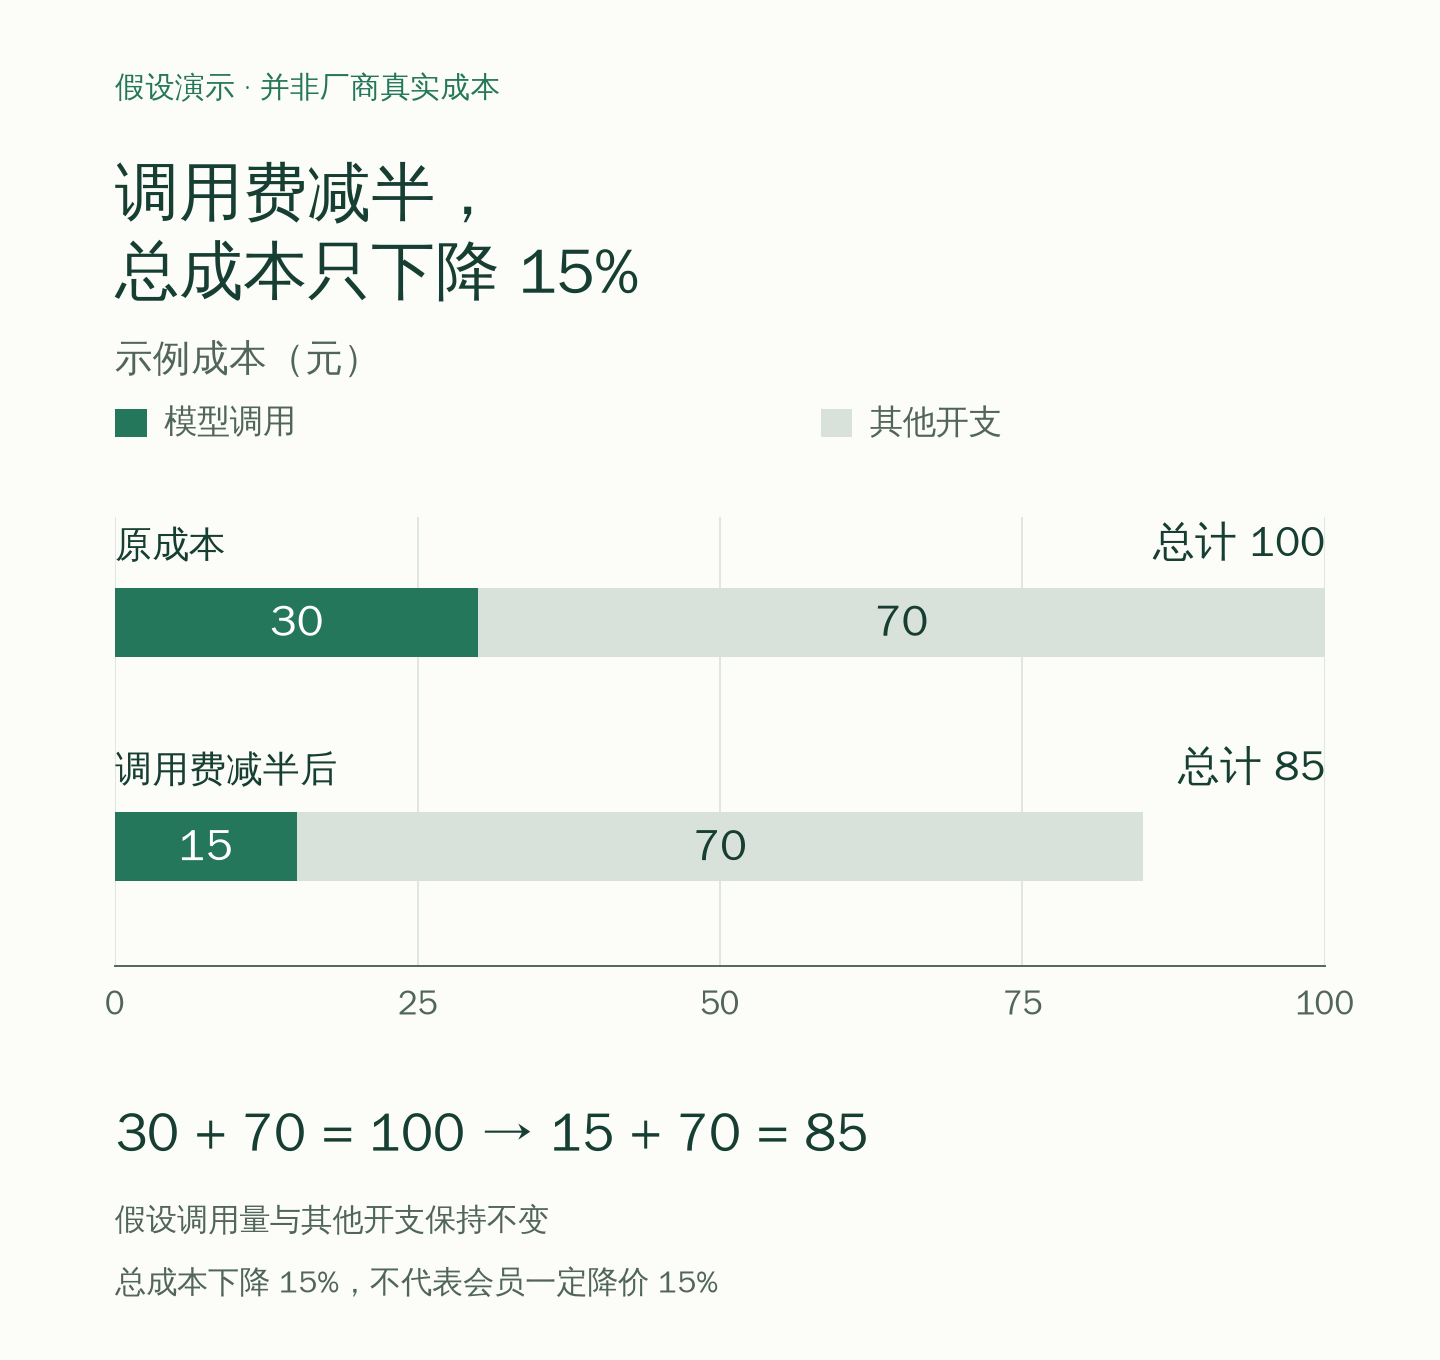
用一笔假设账就能看出差别:某项服务原来总成本 100 元,其中模型调用占 30 元;如果调用费用减半,其他开支不变,总成本是 85 元。便宜了一半的只是那一项,总成本下降了 15%。这里的数字仅用于解释计算关系,并非任何厂商的真实成本。
再往后才是定价。经营者可以降月费,也可以增加额度、投入新功能,或保留利润。没有它的成本和套餐数据,不能仅凭月费没变,就断言降本全被它吞了。反过来,厂商只说“模型更强”,也不足以证明老用户为日常任务花的钱更值。
我对这次开源的期待,是它能让采用昇腾的团队更容易做出价格有竞争力的服务。当用户可以换到质量相近、费用更低的产品时,其他经营者才会承受更直接的定价压力。这是对后续竞争的判断,还需要实际产品和报价来检验;未采用这套工具的平台,其收费也不能由这次发布直接推断。
“更聪明”值得卖钱,“已经够用”也该有便宜的选项。只想改几封邮件、整理几份资料的人,不该每次谈性价比,都被带去看最新旗舰模型的跑分。
| 数字与来源 | 应该怎样理解 |
|---|---|
| FlashMLA:理论峰值的 95% 项目方披露 | 特定计算环节接近被测芯片的理论峰值。 不能直接换算成整套服务或会员的降价幅度。 |
| AI Index:20→0.07 美元 每百万 token 2022.11 → 2024.10 | 达到同一 MMLU 门槛的 API 报价下降。 不同模型的历史比较,不是同款会员降价,也不是此次开源的成绩。 |
| 示例成本:100→85 元 本文的假设演示 | 调用费原占 30%,这一项减半,其他开支不变,总成本下降 15%。 不是厂商成本披露,也不是降价预测。 |
把降价算到一件做完的事上
对消费者,最有用的比较是:完成同样的任务,到底要花多少钱。
比如整理一份长文档,先看套餐是否允许处理这么长的内容,再看要不要额外买额度;结果不合格需要重做,重做是否继续计费。月底的实际花费,加上自己检查和修改的时间,比“每次调用低至多少”更接近真实成本。上一篇聊 Claude Mods 时,我在意的也是交付后还有多少活留给人。
同样的月费,如果能多完成一些质量合格的任务,用户也得到了实惠。但额度多少、用完后怎么收费、哪些功能另付费,应当在购买前讲清楚。不能只展示最便宜的一个数字,让人用到一半才发现条件。
下次看到“效率大幅提升”的发布稿,我会先翻到价格那一页。
资料核对日期:2026 年 10 月 6 日。新闻事实参照路透社报道及项目文档,历史价格趋势参照斯坦福 AI Index;路透社报道引用了厂商公告,并非硬件性能测评。本文未独立实测昇腾硬件,性能成绩为项目方披露,成本假设与消费者定价分析已在文中分别说明。