
Liquid AI d1:8 毫秒很快,但别只算调用费
调用费省了 76%,总账却可能更贵。Liquid AI d1 的 8 毫秒很吸引人,但小模型放在哪个环节、分错一次值多少钱,才决定这笔钱省不省得下来。文内算例均为假设。
 buffer关于作者约 6 分钟阅读
一条工单应该交给售后,还是技术支持?
如果系统只需要一个选项,让 AI 先写一段解释,再从里面抠出标签,多少有点绕。普通小模型其实也能被要求只输出标签。Liquid AI 这次想做得更直接:连生成答案文字这一步都省掉。
2026 年 10 月 7 日,Liquid AI 开放了 d1-3B 和 d1-omni-600M 的权重,称它们为决策模型。输入材料、问题和候选项,模型直接返回结构化判断及概率。官方公告里最抓眼球的数据,是 d1-3B 在 RTX 4090 上单题 8 毫秒。
我对这条路线有兴趣。很多 AI 应用的大头工作,本来就是分流、筛选和排序,没那么多话需要说。
但我想先算一笔账:把请求交给便宜的小模型以后,省下的调用费,够不够支付它分错的那几单?
Liquid AI d1,适合接哪一段工作
d1 接受自然语言定义的问题和候选答案,让输入经过一次模型计算,输出选项、分数或概率。对同一份材料,可以一次提出多个判断问题,不必把每个答案都写成句子。
“零输出 token”指的是不逐个生成回答文本。token 是模型处理文本的计量单位,输入仍然要读,图像仍然要处理,计算不会消失。
按 d1-3B 模型卡,这个版本约 31.2 亿参数,支持文本和图像;d1-omni-600M 约 5.87 亿参数,是实验版本,支持文本配图像或文本配音频。后者的音频训练主要围绕英语助手请求,片段截到 30 秒,中文语音效果需要另测。
这并不意味着传统分类器突然过时。如果需求就是识别固定格式,先写规则往往更省事;如果类别长期稳定、有足够的标注数据,专门训练的分类模型也值得比较。普通小语言模型配合限定输出格式,同样是合理的对照。
d1 比较吸引我的,是把多模态输入、可用自然语言调整的判断标准和概率输出放到了一起。但它要靠实际测试,证明这套组合在你的任务里划算。拿它和一个被要求长篇解释的大模型比,容易赢得太轻松。
8 毫秒:先看输入有多长
Liquid 披露的 d1-3B 延迟如下。单位是毫秒,均为厂商测试结果:
| 设备 | 单题 | 3.4K token 输入 | 384px 图像 |
|---|---|---|---|
| RTX 4090 | 8 | 102 | 17 |
| Jetson AGX Orin 64GB | 26 | 560 | 83 |
| Jetson Orin Nano | 50 | 1,640 | 202 |
模型卡还写了测量条件:预热后调用,GPU 使用 BF16,取 20 次运行的中位数。4090 的 8 毫秒用了编译优化,未启用时单题为 16 毫秒;新输入形状第一次运行,还可能触发额外编译。
所以 Orin Nano 的“单题 50 毫秒”和“长输入 1.64 秒”可以同时成立。接进产品,还得加上预处理、排队和后续动作。打算拿它当路由器,就别无脑塞整段聊天历史——先确定分流究竟需要哪些信息。
能力也有口径。Liquid 报告 d1-3B 在 Decision Index v0.2.1 公开部分得分 48.57,这是用官方评分器做的自评,模型卡注明并非排行榜正式提交。它更不是你家业务的通用正确率。评测说明在这里。
算一次:调用费省了 76%,为什么还可能亏
下面这组数全部是假设,用来演算,不是 d1 的报价或实测。
假设每天处理 10 万条请求,原来全部调用大模型,每条 0.05 元,合计 5,000 元。现在先经过本地小模型,把设备、运行等基础成本按处理量摊成每条 0.002 元;其中 20% 再升级给大模型。
这样,基础处理费就是:10 万 × 0.002 + 2 万 × 0.05 = 1,200 元,比原来少 3,800 元,节省 76%。
先别急着庆祝。剩下自动放行的 8 万条里,如果相对原流程新增了 0.2% 的错分,就是每天多出 160 个错误。假设每个错误要额外花 15 元处理,纠错再加 2,400 元。总费用变成 3,600 元,仍然便宜,但只省了 28%。
新增错分率如果是 0.5%,就多出 400 个错误,纠错需要 6,000 元。加上基础处理费,一天花 7,200 元,比原来还贵 2,200 元。
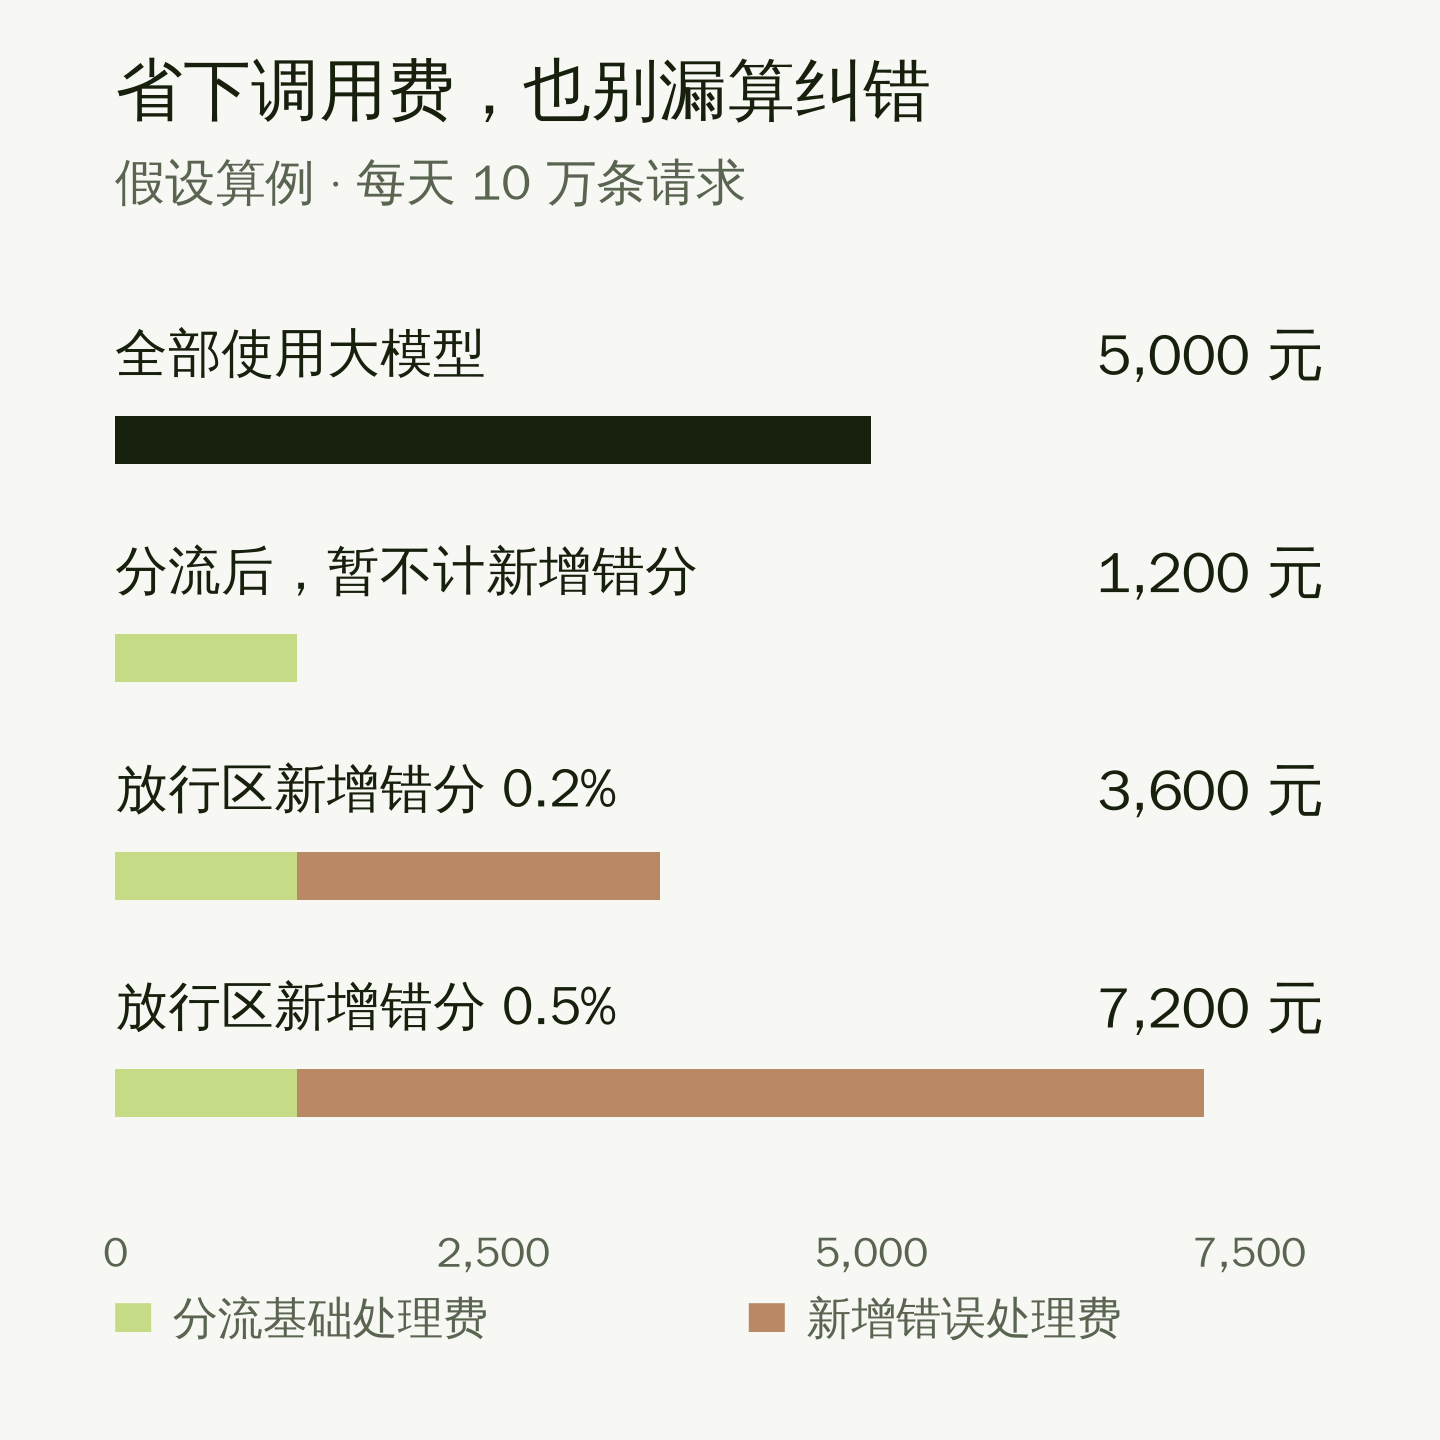
在这组假设下,自动放行部分的新增错分率只要超过约 0.32%,就会吃掉全部节省。这里算的是引入分流后多出来的错误,原流程本来就有的错误不重复记账;不同错误的实际代价也可能差得很远。
这个算例想提醒我的,是选任务的顺序。资料标签分错了,改回来就行;退款对象弄错、重要请求被丢弃,补救成本完全不同。同一个小模型,放在哪个位置,经济账可能天差地别。
最容易漏掉的,是它很自信地分错了
给低置信度请求安排升级通道,是自然的做法。可这道网,只能捞到模型自己觉得没把握的情况。
假设它把一条账户盗用投诉,以 97% 的把握分进普通售后。阈值设在 90%,这条请求就直接过去了。阈值设得更精细,也不能自动解决“模型根本没意识到自己分错”这件事。
因此我会抽查已经被自动放行的高置信度请求,而且要留一份随机样本。只研究低分、疑难和已被用户投诉的案例,看到的会是经过筛选的错误,没法据此估算整个放行区的风险。少见但后果严重的类别,可以另外加大抽查量,统计时分开看。
这也涉及概率校准:报九成把握的一批判断,实际是否大约九成正确。Guo 等人在 ICML 2017 的研究讨论过模型置信度与正确率不匹配的问题。Liquid 将 d1 描述为经过校准的模型;换成自己的语言、术语和输入分布以后,仍要重新核对。
还有个便宜的检查:候选项有没有把正确答案排除在外?只给“售后”和“技术”两个选项,账户安全问题就可能被硬塞进去。我会保留“其他/转人工”,同时测试它是否真的会用这个出口。
如果是我,先让它替资料分个堆
对这个博客,我愿意先试资料分类和疑似重复内容标记。让它旁观一段时间,记录它会怎么分,再和人工结果比较;测试通过以后,接管那些错了容易补救的步骤。标题、事实判断和发布权限,暂时没必要一起交出去。
比较时,我会把规则、传统分类器、限定输出的小语言模型和 d1 放在同一批输入上,保持同样的升级策略。最后看总费用、需要人工处理的数量,以及被错误放行的请求。这样才能知道买到的是收益,还是一个很好看的毫秒数。
本地运行可以减少原始材料出站,也有利于控制延迟,前提是整条数据链路确实留在本地,硬件闲置和维护有人买单。另一个选型细节是 LFM Open License v1.0:商用条款带有年收入 1,000 万美元门槛,不能把开放权重理解成任何主体都能无条件商用。
我在之前的 AI 价格文章里关心成本能否变成用户真正享受到的便宜。d1 提供了另一条值得试的路:明确只需要判断的地方,就少生成一些用不上的文字。
不过,我会先挑那个答错一次也赔得起的环节。省钱这件事,算到最后一张账单才算数。