
Ollama 显卡要求:最低要什么卡,4 到 80GB 显存各能跑哪些模型(v0.40.16 实测)
Ollama 官方只写了支持哪些显卡,没有最低显存。这篇先讲官方要求,再按 4 到 80GB 九档显存,用模型库的下载大小列出能装什么,并附 v0.40.16 上上下文长度如何增加内存占用的实测。
 buffer关于作者约 6 分钟阅读
Ollama 显卡要求在官方文档里只有「支持哪些卡」,没有写最低显存:NVIDIA 要计算能力 5.0 以上、驱动 550 以上(5.0 到 6.2 的老卡要 570 以上);AMD 走 ROCm v7;苹果走 Metal;其余显卡可以走 Vulkan。显存多大才够,要看你要跑的模型和上下文放不放得下。所以这篇分两半:先把官方硬件要求讲清楚,再按 4、6、8、12、16、24、32、48、80 GB 九档显存,用 Ollama 模型库里的真实下载大小列出各档能装什么。我们在 Ollama v0.40.16 上还量了一件事:同一个 1.3 GB 的模型,上下文从 4096 加到 131072,ollama ps 里的内存占用从 2.0 GB 涨到 6.9 GB。资料查询日期 2026 年 11 月 10 日。
官方对显卡到底有什么要求
下面是 Ollama 官方 Hardware support 页的要点。
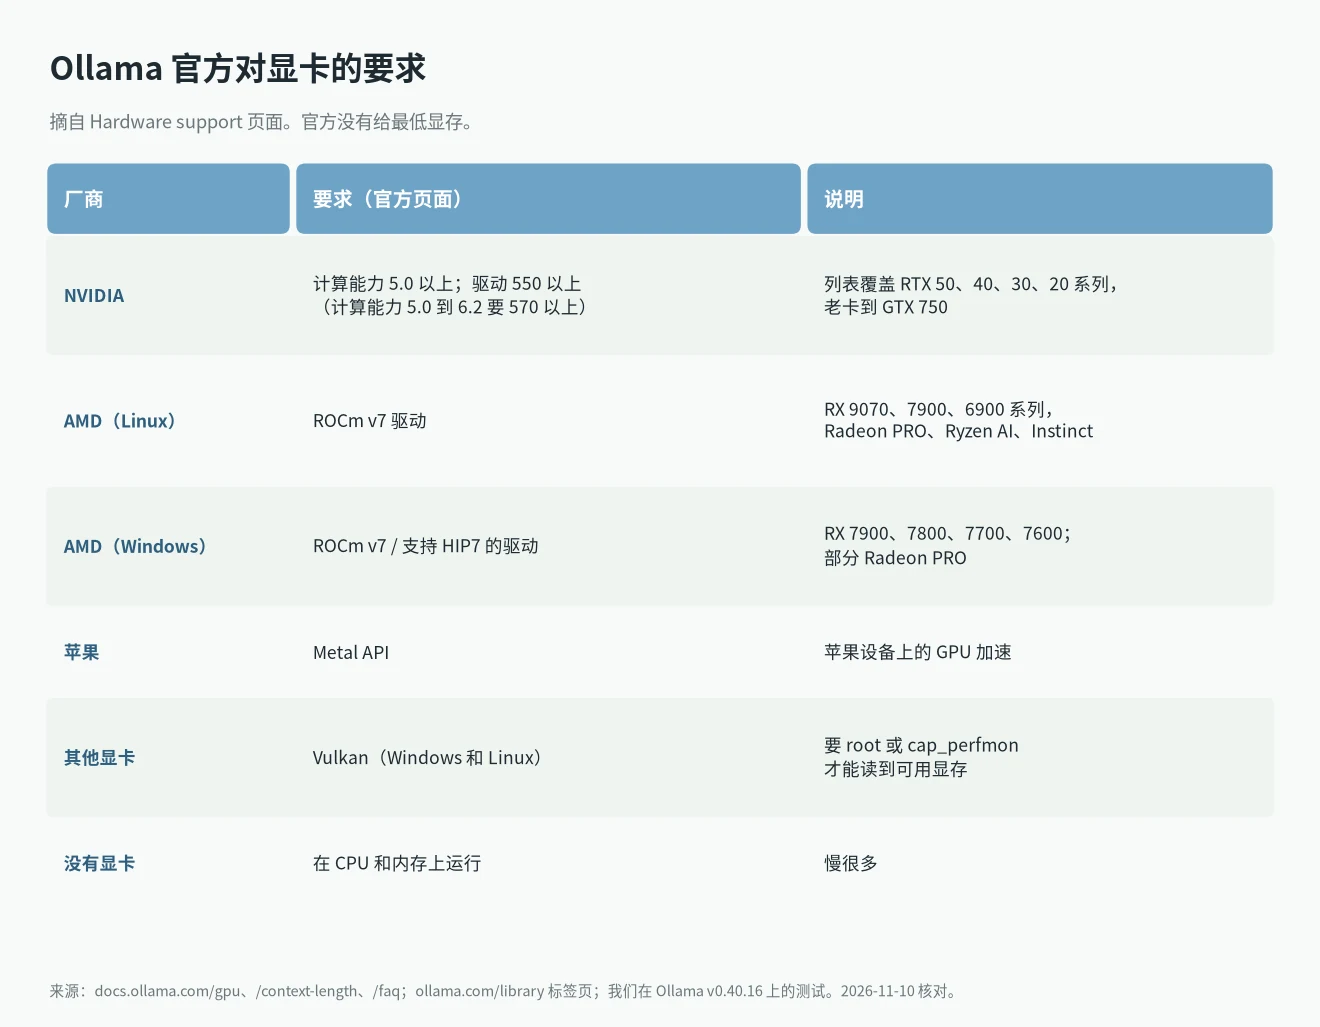
几个容易忽略的点:
- 官方没有给「最低显存」。显存不够时 Ollama 不会拒绝运行,而是把一部分放到 CPU 和内存里,速度会掉。
- 第一次装完发现没用上显卡,先按官方页检查驱动版本和计算能力。老卡(计算能力 5.0 到 6.2)需要 570 以上的驱动,很多人卡在这一条。计算能力在 NVIDIA 的 CUDA GPUs 页查。
- AMD 的 Windows 支持列表比 Linux 短,只有 RX 7900/7800/7700/7600 和部分 PRO 卡。
- Vulkan 路径要求额外能力(比如 root 或
cap_perfmon)才能读到可用显存,读不到时 Ollama 只能按模型大小估算。
按显存分档:能装什么
下面这张表里的模型大小来自 Ollama 模型库各标签页(默认量化版本,2026 年 11 月 10 日),不含上下文占用。判断标准是我们自己定的经验规则,不是官方标准:「够」表示模型文件不超过显存的 65%,「紧」表示在 65% 到 90% 之间,上下文要设短,「不够」表示超过 90%,大概率要放一部分到 CPU。
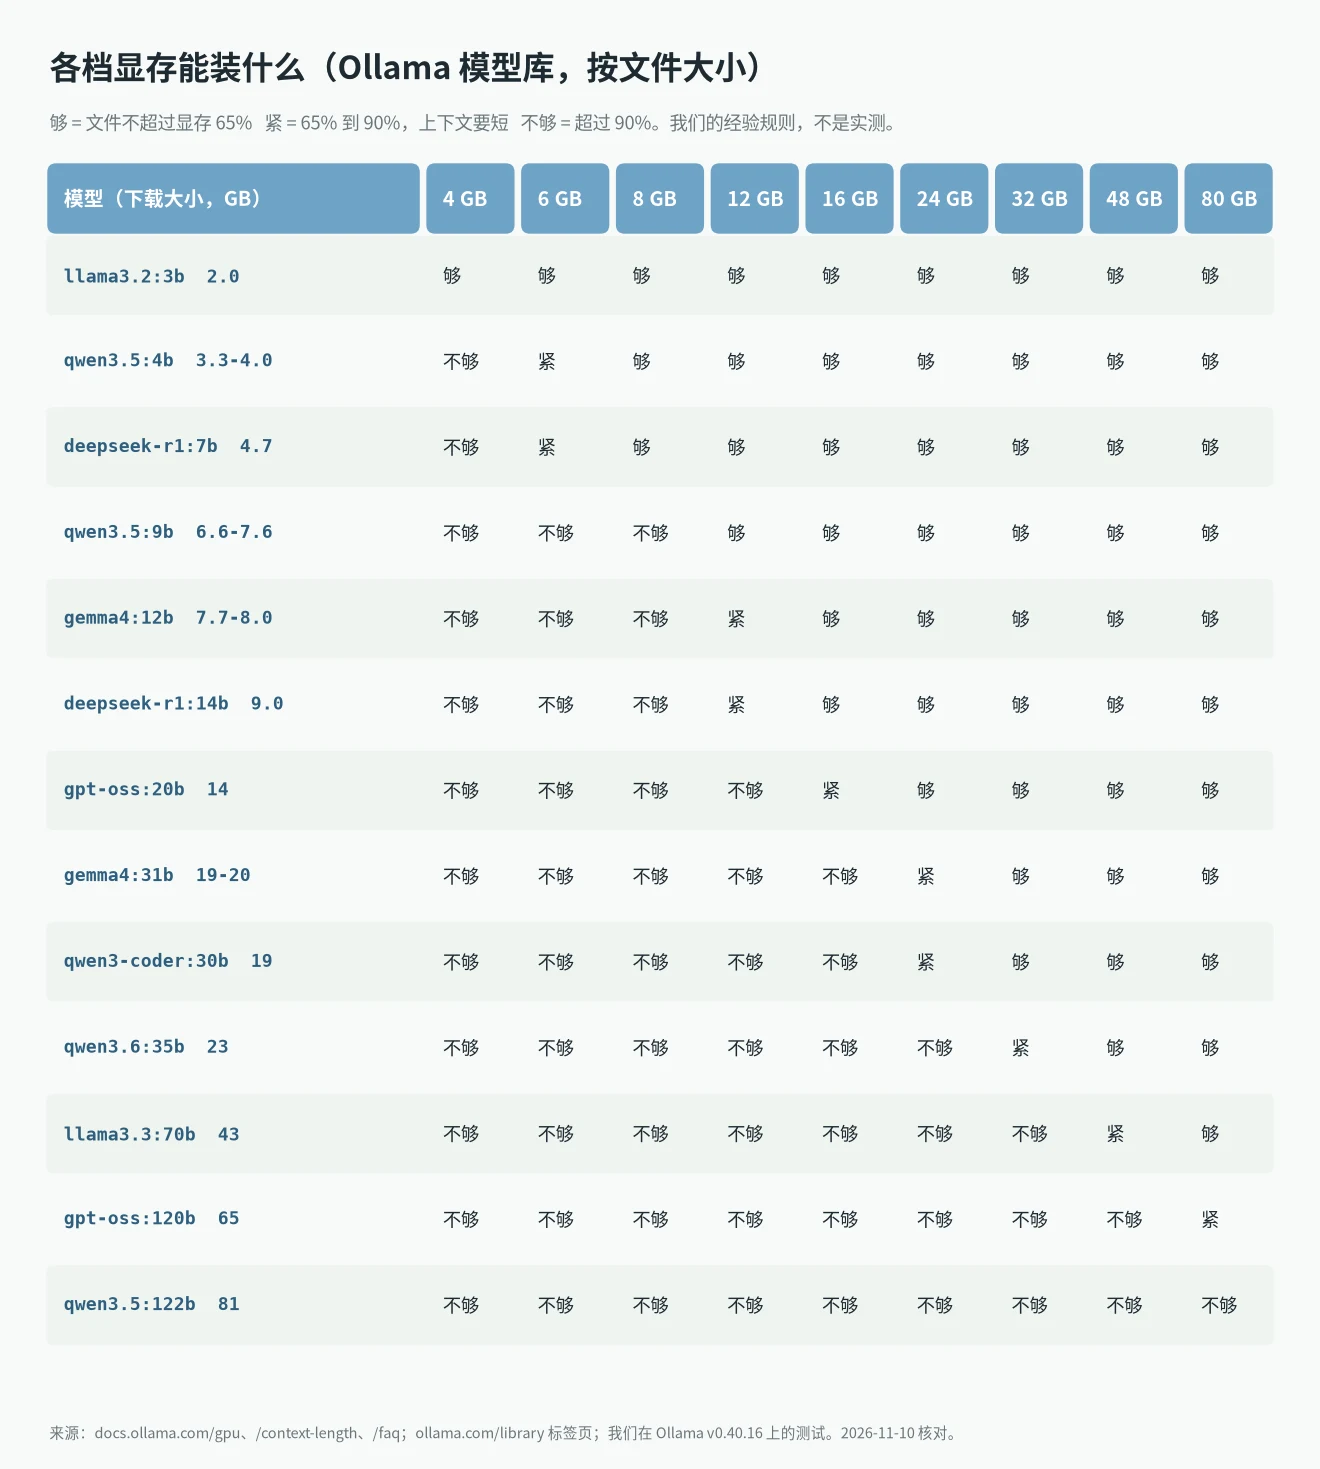
读法:
- 4 GB:跑 3B 以下的小模型,比如 llama3.2:3b(2.0 GB)。
- 6 到 8 GB:7B 到 8B 档,deepseek-r1:7b(4.7 GB)在 8 GB 上比较舒服,6 GB 上要把上下文压低。
- 12 GB:gemma4:12b(7.7 到 8.0 GB)和 deepseek-r1:14b(9.0 GB)可以装,但 14B 的余量不大。
- 16 GB:gpt-oss:20b(14 GB)能装,余量小;14B 档很宽松。
- 24 GB:27B 到 31B 一档,例如 gemma4:31b(19 到 20 GB)、qwen3-coder:30b(19 GB)、qwen3.6:27b(18 到 19 GB),都靠上下文留余量。
- 32 GB:35B 档,qwen3.6:35b(23 GB)、qwen3.5:35b(22 GB)。
- 48 GB:70B 档(llama3.3:70b、deepseek-r1:70b 都是 43 GB)刚好装下,上下文基本留不出多少。
- 80 GB:gpt-oss:120b(65 GB)可以装;qwen3.5:122b(81 GB)不行。
苹果芯片、Ryzen AI Max 这类统一内存机器的可用显存另算,这篇没有覆盖。想算精确数字,用显存计算器;想看每档推荐哪个模型,见本地大模型推荐。
上下文会吃掉多少显存
官方 Context length 页写明,Ollama 默认的上下文长度跟显存有关:低于 24 GiB 是 4k,24 到 48 GiB 是 32k,48 GiB 以上是 256k。写代码、Agent 这类任务官方建议至少设到 64000。上下文越长,需要的显存越多。
我们用 Ollama v0.40.16 在一台没有显卡的 Linux 机器上量了一遍。模型是 llama3.2:1b(模型库标 1.3 GB),每次只生成 1 个 token,只改 num_ctx,再看 ollama ps 的 SIZE 列。
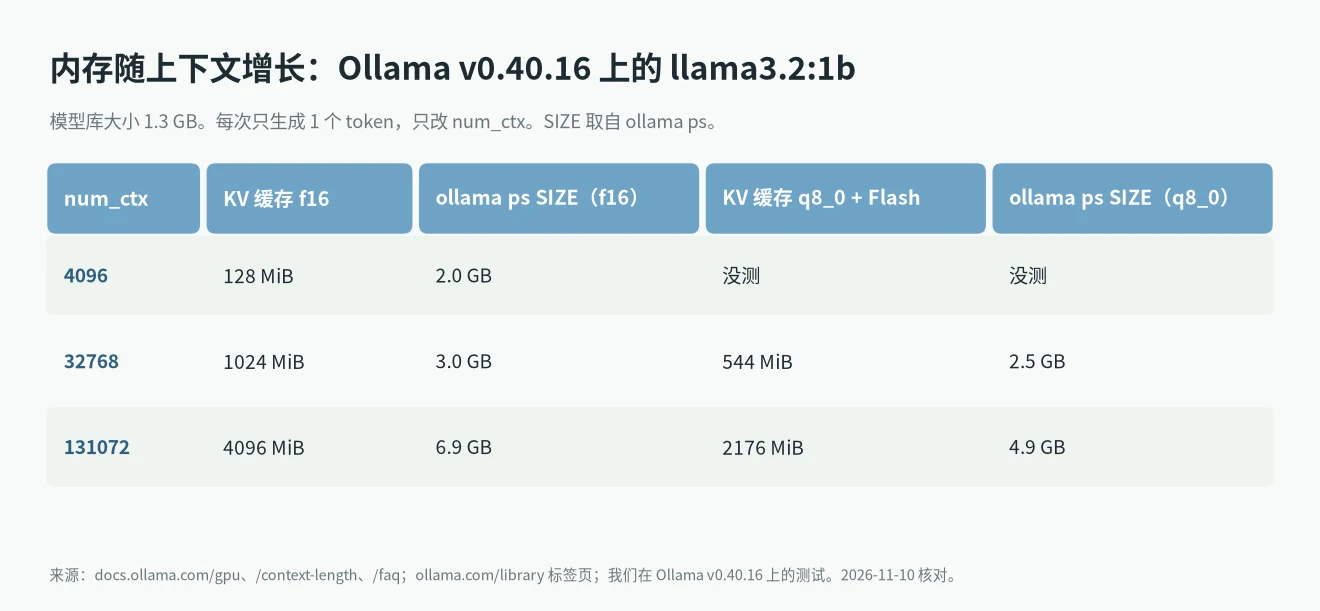
结果:同一个模型,4096 上下文占 2.0 GB,32768 占 3.0 GB,131072 占 6.9 GB;KV 缓存(日志里的 llama_kv_cache)分别是 128 MiB、1024 MiB 和 4096 MiB。把缓存量化成 q8_0 并打开 Flash Attention(官方 FAQ 里的 OLLAMA_KV_CACHE_TYPE 和 OLLAMA_FLASH_ATTENTION),131072 上下文的缓存降到 2176 MiB,ollama ps 显示 4.9 GB。
这个模型很小,运行时固定开销占比大,所以 1.3 GB 变 2.0 GB 的比例不能套到大模型上。能套的是趋势:占用比下载大小大,并且跟着上下文走。官方 FAQ 还写了:OLLAMA_NUM_PARALLEL 大于 1 时,所需内存按 OLLAMA_NUM_PARALLEL 乘 OLLAMA_CONTEXT_LENGTH 增长。
相关设置见Ollama 上下文长度设置。
显存不够会怎样,怎么确认
官方 FAQ 说明:新模型加载时,Ollama 会比较所需显存和当前可用显存,能完整放进单张卡就放进去,放不下就分到多张卡;如果总显存仍然不够,一部分放内存。ollama ps 的 PROCESSOR 列显示放在哪:100% GPU、100% CPU,或者 48%/52% CPU/GPU 这种混合。
有一个我们实测遇到的坑:那台没有显卡的机器上,ollama ps 的 PROCESSOR 列也打出了 25%/75% CPU/GPU、52%/48%、79%/21%,而同一份服务端日志写的是 inference compute id=cpu,total_vram="0 B"。所以判断有没有用上显卡,不要只看 PROCESSOR 一列,同时看服务端日志里的 inference compute 那一行,在 NVIDIA 机器上再看 nvidia-smi。这是我们在 v0.40.16 的观察,没有确认原因。
遇到「model requires more system memory」这类报错,见对应的排查文章;Ollama 的其他报错见报错速查。有显卡但 Ollama 只跑 CPU,见Ollama 不用显卡只跑 CPU。
我们实测了什么,哪些来自文档
- 实测(Ollama v0.40.16,Linux,8 核、15.6 GiB 内存,无显卡):服务端日志里的
inference compute id=cpu和vram-based default context total_vram="0 B" default_num_ctx=4096;OLLAMA_CONTEXT_LENGTH=64000会出现在服务端配置里;llama3.2:1b 在不同上下文下的ollama psSIZE 和 KV 缓存大小;q8_0 缓存加 Flash Attention 的效果;上面提到的 PROCESSOR 列现象。 - 没测:任何真实显卡的显存占用、NVIDIA 驱动和计算能力要求、AMD ROCm 支持、Vulkan、各模型在各档显存上到底装不装得下。表格里的模型大小来自 Ollama 模型库页面,够、紧、不够是按我们的经验规则算出来的,不是实测。
- 另外:我们这台机器下载模型要给 Ollama 服务进程配代理,这和「max retries exceeded」那篇讲的一致。
- 来源:Hardware support、Context length、FAQ、Ollama Library(gemma4、qwen3.5、qwen3.6、qwen3-coder、deepseek-r1、gpt-oss、llama3.2、llama3.3 的标签页)。查询日期 2026 年 11 月 10 日。
买卡的话,可以看显卡性价比指南和4090 能跑多大的模型。
常见问题
Ollama 最低要什么显卡?
官方页写的是 NVIDIA 计算能力 5.0 以上加驱动 550 以上(老卡 570 以上)、AMD 的 ROCm v7 支持列表、苹果 Metal,以及 Vulkan 兜底。没有最低显存的数字。
没有显卡能用 Ollama 吗?
能,会跑在 CPU 和内存上。我们的测试机就是这样跑的,日志显示 inference compute id=cpu。速度会慢很多。
4GB 显存能跑什么?
下载大小在 2 GB 左右的小模型,比如 llama3.2:3b(2.0 GB)。再大的模型要放一部分到内存。
为什么显存够装下模型文件,还是装不下?
因为还有 KV 缓存。我们的测试里,1.3 GB 的模型在 131072 上下文下要 6.9 GB。上下文设短、量化缓存,或者换小一档的模型。
Ollama 一定要 NVIDIA 吗?
不一定。AMD 走 ROCm,苹果走 Metal,其他显卡可以走 Vulkan。支持的具体型号以官方页为准。