

跑大模型显卡性价比怎么选?5060 Ti 到 5090,按每 GB 显存和每秒 token 算清楚(2026)
跑大模型显卡性价比,先看要多大显存:5060 Ti 每花一美元换来的速度最多,二手 3090 是最便宜的 24GB,5090 是 32GB 的首选。2026 年 10 月 28 日核对。
 buffer关于作者约 6 分钟阅读
跑大模型显卡性价比,先看你要跑多大的模型,再看每块钱能换多少显存和速度。结论:只跑 14B 以内的模型,买 RTX 5060 Ti 16GB(429 美元),按每 100 美元能换到的每秒 token 数算,它是我对比的几张卡里最高的。要 24GB,二手 RTX 3090 约 800 美元,仍是最便宜的门槛,跑 32B 模型约每秒 30 个 token。要 32GB,直接买 RTX 5090(1,999 美元),它是这里最快的卡,每 GB 显存的价格和 5080 一样。按现在的价格,不建议买 RTX 5080,也不建议买新的 RTX 4090。只有要在单卡上跑 70B 或 gpt-oss-120b,才考虑 RTX Pro 6000。价格来自 NVIDIA 首发价或 Hardware Corner 列出的市场价,速度来自 Hardware Corner 的 llama.cpp 实测,均于 2026 年 10 月 28 日核对。
一句话答案
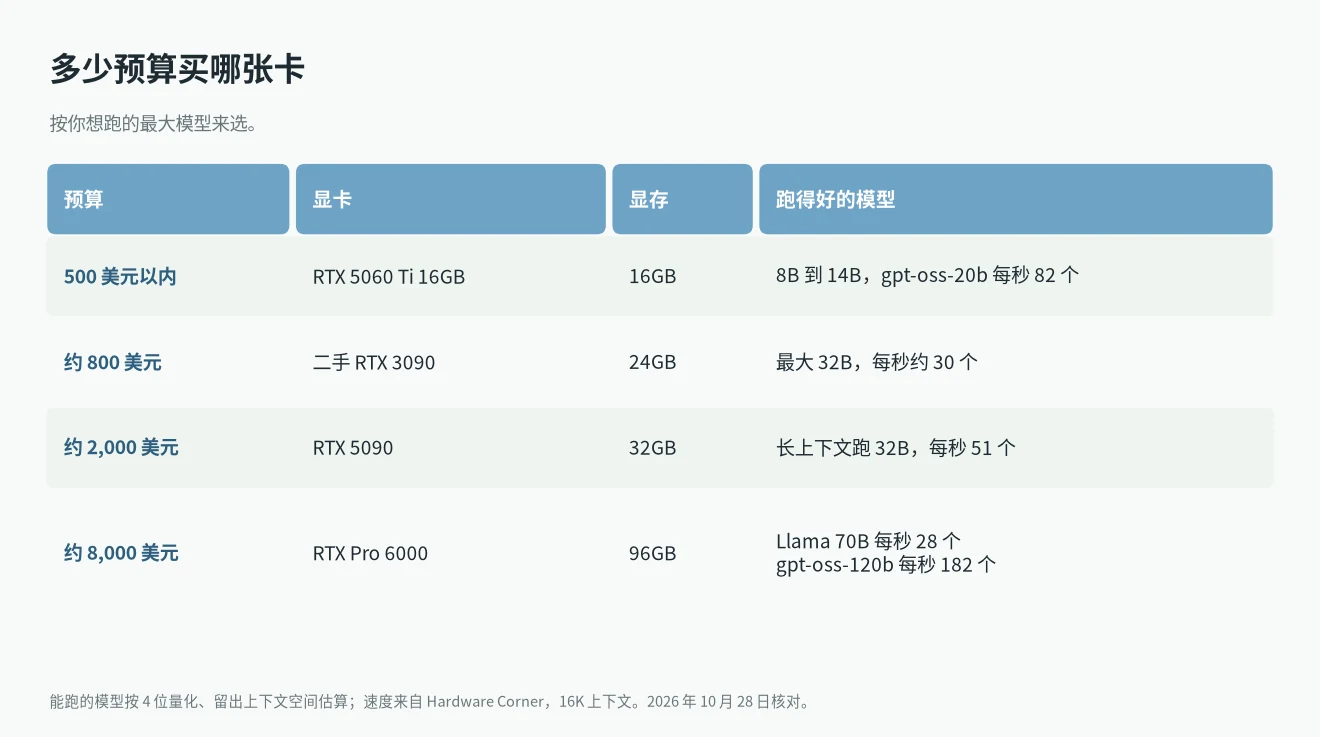
- 500 美元以内:RTX 5060 Ti 16GB。Qwen3 8B 上每 100 美元换 12 tok/s,这份名单里比例最高。
- 800 美元左右:二手 RTX 3090。24GB,每 GB 约 33 美元,能跑 32B 模型。
- 2,000 美元左右:RTX 5090。32GB,Qwen3 8B 每秒 145 个 token,Qwen3 32B 每秒 51 个。
- 8,000 美元左右:RTX Pro 6000。96GB,这里唯一能单卡跑 Llama 70B 和 gpt-oss-120b 的卡。
- 不建议:RTX 5080(和 5070 Ti 一样 16GB,贵 250 美元),以及约 2,574 美元的 RTX 4090,现在比 5090 还贵。
跑大模型显卡性价比怎么算
看两个数。第一个是每 GB 显存的价格。模型要整个放进显存才能全速运行,所以显存决定你能跑哪些模型。4-bit 量化下,8B 模型约需 6GB,14B 约 10GB,32B 约 20GB,上下文还要另算。具体模型可以用我的显存计算器算一下。
第二个是每块钱的速度。模型放得下时,生成速度主要看显存带宽,因为每生成一个 token,显卡都要把权重读一遍。我用 Hardware Corner 的显卡排行里 Qwen3 8B、16K 上下文的每秒 token 数,再除以价格。这个排行用同一套 llama.cpp 设置测试所有显卡。
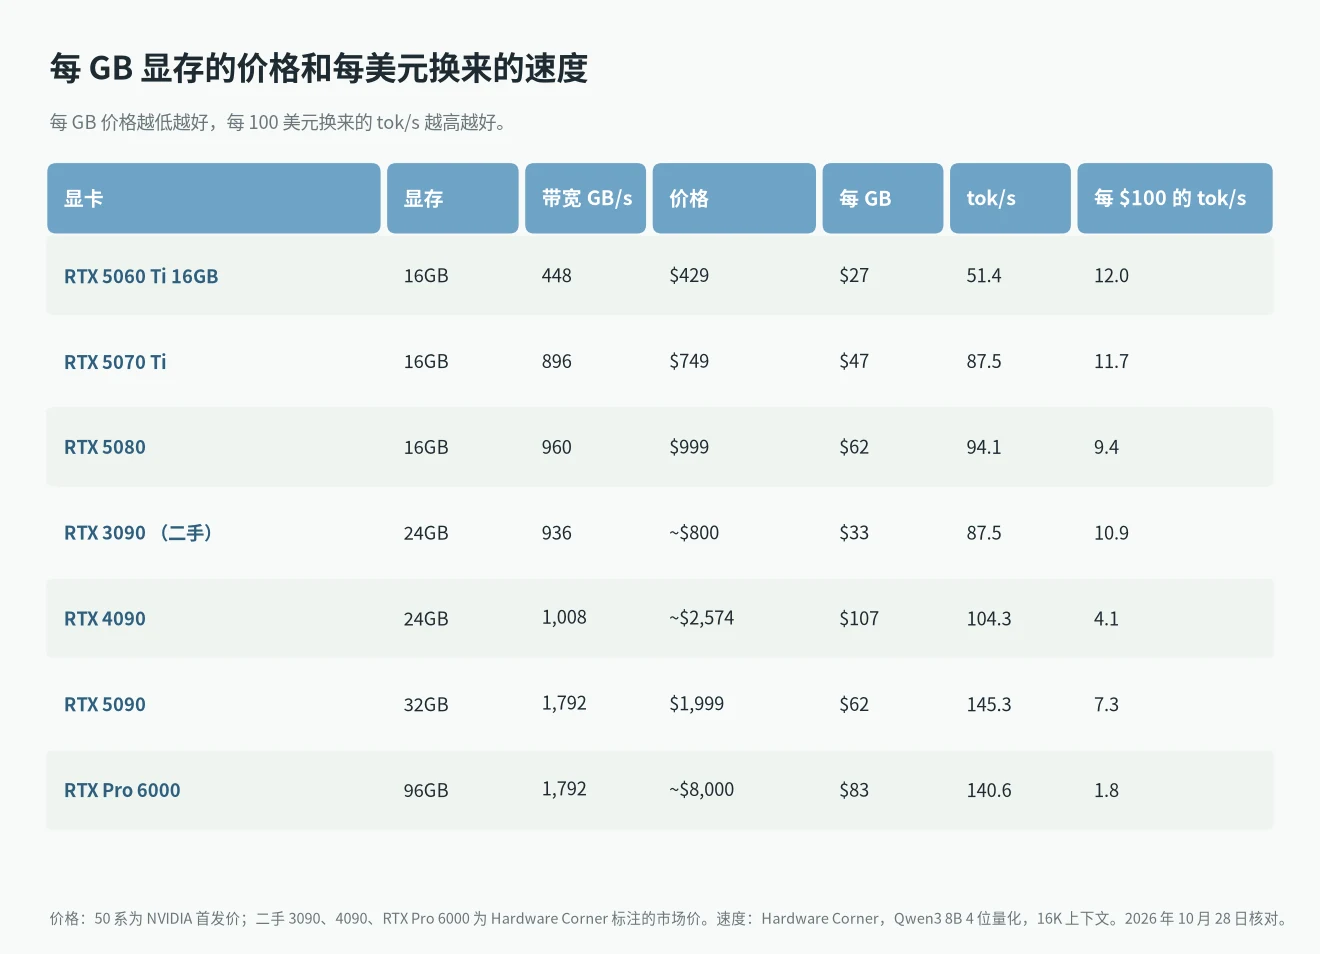
RTX 50 系列用 NVIDIA 首发价:RTX 5090 为 1,999 美元,RTX 5080 为 999 美元(NVIDIA,2025 年 1 月),RTX 5070 Ti 为 749 美元,RTX 5060 Ti 16GB 为 429 美元(NVIDIA,2025 年 4 月)。RTX 3090 和 4090 已停产,RTX Pro 6000 没有公开零售价,这三张用 Hardware Corner 上的市场价。实际售价每周都在变,买之前用你看到的价格重新除一遍。
每张卡的实测速度
下面是三个常用模型在 16K 上下文下的生成速度(每秒 token 数),都来自同一份 Hardware Corner 测试。
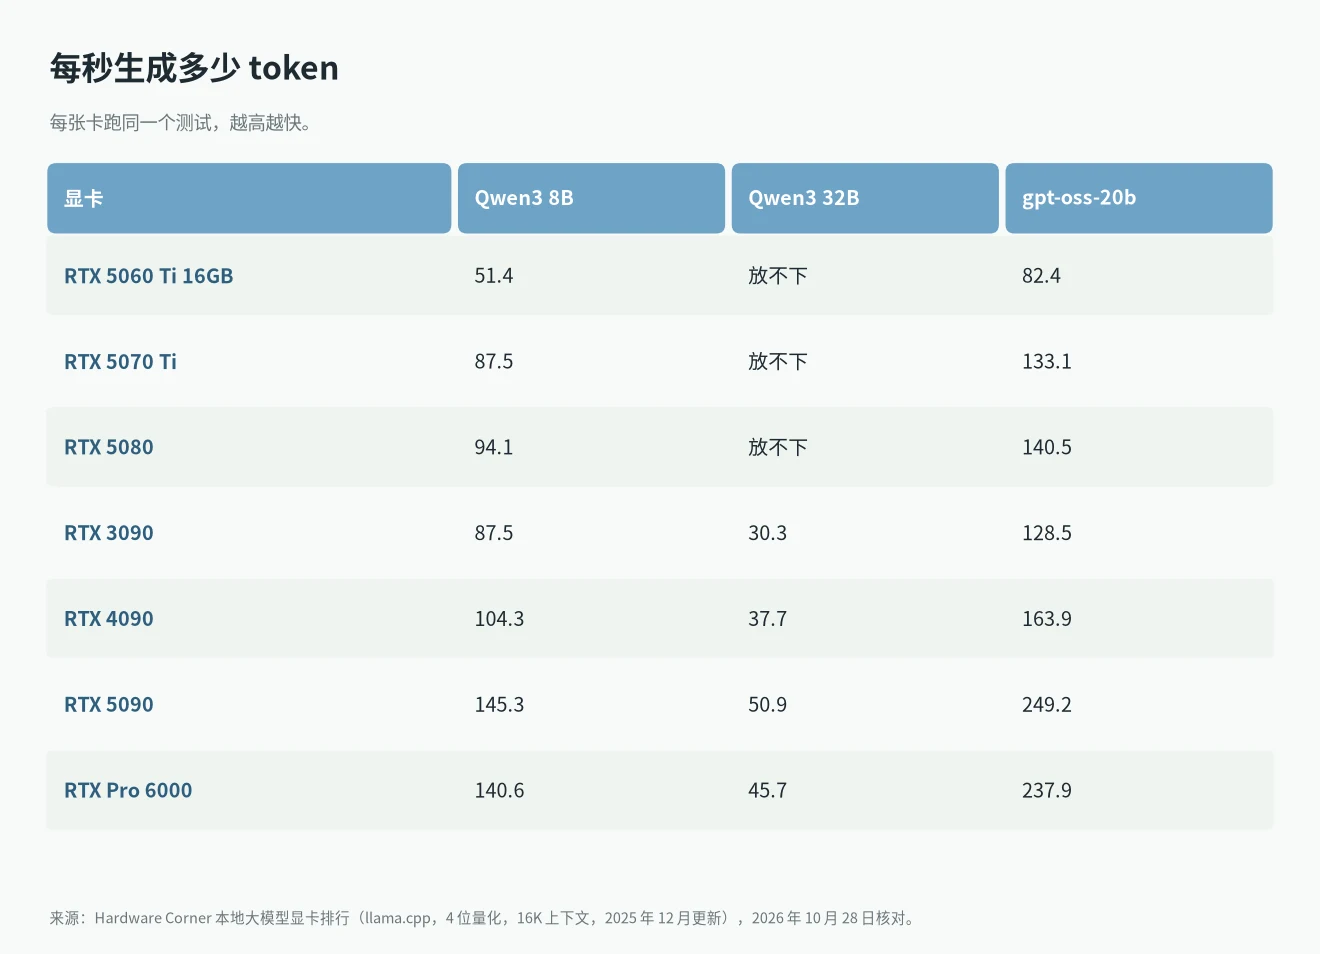
有三点值得注意。第一,16GB 的卡再快也跑不了 32B 模型。第二,RTX 3090 跑 Qwen3 8B 和 RTX 5070 Ti 一样快(都是 87.5 tok/s),因为两者带宽接近:936 和 896 GB/s。第三,在两张卡都放得下的模型上,RTX Pro 6000 并不比 RTX 5090 快,两者带宽都是 1,792 GB/s。多花的钱买的是多出来的 64GB 显存,不是速度。5090 和 4090 的详细对比见RTX 5090 跑大模型这篇。
按预算选:跑大模型显卡性价比排序
500 美元以内:RTX 5060 Ti 16GB
429 美元的 RTX 5060 Ti 16GB,Qwen3 8B 每秒 51.4 个 token,gpt-oss-20b 每秒 82.4 个。每 100 美元换 12 tok/s,是这里最高的。短板是带宽只有 448 GB/s,是 5070 Ti 的一半,提示词和上下文一长,速度掉得更多。它是新卡,有保修,功耗也比 3090 低很多。如果只跑 8B 到 14B 的模型,买它就对了。
800 美元左右:二手 RTX 3090
Hardware Corner 给出的二手 RTX 3090 价格约 800 美元,每 GB 约 33 美元,没有哪张新卡能这么便宜拿到 24GB。24GB 是关键的一档:4-bit 的 Qwen3 32B 能跑到每秒约 30 个 token,而 16GB 的卡根本装不下。代价是二手、没保修、功耗高(350W)、散热器大。付钱前一定要实测,看风扇和显存温度。24GB 能装下哪些模型,可以看我的RTX 4090 能跑多大模型,3090 能跑的模型一样,只是慢一些。
想要新卡又只要 16GB:RTX 5070 Ti
749 美元的 RTX 5070 Ti 带宽是 5060 Ti 的两倍,Qwen3 8B 快 70%,每秒 87.5 个 token。按每块钱算和 5060 Ti 差不多。如果你更在乎小模型的速度,选它。999 美元的 RTX 5080 只比 5070 Ti 快约 8%,显存同样 16GB,跑大模型不划算。
2,000 美元左右:RTX 5090
RTX 5090 是我对比的卡里最快的。Qwen3 32B 每秒 50.9 个 token,4090 是 37.7,3090 是 30.3。32GB 显存让 32B 模型也能开长上下文。按 1,999 美元首发价算,每 GB 62 美元,和 5080 一样,显存却多一倍。Hardware Corner 列出的市场价是 2,499 美元,即使按这个价格,也比约 2,574 美元的 RTX 4090 划算。不过 2026 年的零售价可能高得多:据 NeoTeo 报道,2026 年 9 月美国有一家零售商把 RTX 5090 标到 4,999 美元,约为 1,999 美元建议零售价(MSRP)的 2.5 倍,整个 RTX 50 系列的售价也普遍明显高于 MSRP。下单前,用你实际看到的价格除以显存 GB 数,再重新比一遍。
8,000 美元左右:RTX Pro 6000
RTX Pro 6000 单卡 96GB,是这里唯一不用拆分模型就能跑 Llama 3.3 70B(每秒 28.2 个 token)和 gpt-oss-120b(每秒 182.2 个 token)的卡。按每 GB 算约 83 美元,比 4090 还便宜。如果你主要要大显存、不太在乎 CUDA 的速度,也可以看看我的 DGX Spark 和 Mac Studio 对比。
两张便宜卡行不行
两张 RTX 5060 Ti 16GB 按首发价 858 美元,合计 32GB,比一张 3090 还多。llama.cpp 和 Ollama 都能把模型拆到两张卡上。但速度不会叠加:单人使用时两张卡轮流干活,大概相当于一张卡跑一个两倍大的模型。还需要有两条 PCIe x16 插槽的主板和更大的电源。两张二手 3090(48GB)是低预算跑 4-bit 70B 的常见做法,但这是个折腾的工程,不是插上就能用。
跑大模型我不会买的卡
- 8GB 显卡:4-bit 下只能装下 7B 左右的模型。多花 50 美元买 16GB 的 5060 Ti。
- RTX 5080:999 美元只有 16GB,5070 Ti 便宜 250 美元,速度差不多。
- 2,500 美元以上的新 RTX 4090:只有 24GB,却比首发价的 32GB RTX 5090 还贵。
还不确定要跑哪些模型,先看我的各显存档位本地大模型推荐,再决定买哪张卡。
常见问题
2026 年跑大模型显卡性价比最高的是哪张?
14B 以内选 RTX 5060 Ti 16GB(429 美元);要 24GB 选二手 RTX 3090(约 800 美元);要 32GB 选 RTX 5090(1,999 美元)。
二手 RTX 3090 现在还值得买吗?
预算有限又要 24GB,值得。约 800 美元是最便宜的 24GB 卡,跑 Qwen3 32B 约每秒 30 个 token。没有保修,买前一定要实测。
跑大模型,RTX 5090 比 RTX 4090 更划算吗?
按现在的价格,是的。5090 有 32GB(4090 是 24GB),生成速度快约 1.35 到 1.5 倍,1,999 美元的首发价还低于 4090 约 2,574 美元的售价。
本地跑大模型需要多少显存?
4-bit 下,8B 到 14B 模型要 16GB,32B 要 24GB,70B 要 48GB 以上。上下文越长,需要越多。