

Mejores LLM locales: guía esencial para elegir modelo según tu VRAM, de 8 a 128 GB (2026)
Qué LLM local ejecutar según tu VRAM o memoria unificada, de 8 a 128 GB, con tamaños de descarga de Ollama revisados el 28 de octubre de 2026.
 bufferSobre el autor5 min de lectura
Respuesta corta: los mejores LLM locales dependen de tu memoria. Con 8 GB, empieza por Qwen3.5 4B. Con 12 GB, usa Qwen3.5 9B o Gemma 4 12B. Con 16 GB puedes probar gpt-oss-20b. Con 24 GB, elige Qwen3.8 27B o Gemma 4 26B-A4B. Con 32 GB, elige Qwen3.6 35B-A3B. Solo con 96 a 128 GB caben gpt-oss-120b y Qwen3.5 122B-A10B. Todos los tamaños de descarga vienen de la biblioteca oficial de Ollama y los revisé uno por uno el 28 de octubre de 2026.
Esta guía mira una sola cosa: si el archivo del modelo cabe entero en tu VRAM (memoria unificada en un Mac) y deja sitio para el contexto. Un modelo que no cabe pasa una parte a la RAM o al disco y va mucho más lento. Para un cálculo exacto, introduce parámetros, cuantización y contexto en la calculadora de VRAM.
Mejores LLM locales según tu VRAM
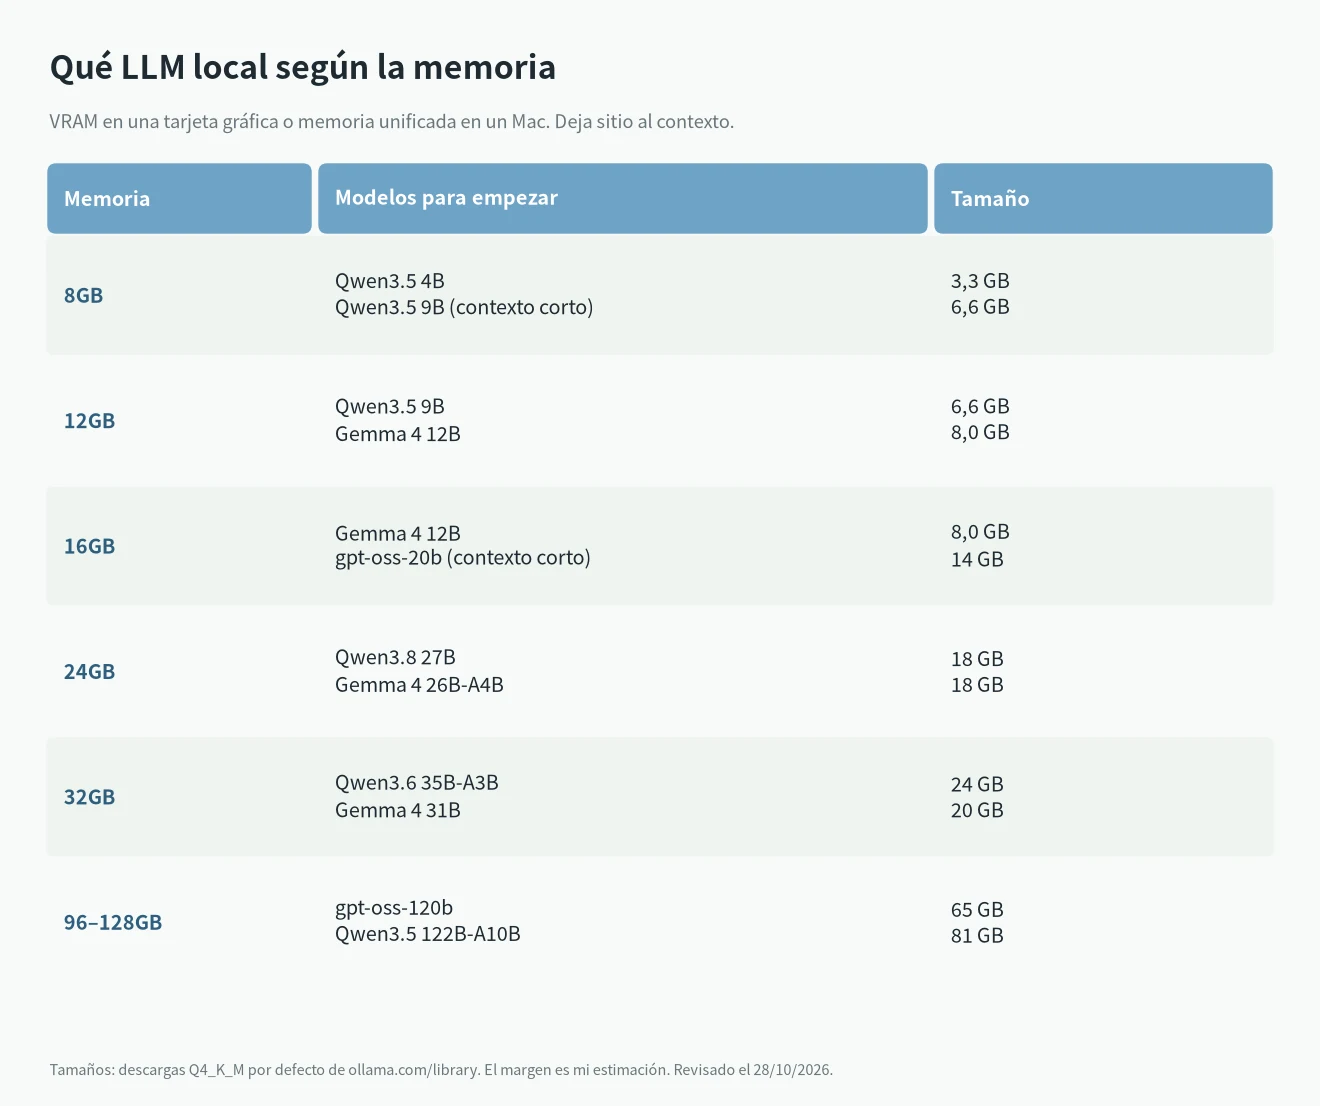
En cada nivel indico solo los dos o tres modelos que conviene probar primero. Los tamaños son las descargas Q4_K_M por defecto de Ollama.
- 8 GB: Qwen3.5 4B, un archivo de 3,3 GB con mucho margen. Qwen3.5 9B ocupa 6,6 GB y también cabe, pero con un contexto corto.
- 12 GB: Qwen3.5 9B (6,6 GB) o Gemma 4 12B (8,0 GB). Es el nivel con mejor relación calidad-precio para chatear, traducir y resumir documentos.
- 16 GB: Gemma 4 12B con un contexto más largo. gpt-oss-20b ocupa 14 GB. Cabe, pero deja unos 2 GB para el contexto.
- 24 GB: Qwen3.8 27B (18 GB) y Gemma 4 26B-A4B (18 GB). Aquí están la RTX 4090 y la RTX 3090. Consulta qué modelos puede ejecutar la RTX 4090.
- 32 GB: Qwen3.6 35B-A3B (24 GB) o Gemma 4 31B (20 GB). La RTX 5090 tiene 32 GB. Consulta la RTX 5090 para IA.
- 96 a 128 GB: gpt-oss-120b (65 GB) y Qwen3.5 122B-A10B (81 GB). Normalmente significa un Mac Studio de 128 GB, una DGX Spark o un equipo con AI Max 395. Compáralos en DGX Spark o Mac Studio.
Los niveles siguen una regla mía: el tamaño del archivo más 2 a 4 GB para el contexto y el entorno de ejecución. Si usas un contexto de decenas de miles de tokens, deja más margen.
Tamaño de descarga por modelo
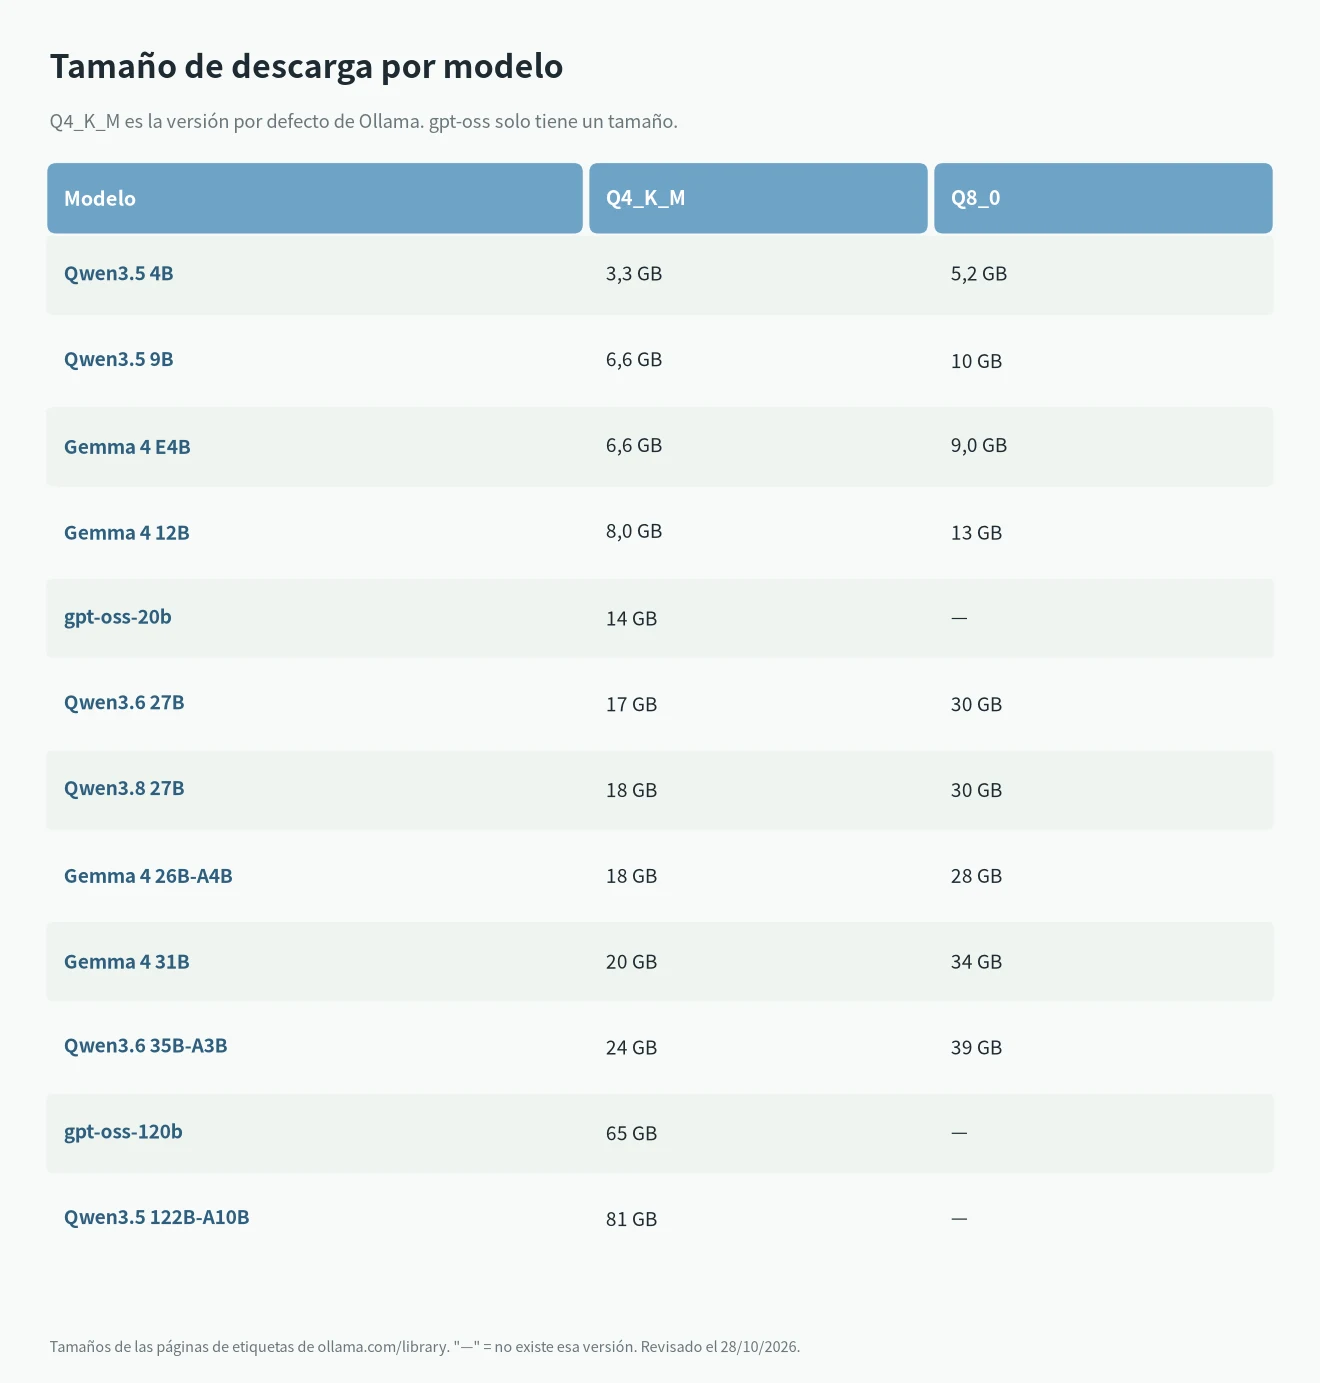
La versión Q8_0 de un modelo ocupa entre 1,5 y 1,8 veces lo que ocupa la Q4_K_M. Por ejemplo, Qwen3.8 27B ocupa 18 GB en Q4_K_M y 30 GB en Q8_0. Q8_0 se acerca más a la precisión original, pero necesita mucha más memoria. Si vas justo, usa Q4_K_M. Con 48 o 64 GB, puedes pasar a Q8_0.
gpt-oss tiene un solo tamaño por modelo: gpt-oss-20b ocupa 14 GB y gpt-oss-120b, 65 GB.
Modelos con A3B o A4B en el nombre
Qwen3.6 35B-A3B, Gemma 4 26B-A4B y Qwen3.5 122B-A10B son modelos de mezcla de expertos (MoE). A3B significa que se activan unos 3.000 millones de parámetros por token. Generan texto más rápido que un modelo denso del mismo tamaño, pero el modelo entero tiene que caber en memoria, así que elige el nivel por el tamaño del archivo.
Para qué sirve cada familia
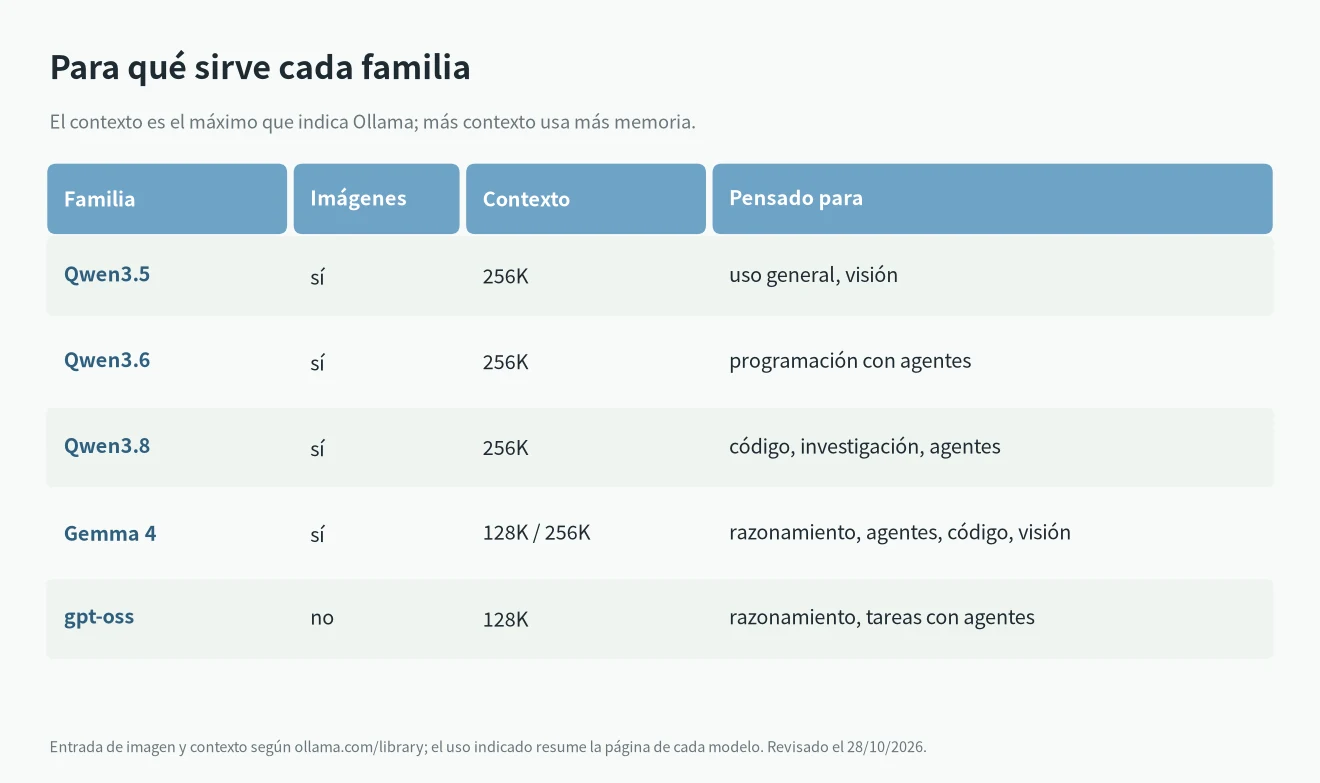
- Qwen3.8 27B: la página de Ollama dice que mejora mucho en programación, trabajo profesional, investigación y tareas largas con agentes. Es mi primera opción para 24 GB.
- Qwen3.6: su descripción se centra en la programación con agentes. Encaja con herramientas de código. Para el hardware, consulta la guía de LLM locales para programar.
- Gemma 4: la familia de Google acepta imágenes. Los modelos E tienen 128K de contexto, y los de 12B o más, 256K.
- gpt-oss: los modelos de pesos abiertos de OpenAI solo aceptan texto, con 128K de contexto.
Si necesitas leer imágenes, elige Qwen o Gemma 4, porque gpt-oss no acepta imágenes.
Si usas un Mac
En un Mac, la memoria unificada hace de VRAM, pero macOS y tus otras aplicaciones usan una parte. Un Mac mini de 16 GB va más seguro en el nivel de 12 GB, y un Mac de 24 GB en el de 16 GB. Para configuraciones concretas, consulta el Mac mini para LLM locales y el M5 para LLM locales.
Cómo empezar
Instala Ollama y ejecuta un comando en la terminal, por ejemplo «ollama run qwen3.8:27b». La primera vez descarga el archivo del modelo, y después funciona sin conexión. Para DeepSeek, consulta cómo instalar DeepSeek en local.
Preguntas frecuentes
¿Cuál es el mejor LLM local para 8 GB de VRAM?
Qwen3.5 4B. Ocupa solo 3,3 GB, así que funciona en 8 GB con mucho margen.
¿Uso Q4 o Q8?
Usa Q8_0 si cabe y Q4_K_M si no. Q4_K_M es la versión por defecto de Ollama y ocupa alrededor del 60 % de la Q8_0.
El modelo cabe, ¿por qué va lento?
Normalmente el contexto es demasiado largo y llena la memoria que queda, así que parte del trabajo pasa a la CPU. Acorta el contexto o elige un modelo más pequeño.
¿Cada cuánto se actualiza esta lista de mejores LLM locales?
Salen modelos nuevos muy a menudo. Los modelos y tamaños de esta guía coinciden con la biblioteca de Ollama del 28 de octubre de 2026, y actualizaré la lista cuando aparezcan versiones nuevas.