
Instalar DeepSeek en local: guía fácil en 3 pasos (2026)
La guía honesta para ejecutar DeepSeek en tu GPU, Mac o PC: qué modelos caben, cuánta memoria y una instalación en 3 pasos.
 bufferSobre el autor6 min de lectura
Quieres instalar DeepSeek en local — en tu propia máquina, sin factura de API y sin que nada salga de casa. Buenas y malas noticias. Los modelos DeepSeek pequeños y medianos corren bien en hardware que mucha gente ya tiene. Pero el que casi todos imaginan al decir “DeepSeek”, el 671B completo, pide un servidor, no un portátil. Lo mío en esta web es ayudarte a gastar bien en IA, así que aquí va la versión honesta, con los números que yo comprobaría antes de soltar un euro.
Qué DeepSeek puedes descargar de verdad
Primero, un lío que pilla a todo el mundo: en las páginas de descarga hay dos cosas muy distintas con el nombre “DeepSeek”. Lo que mueve el hardware normal son los modelos R1 destilados — 1.5B, 7B, 8B, 14B, 32B y 70B —, que en realidad son Qwen y Llama reentrenados con el razonamiento de DeepSeek-R1. Son útiles y pequeños — y son con los que casi todo el mundo va a instalar DeepSeek en local —, pero no son el R1 real.
Los pesos abiertos de verdad — DeepSeek-V3, V3.1 y el R1 completo — son modelos Mixture-of-Experts de 671B. Los más nuevos, V4-Pro y V4.1-Flash, aparecen como modelos cloud en Ollama, o sea de escala servidor. Puedes verlo en la librería de Ollama y en Hugging Face. Así que, al hablar de instalar DeepSeek en local en un PC o un Mac normal, hablamos de los tamaños destilados.
Instalar DeepSeek en local empieza por la memoria
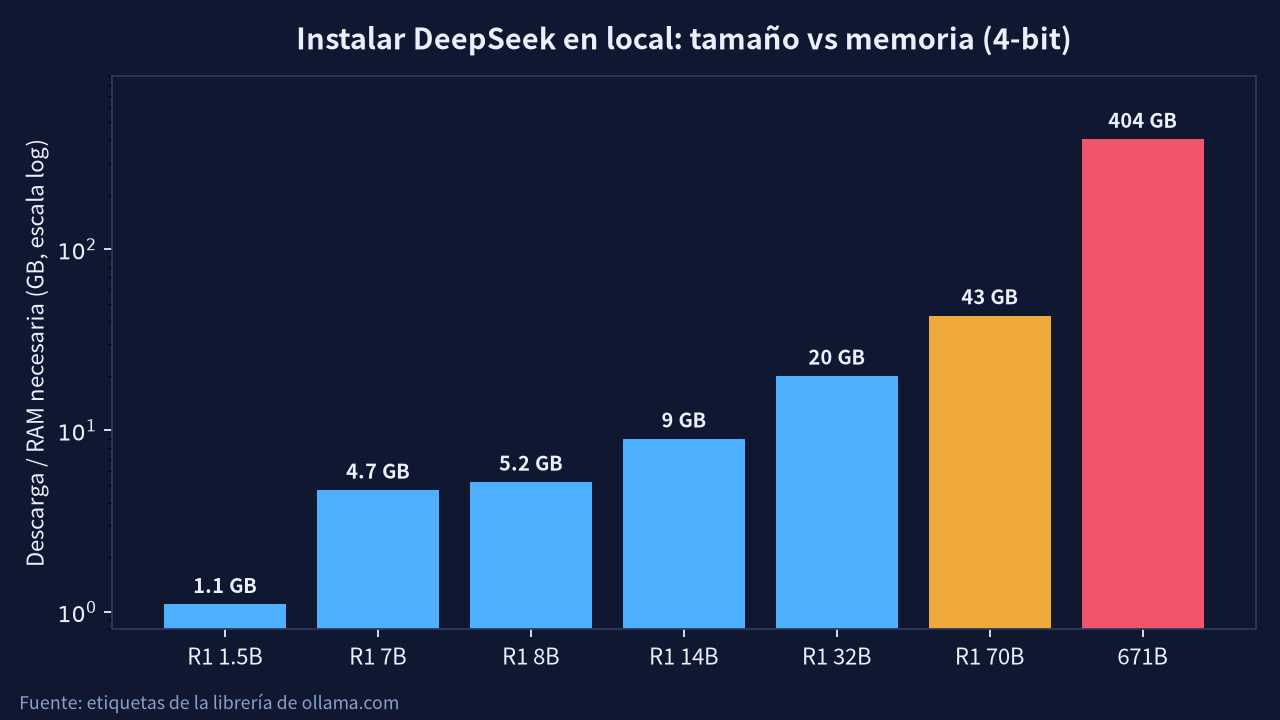
Lo que lo decide todo es la memoria: la VRAM de la gráfica, o la memoria unificada en un Mac. Regla rápida: a 4 bits (los archivos q4_K_M que usa casi todo el mundo), un modelo necesita un poco más que su tamaño de archivo en memoria, más margen para la ventana de contexto. Los tamaños de abajo salen directos de las etiquetas de Ollama, o sea, lo que de verdad ocupa en tu disco.
| Modelo (4 bits) | Descarga / memoria | Cómodo en |
|---|---|---|
| DeepSeek-R1 1.5B | 1,1 GB | Casi cualquier cosa |
| DeepSeek-R1 7B | 4,7 GB | GPU de 8 GB / Mac de 16 GB |
| DeepSeek-R1 8B | 5,2 GB | GPU de 8 GB / Mac de 16 GB |
| DeepSeek-R1 14B | 9,0 GB | GPU de 12–16 GB / Mac de 24 GB |
| DeepSeek-R1 32B | 20 GB | GPU de 24 GB / Mac de 32–48 GB |
| DeepSeek-R1 70B | 43 GB | GPU(s) de 48 GB / Mac de 64–128 GB |
| 671B completo (V3.1 / R1) | 404 GB (q4), 713 GB (q8) | Solo servidor multi-GPU |
Dos matices honestos: a 8 bits los tamaños casi se duplican, y un contexto largo come memoria extra por encima. El archivo del modelo es el suelo, no el techo.
Niveles de hardware: qué cabe dónde
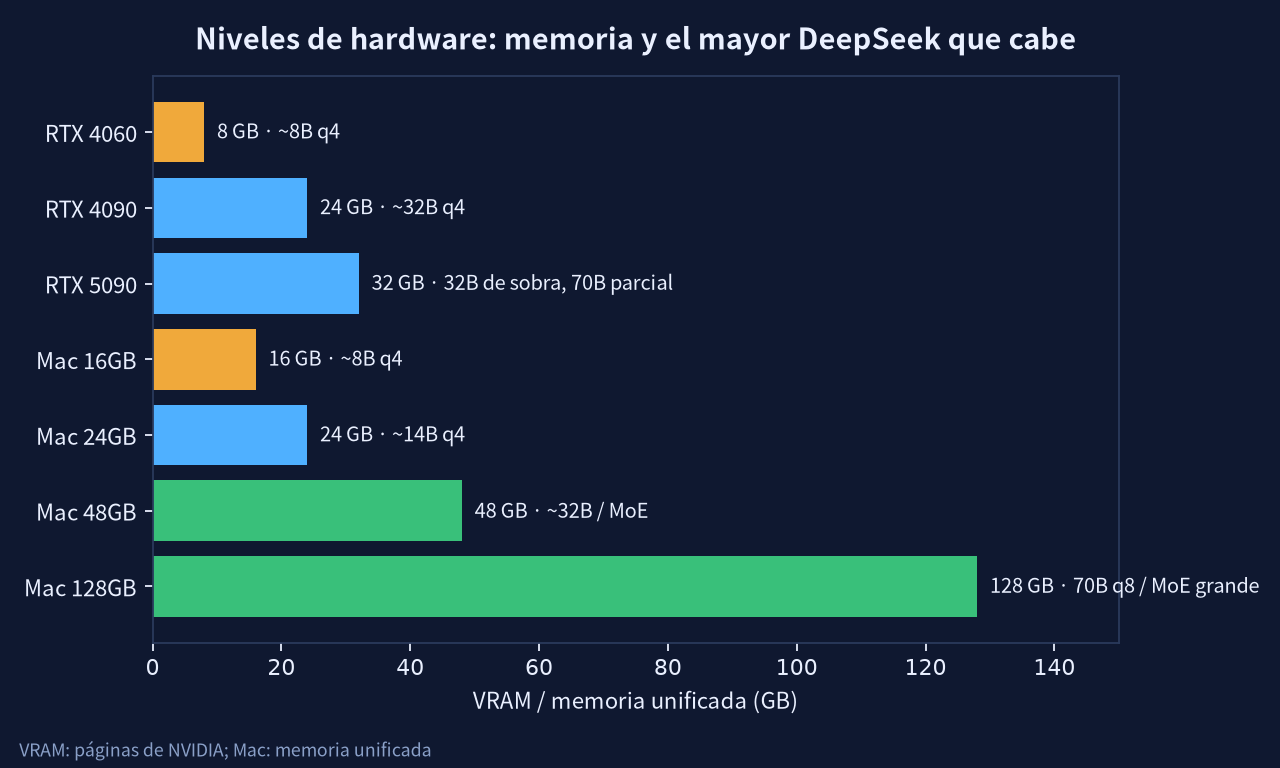
En gráficas lo que manda es la VRAM: la RTX 4060 tiene 8 GB, la RTX 4090 tiene 24 GB y la nueva RTX 5090 trae 32 GB de GDDR7. Una tarjeta de 8 GB llega a un 8B, una 4090 de 24 GB mueve un 32B a 4 bits, y una 5090 hace el 32B con holgura y empieza a tantear el 70B.
El Mac juega a otra cosa: la memoria unificada se comparte con la GPU, así que un Mac de 32 o 48 GB carga modelos que una gráfica de PC del mismo precio no puede, aunque más despacio. Si vas a elegir un Mac para esto, afiné cuánta memoria comprar en mi guía de comprar Mac ahora o esperar: en corto, 24 GB es mi mínimo y 48 GB el punto dulce para IA local. (En México los precios cambian, pero la lógica de memoria es la misma.)
La vía rápida de instalación
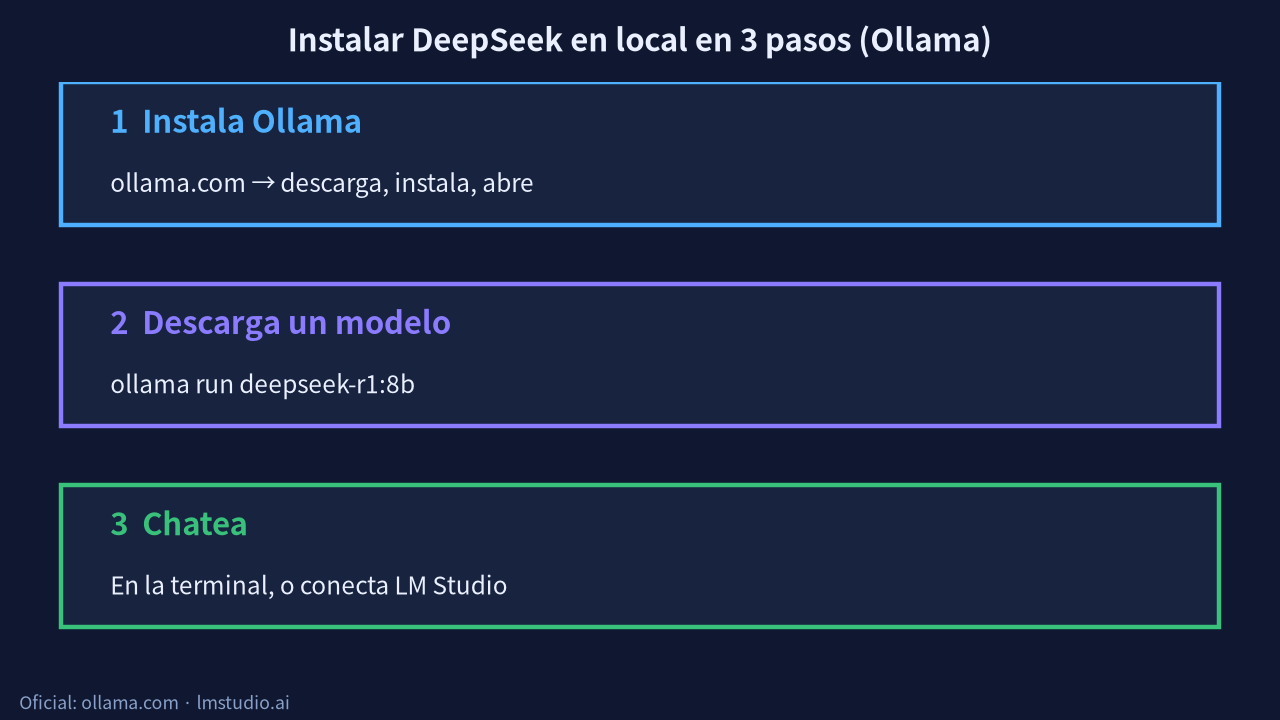
No hace falta tocar Python. Dos herramientas cubren a casi todos. Ollama es la vía de una línea: instálalo, ejecuta ollama run deepseek-r1:8b y ya estás chateando en la terminal. LM Studio es la misma idea con interfaz gráfica y buscador de modelos, mejor si la terminal no es lo tuyo. Ambas son gratis y así es como le diría a un amigo que instale DeepSeek en local por primera vez.
Límites honestos
La parte que el bombo se salta: los destilados son buenos, pero no son el R1 completo — en razonamiento duro se nota el escalón. Y el 671B real está fuera de casa de verdad: 404 GB a 4 bits son un armario de GPUs o un Mac tope de gama carísimo, y aun así va lento. No te voy a dar tokens por segundo porque no lo he medido en cada equipo, y quien te dé una sola cifra limpia de “velocidad de DeepSeek” está improvisando. Elige un modelo que quepa con margen y irá fino; para instalar DeepSeek en local y disfrutarlo, mete uno que quepa con margen; si apenas entra, se arrastra.
¿Puedes seguir usando DeepSeek tras la prohibición en EE.UU.?
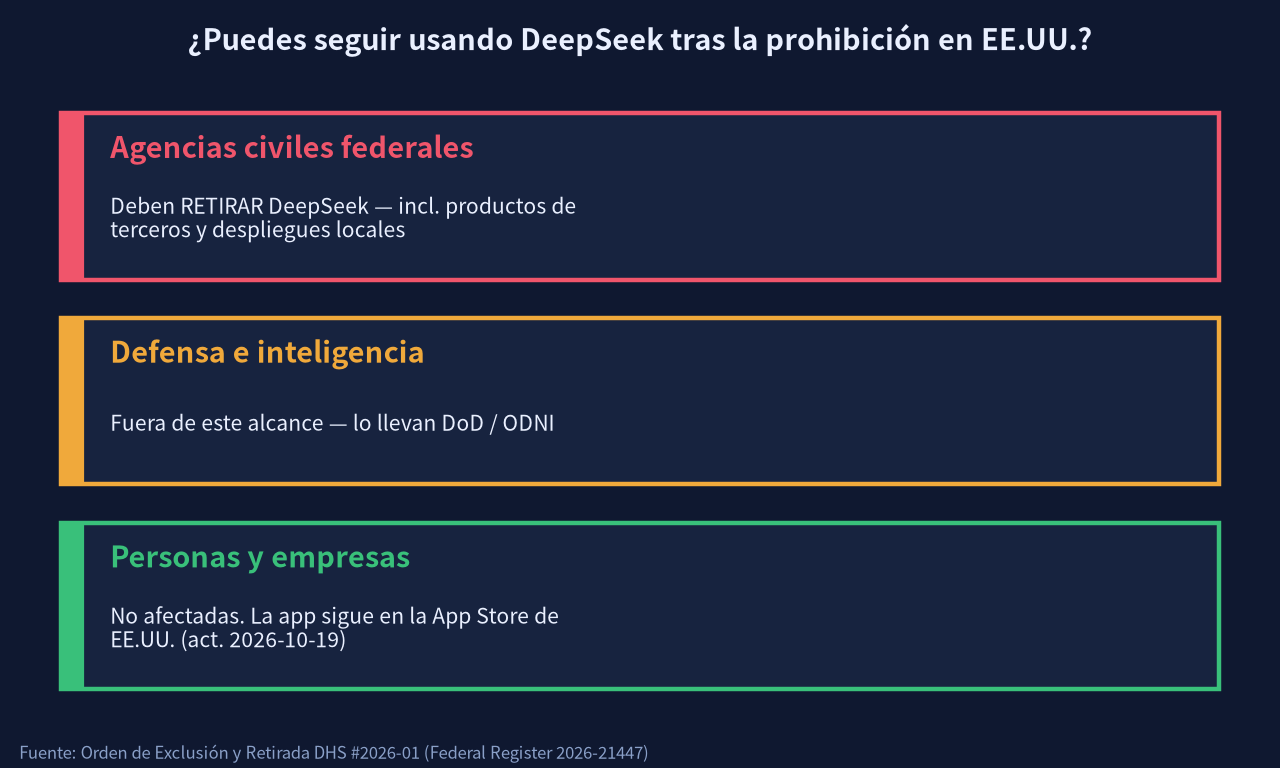
Sale cada vez, así que: sí, si eres un particular. El 19 de octubre de 2026 (hora de Pekín) EE.UU. publicó una orden del DHS — firmada ya el 24 de julio — que ordena a las agencias civiles federales dejar de comprar DeepSeek y retirarlo de sus sistemas. Incluye productos de terceros construidos con DeepSeek y despliegues locales de código abierto dentro de esas agencias. Defensa e inteligencia van por separado y no entran en esta orden.
Lo que no hace es afectarte a ti. Las personas y empresas quedan fuera, y la app seguía disponible en la App Store de EE.UU. (actualizada el 19 de octubre). Un detalle curioso: los 60 días para pedir una excepción contaban desde la firma de julio, así que ya se habían cerrado (hacia el 22 de septiembre) antes de que la orden fuera pública. Puedes leer el documento original en el Federal Register.
Qué haría yo
Si solo quieres probarlo, instala Ollama y baja el 8B esta noche: cabe en casi todo. Si la IA local es trabajo de verdad, apunta a 24–32 GB de VRAM o un Mac de 48 GB y vive en el rango 14B–32B. El sueño del 671B, para quien tenga presupuesto de servidor; el resto puede instalar DeepSeek en local sin problema en esa franja media. Y si las cuentas del hardware dejan de cuadrar, una suscripción suele salir más barata — las comparé en mi comparativa de precios de suscripciones de IA. Para el porqué de que DeepSeek siga tirando los precios, lee mi artículo sobre DeepSeek, Huawei y una IA más barata.
Escrito el 20 de octubre de 2026 (Asia/Shanghai). Tamaños de modelo de la librería de Ollama; memoria de GPU de las páginas de NVIDIA; detalles de la prohibición del Federal Register. Ninguna cifra de velocidad es un benchmark propio.
Sigue leyendo: más sobre hardware para IA y más guías de DeepSeek.