
从 GTA 6 到特斯拉:世界模型能替我们试错吗?
卡住的游戏任务能交给 AI 吗?货车挡住视线时,特斯拉能不能提前想到有人会出来?从 GTA 6、SIMA 2 到特斯拉的世界模拟器,聊世界模型离普通人生活有多近,以及它必须先过的现实考验。
 buffer关于作者约 9 分钟阅读
等 GTA 6 发售,我能不能把卡了半天的任务交给 AI,自己去倒杯水?
再想远一点:周一早高峰,车开到一辆挡住视线的货车旁边,它能不能提前想到“后面可能有人出来”,早点松开油门,别等我吓出一身汗才猛踩刹车?
“世界模型”离普通人的生活,其实可以从这两个问题讲起。它尝试学会的是:现在眼前是这个样子,如果我这样做,接下来可能发生什么。最近 Odyssey-3 和 RoboJEPA 的新进展,让这件事又往前走了一步。但会想象后果,和能放心替我们做决定,中间还有不少功课。
先聊点有意思的:AI 能帮我玩 GTA 6 吗?
先对一下时间:截至本文发布的 2026 年 10 月 10 日,Rockstar 官网给出的 GTA 6 发售日期是 11 月 19 日。所以这里聊的是未来游戏助手的可能性。
设想一个开放世界游戏里的追车任务。你卡在同一个弯道,攻略只会说“提前减速、抓住时机”。如果 AI 真能看懂画面、判断车速、操作转向,还能尝试另一条路线,它就有机会陪你过关,甚至替你接手这一段。
这条路已经有研究原型。Google DeepMind 在 2025 年 11 月介绍的 SIMA 2,能根据用户要求,在 3D 游戏中看画面、操作虚拟键鼠;研究者还把它放进 Genie 3 世界模型生成的新环境,测试它能否导航、理解指令并采取行动。
在这套组合里,SIMA 2 是玩家,Genie 3 提供它练习的世界。能生成一个像游戏的环境,不等于自己就会玩游戏;能在新场景里找到目标,也还不等于能通关 GTA 6。团队明确提到,长任务、短期记忆和精细操作仍是难点。
这里还有个容易被忽略的事实:游戏本来就有引擎,撞墙、转弯会发生什么,原游戏自己算得出来。让 AI 玩游戏,并不必然需要另造一个世界模型。能直接在原游戏里训练时,应先利用它的真实规则;生成世界的价值,是补充更多练习场景,再把练出的本事带回目标游戏验证。
对玩家来说,我更期待一个能接手重复跑图、卡关时搭把手的队友。剧情和关键选择还归自己。这个愿望比“AI 替人玩完整部游戏”小,却更像我愿意实际用的功能。
那特斯拉呢,视觉驾驶会不会再上一个台阶?
有机会。尤其是那些你开了很多年车,也不想亲自再碰一次的场面:货车挡住路口,旁边突然出来一个人;雨夜反光,车道线看不清;前车原本好好开着,忽然横切过来。
世界模型在这里的用处很好理解:把同一段路况拿出来,换几种驾驶操作,看看后果。早一点减速会怎样,继续向前会怎样?如果训练与测试能反复覆盖这些情况,最后受益的可以是每天坐在车里的人。
特斯拉也确实公开讲过这条路线。Tesla AI 团队负责人 Ashok Elluswamy 在 ICCV 2025 的技术演讲中,展示了根据过去的状态和驾驶动作生成后续多摄像头画面的“神经世界模拟器”。驾驶策略做出动作,模拟器给出下一段环境反馈,两者可以循环运行。
他展示的用途包括:拿过去出过问题的片段,检查新版本策略会怎么处理;给原本正常行驶的车辆加上突然切入的动作,测试系统的反应。这是特斯拉自己的技术展示。它说明世界模型已进入其研发工具箱,实际安全收益还得拿真实表现来检验。
这部分进步可以先发生在训练和测试阶段,再通过更好的驾驶策略进入用户的车里。不需要假设车每次打方向前,都在车载电脑里播放一段“未来电影”。至于车端怎样使用预测能力,还要看具体架构与算力预算。
而且,摄像头没看见的东西,不能靠想象变成已知事实。货车后面到底有没有人,模型无法凭空确认;我期待它能推演“有人出来”和“没人出来”等可能性,在证据不足时给风险留出余量。对乘客而言,进步可能表现为更早、更平顺地减速,同时减少没必要的急刹车。
所以,马斯克的视觉路线能否更进一步,要看这些难场景里的实测结果。面向车主的 FSD(Supervised)仍要求驾驶者主动监督,不能按无人驾驶使用。“有世界模型”本身不是无人驾驶的通行证。
这次的新进展,离日常使用还有多远?
游戏队友、驾驶模拟器、机器人规划,用途不同,成绩也不能混着算。最近的两项发布,刚好能帮助我们看清进步和距离。
Odyssey-3:环境能响应操作,分数有测试条件
Odyssey 在官网标注为 10 月 8 日的发布文章中,开放了 Flash 版本的研究预览。用户可以在生成的环境中移动、调整视角、引入事件,观察环境继续演变。这是交互环境生成的进展,并非 GTA 6 代打演示。
Pro 版本在 Physics-IQ Verified 视频续写测试中得了 66.1:让模型接着真实物理实验的视频往下生成,再与实际结果比较。该成绩使用了提示增强与 best-of-8,也就是生成 8 个候选后择优。同样有提示增强、没有 best-of-8 的 Pro 得分为 63.4;官方图注注明,常规分数平均了 4 次运行,best-of-8 使用 1 次运行。
这些条件决定了数字该怎么理解。66.1 不能当成驾驶或机器人任务的成功率,也不等于公开 Flash 预览的成绩。
RoboJEPA:预测更准了,真机仍有难关
Meta FAIR 等团队 10 月 7 日公布的 RoboJEPA,在压缩后的视觉特征里预测未来,不必把每一帧画出来。研究将预测器从 2200 万参数扩到 80 亿,数据覆盖 23 个公开数据集、12 类机器人平台。实验使用这批数据,并保持负责提取图像特征的部分不变;增加训练计算量降低了预测误差,也改善了所测规划任务的表现。
再看 RoboJEPA-8B 的真机成绩:
| 真机任务 | 成功率 |
|---|---|
| 抓取物体 | 67% |
| 抬起物体并保持至结束 | 50% |
| 抓取并放到目标位置 | 27% |
论文还写明,即便连接 GPU 集群,80 亿参数模型的一次多步规划仍需数秒,尚未达到实时。家里的机器人要端杯咖啡过来,除了想得对,还得来得及反应。
游戏可以重来,现实里的失误谁来买单?
假如模型把“夹得不牢,杯子也不会掉”学进去了,机器人可能偏偏选中从你电脑上方抄近路。它已经预演过了,结果看上去很好。麻烦正出在这里:如果坏动作在模拟里总能成功,继续优化,可能会让机器更积极地选择坏动作。
理论论文《Imperfect World Models are Exploitable》讨论了一种关键错误:现实中 A 优于 B,模型却把 B 排到 A 前面。它在特定数学假设下研究这种排序颠倒何时能够避免。与之前写过的 Karotte 与奖励作弊相比,这次问题发生在行动后果的预测上。
这也是我更愿意先让世界模型参与“考试”的原因:先帮开发者挑出值得测的驾驶或机器人方案,再拿真机结果核对。初筛不会消除模型错误,但在它的判断变成现实动作之前,我们多了一步检查的机会。
Runway 在今年 2 月的研究中模拟了 8 种机器人策略、1450 次运行,收集超过 1.6 万次人工评分。模拟与真机评分在这 8 种策略间的 Pearson 相关系数为 0.95。这是公司自行公布的单一机械臂桌面任务研究,支持的是这组策略相对表现的一致性,不是 95% 成功率,更不是驾驶安全证明。
“先当考官”于是有了实验依据。不过,这个考官也得先考试。
拿那杯咖啡,给模型出一道真题
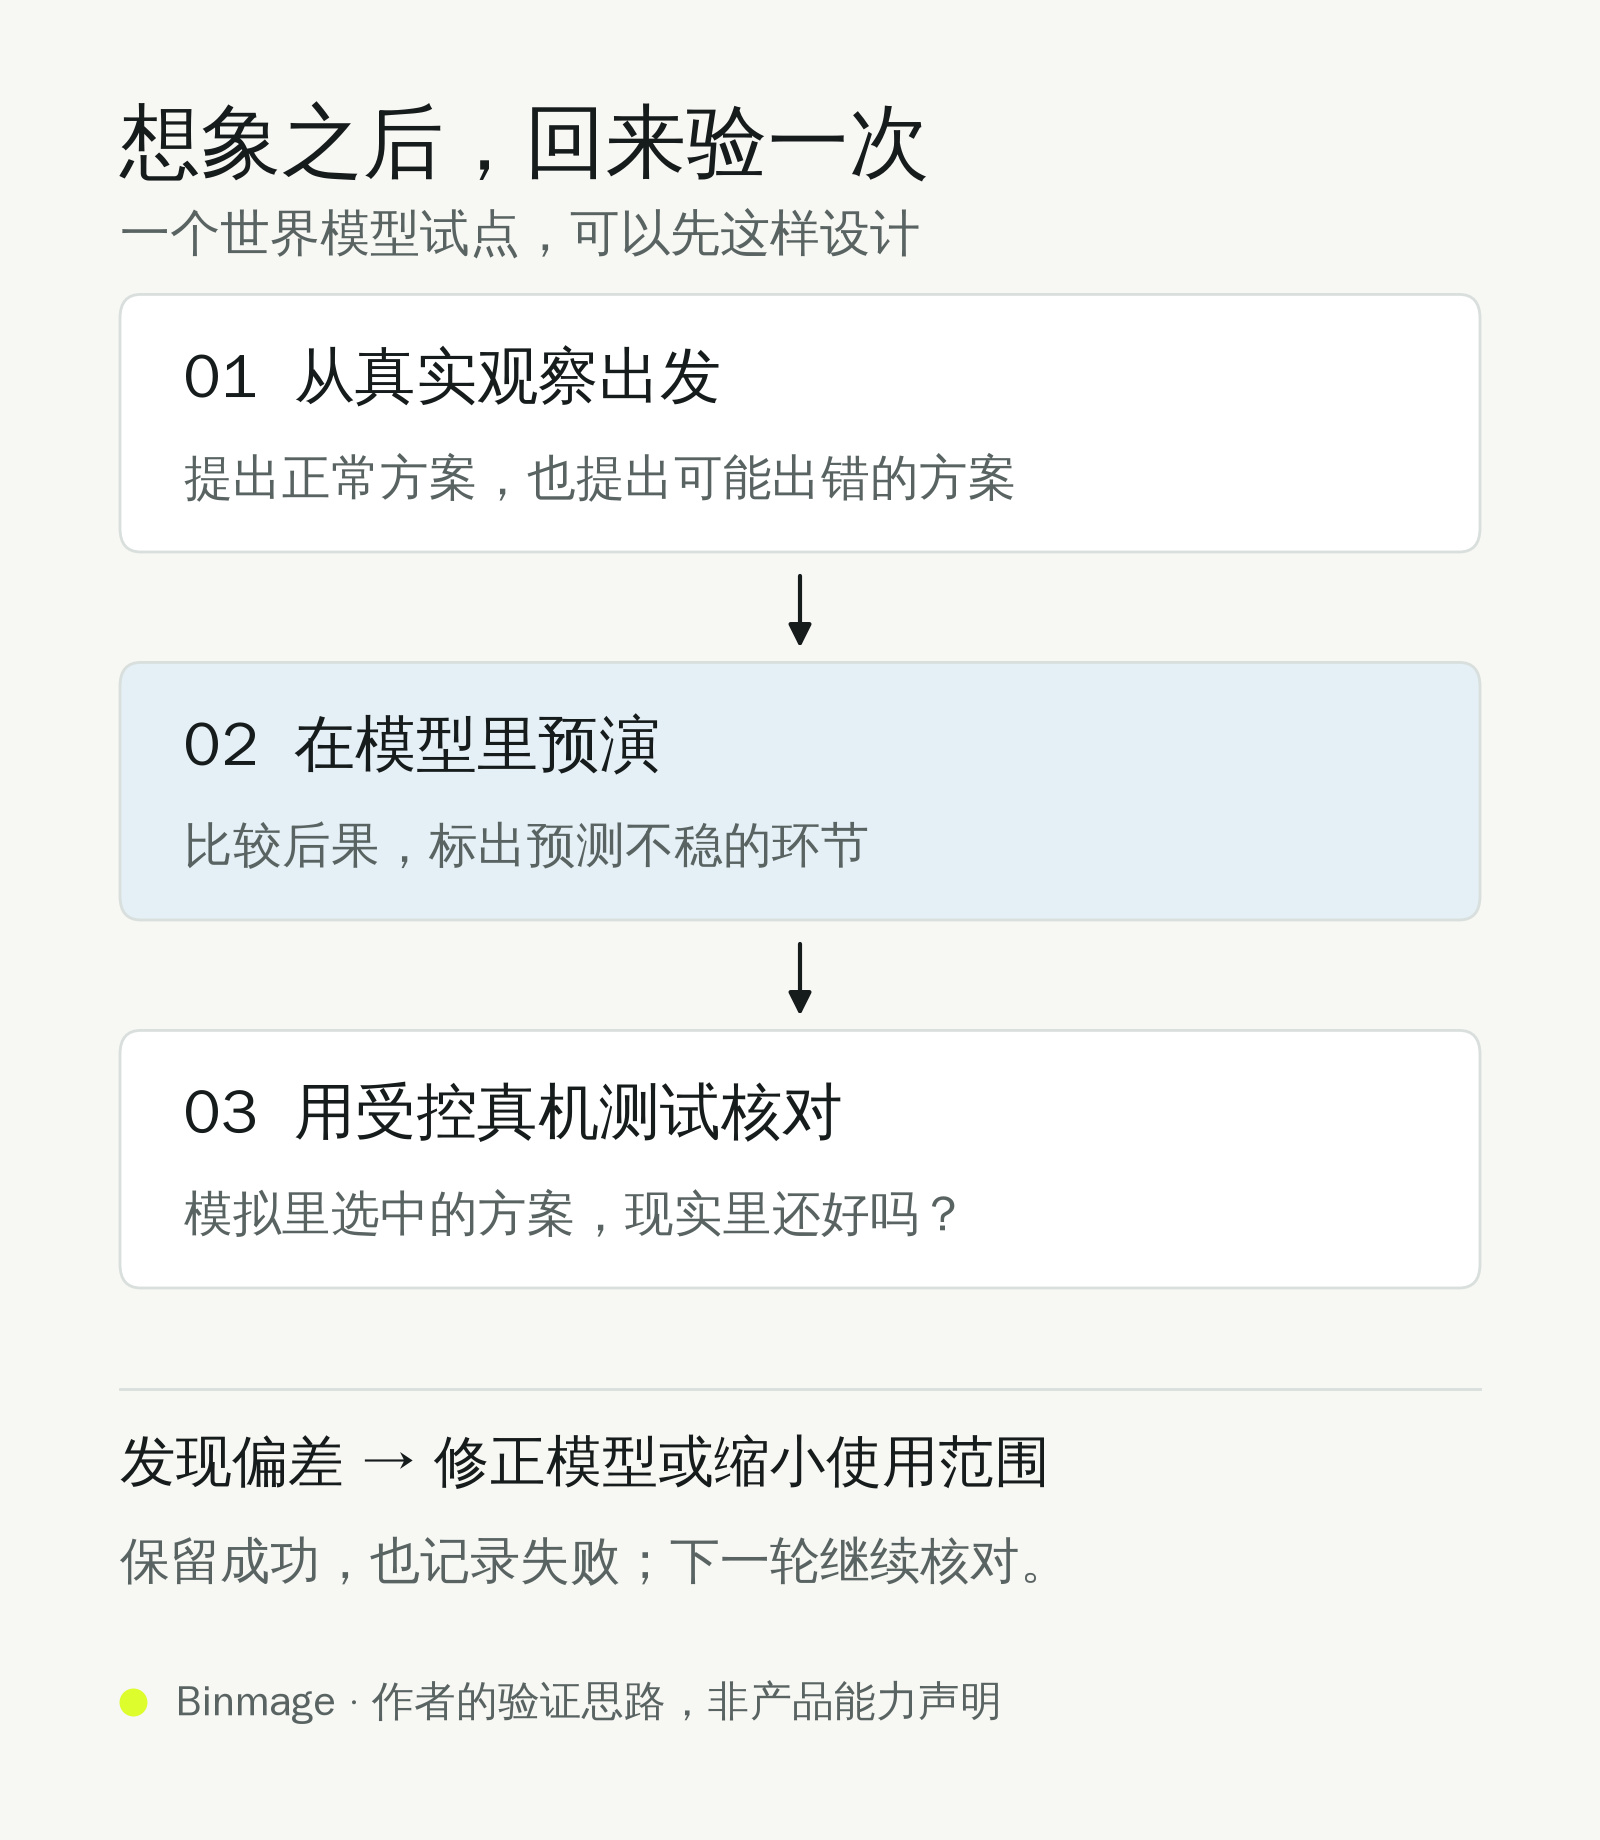
假设团队准备比较三版机械臂程序,任务都是把杯子放进托盘。先用旧版本的真机记录调好评测方法,把这三版程序,以及新的杯子位置、装水量留作考题。
让模型先打分、排序,记下它推荐谁,再在有防护的台面上,用相同起始条件重复做真机测试。预测必须留在答案揭晓之前。最初这轮验证省不了多少测试费,得先证明它筛得准,后面才谈节省预算。
杯子掉没掉、洒没洒、任务完成了没有、用了多久,要分别记。会弄坏东西的方案,不能靠速度快把分数补回来。
开始用模型初筛之后,还要随机抽查被它淘汰的方案。只测推荐的版本,就不知道它错杀了多少好方案。模型一旦决定“什么值得测”,验证数据也会受它影响。漏掉这一步,筛选工具很容易变成替自己证明正确的工具。
换了夹爪、杯子材质或使用环境,旧成绩是否还有效,也得重新核对。最后算总账:少做的真机测试,能否抵过模型推演、人工复核与误判返工?如果省不下来,就没有必要为了“用了世界模型”而保留这道工序。
那些不漂亮的失败记录,可能更值得留下
特斯拉那场演讲里还有一个细节:训练世界模拟器时,并不只需要优良驾驶。糟糕的驾驶操作也有用,因为模拟器需要学会这些动作会带来什么后果。教车怎么开好,和教模型坏开法会出什么事,需要的数据并不完全一样。
这也让我重新看了一眼 RoboJEPA 的数据表。在团队收集并核验的数据中,智元相关的 AgiBot World 提供了 8036 小时视频,占总计 15022 小时的约 53.5%。多机位会累计多份视频;按动作时长算,则是 2734 / 6692 小时,约 40.9%。这些占比不等于训练采样权重,更不能换算成模型能力贡献率,但足以说明国内真实交互数据是这项研究的重要来源。
接下来值得积累的,我认为还包括:哪次抓空了,哪里接触出了错,补救有没有用。把动作和传感器记录对齐,让失败能被复盘、被授权复用,这些不太适合剪进宣传片的工作,可能比再拍一条顺利演示更能帮到模型。
回到最开始的两个愿望:游戏里,我希望 AI 能帮我少重试几次;开车时,我希望它把那些不该发生的事,尽量留在经过检验的模拟里。世界模型要走进日常生活,得让人看到这样的好处。
资料核对至 2026 年 10 月 10 日。本文依据论文、官方研究报告与技术演讲分析,未进行真机复测;GTA 6 助手、道路情景及咖啡试点为用途举例或作者构想,封面为概念插画。