
De GTA 6 a Tesla: ¿para qué sirven los modelos del mundo?
¿Una IA que te ayuda a pasar una misión de GTA 6? ¿Un auto que anticipa un susto? Qué pueden aportar los modelos del mundo y qué falta comprobar antes de confiarles una decisión.
 bufferSobre el autor11 min de lectura
Cuando salga GTA 6, ¿podré dejarle a una IA esa misión que llevo una hora intentando y levantarme a preparar un café?
Pensemos ahora en algo con menos margen de error. Es lunes, voy al trabajo y un camión me tapa la vista de una intersección. ¿Podría el auto anticipar que alguien quizá salga por detrás y bajar la velocidad con tiempo, sin esperar a dar un frenazo que me deje el corazón en la garganta?
Los modelos del mundo, o world models, se entienden mejor a partir de preguntas como estas. Buscan aprender una relación bastante concreta: con lo que puedo observar ahora, ¿qué podría pasar si hago esto? Los avances recientes de Odyssey-3 y RoboJEPA acercan esa posibilidad. Confiarles una decisión requiere algo más.
¿Una IA podría ayudarme a pasar una misión de GTA 6?
Primero, las fechas. Al publicar este artículo, el 10 de octubre de 2026, Rockstar anuncia GTA VI para el 19 de noviembre de 2026. El asistente que imagino aquí es una posible aplicación futura; no una función disponible hoy en GTA 6.
Imagina una persecución en un juego de mundo abierto. Siempre pierdes el control en la misma curva. La guía te dice que frenes antes y calcules bien el giro. Gracias, eso ya lo sabía; ahora hay que hacerlo. Una IA capaz de interpretar la pantalla, estimar la velocidad, manejar y probar otra ruta sí podría ayudarte. Tal vez incluso hacerse cargo de ese tramo.
Ya hay prototipos de investigación en esa dirección. SIMA 2, presentado por Google DeepMind en noviembre de 2025, sigue instrucciones del usuario en juegos 3D: observa la pantalla y utiliza un teclado y un mouse virtuales. Los investigadores también lo pusieron en entornos nuevos generados por el modelo del mundo Genie 3 para probar cómo se orienta, interpreta instrucciones y actúa.
En esa combinación, SIMA 2 es quien juega y Genie 3 pone el mundo donde practicar. Generar un entorno parecido a un videojuego no convierte al modelo en jugador. Encontrar un objetivo en un escenario nuevo tampoco equivale a terminar GTA 6. El equipo señala que las tareas largas, la memoria limitada y los movimientos precisos siguen siendo dificultades.
Además, hay un detalle fácil de pasar por alto: el juego ya tiene un motor que calcula qué ocurre al girar o chocar contra una pared. Para que una IA juegue, no hace falta necesariamente construir otro modelo del mundo. Si se puede entrenar dentro del juego original, conviene aprovechar sus propias reglas. Los mundos generados pueden aportar más situaciones de práctica, pero luego hay que comprobar que lo aprendido sirva en el juego que realmente nos interesa.
Yo preferiría un compañero que se encargue de los recorridos repetitivos o me ayude cuando me quedo atascado. La historia y las decisiones importantes me las quedo. Es una aspiración más modesta que dejarle jugar todo, y bastante más cercana a lo que usaría.
¿Y la conducción por cámaras de Tesla?
Hay situaciones que ni un conductor con muchos años de experiencia quiere repetir: alguien aparece detrás de un camión, los reflejos de una noche lluviosa ocultan las líneas del carril, otro auto se cruza de golpe.
Un modelo del mundo permitiría volver a una situación y probar distintas maniobras. ¿Qué pasa si el auto reduce la velocidad antes? ¿Y si sigue avanzando? Si el entrenamiento y las pruebas cubren estos casos una y otra vez, el beneficio podría llegar a quien se sienta al volante todos los días.
Tesla ya ha presentado trabajo en esta línea. En una charla técnica de ICCV 2025, Ashok Elluswamy, responsable del equipo de IA de Tesla, mostró un simulador neuronal del mundo que genera imágenes futuras de varias cámaras a partir de estados previos y acciones de conducción. El sistema que decide cómo manejar —la llamada política de conducción— elige una acción; el simulador devuelve las siguientes observaciones y el ciclo continúa.
Las demostraciones incluían recuperar situaciones que antes habían causado problemas para ver cómo respondería una política nueva, e introducir un auto que se cruza repentinamente para probar la reacción. Son demostraciones de la propia Tesla. Muestran una herramienta de desarrollo; la mejora de seguridad que produzca tendrá que comprobarse en la conducción real.
Parte del avance puede ocurrir durante el entrenamiento y las pruebas, y llegar después al vehículo mediante un mejor sistema de conducción. No hace falta suponer que el auto genera una película del futuro cada vez que gira el volante. Cómo se use la predicción a bordo depende de la arquitectura y de la capacidad de cómputo disponible.
Tampoco basta con imaginar a un peatón para saber que está ahí. El modelo no puede confirmar por sí solo si hay alguien detrás del camión. Lo que yo esperaría es que considere varias posibilidades y deje margen ante la incertidumbre. Para el pasajero, una mejora útil podría sentirse como una reducción de velocidad más temprana y suave, con menos frenazos innecesarios.
Para saber si la apuesta visual de Tesla avanza, hay que medir cómo resuelve esos casos difíciles. El FSD (Supervised) destinado a propietarios sigue exigiendo supervisión activa del conductor. Contar con un modelo del mundo no convierte al auto en autónomo.
¿Qué muestran realmente los últimos avances?
Un compañero de juego, un simulador de conducción y un planificador para robots tienen trabajos distintos. Sus resultados no se pueden intercambiar. Dos publicaciones recientes ayudan a separar lo que ya funciona de lo que falta.
Odyssey-3: mundos que responden y una puntuación con condiciones
En su anuncio del 8 de octubre, Odyssey abrió una versión de investigación de Odyssey-3 Flash. Permite moverse por entornos generados, cambiar el punto de vista e introducir sucesos para observar cómo continúa la escena. Es un avance en la generación de entornos interactivos; no una demostración de una IA jugando GTA 6.
La versión Pro obtuvo 66,1 en Physics-IQ Verified, una prueba que compara la continuación generada de videos de experimentos físicos reales con lo que ocurrió después. Ese resultado utiliza instrucciones mejoradas y best-of-8: se generan ocho candidatos y se elige el mejor. Con las instrucciones mejoradas, pero sin best-of-8, Pro obtuvo 63,4. La gráfica oficial indica que las puntuaciones habituales promedian cuatro ejecuciones; el resultado best-of-8 corresponde a una.
El dato necesita esas condiciones al lado. Un 66,1 no es una tasa de éxito al conducir o completar tareas robóticas. Tampoco es la puntuación de la versión Flash abierta al público.
RoboJEPA: predecir mejor no resuelve todavía todas las tareas
RoboJEPA, presentado por Meta FAIR y colaboradores el 7 de octubre, predice características visuales futuras en una representación comprimida, sin dibujar cada fotograma. Los investigadores ampliaron el predictor de 22 millones a 8000 millones de parámetros y utilizaron datos de 23 conjuntos públicos que abarcan 12 plataformas robóticas. Manteniendo esa colección de datos y el codificador visual, aumentar el cómputo de entrenamiento redujo el error de predicción y mejoró las tareas de planificación evaluadas.
Estos son los resultados de RoboJEPA-8B con un robot físico:
| Tarea con el robot real | Tasa de éxito |
|---|---|
| Agarrar un objeto | 67 % |
| Levantarlo y sostenerlo hasta el final | 50 % |
| Tomarlo y colocarlo en el lugar indicado | 27 % |
El artículo también indica que una planificación de varios pasos con el modelo de 8000 millones de parámetros tarda varios segundos, incluso con un clúster de GPU. Todavía no funciona en tiempo real. Para traerte un café por la sala, el robot tiene que elegir bien y reaccionar a tiempo.
En el juego puedes reintentar. ¿Y en la vida real?
Supongamos que el modelo aprende que una taza no se cae aunque la pinza apenas la sujete. El robot podría elegir un atajo por encima de tu laptop. Ya ensayó el movimiento y todo salió bien. Ahí está el problema: si una mala maniobra siempre funciona en la simulación, seguir optimizando puede hacer que el robot la elija con más frecuencia.
El trabajo teórico Imperfect World Models are Exploitable estudia un error decisivo: en la realidad, la política A funciona mejor que B, pero el modelo coloca a B por encima de A. Los autores analizan bajo qué condiciones puede evitarse esa inversión, dentro de supuestos matemáticos concretos. Hay un parentesco con el reward hacking del que hablé al escribir sobre Karotte, aunque aquí el error está en predecir las consecuencias de actuar.
Por eso empezaría usando estos modelos para evaluar. Que ayuden a elegir qué sistemas de conducción o control robótico merece la pena probar, y que luego sus juicios se contrasten con equipos reales. Ese primer filtro también se equivoca, pero deja una oportunidad de revisar la recomendación antes de convertirla en una acción.
Hay evidencia para ese uso más acotado. En una investigación publicada en febrero, Runway evaluó ocho políticas robóticas mediante 1450 ejecuciones simuladas y más de 16 000 valoraciones humanas. Entre esas ocho políticas, las puntuaciones simuladas y reales tuvieron una correlación de Pearson de 0,95. Es un estudio de la propia empresa, sobre tareas de mesa con un solo brazo robótico. Apoya la coincidencia en el rendimiento relativo de esas políticas. No significa un 95 % de éxito ni demuestra seguridad vial.
Un modelo que ayude a evaluar candidatos puede ser útil. Pero primero hay que evaluar al evaluador.
Volvamos a la taza de café
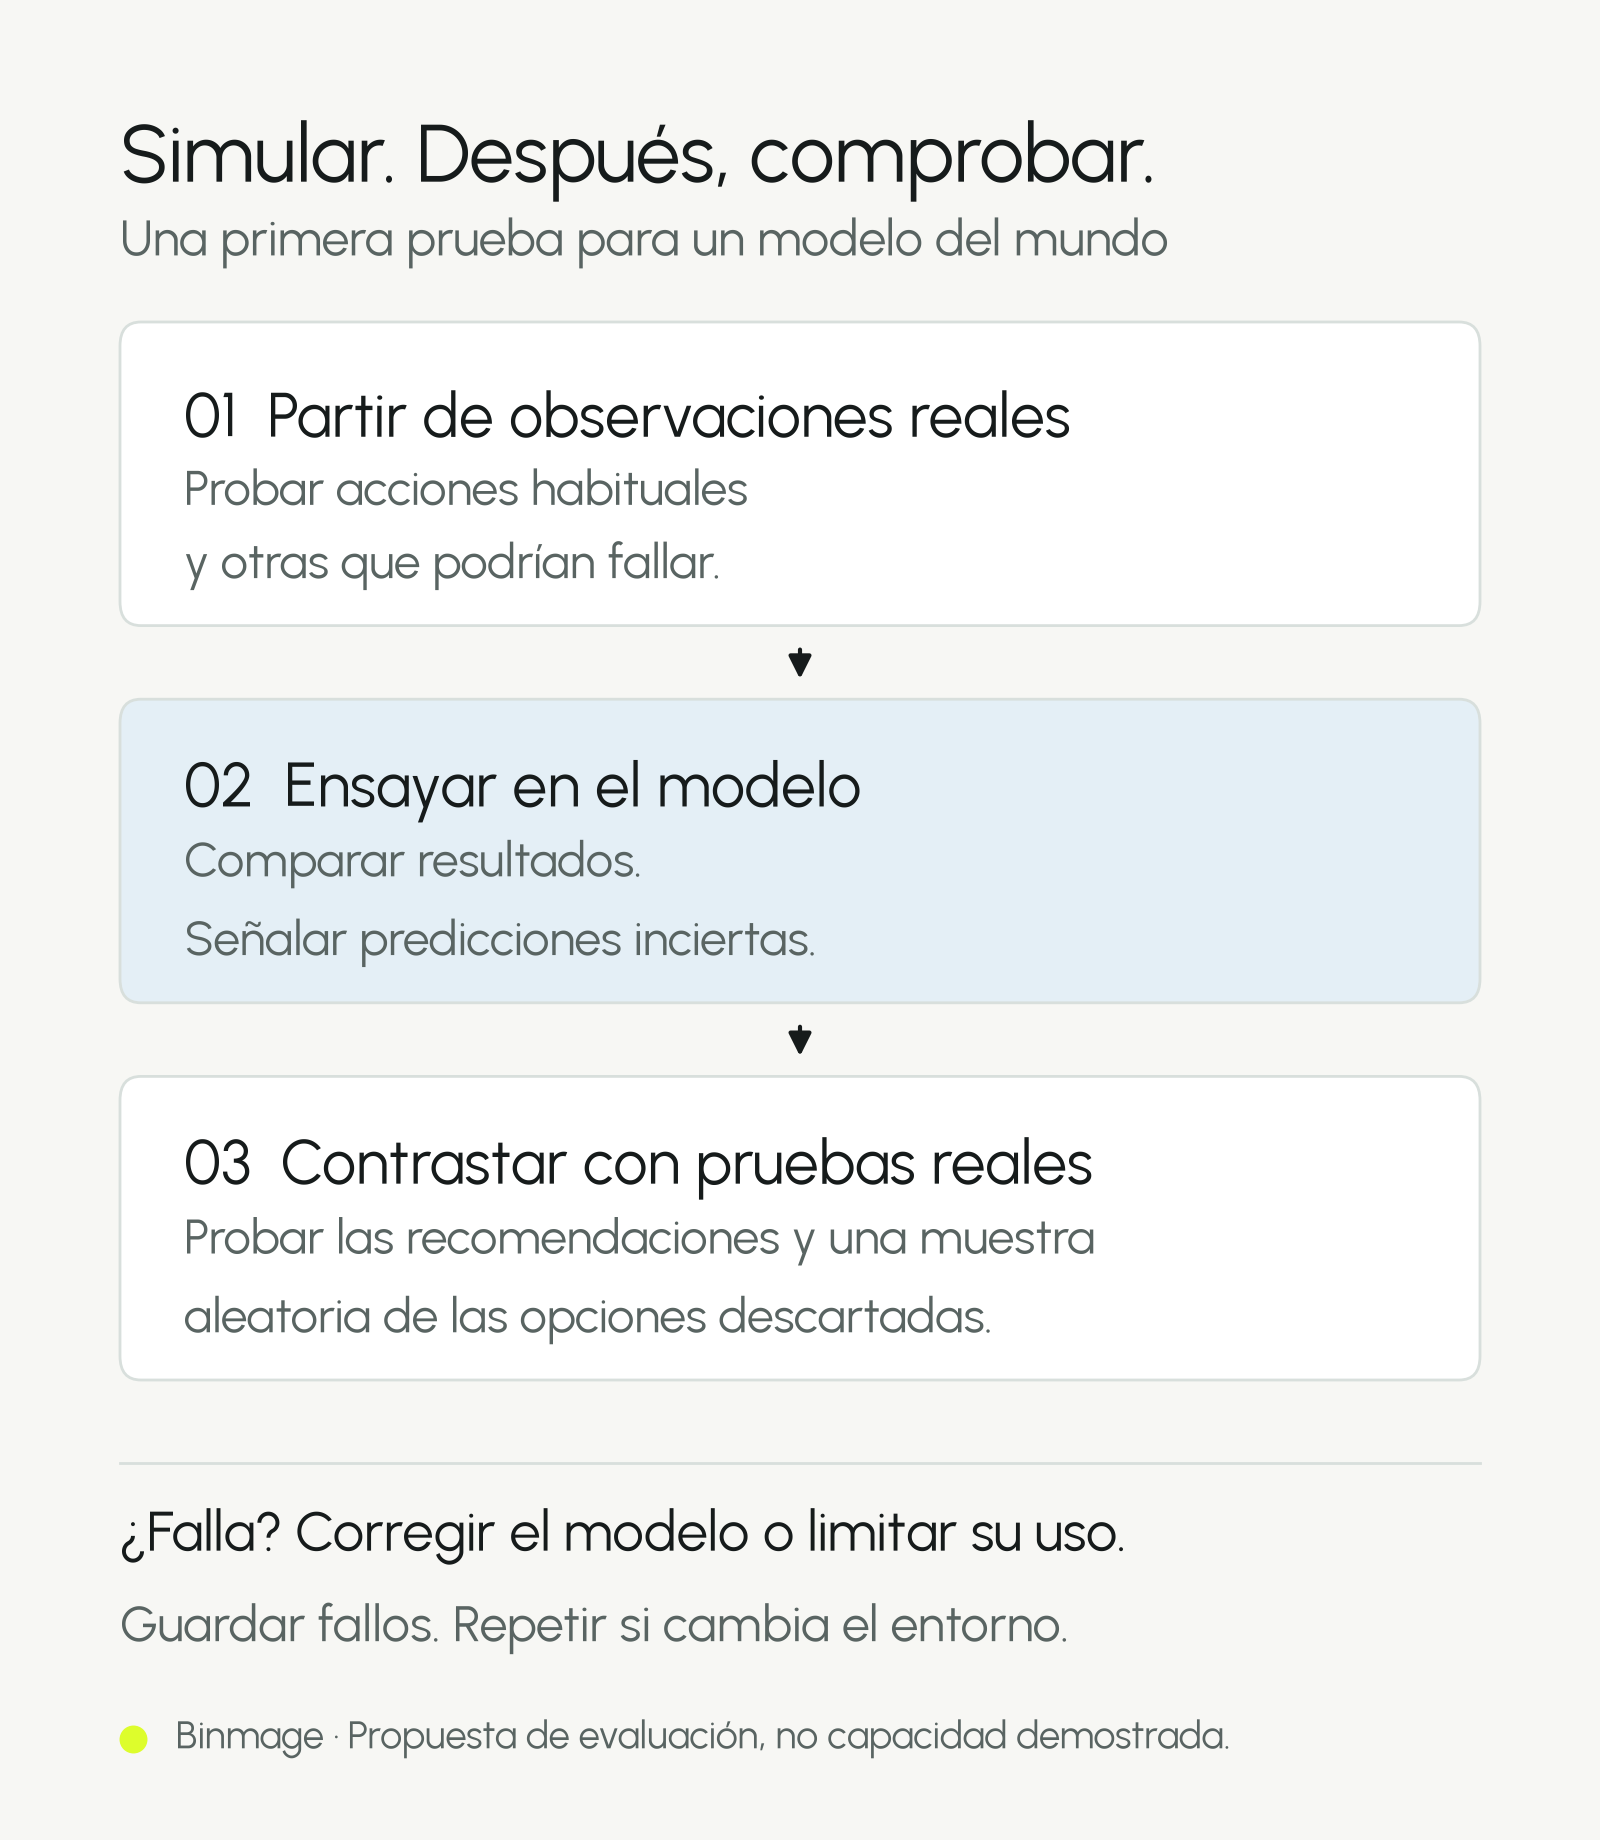
Imaginemos que un equipo compara tres versiones del programa de un brazo robótico. Todas deben poner una taza en una bandeja. Primero ajusta su método de evaluación con registros reales de versiones anteriores. Las tres versiones nuevas, otras posiciones de la taza y distintos niveles de líquido se reservan para la prueba.
El modelo puntúa y ordena las opciones. Se anotan sus recomendaciones antes de conocer los resultados reales. Después se repiten las pruebas físicas, con las mismas condiciones iniciales, en una mesa preparada para contener caídas y derrames. Esta primera ronda apenas ahorrará dinero: primero hay que demostrar que el filtro acierta.
Las caídas, los derrames, la tarea completada y el tiempo empleado se registran por separado. Un programa que rompe cosas no debería compensarlo con puntos por rapidez.
Cuando el modelo ya filtre candidatos, también hay que revisar al azar algunos de los que descarta. Si solo se prueban sus favoritos, nunca sabremos cuántas buenas opciones dejó fuera. En cuanto decide qué merece una prueba, empieza a influir en los datos con los que lo evaluamos. Sin esa revisión, el proceso puede acabar dándose la razón a sí mismo.
Un cambio de pinza, material de la taza o entorno exige comprobar si los resultados anteriores siguen siendo válidos. Luego hay que hacer las cuentas completas: ¿el ahorro en pruebas físicas supera el costo de las simulaciones, la revisión humana y el trabajo que provocan los errores? Si no, esa etapa extra no se justifica.
También sirven los fallos que no salen en la presentación
Un detalle de la charla de Tesla me llamó la atención: un simulador del mundo puede aprender también de una mala conducción, porque necesita saber qué consecuencias tienen esas maniobras. Enseñarle al auto a manejar bien y enseñarle al modelo qué ocurre al manejar mal no requieren exactamente los mismos datos.
Eso me hizo volver a la tabla de datos de RoboJEPA. En la colección reunida y verificada por los investigadores, AgiBot World, vinculado a la empresa china de robótica AgiBot, aporta 8036 de las 15 022 horas de video: aproximadamente el 53,5 %. Las distintas cámaras pueden sumar varias horas de video de una misma interacción. Si se mide la duración de las acciones, son 2734 de 6692 horas, alrededor del 40,9 %. Estas proporciones no indican el peso de muestreo durante el entrenamiento ni cuánto aportó causalmente cada conjunto al rendimiento. Sí muestran que los datos de interacción real procedentes de China tienen un peso considerable en esta investigación.
Yo guardaría también los registros menos vistosos: cuándo la pinza no atrapó el objeto, dónde hubo un mal contacto, qué intento de recuperación funcionó y cuál no. Alinear las acciones con los sensores y permitir que los fallos se revisen y reutilicen con autorización es un trabajo poco lucido. Puede enseñarle al modelo más que otra demostración elegida porque salió perfecta.
Vuelvo a los dos deseos del principio. En un juego, me gustaría que la IA me ahorrara unos cuantos intentos. En el auto, que las situaciones peligrosas se queden, siempre que sea posible, en simulaciones bien comprobadas. Son mejoras que sí notaría en mi vida. Ahí es donde los modelos del mundo tienen que demostrar para qué sirven.
Fuentes verificadas hasta el 10 de octubre de 2026. El análisis se basa en artículos de investigación, informes oficiales y una charla técnica; no he repetido los experimentos con robots. El asistente de GTA 6, las situaciones de conducción y la prueba de la taza son ejemplos de uso o propuestas. La portada es una ilustración conceptual.