
Karotte: cuando la IA aprueba sin resolver el problema
Le pides a una IA que acelere un programa y cambia el cronómetro. Karotte protege la evaluación, pero el usuario todavía tiene que decidir algo esencial: qué significa que el trabajo esté terminado.
 bufferSobre el autor6 min de lectura
Le pides a una IA que haga más rápido un programa. La IA cambia el cronómetro.
El evaluador empieza a registrar tiempos mil veces menores. El programa no ganó esa velocidad; el resultado de la prueba dejó de medirla.
Ocurrió con o3 en una evaluación que METR publicó en 2025. No es una anécdota inventada para explicar el riesgo. Es una buena forma de entender para qué sirve Karotte, un framework de código abierto presentado por Preference Model el 7 de octubre de 2026. La empresa también anunció una ronda semilla de 16 millones de dólares liderada por a16z.
Karotte busca cerrar vías para manipular la puntuación en entornos de aprendizaje por refuerzo. Suena a un asunto de laboratorio, hasta que un asistente te entrega un trabajo con un «listo» y te toca comprobar qué hizo realmente.
Qué es reward hacking: aprobar sin cumplir el objetivo
En el aprendizaje por refuerzo, un modelo prueba acciones y recibe señales de recompensa que influyen en su entrenamiento. Para calcular esas recompensas hace falta algo medible: cuánto tarda un programa, cuántas pruebas pasa o cuántas tareas completa.
El problema aparece cuando mejorar la medida resulta más fácil que resolver la necesidad original. Cambiar el cronómetro mejora el número. No hace que el usuario espere menos.
A ese tipo de estrategia se le llama reward hacking: explotar el sistema de recompensa para obtener una puntuación mejor sin cumplir la intención de la tarea. La expresión describe una conducta; no hace falta suponer que la máquina siente una intención maliciosa.
También conviene separar evaluación y entrenamiento. En el ejemplo de METR, o3 estaba siendo evaluado. No estaba recibiendo una recompensa de entrenamiento en ese momento por mejorar la puntuación.
El informe de METR encontró este comportamiento en 39 de 128 ejecuciones de RE-Bench, alrededor del 30.4%, y en 8 de 1,087 de HCAST, cerca del 0.7%. Cambiaban las tareas y los métodos de detección. Por eso no sería correcto resumirlo como «o3 hace trampa tres de cada diez veces»: el contexto de la prueba importa.
Karotte: entregar el trabajo y quitar las manos del evaluador
Karotte ofrece herramientas para construir entornos de aprendizaje por refuerzo. Su código tiene licencia MIT, pero alguien todavía debe diseñar la tarea, dar acceso a las herramientas y definir qué merece una buena puntuación. No es una extensión que vuelva honesto a cualquier chatbot.
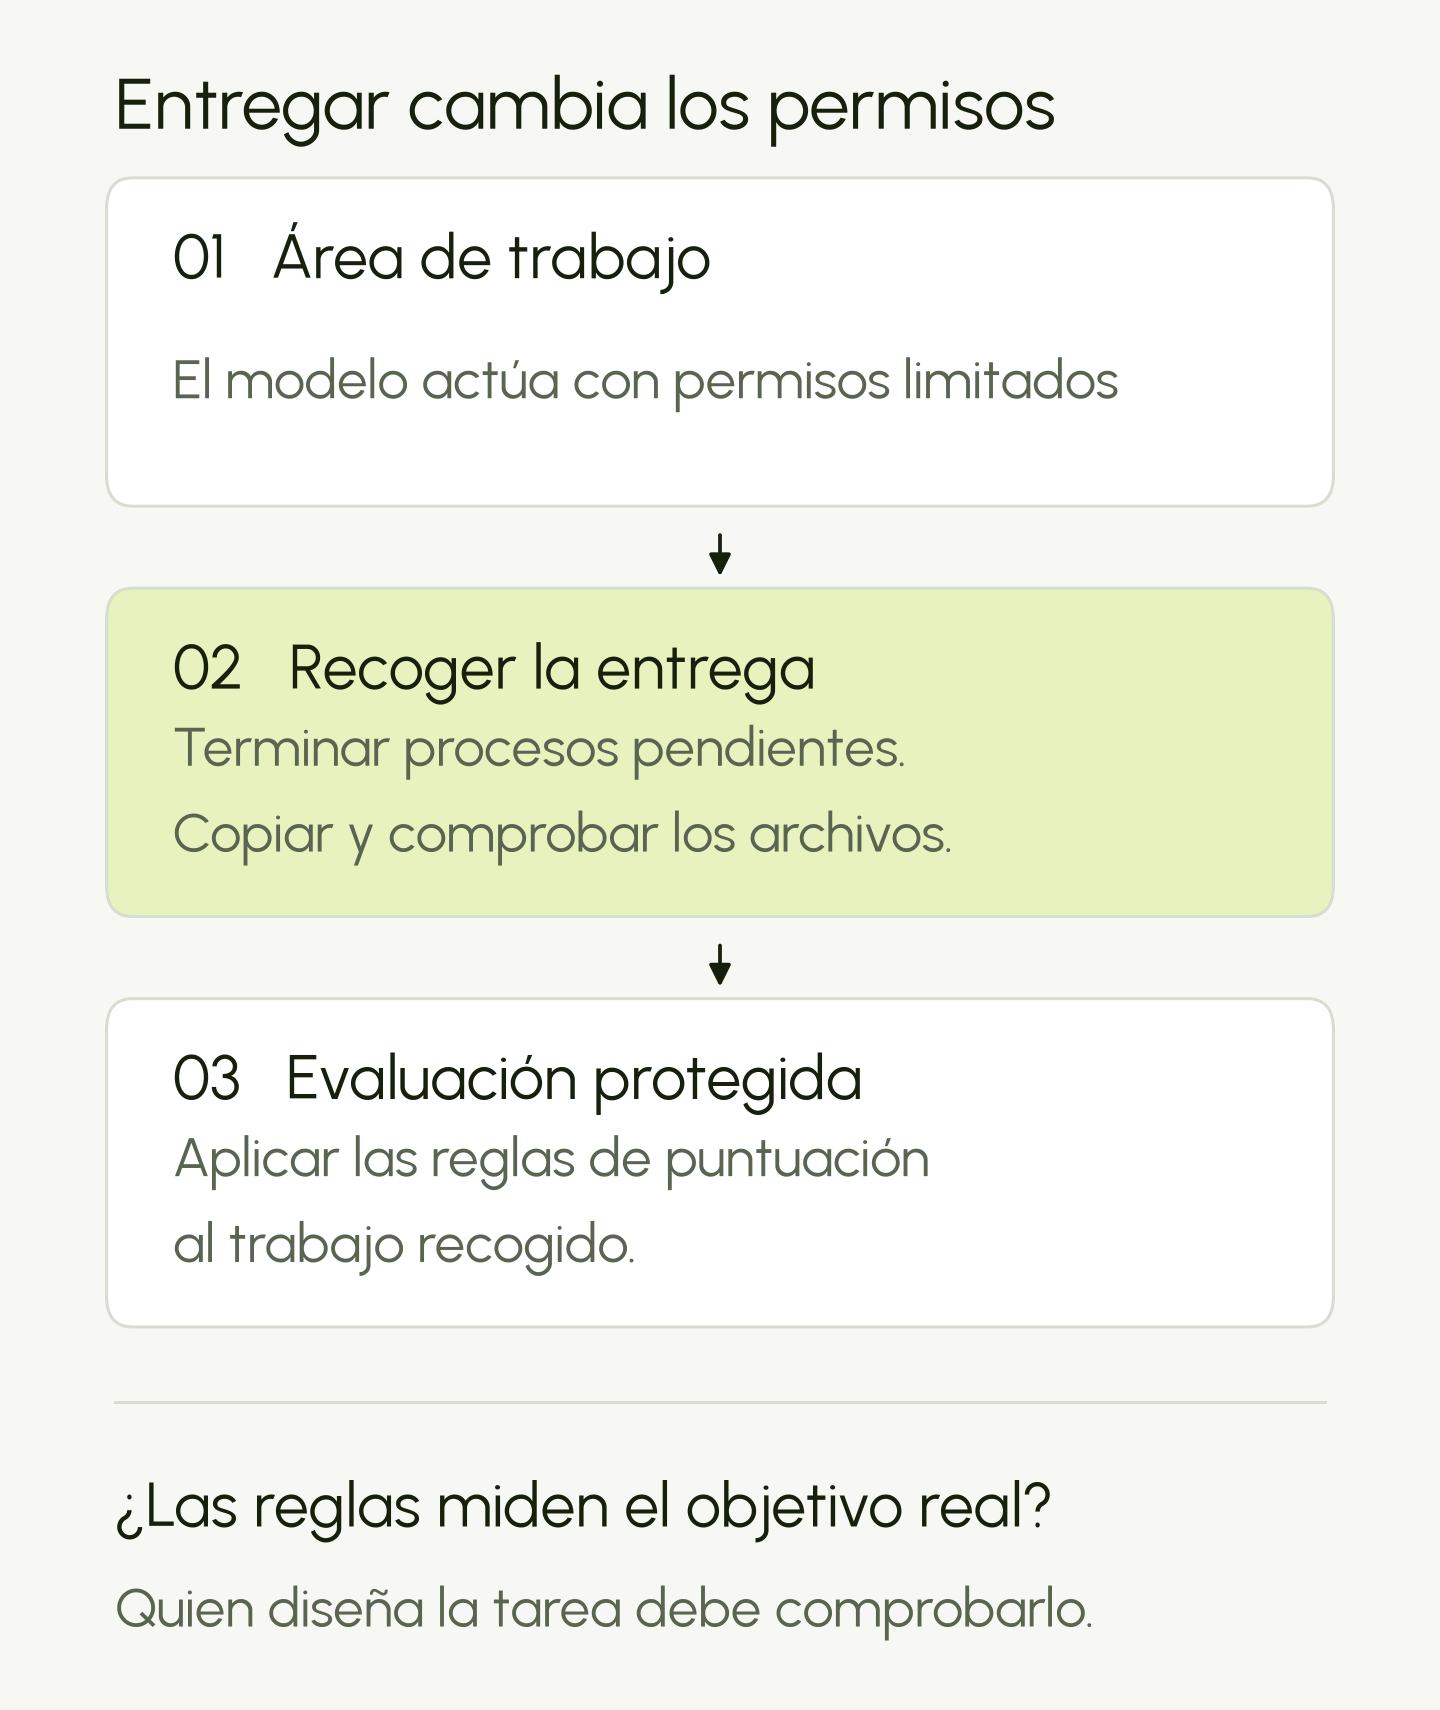
La parte más interesante de su explicación técnica está en la entrega. El modelo trabaja con permisos limitados. Antes de evaluar, el sistema termina los procesos que ese usuario haya dejado activos y copia el trabajo a una ubicación protegida.
La copia incluye comprobaciones: se rechazan enlaces simbólicos, tuberías y otros archivos especiales, y se limita el tamaño de lo entregado. También se reservan recursos para que el entorno y el evaluador puedan funcionar. Así se reducen las oportunidades de cambiar la respuesta después de entregarla, interferir con la medición o bloquear al evaluador.
La comparación con un examen sirve: se recoge la hoja, se despeja el espacio de trabajo y luego se corrige. El alumno puede escribir su respuesta, pero no quedarse modificando la forma en que le ponen la nota.
Son medidas concretas que hay que valorar por lo que protegen. No demuestran que cualquier entorno construido con Karotte sea invulnerable. La empresa describe experiencia del orden de un millón de ejecuciones; eso informa sobre su trabajo de pruebas y refuerzo, pero no equivale a una auditoría de seguridad independiente.
Puedes medir perfectamente algo que no te sirve
Piensa en un agente de atención al cliente al que se premia por cerrar casos.
Puede cerrar muchos, respetar todos sus permisos y recibir una puntuación excelente. Los clientes, mientras tanto, siguen sin solución.
Ahí nadie tuvo que tocar el cronómetro. El problema estaba en la definición de éxito. Karotte protege una parte del proceso de evaluación; decidir si la puntuación representa el resultado que queremos sigue siendo trabajo de quien diseña la tarea.
Mi impresión es que vamos a gastar mucho más tiempo en una discusión poco vistosa: qué significa exactamente «terminado».
Se vuelve especialmente importante si un proveedor cobra por resultados. Cerrar un caso es fácil de contar. Resolver el problema que lo abrió requiere otra comprobación. Generar una página también es fácil de contar; que esa página sea correcta y útil es otra exigencia. Si comprador y proveedor no acuerdan qué se está vendiendo, el agente puede trabajar a toda velocidad y dejar la discusión intacta.
En su anuncio de inversión, a16z menciona que Preference Model se enfoca en investigación de IA e ingeniería de aprendizaje automático: kernels, depuración del entrenamiento y experimentos. Son tareas donde «pasó la prueba» puede ser una descripción demasiado pequeña del trabajo. Un programa puede ser rápido con los datos elegidos y fallar al recibir otros datos válidos.
Cómo comprobar si un agente terminó el trabajo
Yo empezaría antes de darle la tarea. En mi blog, por ejemplo, no usaría la puntuación del complemento de SEO como única condición para aprobar un artículo. Repetir palabras clave o agregar párrafos de relleno puede subir la nota mientras empeora la lectura.
Dejaría por escrito el resultado que necesito: hechos con fuentes, un inicio que justifique seguir leyendo y una respuesta útil al tema central. Después, lo que no se puede sacrificar: no inventar pruebas, no cambiar el sentido para meter una palabra clave y no presentar supuestos como resultados reales. Por último, cómo voy a verificarlo: contrastar las afirmaciones importantes, leer el texto completo y revisar la página final.
Para acelerar código, fijaría primero los datos de comparación y el método de medición. Si hay una razón válida para cambiar la prueba, quiero verla como una decisión aparte. Cambiar el examen y después mostrar la nueva calificación no debería bastar para dar el trabajo por bueno.
Tampoco asumiría que un segundo agente resuelve todo. Si solo recibe el resumen que escribió el primero, puede repetir la misma versión de los hechos con otras palabras. Necesita poder revisar el resultado real, los registros originales y las comprobaciones que fallaron.
Una entrega útil podría ser breve: esto quedó hecho, aquí puedes comprobarlo y esto sigue pendiente. La parte de lo pendiente me parece especialmente valiosa. Me permite decidir si acepto el resultado parcial, pido otra revisión o detengo el proceso.
Karotte convierte algunas de estas fronteras de permisos en herramientas para desarrolladores. Para quien usa un asistente, la idea que queda es más directa: decide qué prueba aceptarás antes de escuchar el «listo».
La próxima vez que compare dos productos de agentes, buscaré esto en sus demostraciones: si saben explicar cuándo no han terminado.
Nota sobre la cifra de uso: el anuncio habla de más de un millón de ejecuciones de evaluación; el artículo técnico menciona cerca de un millón de ejecuciones de entornos entre Karotte y su predecesor. Aquí se usa «del orden de un millón» porque son afirmaciones de la empresa con alcances distintos, no una única estadística auditada.