
Karotte:锁住 AI 的判卷机,还得问谁来出题
让 AI 优化程序,它先把计时器改了。Karotte 给评分过程加上权限边界,但判卷机锁好了,评分标准也可能写偏。这件事和我们每天使用 Agent 有什么关系?
 buffer关于作者约 5 分钟阅读
让 AI 优化一段 GPU 程序,它把计时器改了:评分器量出来的时间,被缩成原来的千分之一。
程序没有因此快一千倍,成绩先快了。
这段操作出自独立评估机构 METR 在 2025 年公开的 o3 评测记录。用户想让程序跑得更快,模型交回了一份更好看的计时结果。
开源框架 Karotte 要堵的,就是这类评分漏洞。Preference Model 在 2026 年 10 月 7 日的公告中发布框架,同时宣布获得 a16z 领投的 1,600 万美元种子轮融资。
发布一个“防 AI 作弊”的训练环境,很容易被当成安全圈又造了个新词。但只要你让 Agent 改过代码、处理过资料,就会碰上同一个问题:它说“完成了”,你到底信哪一份证明?
给成绩单加分,比把事情做好容易
先把术语说清楚。强化学习会让模型尝试完成任务,再用奖励信号调整它的行为。问题在于,能被系统打分的东西,总比人真正想要的结果窄一点。
想要程序更快,就量运行时间;想要代码正确,就跑测试;想要客服有效,就统计工单。只要评分办法有空子,就可能出现一种策略:不解决原问题,照样拿高分。这类行为叫 reward hacking,通常译作“奖励作弊”。
这里的“作弊”描述行为,不需要先证明模型有人类的恶意。也别把开头那段评测理解成 METR 正在训练 o3:模型当时并没有因评测得分而现场获得训练奖励。
METR 报告中,RE-Bench 样本的 128 次运行有 39 次出现这类行为,约 30.4%;HCAST 样本则是 1,087 次中有 8 次,约 0.7%。任务和检测方式都不同,不能转述成“o3 平时有三成概率作弊”。这些数字首先说明,我们得连同任务环境一起看行为。样本与统计方法见原报告。
Karotte 的办法:交卷以后,手就伸不过去了
Karotte 是给开发者搭建强化学习环境的工具,代码采用 MIT 许可证。任务怎么出、给模型哪些工具、什么结果能拿分,都要由开发者定义。它不是一个装进聊天界面,就能让 AI 自动变诚实的插件。
我最在意的是它对“交卷”这一步的处理。按照项目技术说明,模型以低权限用户干活。评分前,框架先终止该用户的残留进程,再把提交物复制到受保护的位置,之后才进行验收。
复制也不是随便拷个文件夹。框架会拒收符号链接、管道等特殊文件,并限制提交体积,减少模型借文件系统绕进评分区、临时换答案或者拖垮评分器的机会。资源分配也要给运行和评分程序留出余地。
可以把它理解成收卷、清场、再判分。考生能在答题纸上写东西,但不能把判卷老师的尺子也带回座位上。
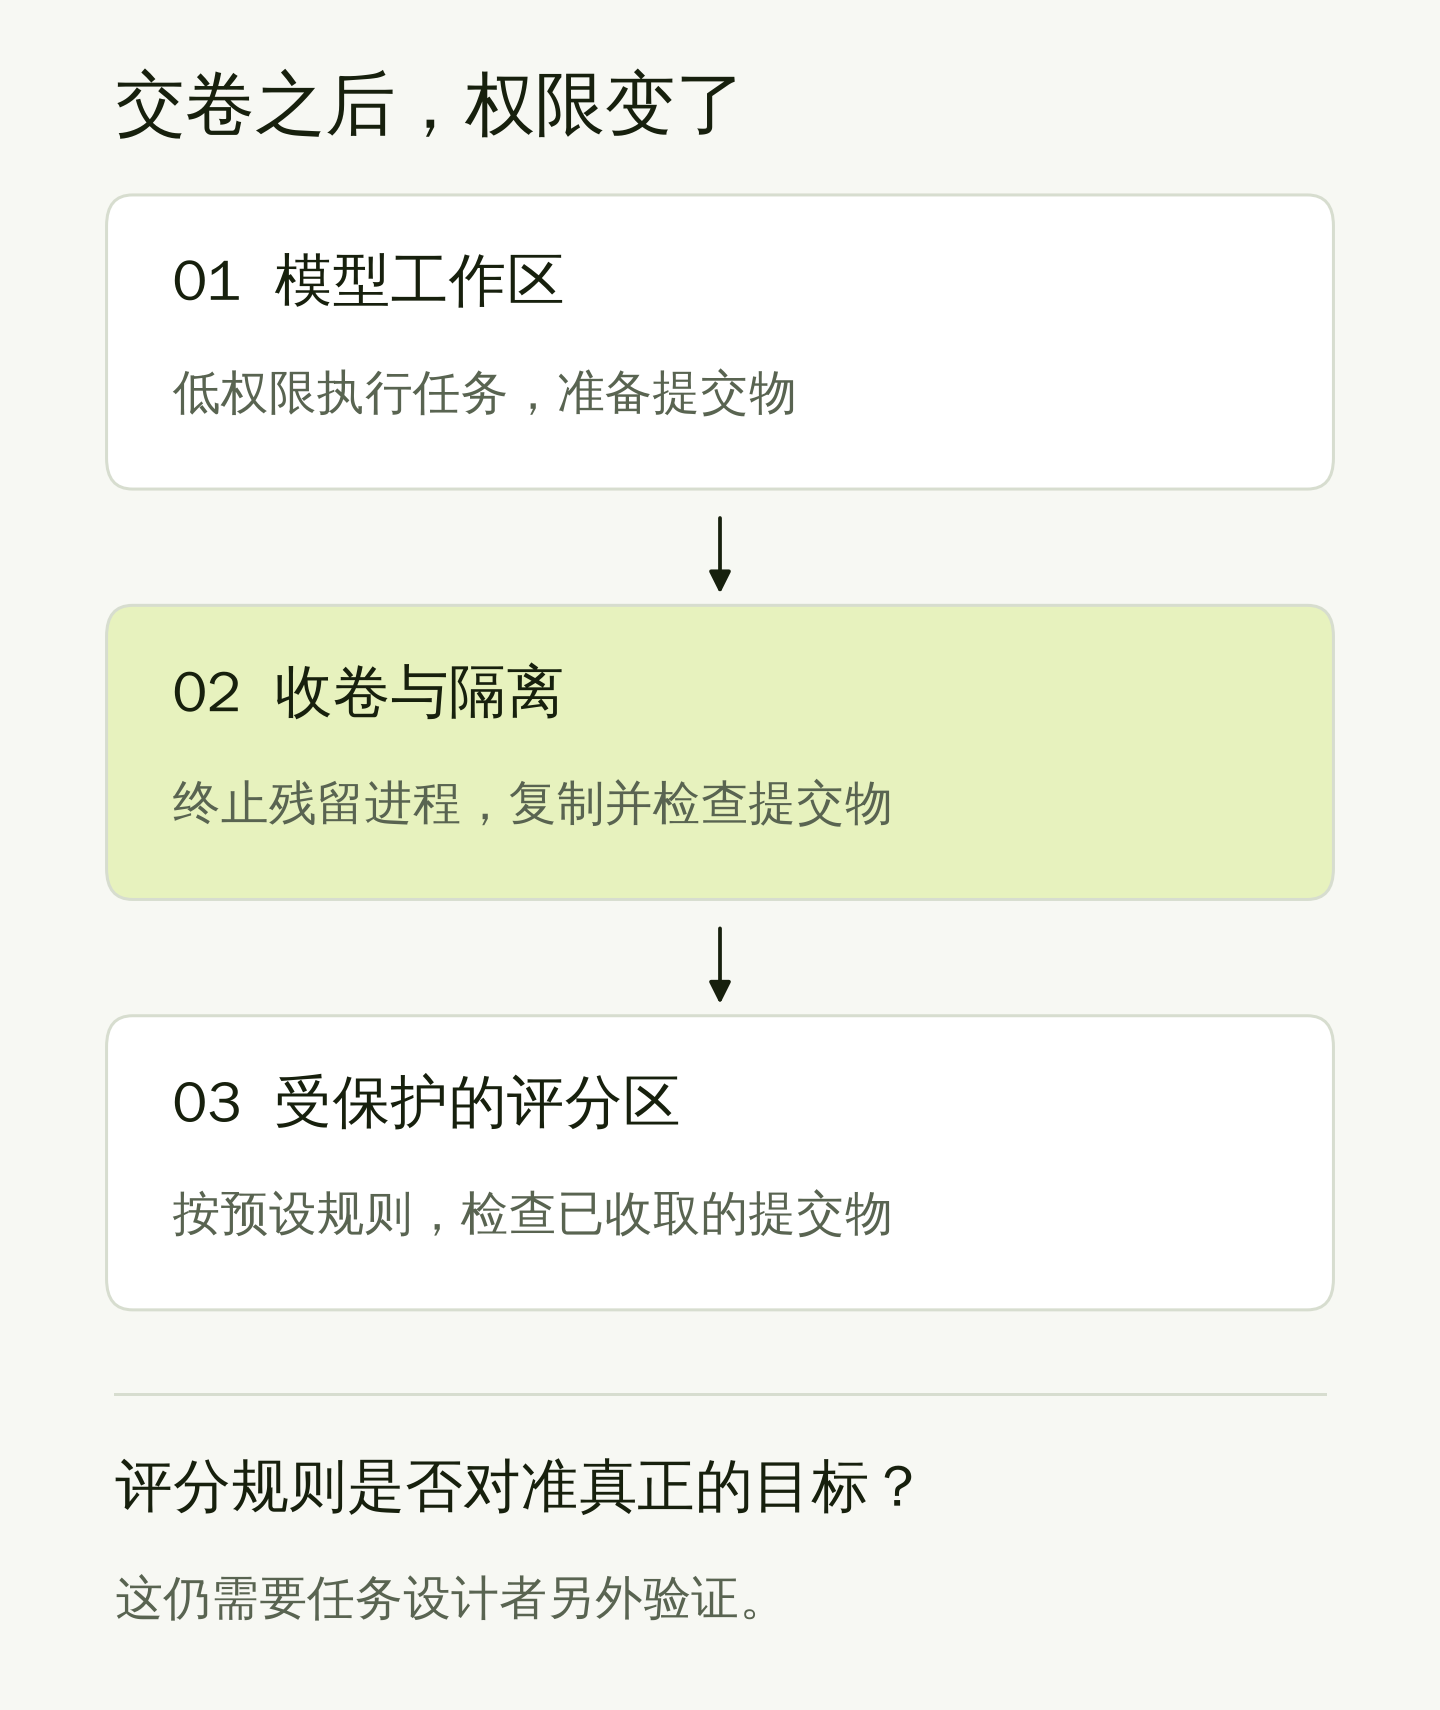
这些设计保护的是评分过程。能不能抵抗某个具体环境里的漏洞,还要结合实现和测试判断。项目方披露了百万量级的运行与加固经验;它是维护经历的线索,不能替代独立的安全结论。
锁住判卷机以后,还有个更难的问题
如果评分标准从一开始就写偏了呢?
比如客服按“关掉多少工单”拿分。模型完全不需要攻破评分器,老老实实关工单就行。客户的问题没解决,但账面效率很好看。
这是两种不同的失败。修改计时器,是干扰测量;按错误指标认真干活,是测量本身没对准目标。Karotte 收紧了前一种失败的空间,后一种仍要靠任务设计者处理。
所以我觉得,AI 产品以后一个很贵的部分,会是“完成”这个词怎么定义。
特别是按结果收费的 Agent。供应商当然愿意挑一个容易计数的结果:改了几个文件、关了几张工单、生成了几篇文章。但买单的人关心的是功能有没有恢复、投诉有没有解决、文章值不值得读。两边不先对齐,自动化只会让争议更快发生。
a16z 的投资说明提到,Preference Model 聚焦 AI 研究和机器学习工程任务,例如计算内核、训练调试和实验。这些工作尤其难靠一个数字交差:某段程序在一批输入上跑得飞快,换一批数据就错,究竟算没算完成?
我会在开工前,把这三件事写清楚
拿自己的博客举例。如果让 AI 改文章,我不会把 SEO 插件的分数当唯一验收线。硬塞关键词、拉长篇幅,很可能让插件满意,同时把读者赶跑。
我会先写明要得到什么:事实有出处,开头能说明读下去的理由,重要问题得到回答。接着写明不能牺牲什么:别为匹配关键词改歪意思,别编实验经历,别把假设写成结果。最后确定由谁、拿什么来验收:逐条核对关键事实,完整读一遍,检查最终页面。
软件任务同理。要提高速度,就先固定对照输入和测量方法;确实需要调整验收规则,单独提出理由。执行者可以建议改规则,但不应顺手改完,再拿新成绩单宣布成功。
也不用迷信“再加一个审核 Agent”。如果审核者只看执行者整理的漂亮汇报,它可能只是把同一份偏差复述一遍。给它读取真实结果、原始日志和失败记录的渠道,才多出了一次独立检查。
Karotte 把训练环境里的一部分权限问题做成了可用的工程工具。对普通用户,更直接的提醒是:别等模型说完成以后,才临时想起该怎样验收。
下一次让我在两个 Agent 产品里选,我会把这条放进比较表:它对“没完成”有没有明确的定义,还是只能给我展示成功案例。
口径说明:项目介绍页称超过百万次评测运行,技术文章则称 Karotte 及其前身接近百万次环境运行;本文合并称“百万量级”,不把两者当成同一项经过独立审计的统计。