

Selected model is at capacity en Codex: qué significa y 5 pasos fáciles para probar
"Selected model is at capacity. Please try a different model." no es tu límite de uso. Qué significa el error de Codex según su código, qué dijo OpenAI, por qué octubre de 2026 fue tan malo y 5 pasos fáciles para probar.
 bufferSobre el autor7 min de lectura
La primera vez que Codex me paró con «Selected model is at capacity. Please try a different model.», pensé que me había quedado sin cuota. No era eso. Mi página de uso todavía tenía bastante margen, y este mes mucha gente en GitHub ha pasado por la misma confusión. Así que revisé el código de Codex, la página de estado de OpenAI y lo que ha dicho el equipo de OpenAI, y aquí solo pongo lo que pude comprobar.
Qué significa «Selected model is at capacity»
Significa que OpenAI se está quedando sin servidores para el modelo que elegiste. No tiene que ver con tu cuota.
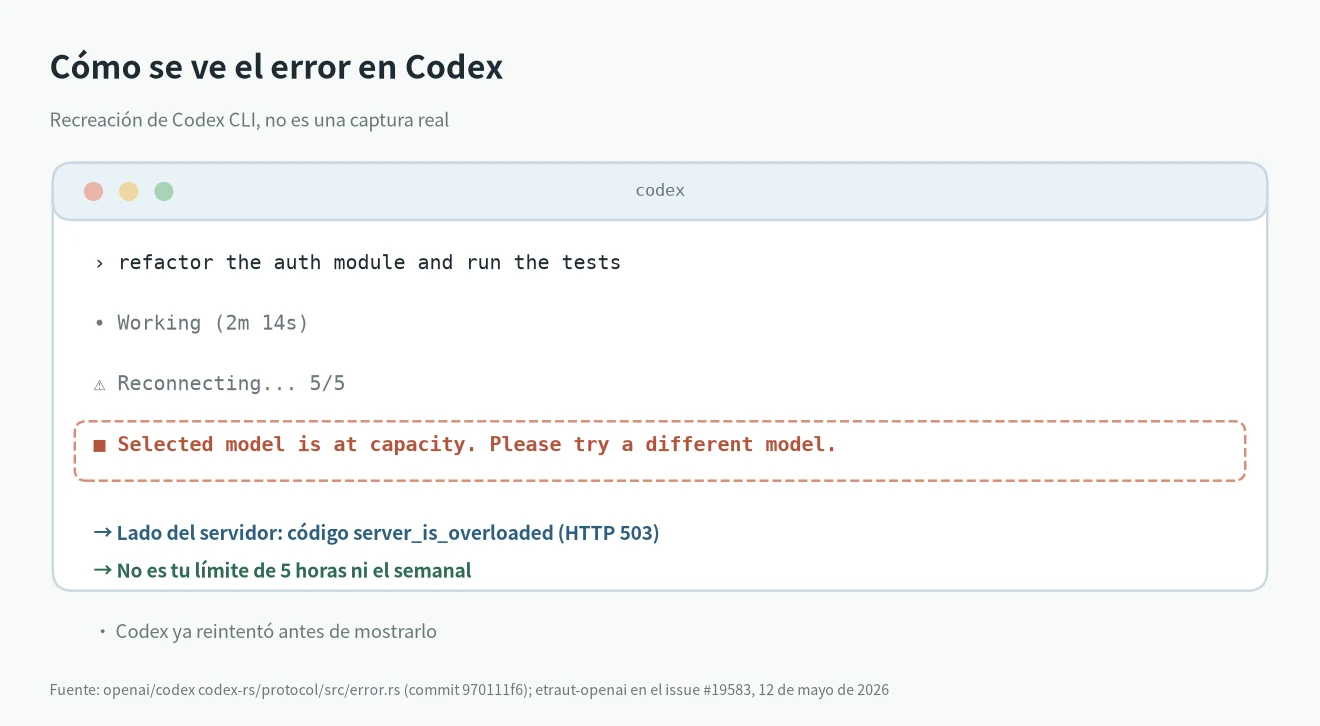
El mensaje es un texto fijo dentro de Codex. En el código de Codex corresponde a un error llamado ServerOverloaded.
Codex lo muestra cuando el servidor de OpenAI responde con el código server_is_overloaded. Puede llegar como un HTTP 503 o a mitad de una respuesta en streaming.
Un mantenedor de Codex, etraut-openai, lo dijo claramente en el issue #19583 de GitHub el 12 de mayo de 2026: «If you receive this message, it does not mean that you are being rate limited or are out of usage. It means that we are running low on capacity to serve this model in your region.»
En español: si ves este mensaje, no significa que te hayan limitado ni que se te haya acabado el uso. Significa que OpenAI tiene poca capacidad para servir ese modelo en tu región.
En qué se diferencia de un límite de uso
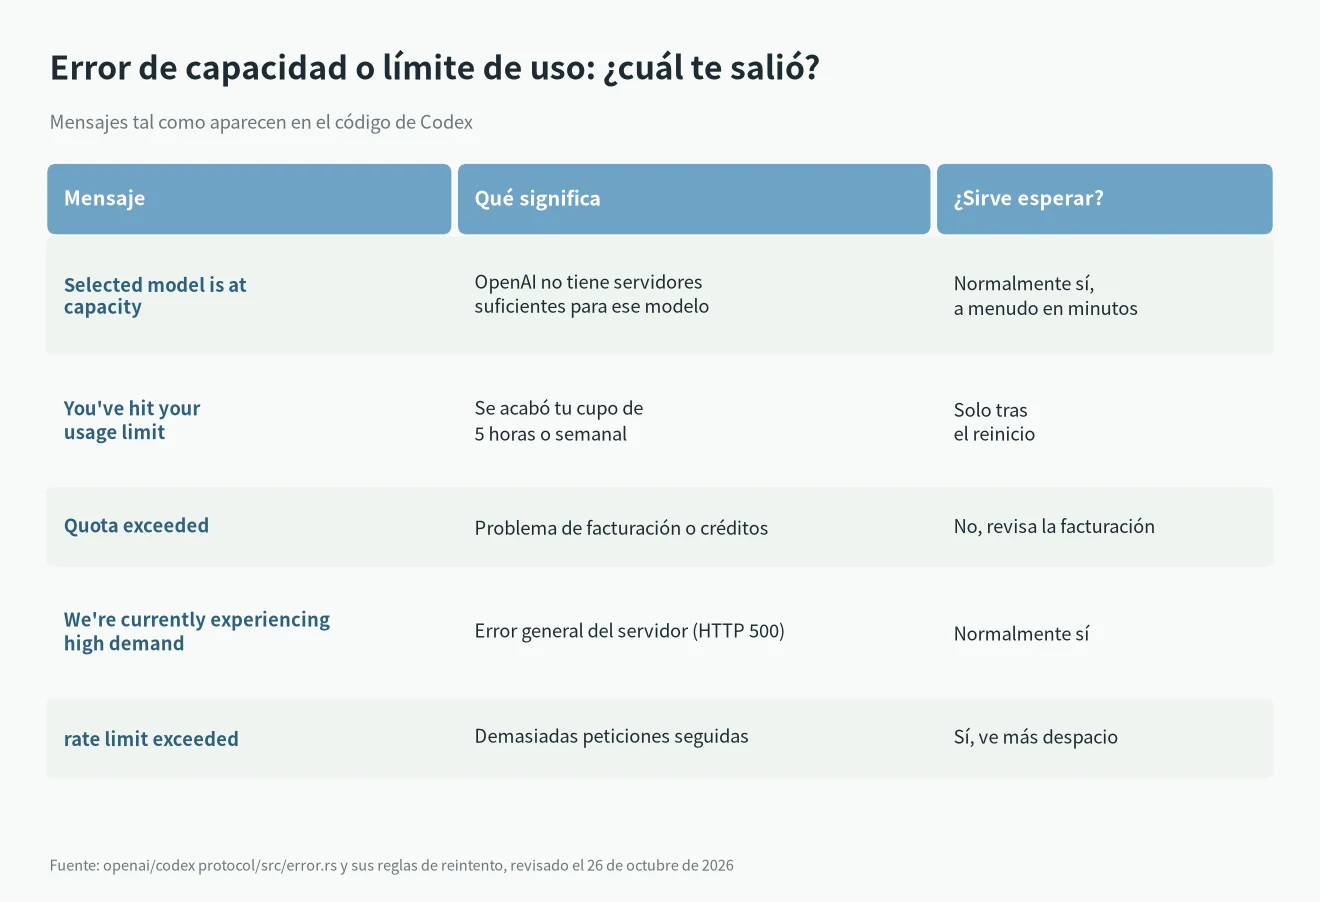
Para mí esta es la parte más útil, porque la solución depende del error que veas. Codex tiene un mensaje distinto para cada caso.
| Mensaje que ves | Qué significa | ¿Sirve esperar? |
|---|---|---|
| Selected model is at capacity. Please try a different model. | OpenAI no tiene servidores suficientes para ese modelo ahora (server_is_overloaded) | Normalmente sí, a menudo en minutos |
| You’ve hit your usage limit | Se acabó tu cupo de 5 horas o semanal | Solo después del reinicio |
| Quota exceeded. Check your plan and billing details. | Problema de facturación o créditos en la cuenta | No, hay que revisar la facturación |
| We’re currently experiencing high demand, which may cause temporary errors. | Un error general del servidor (HTTP 500) | Normalmente sí |
| rate limit exceeded | Demasiadas peticiones en poco tiempo | Sí, ve más despacio |
En el código, los errores de límite de uso y de cuota se marcan como «no reintentar». El error de capacidad es diferente. Codex solo espera y reintenta por su cuenta si el servidor le manda una indicación de reintento.
Si quieres ver cuánto uso te queda, escribe /status en Codex CLI. Muestra la configuración de la sesión, el uso de tokens y los límites. Cómo funcionan las ventanas de 5 horas y semanales está en mi guía de cuotas de suscripciones de IA, y los reinicios los apunto en el seguimiento de límites de Claude y Codex.
Por qué pasa tanto en octubre de 2026
El error no es nuevo. El issue más antiguo con esta frase en el título que encontré es el #11635, del 12 de febrero de 2026.
Pero octubre ha sido mucho peor. Entre el 26 de septiembre y el 26 de octubre, 175 issues del repositorio openai/codex mencionan la frase. 107 la llevan directamente en el título.
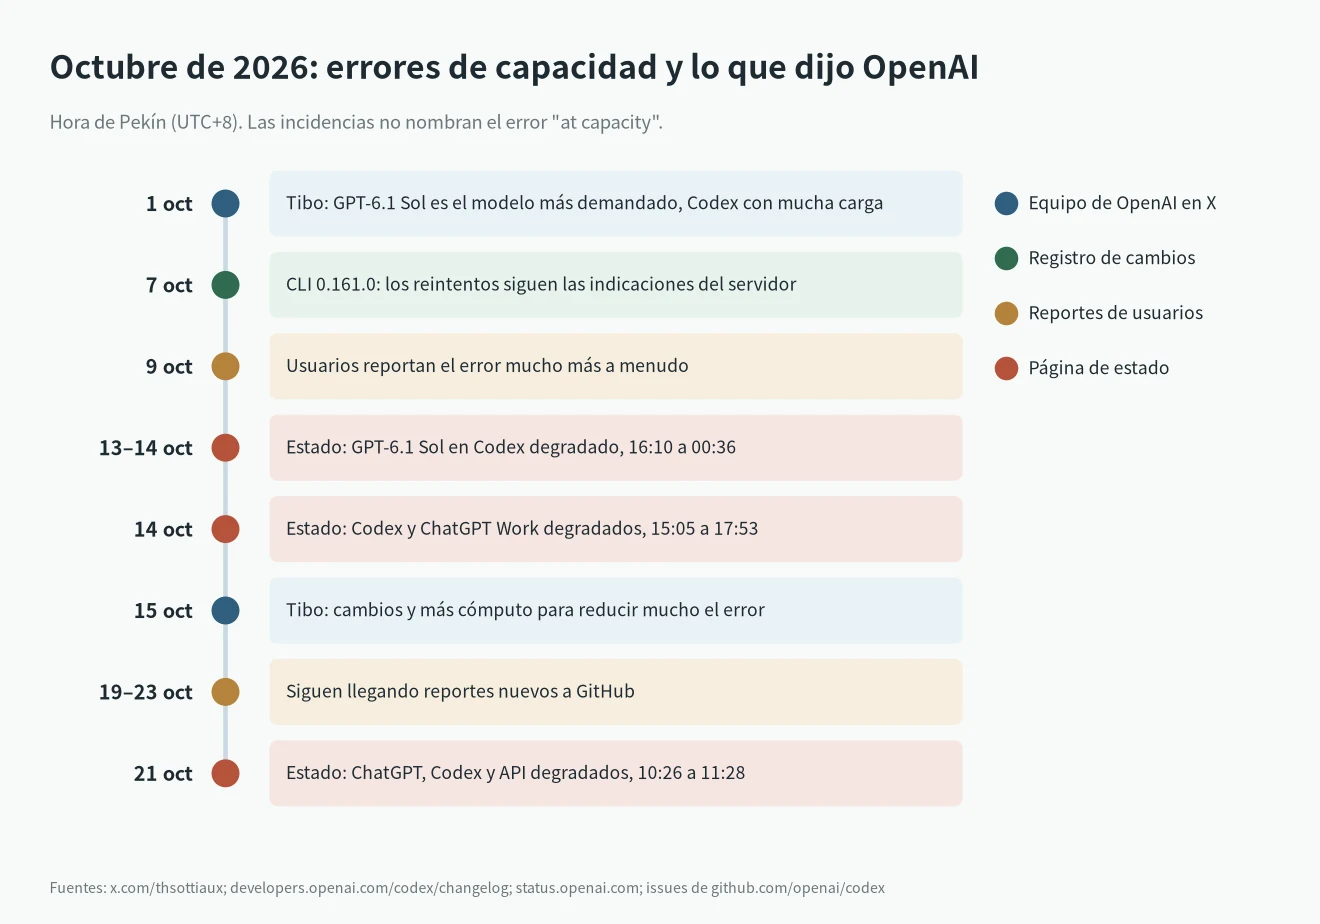
La causa más probable es la demanda. El 1 de octubre, Tibo (@thsottiaux), que trabaja en Codex en OpenAI, escribió que GPT-6.1 Sol era prácticamente su modelo más demandado y que Codex estaba bajo mucha carga.
La página de estado de OpenAI también registró problemas. Las horas son de Pekín (UTC+8).
- Del 13 de octubre a las 16:10 al 14 de octubre a las 00:36: rendimiento degradado de GPT-6.1 Sol en Codex y el modo Work. Afectó a Codex Web, la CLI, la extensión de VS Code y la API de Codex.
- 14 de octubre, de 15:05 a 17:53: rendimiento degradado en Codex y ChatGPT Work, con más errores de lo normal.
- 21 de octubre, de 10:26 a 11:28: rendimiento degradado en ChatGPT, Codex y las API.
Ninguna de estas notas usa las palabras «at capacity». Las pongo porque coinciden con los días en que más gente reportó el error.
El 15 de octubre a las 23:11 hora de Pekín, Tibo publicó que OpenAI había aplicado una serie de cambios y más capacidad de cómputo para reducir mucho este error. También dijo que, si vuelve a pasar, Codex debería acabar continuando solo. Pidió que se lo dijeran si seguía apareciendo.
Siguió apareciendo. Entre el 19 y el 23 de octubre llegaron nuevos reportes a GitHub, como #55260, #55544, #55583, #55740 y #56410.
Lo que cuentan los usuarios (sin confirmar por OpenAI)
Esto sale de reportes de usuarios en GitHub. OpenAI no lo ha confirmado, así que tómalo como patrones, no como hechos.
- Mucha gente lo ve con bastante uso disponible. Quien abrió el #52394 todavía tenía alrededor del 70%.
- Quien abrió el #55544 midió que fallaba cerca del 30% de las peticiones con un plan Plus. Reintentar en el momento solía funcionar.
- Varias personas dicen que cambiar de modelo no sirvió, porque todos daban el mismo error.
- Algunos lo veían en un cliente de Codex y en otro no, por ejemplo la CLI funcionaba y la app de escritorio no.
- Unos pocos creen que ciertas cuentas quedan marcadas, porque cambiar de cuenta lo solucionó. Nadie de OpenAI lo ha dicho, así que yo lo trataría como una suposición.
- En el #55832, quien abrió el issue dijo después que su caso era un problema temporal de su red local. Vale la pena descartar tu propia red.
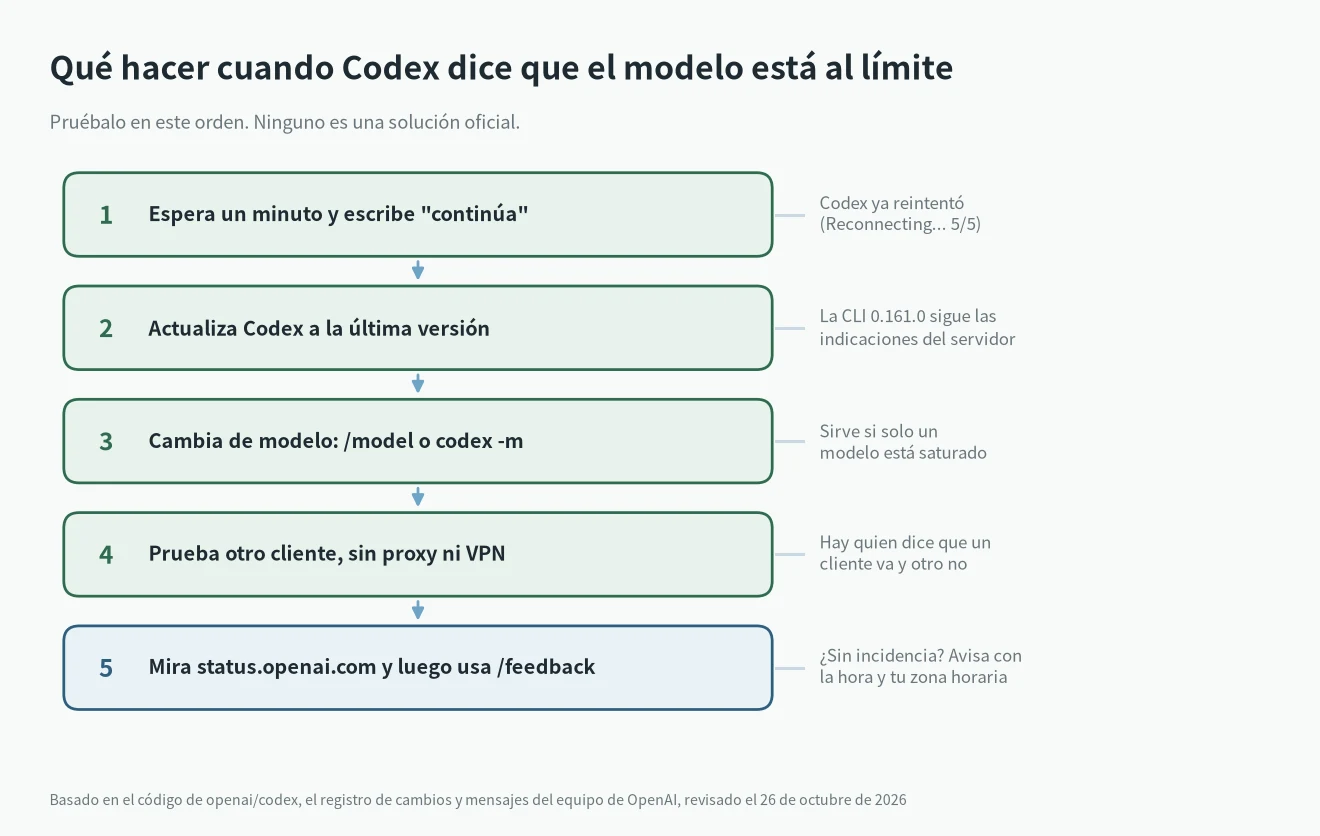
5 pasos fáciles para probar, en orden
Ninguno es una solución oficial. Son los pasos que encajan con cómo funciona el error en el código y con lo que ha dicho el equipo de OpenAI.
1. Espera un minuto y escribe «continúa»
Codex ya reintenta varias veces antes de mostrarte el error. Por defecto hace 4 reintentos de petición y 5 de streaming, por eso a veces ves antes una línea Reconnecting... 5/5. Como el problema está en el servidor, esperar un poco es lo que más suele funcionar.
2. Actualiza Codex
El registro de cambios de Codex de la CLI 0.161.0 (7 de octubre) dice que los reintentos ahora siguen las indicaciones del servidor para fallar menos durante la sobrecarga. El mensaje de Tibo del 15 de octubre también habla de que Codex continúe solo. Las dos cosas solo ayudan si usas una versión reciente. Hay un pull request de la comunidad para reintentos automáticos más largos (#31058) que sigue abierto y no se ha publicado.
3. Cambia de modelo
El propio mensaje lo sugiere. En la CLI, usa /model o arranca con codex -m . Sirve cuando solo un modelo está saturado. Muchos reportes de octubre dicen que fallaban todos a la vez, así que no esperes demasiado.
4. Prueba otro cliente de Codex y revisa tu red
Si la app de escritorio sigue fallando, prueba la CLI, o al revés. Si usas un proxy o una VPN, desactívalo para una prueba. Si vas a instalar la CLI por primera vez, mi guía para instalar Codex CLI explica el inicio de sesión.
5. Mira la página de estado y repórtalo
Mira primero status.openai.com. Si no hay ninguna incidencia y sigue pasando, escribe /feedback en Codex para enviar los registros al equipo, o abre un issue en GitHub con la hora y tu zona horaria. Tibo pidió justo este tipo de aviso.
Lo que yo no haría
No subiría de plan solo por este error. En octubre lo reportaron usuarios de Plus y de Pro, y el error no depende de tu cuota.
Tampoco metería Codex en un bucle de reintentos rápidos en un script. Si lo automatizas, deja más tiempo entre cada intento.
Si todavía estás decidiendo qué herramienta pagar, comparé las dos en Claude Code o Codex, y los planes de ChatGPT en ChatGPT Go, Plus o Pro. Claude Code tiene su propia versión de este problema, el error 529 Overloaded, que está en mi guía de errores de Claude Code.
Preguntas frecuentes
¿Este error significa que me han bloqueado la cuenta?
Ninguna fuente que encontré lo dice. El mantenedor de OpenAI lo describió como poca capacidad para el modelo en tu región.
¿Una petición fallida cuenta para mi uso?
No encontré ninguna explicación de OpenAI sobre esto, así que no puedo decir ni que sí ni que no.
¿Lo va a arreglar OpenAI?
El 15 de octubre Tibo dijo que OpenAI había añadido más cómputo y hecho cambios para reducirlo mucho. Después de esa fecha siguieron llegando reportes, así que lo sigo vigilando.