

Ollama model requires more system memory 怎么办?6 个有效解决办法,附实测
Ollama 报 model requires more system memory (X GiB) than is available (Y GiB),模型就是加载不起来。我们在 15.6 GiB 内存的机器上用 qwen2.5:14b 复现了这个报错,测了上下文长度对内存估算的影响,并对照 Ollama 源码、官方 FAQ 和 GitHub issue 逐个验证修法。
 buffer关于作者约 8 分钟阅读
模型明明下好了,ollama run 一跑却直接报 ollama model requires more system memory:Error: 500 Internal Server Error: model requires more system memory (14.0 GiB) than is available (10.3 GiB)。很多人第一反应是内存不够、只能加内存条,其实这两个数字里有不少是可以调的。我们在一台 15.6 GiB 内存、没有 swap、只有 CPU 的 Linux 机器上,用 Ollama 0.24.0 和 qwen2.5:14b(模型文件 9.0 GB)复现了这个报错,下面的数字都是这台机器上跑出来的,修法另外对照了 Ollama 源码、官方 FAQ 和 GitHub issue。
ollama model requires more system memory 里的两个数字是什么
报错里第一个数字是 Ollama 估算的这次加载需要多少内存,第二个是它认为现在能用的内存。我们读了 Ollama v0.24.0 的源码,这个检查在 llm/server.go 的 verifyLayout 里:需要的内存是放在 CPU 这边的模型权重、KV 缓存(上下文占的内存)和计算图加在一起;能用的内存是空闲内存加上空闲 swap。只要前者大于后者,Ollama 就拒绝加载,返回这条 ollama model requires more system memory 报错。这个检查在 macOS 上会跳过,所以这条报错基本出现在 Linux 和 Windows 上。
Linux 上的「空闲内存」取的是 /proc/meminfo 里的 MemAvailable,和 free -h 最后一列 available 是同一个值。我们测试时 free -h 显示 10Gi 可用,Ollama 日志里写的是 available="10.3 GiB",两边对得上。容器里的算法不一样,后面单独讲。
所以排查的思路就两条:把第一个数字降下来,或者把第二个数字提上去。第一个数字里,模型权重基本是固定的,变化最大的是上下文长度。
实测:同一个模型,只改上下文长度
我们先用默认设置加载 qwen2.5:14b,能正常回答。然后用 OLLAMA_CONTEXT_LENGTH=32768 重启服务,再跑一次,报错就出来了。用 API 在请求里传 num_ctx 也一样。下图是终端里的真实输出,curl 用的 11435 是我们测试时第二个 Ollama 实例的端口,你自己的默认端口是 11434。
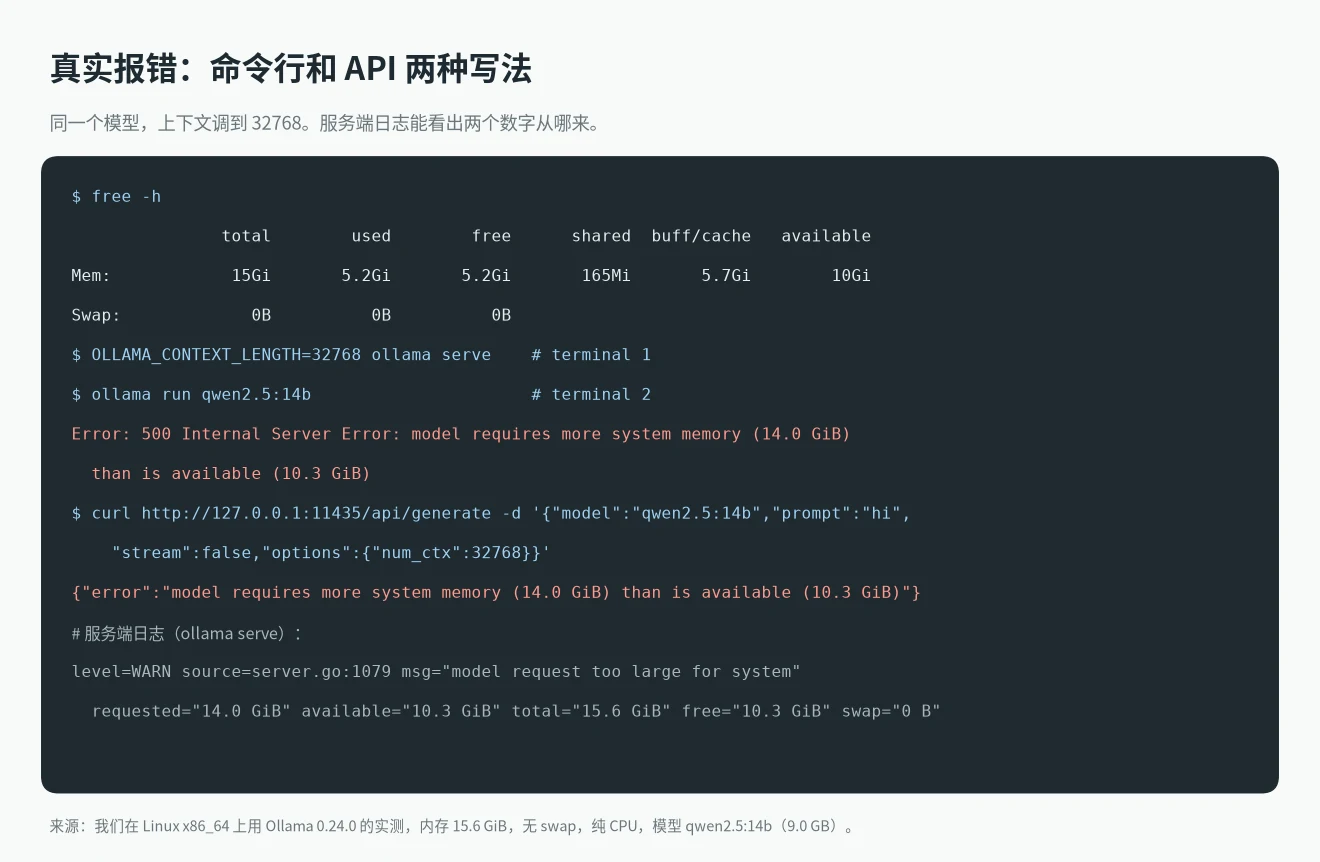
服务端日志里那一行 model request too large for system 把数字列得很清楚:requested="14.0 GiB" available="10.3 GiB" total="15.6 GiB" free="10.3 GiB" swap="0 B"。接着我们只改 num_ctx,其他都不动,又试了几档:
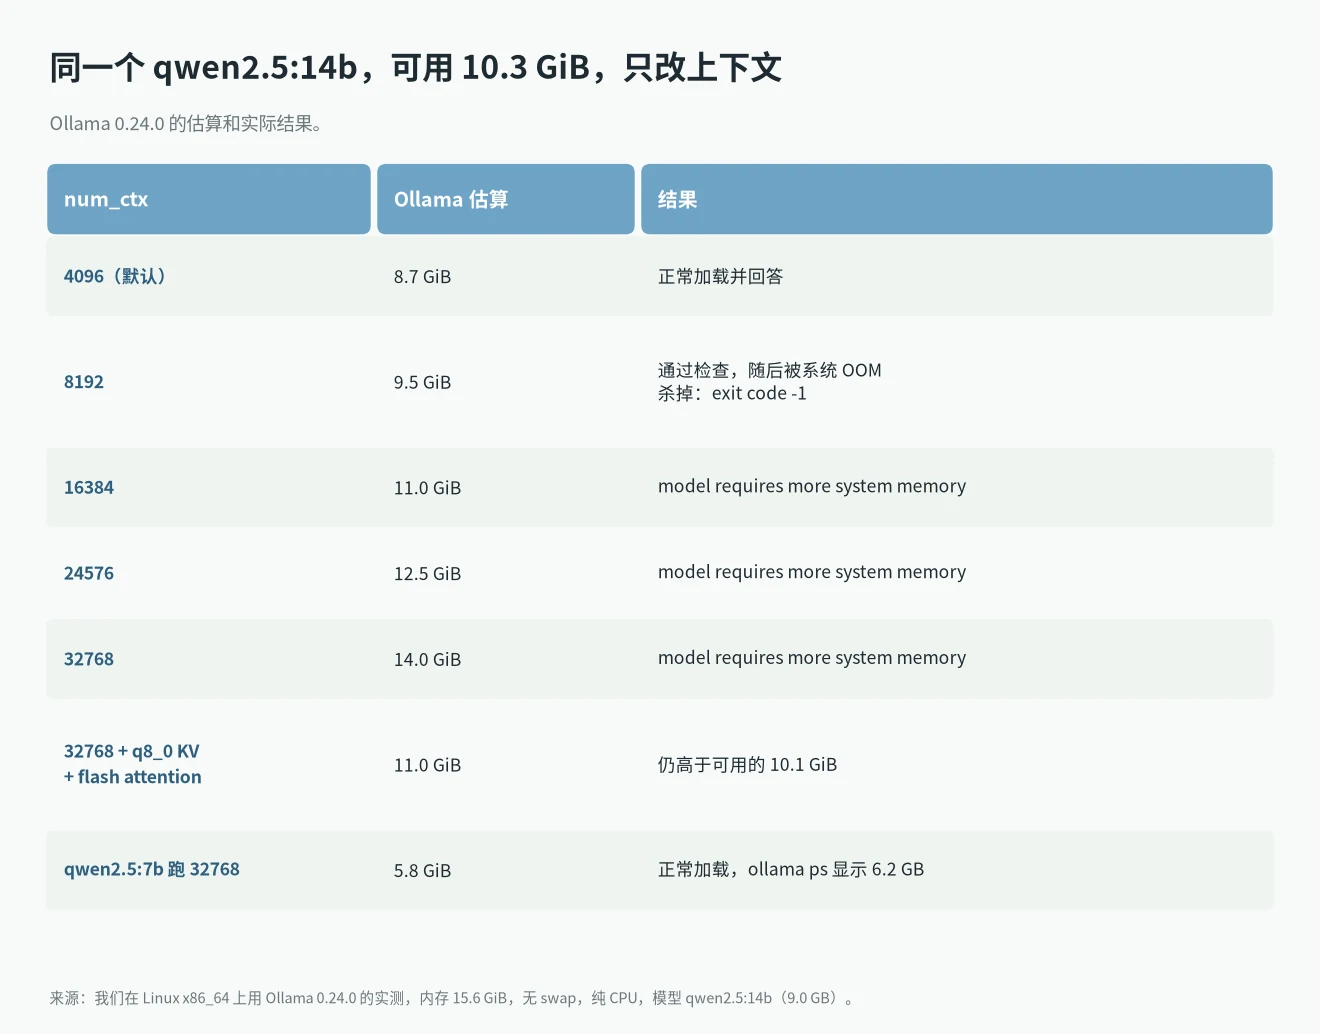
从 4096 到 32768,估算从 8.7 GiB 涨到 14.0 GiB,模型文件本身没变。还有一个要注意的结果:8192 那一档估算 9.5 GiB,通过了检查,但加载过程中进程被系统的 OOM killer 杀掉了,API 返回的是 llama runner process has terminated with exit code -1,dmesg 里能看到 Out of memory: Killed process。也就是说,估算只比可用内存小一点时,照样可能跑不起来,最好留出余量。
6 个解决办法
1. 调小上下文长度 num_ctx
这是最直接的办法。Ollama 官方 FAQ 写的默认上下文是 4096 个 token,如果你或者你用的工具把它调大了,内存需求会跟着涨。改的地方有三处,选你用到的那一处:
# 服务端全局设置(会影响所有请求)
OLLAMA_CONTEXT_LENGTH=8192 ollama serve

# ollama run 交互界面里临时改
/set parameter num_ctx 8192

# API 请求里改
curl http://localhost:11434/api/generate -d '{"model":"qwen2.5:14b","prompt":"hi","options":{"num_ctx":8192}}'很多人自己没改过,是插件替你改的。issue #7423 里,用户在 IntelliJ 的 Continue 插件里调用 Docker 中的 Ollama 时报了这个错,Ollama 维护者 rick-github 的判断是 Continue 用了很大的上下文窗口。所以如果命令行能跑、插件里报错,先去插件配置里找上下文长度。改完用 ollama ps 看 CONTEXT 一列,确认生效的是多少。
5 种设置上下文的方法和它们的优先级,见 Ollama 上下文长度设置。
2. 检查 OLLAMA_NUM_PARALLEL
官方 FAQ 写得很明确:所需内存会按 OLLAMA_NUM_PARALLEL * OLLAMA_CONTEXT_LENGTH 放大。现在的默认值是 1,我们 0.24.0 的启动日志里也是 OLLAMA_NUM_PARALLEL:1。但如果你在 systemd、Docker compose 或者环境变量里设过 4、8 这样的值,KV 缓存就要按倍数算。issue #7423 是 2024 年的,当时默认值还是 4,那位用户把 OLLAMA_NUM_PARALLEL 改成 1、换了小一点的模型之后就能用了。只有一个人在用的话,设成 1 就够了。
3. 量化 KV 缓存
官方 FAQ 里介绍了用 OLLAMA_KV_CACHE_TYPE 把 KV 缓存量化成 q8_0,前提是开启 OLLAMA_FLASH_ATTENTION=1。我们在同一台机器上这样启动后,qwen2.5:14b 在 32768 上下文下的估算从 14.0 GiB 降到 11.0 GiB:
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve降了 3 GiB,不过在我们这台机器上还是比可用的 10.1 GiB 多,照样报错。它适合差一点点的情况,差得多的话要和第 1 条一起用。FAQ 的说法是 q8_0 占用约为默认 f16 的一半,精度损失很小,通常看不出质量变化;但也提醒 Qwen2 这类 GQA 数量高的模型受量化的影响可能更大。
4. 换小一号的模型或更低的量化
上下文必须要长的话,就只能让模型权重变小。我们把模型换成 qwen2.5:7b(模型文件 4.7 GB),同样是 32768 上下文,估算 5.8 GiB,正常加载,ollama ps 显示占用 6.2 GB、100% CPU、CONTEXT 32768。按模型大小和上下文估算需要多少内存,可以用我们的本地大模型显存计算器;16GB 这类配置适合跑哪些模型,可以看本地大模型推荐。
5. 腾出内存,或者加 swap
可用内存是加载那一刻算的,其他程序占得多,它就小。先用 ollama ps 看有没有别的模型还驻留在内存里,有的话用 ollama stop 模型名 卸掉;浏览器开了很多标签页也会占不少。issue #7423 的提问者最后自己总结,原因就是浏览器开了太多窗口,关掉后就正常了。
源码里可用内存包含空闲 swap,所以加 swap 也能让检查通过。在 issue #7942 里,有用户设了 useMmap 仍然报 model requires more system memory (17.7 GiB) than is available (13.6 GiB),rick-github 回复说 mmap 不影响这个内存检查,内存不够就加 swap。issue #8667 里在 40GB 内存上跑 deepseek-r1:671b(报 446.3 GiB)的讨论,给出的也是加大 swap 的办法。我们没有测加 swap 之后的速度,这里只说明检查会把 swap 算进去;内存本身不够的问题并没有消失。
6. Docker、LXC 里放宽内存限制
在容器里,Ollama 不用 MemAvailable。我们读的 v0.24.0 源码里,discover/cpu_linux.go 会读 cgroup 的 memory.max 和 memory.current,用「总内存减去 memory.current」当作可用内存。问题在于 memory.current 把文件缓存也算进去了,模型文件读过一遍之后,缓存可能就占了好几 GB,容器里明明还有大量可回收内存,Ollama 却算出很小的可用值。
issue #15704 就是这个问题:Proxmox LXC 容器给了 32 GiB,MemAvailable 约 31.9 GiB,Ollama 却报 model requires more system memory (18.3 GiB) than is available (12.6 GiB)。2026 年 8 月有用户在 Docker 里的 0.32.9 上确认了同样的计算路径。修复的 PR #13782 还没合并,issue 也还开着。在修复合并之前,能做的是给容器更高的内存限制,或者在宿主机上直接跑 Ollama,同时用上面 1 到 4 条把需求降下来。
升级 Ollama 以后还会报这个错吗
我们对比了不同版本的源码:v0.21.2 到 v0.24.0 的 llm/server.go 里都有 model requires more system memory (%s) than is available (%s) 这句报错;从 v0.30.0 开始,到 v0.40.0,正式代码里都找不到这句原文了。新版本改用 llama-server 加载,内存不够时报错的样子不同。
我们在同一台机器上用当前的 0.40.13 试了 llama3.2:3b 加 131072 上下文:日志先写 projected to use 15468 MiB of host memory vs. 16002 MiB of total host memory,然后是 failed to fit params to free device memory: was unable to fit model into system memory by reducing context, abort,API 返回 llama-server process has terminated: signal: killed。所以升级之后这句 ollama model requires more system memory 可能不再出现,但内存不够的问题还在,上面的办法照样适用。按源码,新版本在你没有手动指定 num_ctx 时,加载 OOM 后会自动尝试更小的上下文;你自己指定了就不会替你降。
如果你遇到的不是内存问题,而是别的加载报错,可以去Ollama 和 llama.cpp 常见报错汇总里按报错原文查。
常见问题
模型文件只有 9 GB,为什么要 14 GB?
模型文件只是权重。加载时还要给 KV 缓存和计算图分配内存,KV 缓存随上下文长度和并发数增长。我们的实测里,同一个 9.0 GB 的 qwen2.5:14b,上下文 4096 时估算 8.7 GiB,32768 时是 14.0 GiB。
Mac 上也会报这个错吗?
按 v0.24.0 的源码,这项检查只在 Linux 和 Windows 上做,macOS(darwin)上换成了另一套判断,源码注释的理由是 macOS 的 swap 是动态分配的。所以 Mac 上一般看不到这条报错。
有 GPU 也会报吗?
会。显存放不下的那部分层会放到 CPU 内存里,检查算的是放在 CPU 这边的那部分。我们的测试机没有 GPU,这部分是根据源码判断的。