

Ollama «pull model manifest: 412»: guía esencial para solucionarlo sin agobios
Ollama muestra "Error: pull model manifest: 412" cuando el modelo que descargas necesita una versión de Ollama más nueva que la tuya. Actualiza por la vía oficial y comprueba con ollama -v. Lo reproducimos en Linux con 0.40.8 y descargamos el mismo modelo con 0.40.12.
 bufferSobre el autor6 min de lectura
Respuesta corta: Ollama muestra Error: pull model manifest: 412 cuando el modelo que intentas descargar necesita una versión de Ollama más nueva que la tuya. El registro comprueba tu versión y rechaza la descarga. Actualiza Ollama por la vía oficial, confirma con ollama -v que la versión cambió y vuelve a descargar. Lo reprodujimos el 29 de octubre de 2026 (hora de Pekín) en una máquina Linux de pruebas: con Ollama 0.40.8 salió el 412 y con 0.40.12 el mismo modelo pasó ese paso.
El mensaje exacto de pull model manifest: 412
Con una versión demasiado antigua, la salida completa es esta:
pulling manifest
Error: pull model manifest: 412:
The model you are attempting to pull requires a newer version of Ollama.

Please download the latest version at:

        https://ollama.com/download
El código HTTP 412 significa «Precondition Failed», y aquí la condición es tu versión de Ollama. El problema es que la página del modelo no siempre dice qué versión necesita. En el issue #18414 un usuario lo señaló: qwen3.8:27b devolvía pull model manifest: 412 en Ollama 0.32.3 y la página del modelo no indicaba ninguna versión mínima.
Hay una segunda variante. Si el modelo necesita una versión que todavía es preliminar, el final cambia:
Error: pull model manifest: 412:
The model you are attempting to pull requires a newer version of Ollama that may be in pre-release.

Please see https://github.com/ollama/ollama/releases for more details.
Se reportó en el issue #19085 con bonsai-2:9b en la 0.40.5, que entonces era la última versión estable. El issue se cerró cuando salió una versión más nueva. Si ves «may be in pre-release», el instalador estable aún no basta: instala la versión previa o espera.
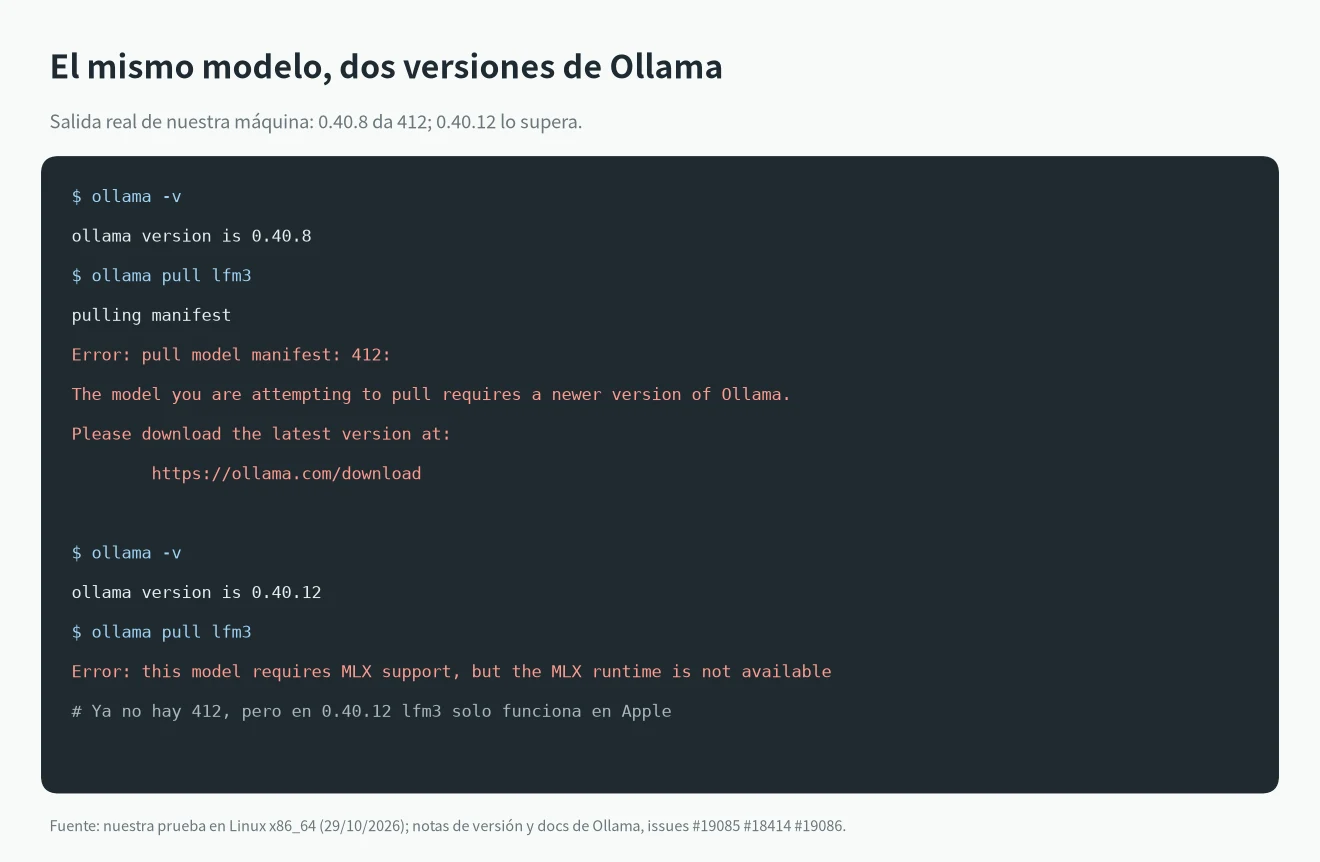
Nuestra prueba: 0.40.8 frente a 0.40.12
Instalamos dos builds oficiales de Linux en la misma máquina y descargamos lfm3, un modelo que llegó con Ollama v0.40.12 el 27 de octubre de 2026.
- En 0.40.8,
ollama pull lfm3mostró el mensaje de pull model manifest: 412 palabra por palabra. La API (POST /api/pull) devolvió el mismo texto en el campoerror. - Con el mismo cliente 0.40.8,
nemotron-3.5-boltyd3pasaron el paso del manifiesto. El 412 se decide por modelo, no es un bloqueo general por tener una versión vieja. - En 0.40.12 el 412 desapareció, pero la descarga se detuvo con otra línea:
Error: this model requires MLX support, but the MLX runtime is not available.
Esa última línea importa. Las notas de v0.40.12 dicen: «lfm3 and d1 2b are supported on Apple hardware in this release. Support for Linux/Windows coming soon.» Es decir, en esta versión lfm3 solo funciona en hardware de Apple. Nuestra máquina usa Linux, así que la actualización resolvió la comprobación de versión y luego chocó con el límite de plataforma. Si usas Linux o Windows y descargas un modelo recién publicado, lee primero las notas de la versión que lo añadió.
Cómo solucionar pull model manifest: 412
1. Mira qué versión usas: ollama -v. Si cliente y servidor no coinciden, aparece una línea Warning: client version is …. El registro ve la versión del servidor.
2. Compárala con la última en GitHub releases y busca el nombre del modelo en las notas para saber qué versión lo añadió.
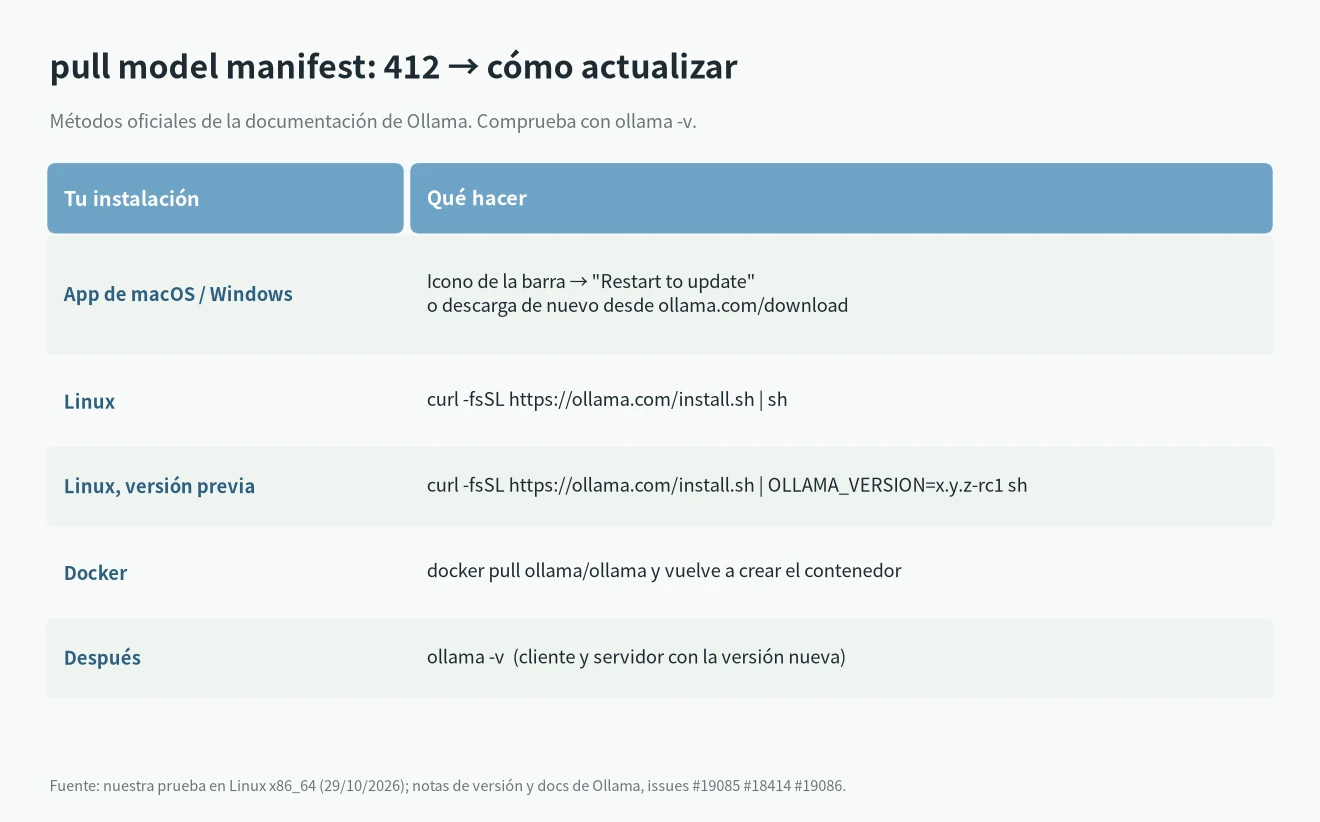
3. Actualiza. Las preguntas frecuentes oficiales explican cómo hacerlo en cada sistema.
4. Ejecuta ollama -v otra vez y repite la descarga.
macOS y Windows
La app de escritorio descarga las actualizaciones sola. Haz clic en el icono de Ollama en la barra de menús (macOS) o en la barra de tareas (Windows) y elige «Restart to update» cuando aparezca. También puedes bajar el instalador desde ollama.com/download e instalarlo encima.
Linux
Vuelve a ejecutar el script de instalación, que sustituye la versión anterior:
curl -fsSL https://ollama.com/install.sh | shSi el modelo necesita una versión previa, la documentación de Linux explica cómo fijar una versión concreta, también candidatas:
curl -fsSL https://ollama.com/install.sh | OLLAMA_VERSION=0.40.12 shCambia el número por el que necesites de GitHub releases. Si Ollama corre como servicio de systemd, revisa systemctl status ollama para confirmar que responde la versión nueva.
Docker
La imagen es ollama/ollama. Descarga la imagen nueva y vuelve a crear el contenedor con el volumen de modelos en la misma ruta, así conservas lo que ya tenías.
Modelos que importas tú
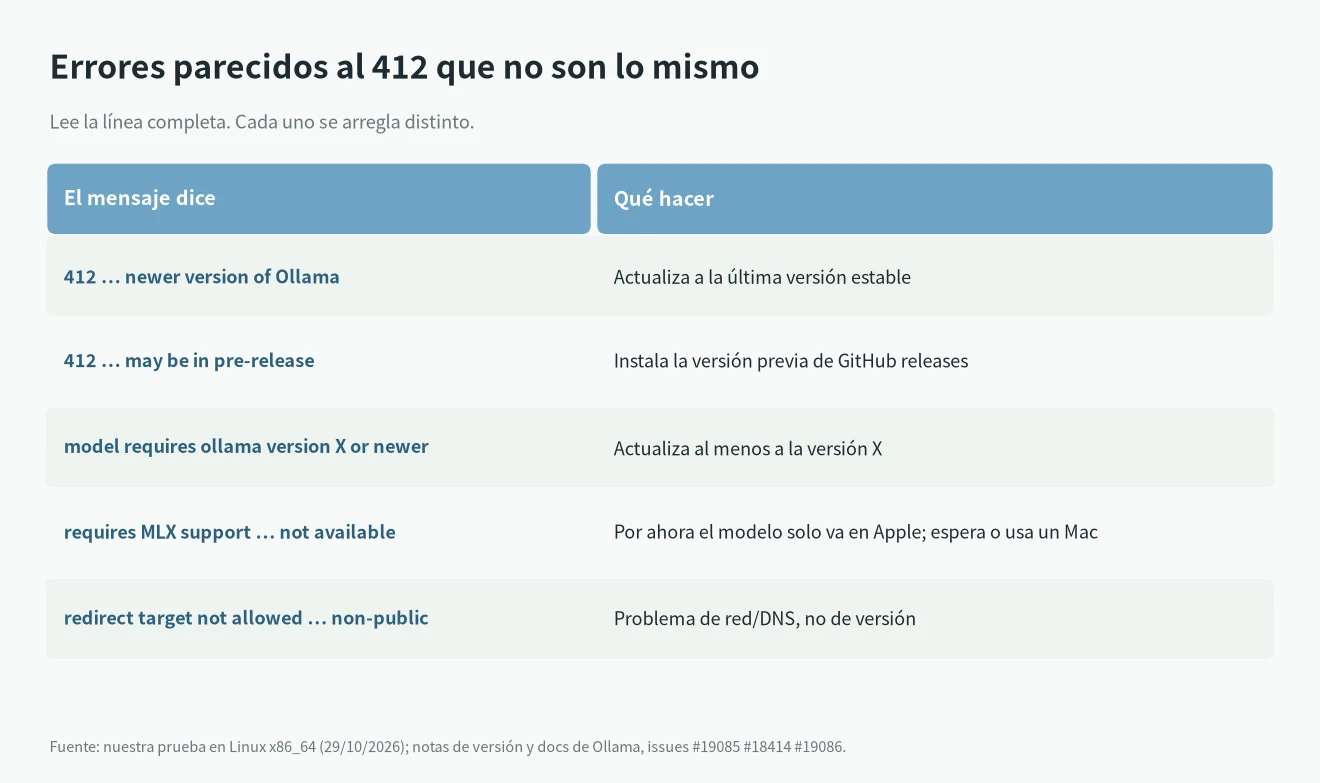
Un Modelfile también puede fijar una versión mínima con la instrucción REQUIRES. Si un cliente antiguo descarga un modelo así, verás model requires ollama version X or newer (current version is vY). Se arregla igual: actualiza al menos a X. En nuestra prueba, un modelo creado en local con REQUIRES 0.99.0 se ejecutó sin problema, porque Ollama lo comprueba al descargar, no al crear en local.
Errores que parecen un 412 y no lo son
redirect target not allowed … resolves to non-public
Es un problema de red, no de versión. Ollama no descarga archivos de modelos desde un host que resuelve a una IP privada o reservada. En el issue #19086, quien lo reportó usaba secuestro de DNS en su router para una VPN, con el rango 198.18.0.0/15, y recibió redirect target not allowed: … resolves to non-public 198.x.x.x. Nuestra máquina de pruebas también usa DNS con IP falsas y mostró la misma línea. Al cerrar el issue, el autor dijo que la opción --insecure evita la comprobación. En nuestra red no funcionó: ollama pull --insecure d3:2b en 0.40.12 devolvió Error: pull model manifest: 500:. La ayuda de esa opción dice «Use an insecure registry», así que no conviene usarla siempre. Lo más fiable es que el host de descarga resuelva a su IP pública real, por ejemplo excluyendo *.r2.cloudflarestorage.com y registry.ollama.ai del modo de IP falsas de tu herramienta de proxy.
unknown model architecture
Si la descarga funciona pero el modelo no carga y el registro dice unknown model architecture, el archivo del modelo es más nuevo que el motor de inferencia que trae tu Ollama. Es otro arreglo, explicado en nuestra guía del error unknown model architecture de Ollama.
Preguntas rápidas
¿pull model manifest: 412 significa que el modelo está roto?
No. El modelo está bien; tu Ollama es más antiguo que la versión para la que se publicó.
Actualicé y sigue saliendo pull model manifest: 412
Ejecuta ollama -v. En Linux puede seguir corriendo el servicio antiguo, y en macOS o Windows puede que la app no se haya reiniciado. Si ya tienes la última versión estable, probablemente el modelo necesita una versión previa: revisa la variante «may be in pre-release».
¿Puedo usar el modelo sin actualizar?
Desde la biblioteca de Ollama, no. Si tienes el archivo GGUF, puedes ejecutarlo directamente con llama.cpp, mira cómo arrancar llama.cpp con un GGUF local. Para elegir un modelo según tu hardware, consulta nuestra guía de LLM local para programar y los mejores LLM locales según tu VRAM.