
AI 看不准书架能否再塞两本书:HSS 测出了什么?
书架上还能不能放两本书?先看 HSS 的真实题图,给个自己的判断。它暴露的视觉落差,也让我重新考虑:哪些事情该让 AI 看图,哪些根本没必要靠猜。
 buffer关于作者约 5 分钟阅读
下面这排书,还能再放两本吗?
具体看靠近镜头、摆着白色、橙色和蓝色书的那一层:浅蓝色书前、书挡之前的位置,还放得下两本与现有白色书大小相近的书吗?先给个自己的判断,再往下看。
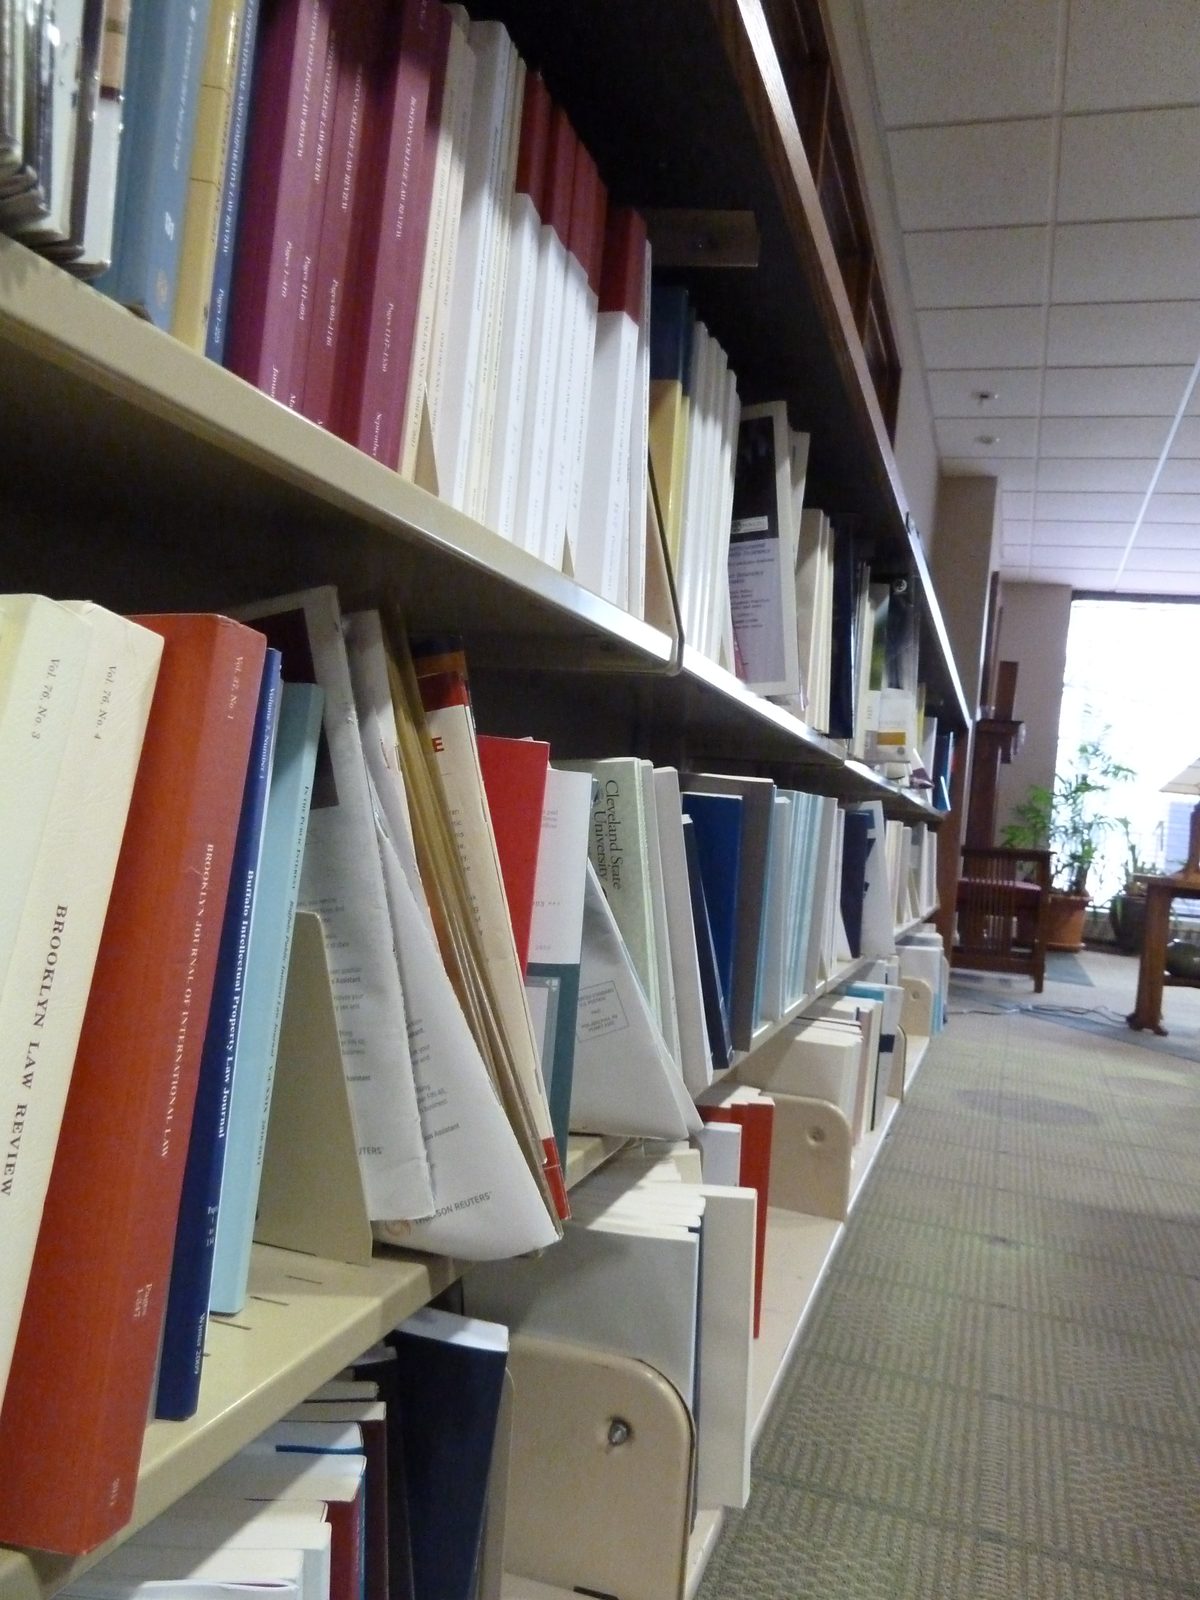
出题方的答案是:能,现有的空隙够用。
在论文所测的版本和设置下,GPT-6-astra、Gemini-3.8-flash、Claude-Opus-5.5 各答了三次,全部判断放不下。这是 Elorian 公布的一道原题,来自它与 Scale AI 联合发布的视觉推理基准 Humanity’s Sixth Sense,简称 HSS。
能写程序、解难题的模型,在这里卡住了。这个反差,比再刷出一张满是高分的榜单更让我在意。
我用 AI 时,很容易顺手发张截图过去,默认它已经把画面看明白了,剩下的只是分析。可如果它第一眼就看错了,后面那段条理清楚的解释,反而会帮错误打掩护。
HSS 测的是“看懂关系”
“第六感”这个名字有点玄,题目倒很接地气:空间够不够,链条有没有在受力,一个人刚才从哪儿走过来。
识别出“这里有书”,只是第一步。你还得看出书之间的间距、倾斜的角度,以及把它们摆正以后会腾出多少位置。HSS 关心的,就是这种从可见线索里推断关系的能力。
按 Scale Labs 的发布说明,这套基准有 522 道开放题:288 道图片题,234 道视频题,覆盖空间、时间与因果、社会理解和情境推断。不给选项,需要模型自己作答。
发布时,人类基线为 93.1%,最强受测模型 GPT-6-astra 为 53.6%,差了 39.5 个百分点。
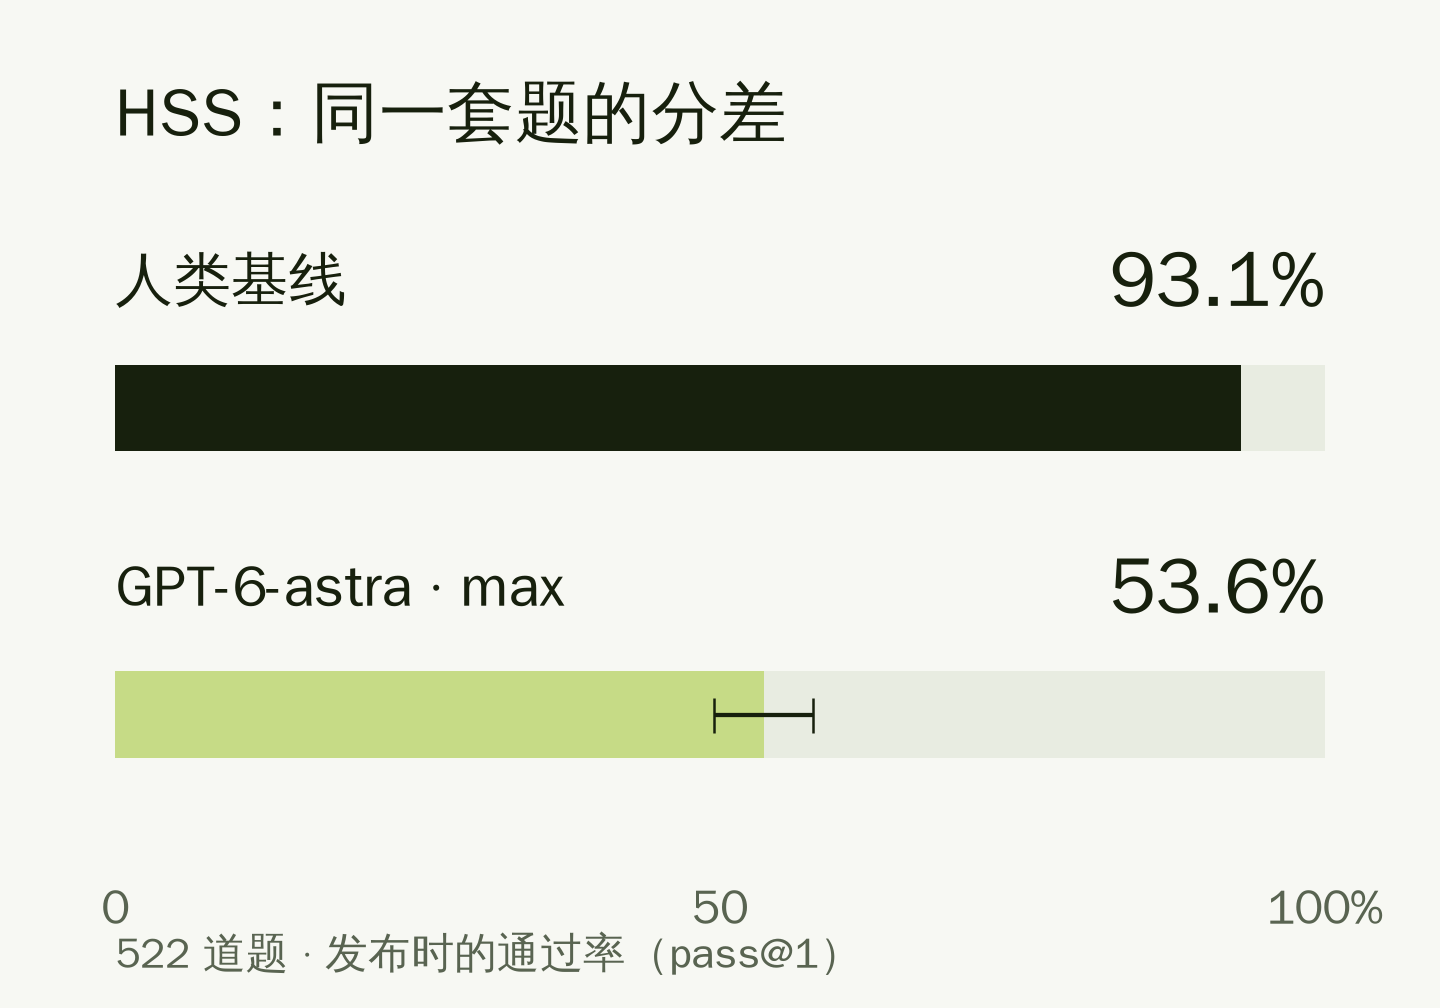
这个差距有分量,但别拿它给“智力”打总分。人类基线来自 20 名参与者;题目也经过筛选,倾向于保留人类能达成共识的判断。它回答的是:在这类视觉任务上,当前模型离受测人类还有多远。
尤其别把书架例题转述成“现在的 AI 永远答不对”。那是特定版本在特定设置下的记录。模型会更新,某次聊天答对一道题,也不等于整类能力已经补齐。
问题可能出在推理之前
论文分析了 8,573 次失败,约 53% 被归为感知错误,41% 被归为隐含信息推断错误,5% 被归为逻辑推理错误。方法见论文附录 D。
这里必须留一个心眼:这些标签由另一个模型 Claude-Opus-5 根据题目、参考答案和回答生成,不是研究人员逐条人工鉴定,也不是裁判重新看图后作出的诊断。因此,不能顺着这组数就宣布“AI 的逻辑已经没问题,只差一双眼睛”。
但它给了我一个很实用的排错顺序:先核对它看到了什么,再讨论它想得对不对。
比如让 AI 操作网页,它可能把灰掉的按钮当成能点的按钮,把背景图里的图标当成真实控件。接下来安排五步还是十步,都救不了这个起点。这是我从 HSS 联想到的使用问题,论文没有直接测网页操作。
我们很爱追问模型“你再仔细想想”。有时该补的,却是一张清楚点的局部图。
多想一轮,还是换个角度看
研究团队也给模型配了工具。在同一个 388 题子集上,GPT-6-astra 从直接回答的 54.4%,提高到 Codex 工具环境下的 59.3%。提升是 4.9 个百分点;这里要和同子集的成绩比,不能拿完整题集的 53.6% 来减。论文附录 F 记录了这组实验。
工具有帮助,信息仍然有边界。放大照片,可以看清原本忽略的缝隙;被遮住的背面、没有拍到的深度,放大多少次也不会出现。
拿“柜子能不能搬进门”来说,我希望助手先分清两件事:它是没看清门框,还是压根不知道柜子的尺寸?前者可以补拍局部,后者应该去量。两种情况都用“再推理一轮”处理,算力很可能花错了地方。
这也是我想要的一种产品能力:助手能提出一个会改变判断的补充问题。“请补一张侧面图”有时比一页分析更值钱。前提是它说得清,那张侧面图究竟要确认什么。
做产品时,我会先少让它猜几次
回到我自己的使用场景。如果助手要改网站,我会希望每个关键动作旁边都有依据:它看到的是哪个控件,当前是什么状态,执行后又从哪里确认结果。
有些依据甚至没必要靠眼睛猜。按钮是否禁用,可以读控件状态;文章有没有发布,可以查后台记录和真实网址;订单是否创建,可以查服务器返回。截图很直观,但它只保留了系统状态的一种表现。
我因此更愿意把产品精力花在“让状态可读取”上。视觉能力当然要进步,可在一个本来就有数据接口的软件里,让模型反复从像素推测答案,经常是我们主动把简单问题做难了。
这也会改变我在上一篇 Claude Mods 文章里设想的“交作业”面板:除了展示完成了什么,还应允许我点回它用过的页面状态、截图区域或视频时间点。看见证据,才有机会在它点错之前拦一下。
书架题让我不舒服的地方,就在这里:答案听起来很合理,而错误恰好藏在我们以为最不需要核对的那一步。
下次给 AI 发截图,我会多加一句:“你是从哪里看出来的?指给我看。”
数据口径补充:HSS 从最初的 3,466 道题中,经三轮审核保留 522 道,见数据集说明。失败归因覆盖 24 个模型,主结果表包含后来加入的第 25 个模型。文中的榜单数字均指论文发布版本,不是实时排名;三项归因百分比为约数。