
HSS: la IA ve los libros. ¿También ve el espacio?
¿Caben dos libros más? Responde antes de ver la solución. Esta pregunta de HSS sirve para entender por qué una explicación convincente no garantiza que la IA haya interpretado bien una imagen.
 bufferSobre el autor6 min de lectura
¿Caben dos libros más en este estante?
Mira la fila más cercana a la cámara, donde están los tomos blancos, naranjas y azules. La pregunta se refiere al espacio delante del libro azul claro, antes del separador: ¿alcanzaría para otros dos del tamaño de los blancos que ya están ahí? Decide antes de seguir leyendo.
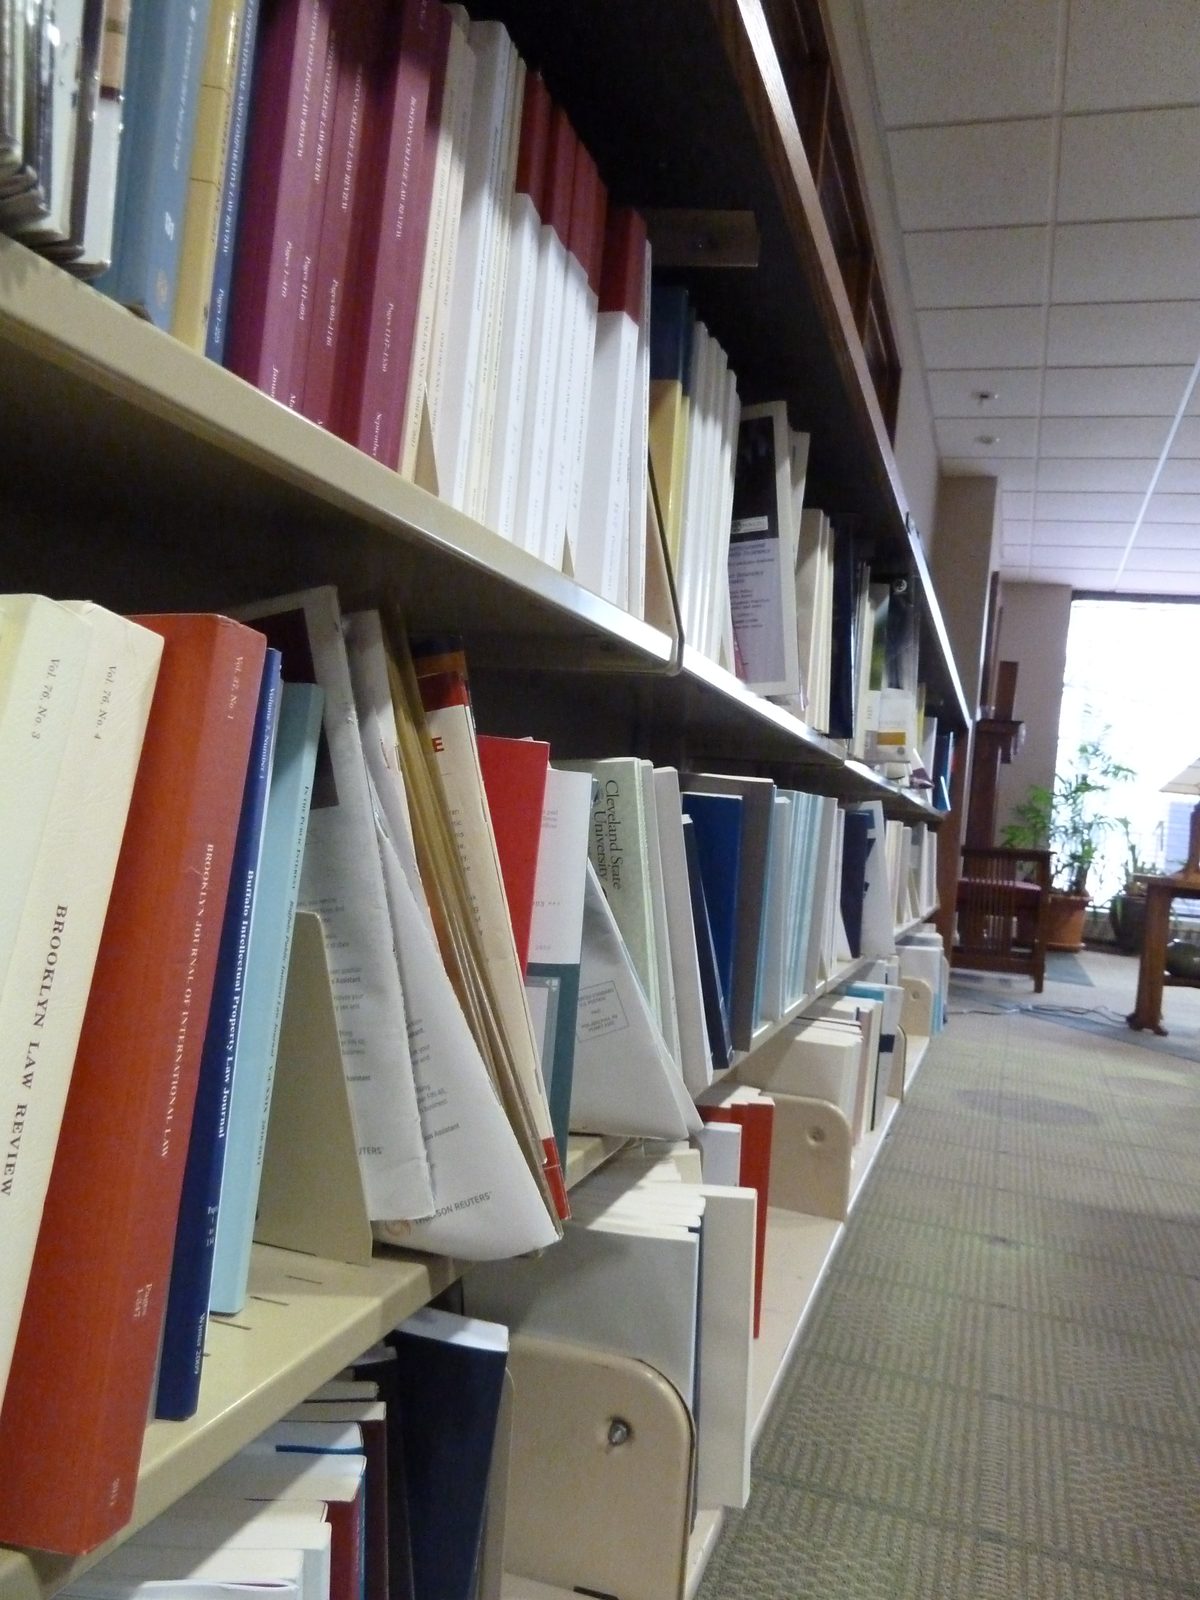
La respuesta de referencia es sí: los espacios disponibles alcanzan.
GPT-6-astra, Gemini-3.8-flash y Claude-Opus-5.5 respondieron tres veces cada uno en las versiones y condiciones del estudio. Las nueve respuestas dijeron que no. La imagen pertenece a un ejemplo publicado por Elorian, que desarrolló con Scale AI la prueba Humanity’s Sixth Sense, HSS.
Un modelo capaz de escribir código puede equivocarse al mirar un estante. A mí ese contraste me importa por una razón bastante cotidiana: cuando envío una captura a un asistente, suelo dar por hecho que ya entendió lo que aparece. Después discuto su recomendación, pero rara vez reviso si vio bien el problema.
Y una explicación impecable puede hacer que esa primera equivocación pase todavía más desapercibida.
Qué es HSS y qué mide del razonamiento visual de la IA
El nombre, «sexto sentido», suena misterioso. Las preguntas no lo son: ¿queda espacio?, ¿una cadena está soportando peso?, ¿de dónde venía la persona que aparece en un video?
En la foto del estante, reconocer libros no basta. Hay que interpretar los huecos, la inclinación de los tomos y el espacio que se podría recuperar al acomodarlos. HSS se ocupa de esas relaciones que inferimos a partir de lo que vemos.
Según la presentación de Scale, son 522 preguntas abiertas: 288 con imágenes y 234 con videos. Cubren relaciones espaciales, tiempo y causalidad, comprensión social e inferencias de contexto. El modelo debe redactar una respuesta; no recibe opciones para elegir.
En los resultados publicados al lanzamiento, la referencia humana alcanzó 93.1% y el mejor modelo evaluado, GPT-6-astra con el máximo esfuerzo de razonamiento, 53.6%. La distancia es de 39.5 puntos porcentuales.
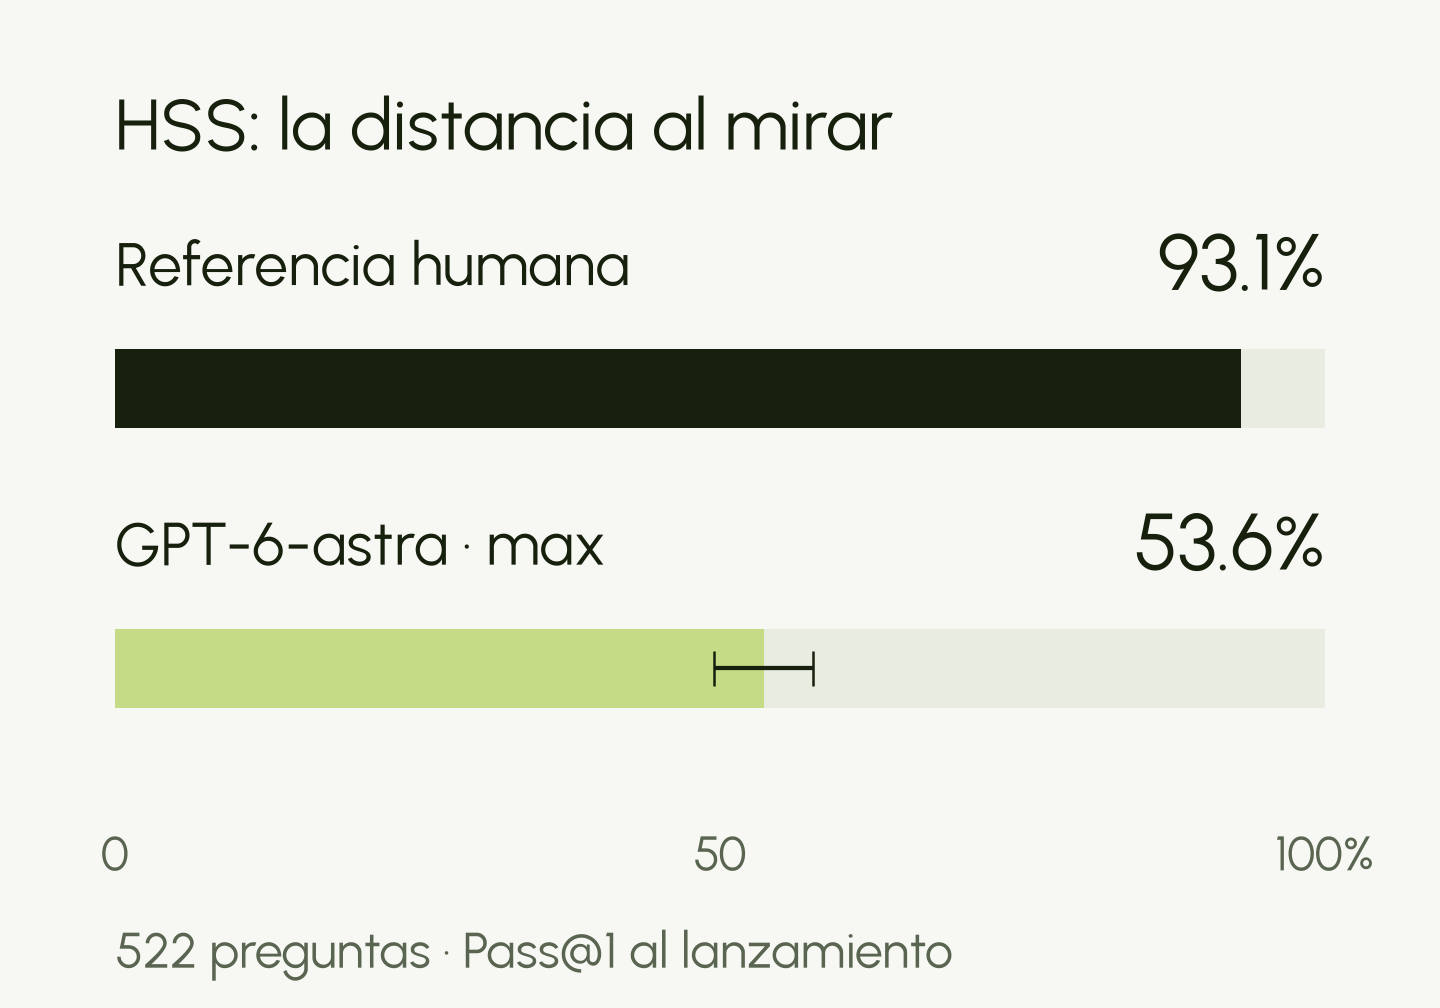
Conviene leer esa diferencia con cuidado. La referencia humana procede de 20 participantes y las preguntas pasaron por un filtro que favorecía casos en los que las personas podían ponerse de acuerdo. El estudio mide un conjunto específico de juicios visuales. No permite decir que una máquina tenga «la mitad de inteligencia» que una persona.
Además, el método de evaluación promedia los resultados de tres intentos por pregunta. Acertar una vez no convierte los tres intentos en un éxito. Tampoco significa que ningún chat vaya a resolver la foto del estante: ese ejemplo documenta lo que ocurrió con ciertas versiones y configuraciones.
Antes de pedir otra explicación, comprueba qué vio
Los autores analizaron 8,573 respuestas fallidas. Aproximadamente el 53% se clasificó como error de percepción, el 41% como fallo al inferir información implícita y el 5% como error de razonamiento lógico. El procedimiento aparece en el apéndice D del artículo científico.
Hay un detalle que cambia la lectura: esas etiquetas las asignó otro modelo, Claude-Opus-5, a partir de la pregunta, la respuesta de referencia y la respuesta evaluada. No fue una revisión humana caso por caso, y el clasificador tampoco volvió a mirar la imagen. Sería apresurado concluir que la lógica ya está resuelta y solo falta mejorar la vista.
Para el uso diario, me quedo con una costumbre sencilla: pedirle al asistente que señale la evidencia antes de discutir su conclusión.
Imagina que le mandas una captura de una página y confunde un botón deshabilitado con uno que se puede pulsar. Puede proponerte cinco pasos perfectamente ordenados, pero todos dependen de algo que interpretó mal desde el principio. Es una aplicación que yo hago del hallazgo; HSS no evaluó directamente agentes que operan navegadores.
A veces, «piénsalo mejor» debería convertirse en «muéstrame dónde estás mirando».
No siempre falta razonar: a veces falta otro dato
Los investigadores también probaron un entorno con herramientas. En un mismo subconjunto de 388 preguntas, GPT-6-astra pasó de 54.4% al responder directamente a 59.3% dentro de Codex. Son 4.9 puntos de mejora, según el apéndice F. Comparar el 59.3% con el 53.6% de la prueba completa mezclaría conjuntos distintos.
Ampliar una imagen ayuda si el detalle estaba ahí y pasó inadvertido. No revela una profundidad que la cámara nunca captó.
Si quiero saber si un mueble pasa por una puerta, necesito que el asistente distinga dos problemas: no ve bien el marco o no conoce las medidas del mueble. En el primer caso puedo tomar otra foto. En el segundo tengo que medir. Darle más tiempo para pensar no sustituye ninguno de esos datos.
Por eso me gustaría una función menos vistosa que una respuesta larga: que la IA sepa pedir el dato concreto que puede cambiar su decisión. «Necesito una vista lateral para comprobar la profundidad» ya me dice qué hacer y para qué sirve.
En una aplicación, muchas veces ni siquiera hace falta adivinar
Si le pido a un asistente que publique algo en mi sitio, la prueba de que lo hizo debería ser fácil de consultar: el registro de publicación y la dirección que puede abrir un lector. Una captura bonita del editor no demuestra lo mismo.
Lo mismo pasa con un botón: la aplicación sabe si está deshabilitado. Y con una compra: el servidor puede confirmar si se creó la orden. La imagen muestra una representación del estado del sistema, no necesariamente toda la información disponible.
Mi prioridad al diseñar esa herramienta sería darle acceso a esas comprobaciones. Me cuesta justificar que la IA deduzca una y otra vez a partir de píxeles algo que el propio programa puede responder directamente.
Esto también ajusta el panel de entrega que propuse al escribir sobre Claude Mods. Además de explicar qué hizo el agente, debería permitirme volver al estado de la página, la zona de la imagen o el instante del video en que basó una decisión. Es una propuesta de diseño, no una función que haya probado en este artículo.
La foto del estante deja una incomodidad útil. Solemos cuestionar lo que la IA piensa después de aceptar, sin revisar, lo que dice haber visto.
La próxima vez que le mande una captura, empezaré por ahí: «¿Dónde lo ves? Señálamelo».
Sobre los datos: la documentación del conjunto indica que se pasó de 3,466 preguntas iniciales a 522 tras tres rondas de revisión. La clasificación de errores abarca 24 modelos; la tabla principal incluye un vigesimoquinto añadido después. Los resultados citados corresponden a la versión del estudio publicada al lanzamiento. Los porcentajes de errores están redondeados.