
Liquid AI d1: ¿cuánto cuesta una decisión equivocada?
Responder en 8 milisegundos suena bien. Equivocarse en 8 milisegundos sale distinto. Qué ofrecen los modelos de decisión de Liquid AI y cómo elegir una tarea donde el ahorro sobreviva a los errores.
 bufferSobre el autor7 min de lectura
Una solicitud llega a soporte. Hay que decidir si va a facturación o al equipo técnico. No hace falta un ensayo: hace falta enviarla al lugar correcto.
Los nuevos modelos de decisión Liquid AI d1 están pensados para ese tipo de trabajo. Reciben información, preguntas y opciones; devuelven decisiones estructuradas y probabilidades sin redactar una respuesta token por token.
Liquid AI publicó los pesos de d1-3B y d1-omni-600M el 7 de octubre de 2026. El dato que llama la atención es una respuesta de d1-3B en 8 milisegundos sobre una RTX 4090.
Me interesa la idea. Muchas aplicaciones necesitan clasificar, filtrar o elegir una ruta miles de veces, sin conversar. Pero antes de celebrar la velocidad, haría otra pregunta: ¿cuánto cuesta mandar una solicitud al lugar equivocado?
Qué hace un modelo de decisión
En d1 puedes definir la pregunta y las respuestas posibles con lenguaje natural. El modelo procesa la entrada en una sola pasada y entrega una opción, una puntuación o probabilidades. También puede responder varias preguntas sobre el mismo material en esa pasada.
«Cero tokens de salida» se refiere a que no genera una secuencia de texto como respuesta. Todavía tiene que leer la entrada y procesar las imágenes. Una conversación larga sigue requiriendo cálculo.
Un modelo de lenguaje convencional también puede configurarse para devolver solo una etiqueta. Y si la tarea tiene un formato fijo, quizá baste una regla. Con categorías estables y suficientes ejemplos etiquetados, un clasificador especializado también merece estar en la comparación.
Lo atractivo de d1 es combinar distintos tipos de entrada, criterios que se pueden expresar con palabras y respuestas con probabilidades. Para saber si conviene, hay que enfrentarlo a alternativas razonables en la misma tarea. Compararlo únicamente con un modelo grande que escribe varios párrafos sería ponérselo demasiado fácil.
IA local con texto e imágenes; el audio requiere más cuidado
Según su ficha técnica, d1-3B tiene aproximadamente 3.12 mil millones de parámetros y admite texto e imágenes. El d1-omni-600M, de unos 587 millones, es experimental y acepta texto con imágenes o texto con audio.
Para una aplicación en español hay un detalle importante: el entrenamiento de audio descrito para d1-omni-600M se centra en solicitudes a asistentes en inglés, con clips recortados a 30 segundos. Eso no demuestra cómo funcionará con llamadas en español, mensajes que mezclan idiomas o grabaciones con ruido.
Yo prepararía ejemplos del uso real antes de asignarle esa tarea. Que un modelo acepte audio es una capacidad de entrada; que clasifique bien tus audios es una pregunta que todavía hay que responder.
Liquid también reporta un 48.57 en la parte pública de Decision Index v0.2.1 para d1-3B. La documentación aclara que es una autoevaluación con el evaluador oficial, no un envío formal a la clasificación. No es un porcentaje de acierto que se pueda trasladar a cualquier negocio.
Qué significan realmente los 8 milisegundos
Estos son algunos resultados de latencia de d1-3B publicados por Liquid. Todos están en milisegundos y proceden de pruebas del fabricante. Cada columna corresponde a una entrada distinta.
| Equipo | 1 preg. | Texto largo | Imagen |
|---|---|---|---|
| RTX 4090 | 8 | 102 | 17 |
| Jetson AGX Orin 64GB | 26 | 560 | 83 |
| Jetson Orin Nano | 50 | 1,640 | 202 |
La ficha del modelo especifica llamadas después del calentamiento; en GPU utiliza BF16 y la mediana de 20 ejecuciones. Los 8 ms de la 4090 incluyen optimización por compilación. Sin ella, la prueba de una pregunta tarda 16 ms. Una nueva forma de entrada también puede provocar un costo de compilación en la primera llamada.
Por eso el Orin Nano puede dar una respuesta en 50 ms y tardar 1.64 segundos con una entrada larga. En el producto hay que contar además la preparación de solicitudes, la espera en cola y la acción posterior. Si solo necesitas clasificar el último mensaje, enviarle toda la conversación puede ser un gasto innecesario.
Un ahorro del 76% que puede desaparecer
El siguiente ejemplo es completamente hipotético. Los precios y las tasas de error son supuestos en dólares estadounidenses para ilustrar la cuenta; no son tarifas ni resultados medidos de d1.
Supongamos 100,000 solicitudes al día. El proceso anterior envía todas a un modelo grande y paga $0.01 por solicitud: $1,000 diarios.
Ahora pasa primero cada solicitud por un modelo pequeño local. Entre equipo y operación, asumimos un costo de $0.0004 por solicitud al volumen indicado. El 20% de los casos todavía necesita el modelo grande. El costo básico queda en 100,000 × $0.0004 + 20,000 × $0.01 = $240. Ahorro: $760, un 76%.
Hasta aquí, todo bien. Pero quedan 80,000 decisiones que se resuelven automáticamente. Si el nuevo proceso introduce errores adicionales en el 0.2% de ese grupo, comparado con el anterior, aparecen 160 equivocaciones más al día. Suponiendo $3 de trabajo extra para corregir cada una, hay que agregar $480. El total sube a $720; el ahorro baja al 28%.
Si la tasa adicional llega al 0.5%, son 400 errores más y $1,200 de correcciones. Sumados a los $240 de procesamiento, el total es $1,440 diarios: $440 más que antes.
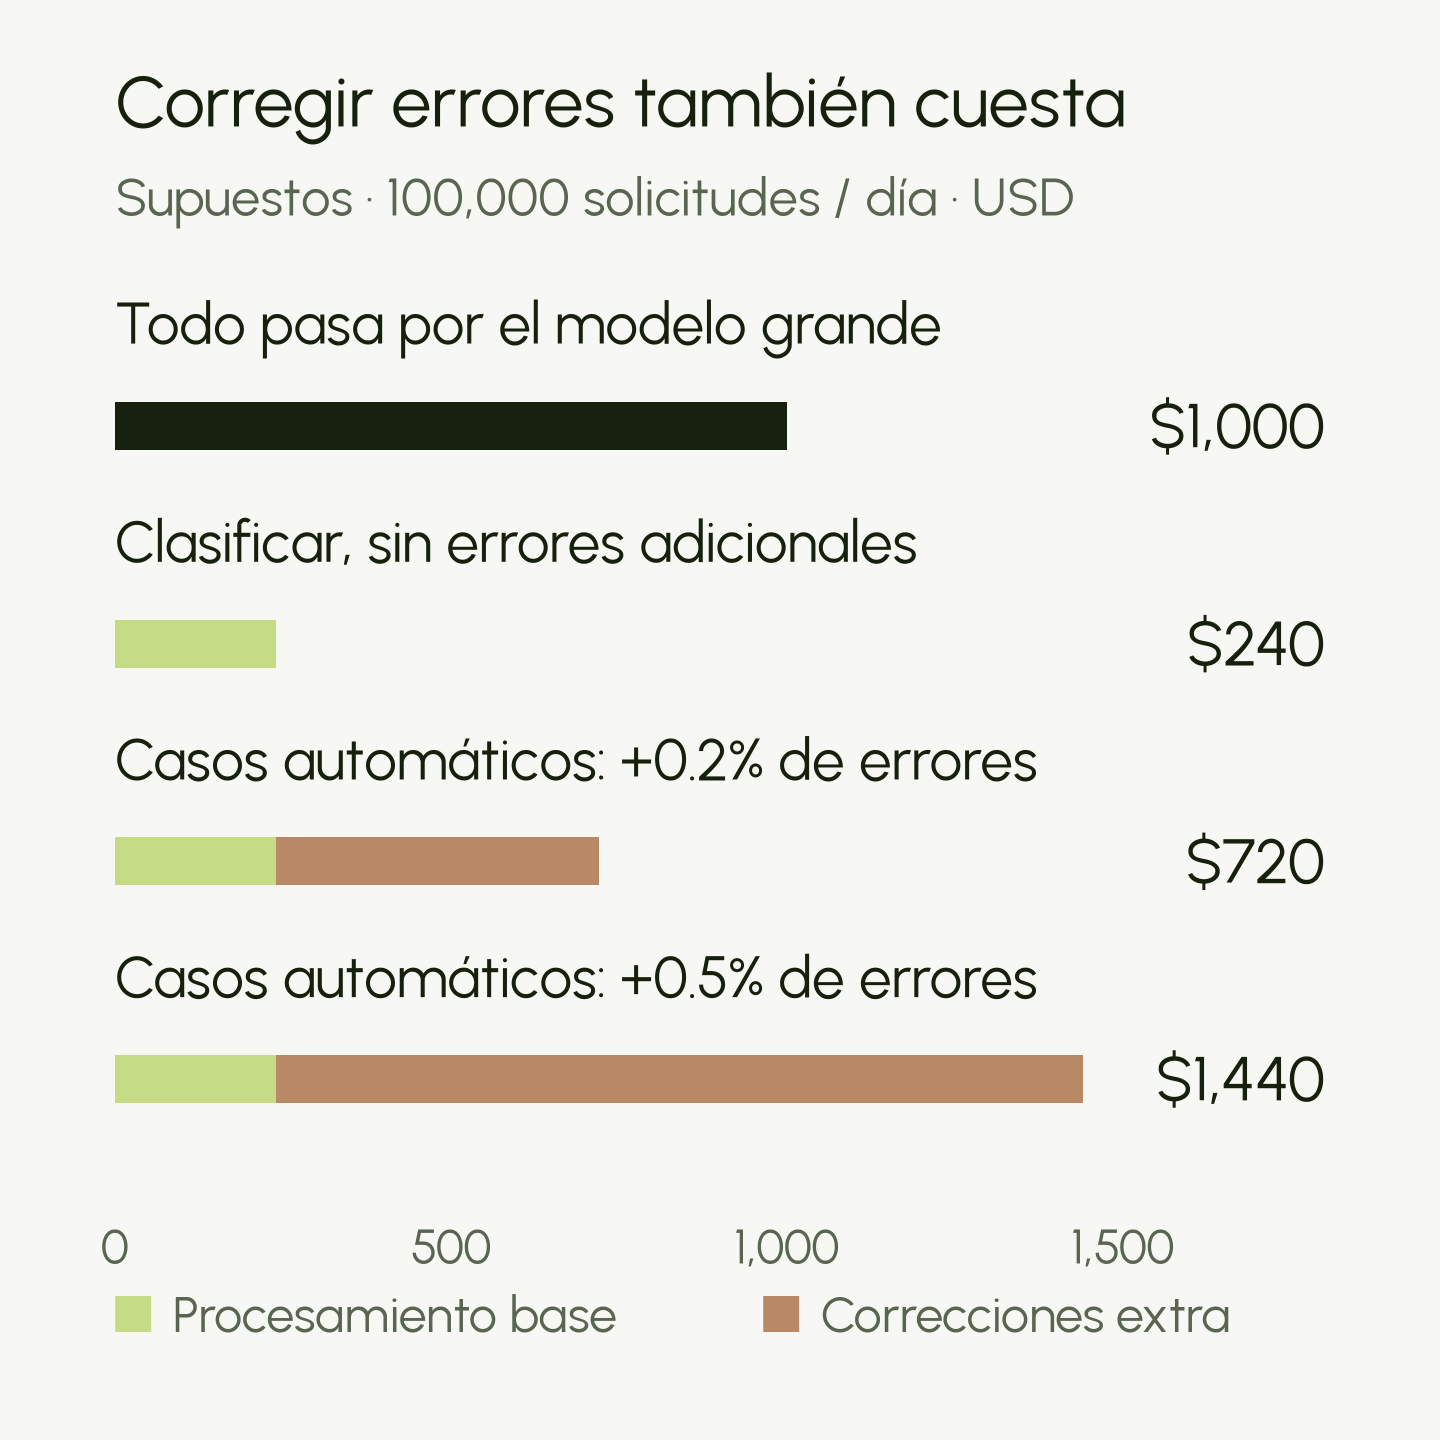
Con estos supuestos, basta una tasa de error adicional cercana al 0.32% de las decisiones automáticas para consumir todo el ahorro: $760 ÷ (80,000 × $3). Los errores que ya tenía el proceso original no se vuelven a cobrar en la cuenta. En una aplicación real, además, cada tipo de error puede tener un costo distinto.
Una etiqueta equivocada en una carpeta se corrige en segundos. Una solicitud importante que nadie atiende puede costar bastante más. La ubicación del modelo dentro del proceso cambia la cuenta, aunque el modelo sea exactamente el mismo.
El error que pasa de largo porque el modelo está muy seguro
Una solución habitual es mandar a revisión las respuestas de baja confianza. Tiene sentido, pero deja fuera un caso incómodo: que el modelo se equivoque con mucha confianza.
Imagina que clasifica una denuncia de robo de cuenta como una consulta normal de facturación, con 97% de confianza. Si revisas únicamente lo que queda por debajo del 90%, esa decisión pasa sin obstáculos.
Por eso también tomaría una muestra aleatoria de los casos aceptados automáticamente. Revisar solo las quejas o las respuestas dudosas no revela cuántos errores viajan por la ruta que parece funcionar bien. Los casos raros y costosos necesitan una revisión adicional; conviene analizar esa muestra dirigida por separado al calcular la tasa general.
Hay otro concepto útil: la calibración. Si el modelo asigna 90% de confianza a un conjunto de decisiones comparables, esperaríamos que aproximadamente nueve de cada diez fueran correctas. El trabajo de Guo y sus colaboradores presentado en ICML 2017 explica este problema. Mostrar un número no demuestra que esté calibrado para tus datos, mucho menos si cambia el idioma o el tipo de solicitud.
Y antes de ajustar umbrales, revisaría las opciones. Si la lista solo permite elegir facturación, soporte técnico o consultas generales, una denuncia de fraude ya empezó sin una ruta adecuada. Incluiría «otro / requiere revisión» y comprobaría con ejemplos que el modelo la usa cuando corresponde.
Dónde lo probaría primero
En mi blog empezaría por ordenar material de investigación: agrupar enlaces, detectar posibles duplicados y proponer qué vale la pena leer. Al principio dejaría que sugiriera decisiones en paralelo al proceso habitual, sin darle permiso para descartar fuentes o publicar conclusiones.
Así podría revisar qué acertó, qué se le escapó y cuánto tiempo costó corregirlo. Esa prueba todavía no la he hecho. Me parece una forma más útil de empezar que asignarle autoridad de inmediato por una cifra de velocidad.
Ejecutarlo localmente puede ayudar a controlar los datos, siempre que el resto del proceso también permanezca local. Los registros y los servicios externos de respaldo pueden enviar información fuera. Y el equipo cuesta dinero incluso cuando no está procesando solicitudes: hay tiempo ocioso y mantenimiento.
También hay que mirar la licencia. Los pesos usan la LFM Open License v1.0, con un umbral de ingresos anuales de 10 millones de dólares para uso comercial. No conviene confundir pesos abiertos con permiso comercial sin restricciones para cualquier organización; la definición de entidad y las condiciones están en el texto.
Al escribir sobre DeepSeek y Huawei, me interesaba cuánto de la reducción de costos llega al usuario. Con d1 añadiría otra partida: el trabajo que dejan las decisiones equivocadas.
Yo empezaría donde un error sea fácil de detectar y barato de deshacer. Después miraría el total de la cuenta. La respuesta más rápida puede ser útil; elegir dónde confiar en ella sigue siendo parte del trabajo.