

Ollama 上下文长度设置:默认值是多少,5 种改法实测(num_ctx)
长对话聊着聊着就忘了前面的内容,编程工具找不到刚读过的文件,多半是 Ollama 的上下文太小。我们在 Ollama 0.40.13 上把每一种上下文长度设置方法都试了一遍,测了几种设置同时存在时谁优先,以及设得比模型上限还大会怎样。
 buffer关于作者约 7 分钟阅读
用 Ollama 聊得稍微长一点,模型就忘了开头说过什么;接上 Claude Code 之类的编程工具,它刚读过的文件转头就找不到了。多数时候问题不在模型,而是 Ollama 给的上下文比你以为的小。
Ollama 上下文长度设置一共有好几处地方能改,改了却不生效、几处设置互相打架的情况也很常见。我们在一台没有 GPU 的 Linux 机器上,用当前的 Ollama 0.40.13 和 qwen2.5:0.5b,把每种改法都实际跑了一遍,每次都用 ollama ps 看真正生效的数字。
Ollama 默认上下文长度是多少
Ollama 官方 FAQ 写的是:默认上下文窗口是 4096 个 token。上下文长度文档写得更细,默认值按显存决定:显存小于 24 GiB 是 4k,24 到 48 GiB 是 32k,48 GiB 及以上是 256k。云端模型默认用最大上下文。
我们的测试机没有 GPU,服务启动日志里有这样一行,和文档对得上:
msg="vram-based default context" total_vram="0 B" default_num_ctx=4096什么都不设,跑 qwen2.5:0.5b,ollama ps 的 CONTEXT 一列就是 4096。要注意,ollama show qwen2.5:0.5b 显示的 context length 32768 是模型本身支持的上限,不是 Ollama 实际给它分配的长度,很多人就是被这一行误导的。
还有一处文档不一致:Modelfile 文档的参数表里,num_ctx 那一行写的还是「Default: 2048」,和 FAQ、上下文长度文档以及我们实测的 4096 都对不上,以 FAQ 和 ollama ps 为准。
Ollama 上下文长度设置的 5 种方法
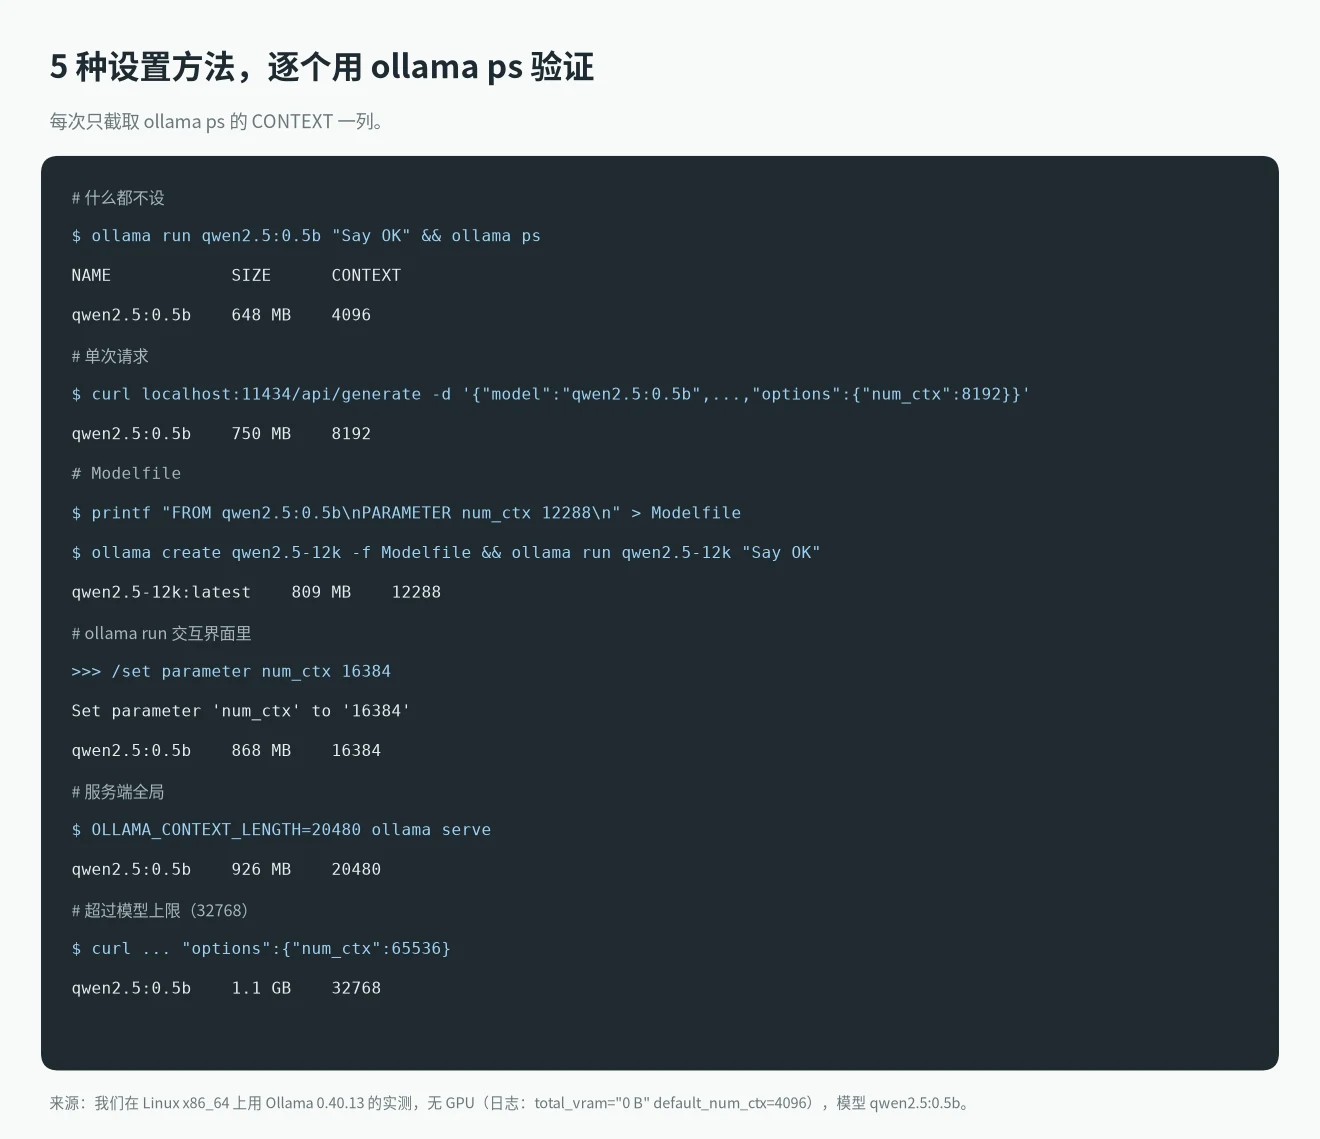
下面每种 Ollama 上下文长度设置方法我们都在 0.40.13 上实测过,图里是每次改完之后 ollama ps 显示的结果:
1. 环境变量 OLLAMA_CONTEXT_LENGTH:整个服务生效
想让所有模型、所有客户端都用同一个上下文,就在启动服务时设这个变量。我们用 OLLAMA_CONTEXT_LENGTH=20480 ollama serve 启动后,启动日志的配置里出现 OLLAMA_CONTEXT_LENGTH:20480,ollama run 跑起来 CONTEXT 是 20480。
OLLAMA_CONTEXT_LENGTH=64000 ollama serveOllama 如果是作为系统服务或桌面程序运行的,变量要按 FAQ 写的方法设,命令行里临时 export 管不到它:
- Linux(systemd):
systemctl edit ollama.service,在[Service]下加一行Environment="OLLAMA_CONTEXT_LENGTH=64000",然后systemctl daemon-reload和systemctl restart ollama。 - macOS 桌面程序:
launchctl setenv OLLAMA_CONTEXT_LENGTH 64000,然后重启 Ollama。 - Windows:先在任务栏退出 Ollama,在「编辑账户的环境变量」里新建
OLLAMA_CONTEXT_LENGTH,保存后重新打开 Ollama。
上下文长度文档还提到,桌面版 Ollama 的设置里有一个上下文长度滑块,也能改。我们的测试机是 Linux 命令行,这个滑块没测。
2. API 请求里的 num_ctx:只管这一次
调用 /api/generate 或 /api/chat 时,在 options 里带上 num_ctx:
curl http://localhost:11434/api/generate -d '{
  "model": "qwen2.5:0.5b",
  "prompt": "Say OK",
  "stream": false,
  "options": {"num_ctx": 8192}
}'我们发完这个请求,ollama ps 显示 CONTEXT 8192、占用 750 MB。接着发一个不带 num_ctx 的请求,模型被重新加载,CONTEXT 又回到 4096。所以这个参数每次请求都要带,不带就按别的设置来。
3. Modelfile 里写 PARAMETER num_ctx:固定在模型上
想让某个模型一直用固定的上下文,最稳的办法是基于它建一个新模型:
FROM qwen2.5:0.5b
PARAMETER num_ctx 12288
ollama create qwen2.5-12k -f Modelfile
ollama run qwen2.5-12k我们这样建好之后,ollama show qwen2.5-12k --parameters 显示 num_ctx 12288,运行时 ollama ps 的 CONTEXT 是 12288。之后在任何客户端里用 qwen2.5-12k 这个名字,都是这个长度。
4. ollama run 里的 /set parameter num_ctx:只管当前会话
在 ollama run 的交互界面里输入:
>>> /set parameter num_ctx 16384
Set parameter 'num_ctx' to '16384'
我们实测 CONTEXT 变成了 16384。退出后再新开 ollama run qwen2.5:0.5b,又回到 4096。想留下来,可以在设置之后输入 /save qwen2.5-16k 存成新模型,界面会提示 Created new model 'qwen2.5-16k',之后运行 qwen2.5-16k,CONTEXT 就是 16384,效果和第 3 种一样。
另外,/set 这类斜杠命令要在交互界面里手动输入。我们试过用管道把 /set parameter num_ctx 16384 送进 ollama run,它会被当成普通提问发给模型,不会改参数。0.40.13 的 ollama run --help 里也没有设置上下文的命令行参数。
5. OpenAI 兼容接口(/v1):只能靠前面的办法
很多工具用的是 Ollama 的 OpenAI 兼容接口 /v1/chat/completions。Ollama 的 OpenAI 兼容文档写明,OpenAI 的 API 没有设置上下文长度的字段,要改就用 Modelfile 建一个新模型,再在请求里用这个新模型的名字。
我们另外试了服务端的环境变量:用 OLLAMA_CONTEXT_LENGTH=20480 启动后,通过 /v1/chat/completions 调用 qwen2.5:0.5b,ollama ps 显示的也是 20480。所以走 /v1 的工具,用第 1 种或第 3 种都行。
几种 Ollama 上下文长度设置同时存在时,谁优先
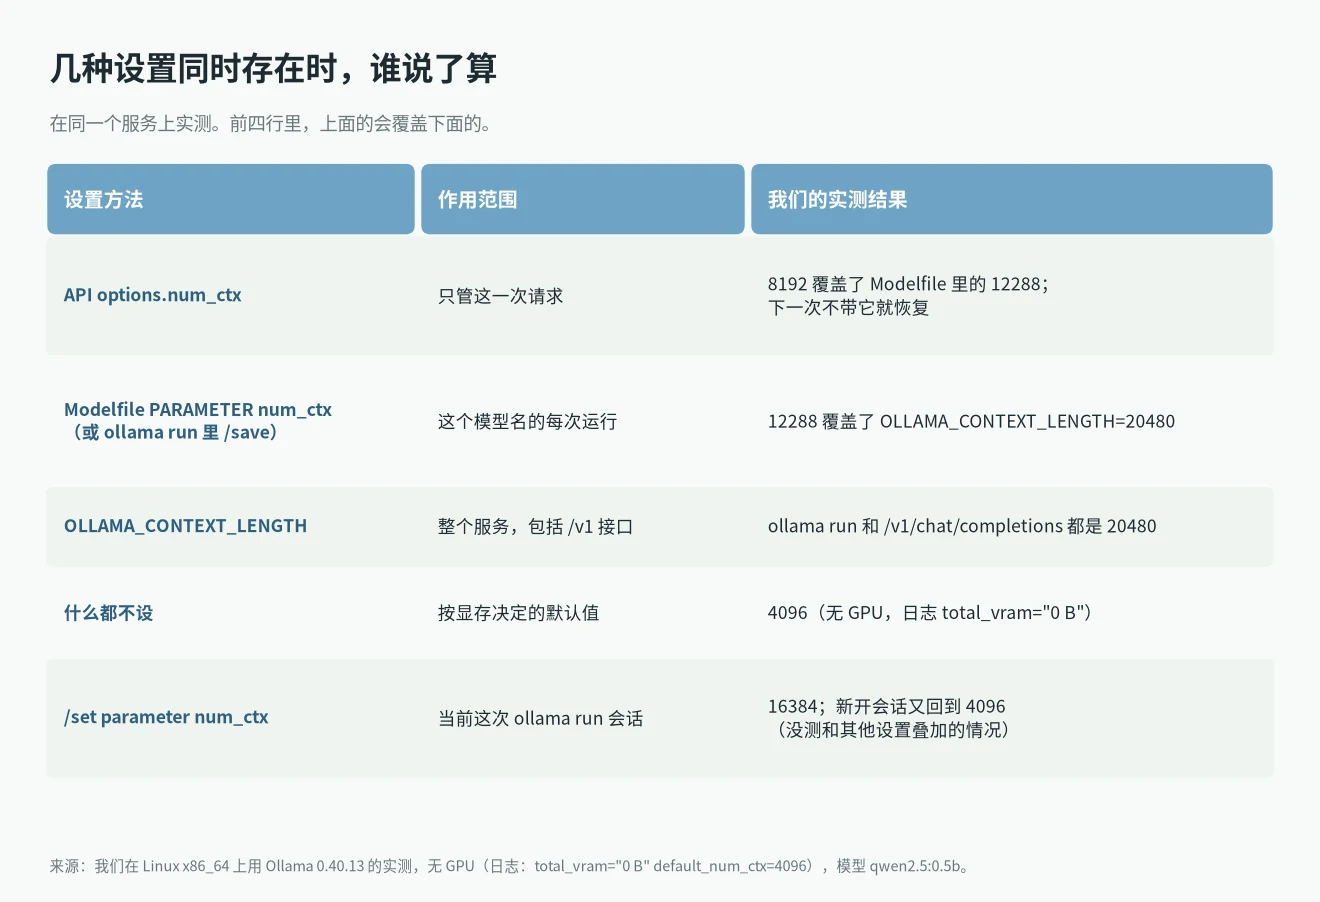
改了上下文却不生效,常见的原因是别处还有一个 Ollama 上下文长度设置把它盖掉了。我们在同一个服务上把几种设置叠在一起测了一遍:
- 服务用
OLLAMA_CONTEXT_LENGTH=20480启动,运行 Modelfile 里写了 12288 的qwen2.5-12k,CONTEXT 是 12288:模型自带的参数优先于环境变量。 - 同一个
qwen2.5-12k,在 API 请求里带"num_ctx": 8192,CONTEXT 是 8192:请求参数优先于 Modelfile。 - 所以顺序是:请求里的 num_ctx,高于 Modelfile 里的 num_ctx,高于 OLLAMA_CONTEXT_LENGTH,最后才是按显存决定的默认值。
排查时可以照这个顺序往下找。比如你设了 OLLAMA_CONTEXT_LENGTH=64000,ollama ps 却显示别的数字,就去看你用的模型是不是自己带了 num_ctx(ollama show 模型名 --parameters),或者客户端是不是在请求里传了 num_ctx。
Ollama 上下文长度设置后怎么确认生效,设太大会怎样
不管用哪种 Ollama 上下文长度设置,确认生效的数字只看一处:模型加载着的时候运行 ollama ps,看 CONTEXT 一列。上下文长度文档也是这样建议的,同时看 PROCESSOR 一列,尽量别让模型被挤到 CPU 上跑。
设得比模型上限还大,Ollama 会按上限截断。qwen2.5:0.5b 的上限是 32768,我们在请求里传了 "num_ctx": 65536,请求正常返回,ollama ps 显示 CONTEXT 32768,服务端日志里是 n_ctx_slot = 32768。也就是说,超过上限不会报错,但也不会真的给你 65536。
上下文越大,内存占得越多。同一个 qwen2.5:0.5b,我们测到的占用是:4096 时 648 MB,8192 时 750 MB,16384 时 868 MB,20480 时 926 MB,32768 时 1.1 GB。
0.5b 的模型很小,涨得不明显;换成 14B 这种模型,涨幅就是以 GB 计了,调大之后加载失败、报 model requires more system memory,处理办法见 Ollama model requires more system memory 怎么办。按模型和上下文估算要多少显存,可以用本地大模型显存计算器。
上下文设多少合适
上下文长度文档的建议是:网页搜索、智能体、编程工具这类任务,至少设到 64000 个 token。普通聊天用默认的 4096 一般够,文档没有给更细的数字。用本地模型接编程工具时,不同显卡能放下多少上下文,可以看本地大模型写代码选哪个里的估算。其他 Ollama 报错可以在Ollama 和 llama.cpp 常见报错汇总里按原文查。
常见问题
ollama show 显示 32768,为什么实际只有 4096?
ollama show 里的 context length 是模型支持的最大长度。Ollama 实际分配多少,按上面的优先级决定,什么都不设时按显存取默认值,显存小于 24 GiB 是 4096。实际值看 ollama ps。
改了 OLLAMA_CONTEXT_LENGTH 没有效果?
先确认变量传进了服务进程:启动日志里的 server config 一行应该能看到 OLLAMA_CONTEXT_LENGTH: 后面是你设的值。systemd、macOS 桌面程序和 Windows 要按上面第 1 种方法里的步骤设置,然后重启 Ollama。如果日志里是对的,ollama ps 还是别的数字,就是模型的 Modelfile 或客户端请求里另有 num_ctx。
Modelfile 文档说默认 2048,到底是多少?
在 0.40.13 上,我们的实测、启动日志和 FAQ 都是 4096(显存小于 24 GiB 时)。Modelfile 文档参数表里的 2048 和其他文档不一致。