

Calculadora de VRAM esencial y gratis para LLM locales: cuánta memoria necesita un modelo (2026)
Calculadora de VRAM para LLM locales con la fórmula explicada: pesos, caché KV y margen. Revisado con llama.cpp, la configuración de Qwen3 y Ollama el 28 de octubre de 2026.
 bufferSobre el autor9 min de lectura
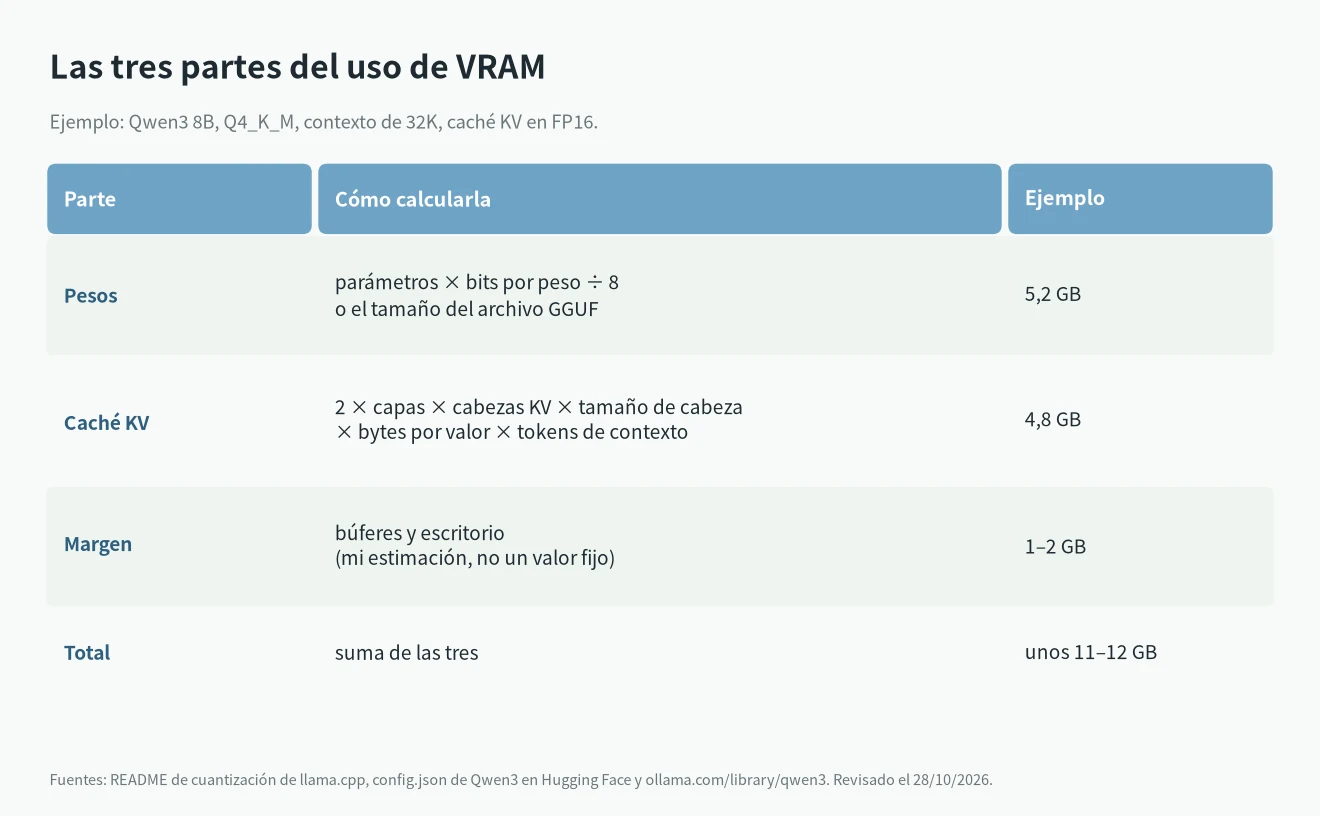
Esta calculadora de VRAM suma las tres cosas que ocupan memoria de la GPU cuando ejecutas un LLM local: los pesos del modelo, la caché KV y un margen. Con Qwen3 8B en Q4_K_M y 32K de contexto, los pesos ocupan unos 5,2 GB, la caché KV unos 4,8 GB y, con 1 a 2 GB de margen, el total queda en 11 a 12 GB. Una regla más rápida: en Q4_K_M, cada mil millones de parámetros necesita unos 0,6 GB, y luego se suma la caché KV según el contexto. Los bits por peso vienen de las notas oficiales de cuantización de llama.cpp, las capas y cabezas de los archivos de configuración oficiales de Qwen3 en Hugging Face, y los tamaños de las páginas de modelos de Ollama. Lo revisé todo el 28 de octubre de 2026. Para saber qué modelo elegir según tu VRAM, consulta los mejores LLM locales.
Respuesta corta
- Pesos: parámetros × bits por peso ÷ 8. Q4_K_M usa unos 4,89 bits por peso, Q8_0 unos 8,5 y FP16 16.
- Caché KV: crece en proporción al contexto. Qwen3 8B necesita unos 1,2 GB con 8K tokens, 4,8 GB con 32K y 19,3 GB con 128K.
- Margen: los búferes del programa y el escritorio también usan VRAM. Yo dejo 1 a 2 GB. Es mi propia regla, no un valor fijo.
- El error más común: mirar solo el tamaño del archivo y olvidar el contexto. Con un contexto largo, la caché KV puede ocupar más que el propio modelo.
Calculadora de VRAM
Elige un modelo y cambia la cuantización y el contexto. El resultado se actualiza al momento. Para otro modelo, elige «Personalizado» e introduce los parámetros, capas, cabezas KV y tamaño de cabeza. Estos datos están en el archivo config.json del modelo, en num_hidden_layers, num_key_value_heads y head_dim.
Caché KV:
Total estimado:
Es una estimación. El uso real cambia según el programa y la configuración.
La calculadora usa por defecto una caché KV en f16, que también es el valor por defecto de llama.cpp. El margen empieza en 1,5 GB y puedes cambiarlo.
La fórmula de la calculadora
Pesos
Memoria de los pesos en bytes = parámetros × bits por peso ÷ 8. Las notas de cuantización de llama.cpp dan los bits por peso medidos con Llama 3.1 8B: 4,89 para Q4_K_M, 5,70 para Q5_K_M, 6,56 para Q6_K, 8,50 para Q8_0 y 16 para F16. Qwen3 8B tiene 8.200 millones de parámetros, así que en Q4_K_M salen unos 5,0 GB. El archivo real en Ollama pesa 5,2 GB, muy cerca. Si ya descargaste el archivo GGUF, su tamaño es el dato más preciso.
Caché KV
Para escribir cada token nuevo, el modelo usa los valores K y V que cada token anterior produjo en cada capa. Esos valores se guardan en la caché KV. Tamaño de la caché KV = 2 × capas × cabezas KV × tamaño de cabeza × bytes por valor × tokens. Qwen3 8B tiene 36 capas, 8 cabezas KV y un tamaño de cabeza de 128. En f16, con 2 bytes por valor, cada token ocupa 147.456 bytes, así que 32K tokens ocupan unos 4,8 GB.
Margen
Además de los pesos y la caché KV, el programa de inferencia necesita búferes para los resultados intermedios. Si la tarjeta gráfica también conecta el monitor, el escritorio usa algo de VRAM. Esta parte cambia según el programa y la configuración, y no hay un valor oficial, así que la calculadora te deja fijarla.
Cómo cambia la cuantización el tamaño de los pesos
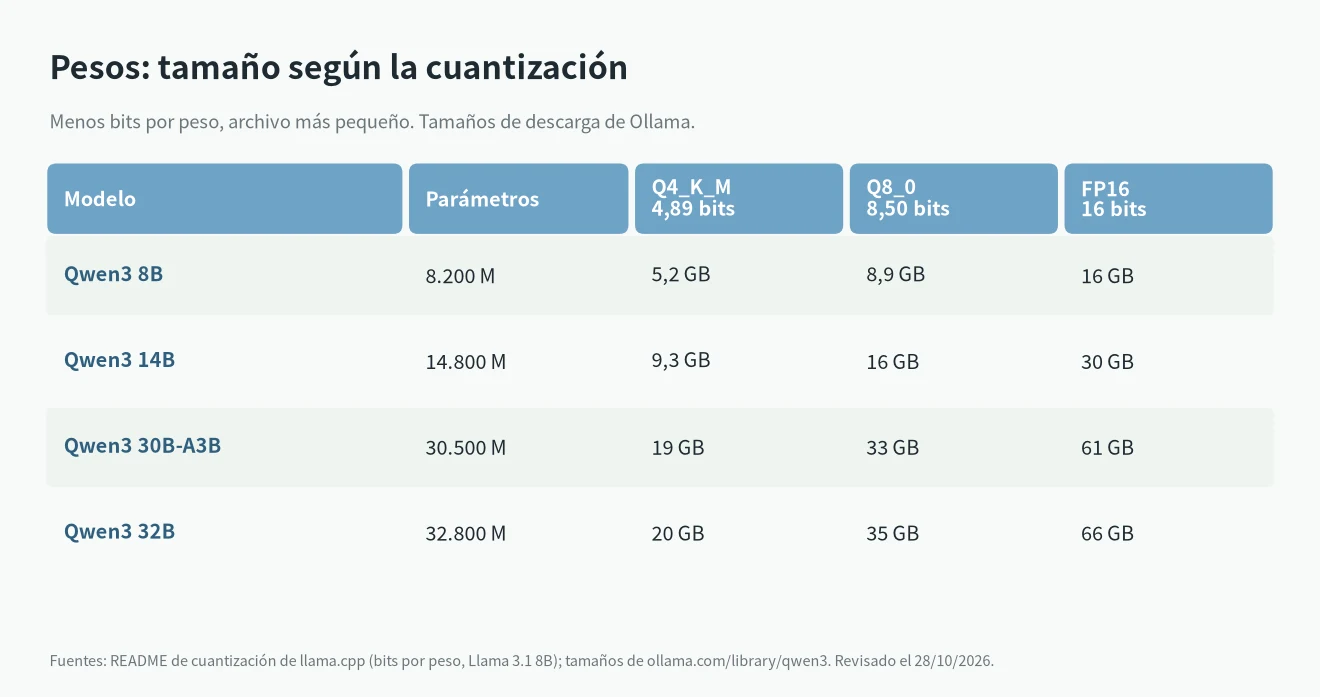
Cuantizar es guardar cada peso con menos bits. Pasar de FP16 a Q8_0 reduce el archivo más o menos a la mitad. Q4_K_M lo deja en un 30 % del tamaño en FP16. Para Qwen3 32B, Ollama indica 66 GB en FP16, 35 GB en Q8_0 y 20 GB en Q4_K_M. Para conversar y programar, Q4_K_M es la opción más común. Si tienes VRAM de sobra, Q8_0 se acerca más al modelo original.
Cómo cambia el contexto la caché KV
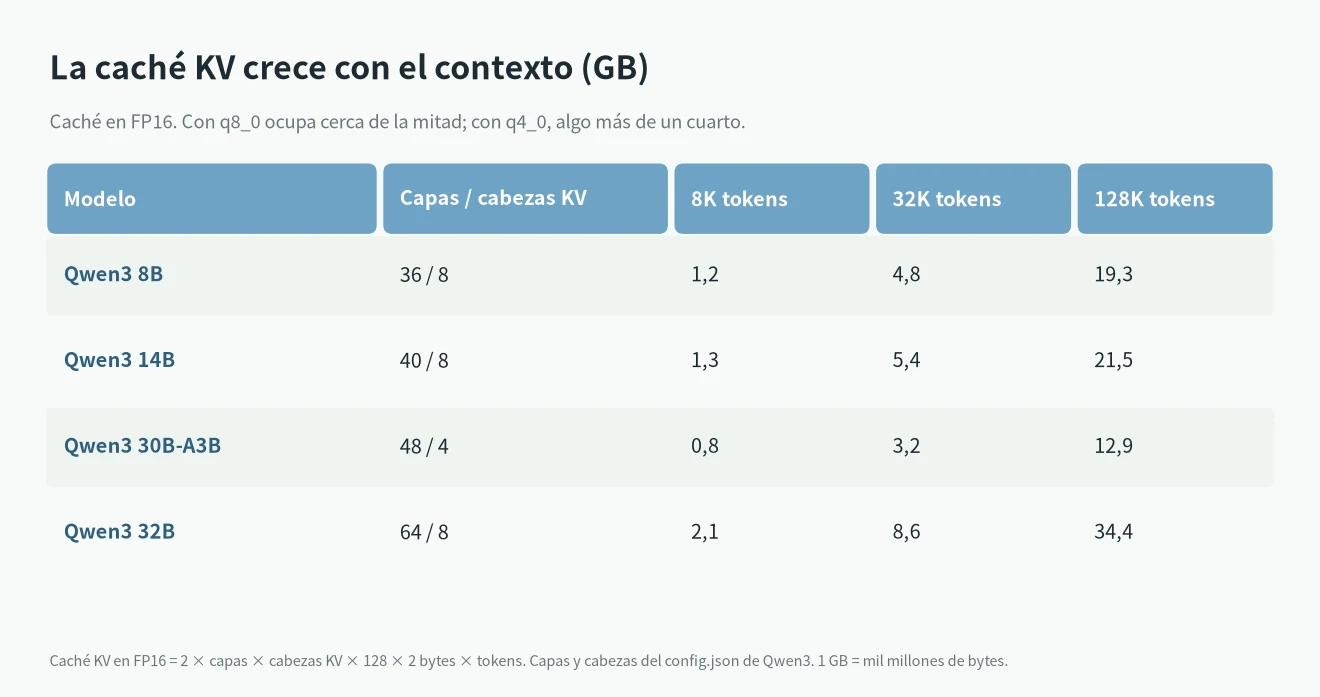
La caché KV depende de las capas, las cabezas KV y el contexto, no de la cuantización de los pesos. Qwen3 32B tiene 64 capas. Con 32K tokens su caché KV ocupa unos 8,6 GB, y con 128K unos 34,4 GB, más que sus pesos en Q4_K_M. Ten en cuenta que la ficha de Qwen3 indica un contexto nativo de 32.768 tokens; para llegar a 131.072 hay que activar YaRN.
En llama.cpp, las opciones -ctk y -ctv permiten guardar la caché KV en q8_0 o q4_0. q8_0 usa unos 8,5 bits por valor, más o menos la mitad que f16. q4_0 usa unos 4,5 bits, algo más de un cuarto.
Qué cabe en cada cantidad de VRAM
Estos totales usan Q4_K_M, caché KV en f16 y 1,5 GB de margen, todo calculado con la calculadora de arriba:
| Modelo | Contexto de 8K | Contexto de 32K | VRAM recomendada |
|---|---|---|---|
| Qwen3 8B | unos 7,9 GB | unos 11,5 GB | 12 GB o más; 16 GB va holgado |
| Qwen3 14B | unos 12,1 GB | unos 16,2 GB | 16 GB o más; 24 GB para contexto largo |
| Qwen3 30B-A3B | unos 21,3 GB | unos 23,7 GB | 24 GB o más |
| Qwen3 32B | unos 23,6 GB | unos 30,1 GB | 24 GB va justo; 32 GB es más seguro |
Para ver qué cabe en una tarjeta de 24 GB, lee Modelos que puede ejecutar la RTX 4090. Para 32 GB, lee RTX 5090 para IA.
¿Cuánta VRAM necesita un LLM?
En corto: el archivo de pesos, más la caché KV del contexto que vayas a usar, más 1 o 2 GB. En Q4_K_M son unos 0,6 GB por cada mil millones de parámetros, sin contar la caché KV. En la práctica, un modelo de 8B pide una tarjeta de 12 GB; uno de 14B, 16 GB; uno de 32B, de 24 a 32 GB; y uno de 70B, unos 48 GB o más. Cuánta VRAM necesita un LLM depende mucho más de los parámetros y la cuantización que de la marca de la tarjeta.
Un caso que se pregunta mucho es la VRAM para gpt-oss-120b. La ficha oficial de OpenAI indica 117.000 millones de parámetros (5.100 millones activos) y que, con sus pesos MXFP4, cabe en una sola GPU de 80 GB como la H100. Ollama lo descarga con 65 GB. Su config.json tiene 36 capas, pero solo 18 usan atención completa (8 cabezas KV, tamaño 64); las otras 18 guardan solo una ventana de 128 tokens. Por eso la caché KV es pequeña: unos 1,2 GB a 32K y 4,8 GB con los 128K completos. Total: unos 68 GB a 32K y unos 71 GB a 128K. Un equipo de 64 GB no llega; 80 GB de VRAM o de 96 a 128 GB de memoria unificada, sí. El gpt-oss-20b ocupa 14 GB en Ollama y pide unos 16 a 19 GB en total, así que lo de «en 16 GB» de OpenAI solo se cumple con contextos cortos.
Si repartes capas con la RAM del sistema, la cuenta es igual: lo que no cabe en la VRAM va a la RAM, así que VRAM más RAM libre tiene que cubrir el total. Funciona, pero mucho más lento.
Modelos MoE: cuenta todos los parámetros
Qwen3 30B-A3B es un modelo de mezcla de expertos (MoE). Tiene 30.500 millones de parámetros en total, pero solo 3.300 millones se activan en cada token. Por eso es rápido, pero los pesos de todos los expertos tienen que estar en memoria. Así que, al usar la calculadora con un modelo MoE, introduce el total de parámetros, no los activos. Además solo tiene 4 cabezas KV, así que con el mismo contexto su caché KV es menor que la de Qwen3 8B.
Qué hacer si no tienes VRAM suficiente
- Baja la cuantización: pasar de Q8_0 a Q4_K_M reduce los pesos alrededor de un 40 %.
- Acorta el contexto: si no vas a leer documentos largos, usa 8K o 16K. La caché KV se reduce mucho.
- Cuantiza la caché KV: añade -ctk q8_0 -ctv q8_0 en llama.cpp para reducirla más o menos a la mitad.
- Deja algunas capas en la RAM: la opción -ngl de llama.cpp fija cuántas capas van a la GPU. El resto queda en la memoria del sistema. Funciona, pero mucho más lento.
- Usa un equipo con memoria unificada: en un Mac o en un equipo con AMD Ryzen AI Max+ 395, la CPU y la GPU comparten memoria, así que caben modelos más grandes.
Mac y memoria unificada
Un Mac no tiene VRAM separada. El modelo va en la memoria unificada y la cuenta es la misma: pesos más caché KV más margen. La diferencia es que macOS usa esa misma memoria, así que conviene dejar más margen. Para equipos concretos, lee Mac mini para LLM locales y M5 para LLM locales. Con más presupuesto, lee DGX Spark vs Mac Studio. Si quieres un modelo local para programar, lee LLM local para programar.
Preguntas frecuentes
¿Cuánta VRAM necesita un modelo de 7B u 8B?
Qwen3 8B en Q4_K_M necesita unos 8 GB con 8K de contexto y unos 11,5 GB con 32K. Una tarjeta de 12 GB puede con él, y con 16 GB va más holgado.
¿Es precisa una calculadora de VRAM?
Los pesos y la caché KV salen de la configuración oficial del modelo, así que se acercan mucho. El margen depende del programa y la configuración, así que el total es una estimación. En la práctica, deja 1 GB más de lo que salga.
¿Por qué un contexto largo usa tanta más VRAM?
Porque la caché KV crece en proporción al contexto. El cuádruple de contexto es el cuádruple de caché. En Qwen3 32B, pasar de 32K a 128K tokens sube la caché KV de unos 8,6 GB a unos 34,4 GB.
¿Cuánta VRAM necesita gpt-oss-120b?
Unos 68 GB a 32K de contexto y unos 71 GB a 128K: 65 GB de pesos MXFP4, una caché KV pequeña y margen. OpenAI dice que cabe en una sola GPU de 80 GB.
¿El tamaño que muestra Ollama es la VRAM que necesito?
No. Ollama muestra el tamaño del archivo, es decir, los pesos. Al ejecutar el modelo también hacen falta la caché KV y el margen. La calculadora de esta página suma las dos cosas.