

Mac mini para LLM locales: la guía esencial 2026 de memoria, modelos y velocidad
Mac mini para LLM locales, revisado con las especificaciones y precios de Apple, los tamaños de Ollama y las pruebas de llama.cpp el 28 de octubre de 2026: qué cabe en cada memoria, qué tan rápidos son el M6 y el M5 Pro y cuál comprar.
 bufferSobre el autor7 min de lectura
¿Sirve un Mac mini para LLM locales? Sí, siempre que compres suficiente memoria. El modelo básico de 16 GB ejecuta modelos de 8B a 14B en 4 bits. Para gpt-oss-20b o Qwen3-30B-A3B, elige el M6 con 24 o 32 GB. Para un modelo de 70B en 4 bits necesitas el M5 Pro con 64 GB. Un modelo como gpt-oss-120b ocupa 65 GB, así que no cabe en ningún Mac mini. En velocidad, el M6 genera unos 36 tokens por segundo con un modelo de 7B en 4 bits y el M5 Pro unos 68, más que suficiente para chatear. Las especificaciones y los precios vienen de Apple, los tamaños de los modelos de las páginas oficiales de Ollama y las velocidades del hilo de pruebas de llama.cpp. Revisé cada cifra el 28 de octubre de 2026.
Respuesta corta
- ¿Puede ejecutar LLM? Sí. La CPU y la GPU comparten la memoria unificada, así que la GPU ejecuta el modelo directamente desde la memoria del sistema. No necesitas una tarjeta gráfica aparte.
- ¿De qué tamaño? Lo decide la memoria. Con 16 GB caben modelos de hasta 14B en 4 bits, con 32 GB un modelo de 32B en 4 bits y con 64 GB uno de 70B en 4 bits.
- ¿Qué tan rápido? Lo decide el ancho de banda. El M6 tiene 153 o 170 GB/s y el M5 Pro 307 GB/s, así que con el mismo modelo el M5 Pro genera texto casi el doble de rápido.
- Qué comprar: el M6 de 16 GB para probar, al menos 24 GB para el uso diario y el M5 Pro de 64 GB para modelos de 70B.
Modelos de Mac mini, memoria y ancho de banda
El Mac mini actual tiene dos chips. Según las especificaciones técnicas de Apple, el modelo M6 tiene CPU de 12 núcleos y GPU de 12 núcleos, parte de 16 GB y se puede configurar con 24 o 32 GB. La versión de 16 GB tiene 153 GB/s de ancho de banda y las de 24 y 32 GB tienen 170 GB/s. El modelo M5 Pro tiene CPU de 15 núcleos y GPU de 16 núcleos, parte de 24 GB, se puede configurar con 48 o 64 GB y tiene 307 GB/s. También se puede mejorar a un M5 Pro con CPU de 18 núcleos y GPU de 20 núcleos.
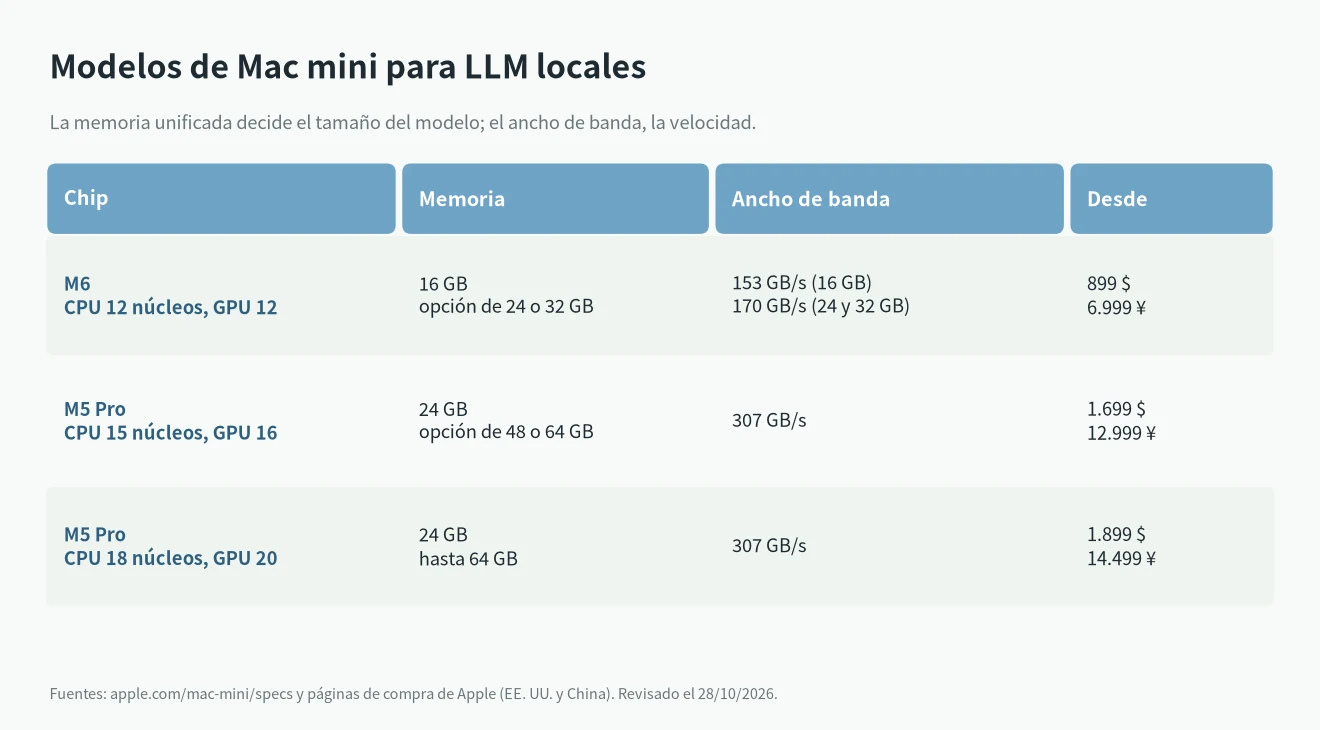
En la tienda de Apple en EE. UU., el modelo M6 cuesta desde 899 $, el M5 Pro desde 1.699 $ y el M5 Pro con GPU de 20 núcleos desde 1.899 $. En la tienda de Apple en China, los mismos modelos parten de 6.999, 12.999 y 14.499 yuanes. La memoria extra cuesta más, así que revisa el precio en la página de configuración.
La memoria va integrada con el chip, así que no se puede ampliar después. Para modelos locales, compra desde el principio toda la memoria que vayas a necesitar.
Mac mini para LLM locales: qué cabe en cada memoria
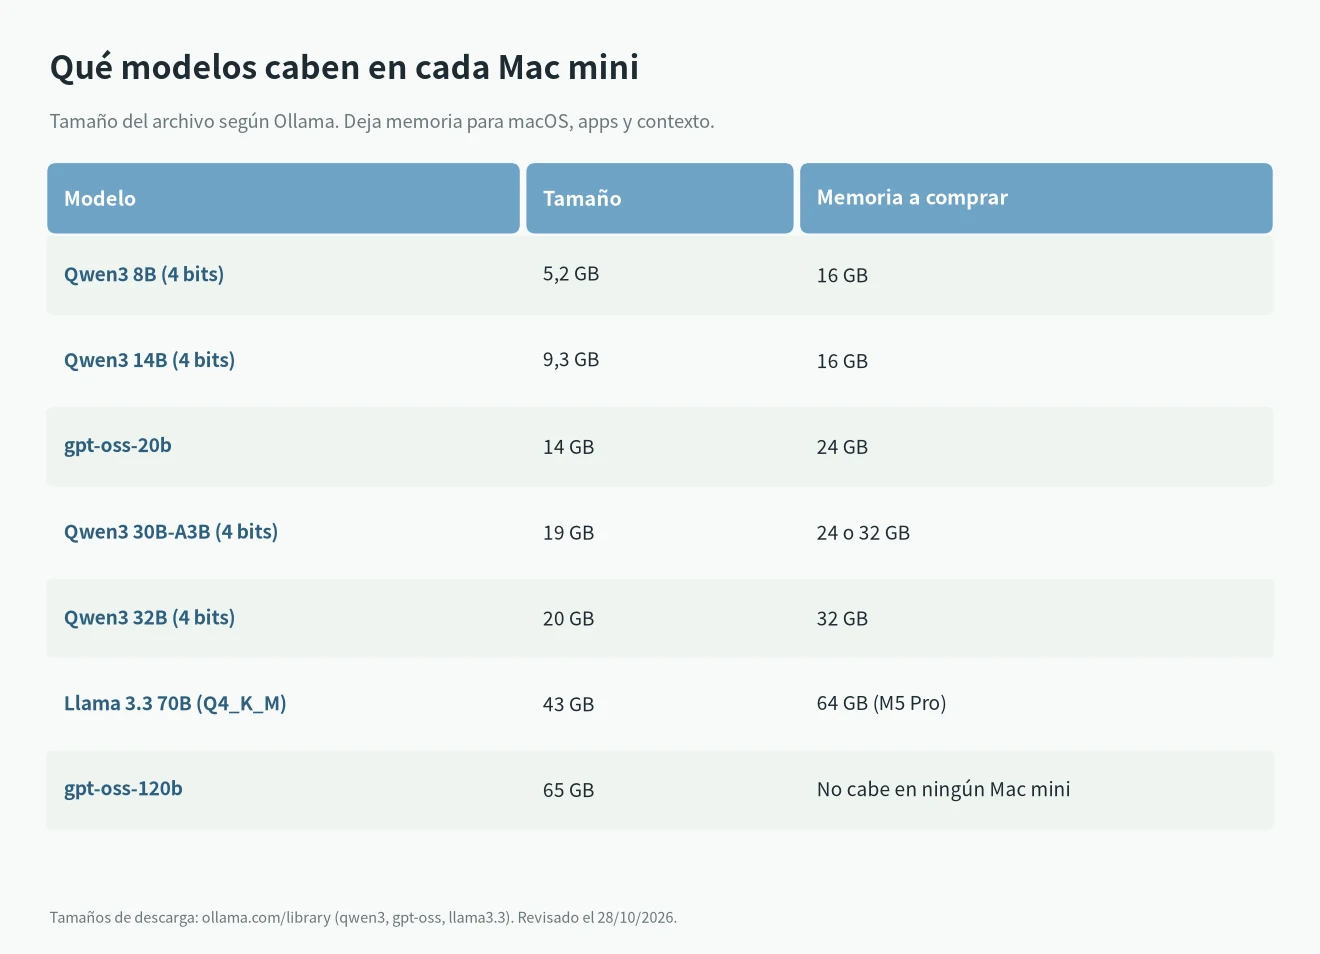
Para saber si un modelo funcionará, mira primero el tamaño de su archivo. Los tamaños de abajo vienen de las páginas de Ollama de Qwen3, gpt-oss y Llama 3.3. El uso real de memoria es algo mayor, porque el contexto también ocupa memoria y macOS y tus otras apps necesitan espacio.
Por cantidad de memoria:
- 16 GB: Qwen3 8B en 4 bits ocupa 5,2 GB y Qwen3 14B en 4 bits 9,3 GB. Los dos funcionan. Con modelos más grandes la memoria se queda justa.
- 24 GB: funcionan gpt-oss-20b (14 GB) y Qwen3 30B-A3B (19 GB). Apple midió Qwen3-30B-A3B en 4 bits con MLX en un MacBook Pro M5 de 24 GB: usó 17,31 GB, y Apple dice que una máquina de 24 GB lo aloja sin problema (pruebas de MLX de Apple).
- 32 GB: Qwen3 32B en 4 bits ocupa 20 GB, así que cabe y deja algo de espacio para el contexto. Es el máximo del M6.
- 48 y 64 GB: solo en el M5 Pro. Llama 3.3 70B en Q4_K_M ocupa 43 GB, así que 64 GB es la opción cómoda.
- No cabe: gpt-oss-120b ocupa 65 GB, más que los 64 GB máximos. Para esa clase de modelos hay que mirar equipos de 128 GB, que comparé en AI Max 395 o DGX Spark.
Velocidad: M6 frente a M5 Pro
Cada token nuevo obliga a leer los pesos del modelo desde la memoria, así que la velocidad de generación depende sobre todo del ancho de banda. Si no tienes claro qué es un token, mira qué es un token en IA.
El hilo de pruebas de llama.cpp para Apple Silicon tiene resultados de dos Mac mini, ambos con Llama 2 7B. El M6 de 32 GB genera 35,74 tokens por segundo en 4 bits (Q4_0). El M5 Pro de 64 GB con GPU de 16 núcleos genera 67,59. Con precisión completa F16, las cifras son 11,59 y 21,39. Son resultados enviados por usuarios, no mediciones de Apple.
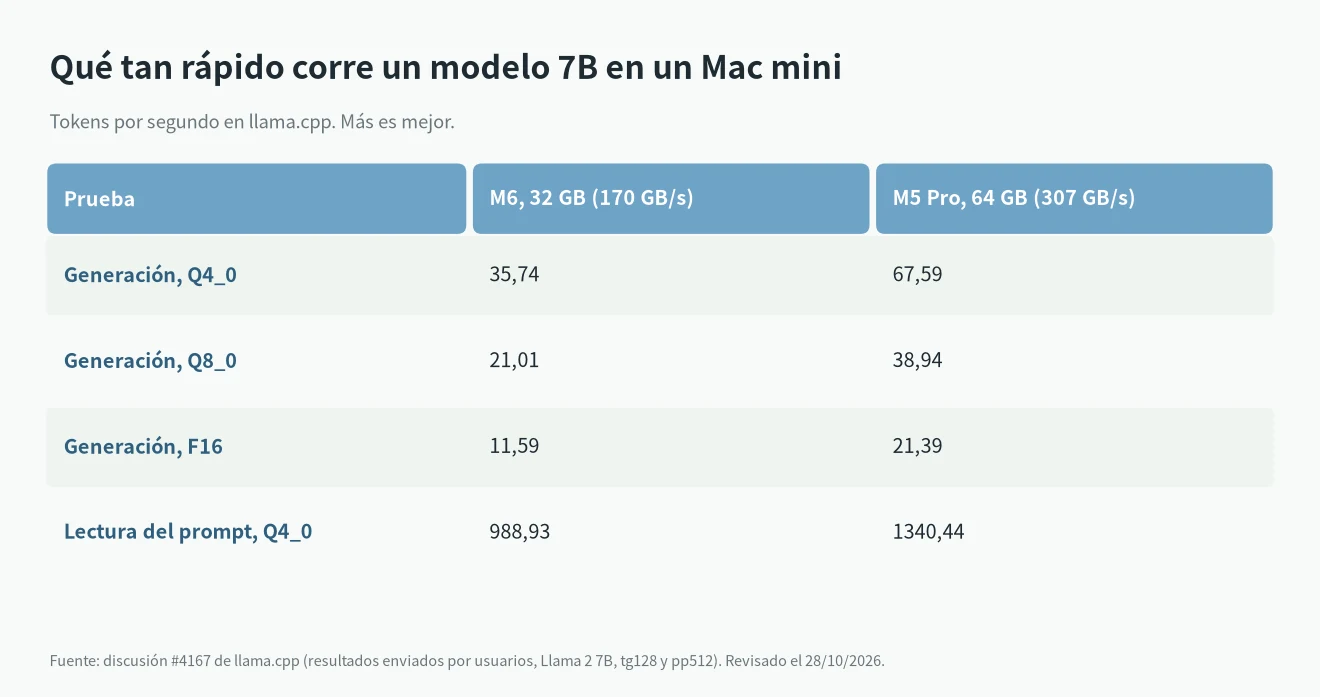
Los modelos más grandes generan más despacio. Como regla aproximada, la velocidad baja en proporción al tamaño del archivo, así que un modelo de 70B va mucho más lento que uno de 7B en la misma máquina. La lectura del prompt depende más de la potencia de la GPU, y ahí el M5 Pro también es más rápido. Las GPU del M6 y del M5 Pro incluyen Neural Accelerators (especificaciones de Apple), que MLX puede aprovechar.
Qué software usar
- Ollama: tiene app para macOS. Un solo comando descarga y ejecuta un modelo, y los tamaños de la tabla de arriba son suyos.
- MLX: el framework de código abierto de Apple. Ejecuta pip install mlx-lm y luego mlx_lm.chat para chatear. Consulta el proyecto mlx-lm.
- llama.cpp: las velocidades de arriba se midieron con él. Es para quien quiere ajustar parámetros.
Si es tu primera vez, empieza con Ollama. Tras instalarlo, escribe ollama run qwen3:8b en Terminal. Descarga el archivo de 5,2 GB y luego puedes chatear en la terminal. Mientras funciona, abre el Monitor de Actividad y mira la presión de memoria en la pestaña Memoria. Si se queda en amarillo o rojo, el modelo es demasiado grande para la máquina: elige uno más pequeño o una cuantización más baja.
Qué comprar: 16, 24, 32 o 64 GB
- Para probar modelos locales: el M6 de 16 GB, desde 899 $. Ejecuta modelos de 8B a 14B para escribir y traducir.
- Para uso diario y programar: al menos 24 GB, mejor 32 GB. Para elegir modelos de programación, mira LLM locales para programar.
- Para modelos de 70B o más velocidad: el M5 Pro de 64 GB. Con 307 GB/s genera texto casi el doble de rápido que el M6.
Para los demás Mac con M5, mira M5 para LLM locales. Si dudas entre comprar ya o esperar, mira comprar un Mac ahora o esperar.
Preguntas frecuentes
¿Es suficiente un Mac mini de 16 GB para LLM locales?
Alcanza para modelos de hasta 14B en 4 bits. Qwen3 14B en 4 bits ocupa 9,3 GB y la máquina todavía necesita memoria para macOS y otras apps, así que no se recomiendan modelos más grandes.
¿Puede un Mac mini ejecutar un modelo de 70B?
Sí, con el M5 Pro de 64 GB. Llama 3.3 70B en Q4_K_M ocupa 43 GB y el M6 llega como máximo a 32 GB, así que no lo puede alojar.
¿Qué diferencia hay entre el Mac mini M6 y el M5 Pro?
La memoria máxima y el ancho de banda. El M6 llega a 32 GB y 170 GB/s. El M5 Pro llega a 64 GB y 307 GB/s. Con el mismo modelo de 7B, el M5 Pro genera texto casi el doble de rápido.
Lo que no pude confirmar
- Apple no publica velocidades de LLM para el Mac mini. Las de arriba las enviaron usuarios de llama.cpp y cambian según el software y el modelo.
- No encontré pruebas del M6 de 24 GB ni del M5 Pro de 48 GB, así que solo se pueden estimar por el ancho de banda.
- No revisé cada precio de ampliación de memoria en la tienda, así que el artículo solo da precios de partida.