

AI Max 395 vs DGX Spark: guía esencial para elegir tu equipo de IA local (2026)
AI Max 395 vs DGX Spark con datos reales de llama.cpp: velocidad de generación parecida, Spark lee los prompts de 2 a 5 veces más rápido y los equipos AMD cuestan la mitad por GB. Precios de octubre de 2026.
 bufferSobre el autor11 min de lectura
En el AI Max 395 vs DGX Spark, la pregunta clave es para qué lo vas a usar. Si es sobre todo para chatear con un modelo local o ayudarte a programar, compra un equipo con Ryzen AI Max+ 395. Si vas a meter prompts largos y software CUDA, compra la DGX Spark. Los dos tienen 128 GB de memoria unificada y un ancho de banda casi igual: 256 GB/s frente a 273 GB/s. Por eso generan texto a una velocidad parecida. La DGX Spark lee los prompts de 2 a 5 veces más rápido y usa el software CUDA de NVIDIA. El precio es casi el doble: en octubre de 2026, un GMKtec EVO-X2 de 128 GB cuesta 3.500 $ y la DGX Spark cuesta 6.950 $ en la tienda de NVIDIA.
Mi recomendación: si usas llama.cpp, Ollama o LM Studio para chatear y programar, y pagas tú, elige un equipo AI Max+ 395. Si tu trabajo depende de CUDA, vLLM o TensorRT-LLM, si procesas documentos largos todo el día o si quieres conectar dos máquinas, elige la DGX Spark.
Escribo esto el 27 de octubre de 2026. Los dos han subido de precio varias veces este año por la escasez de memoria, así que cada precio lleva fecha y fuente. Aquí, «AI Max 395» significa el chip Ryzen AI Max+ 395 (nombre en clave Strix Halo) en su versión de 128 GB.
AI Max 395 vs DGX Spark: especificaciones
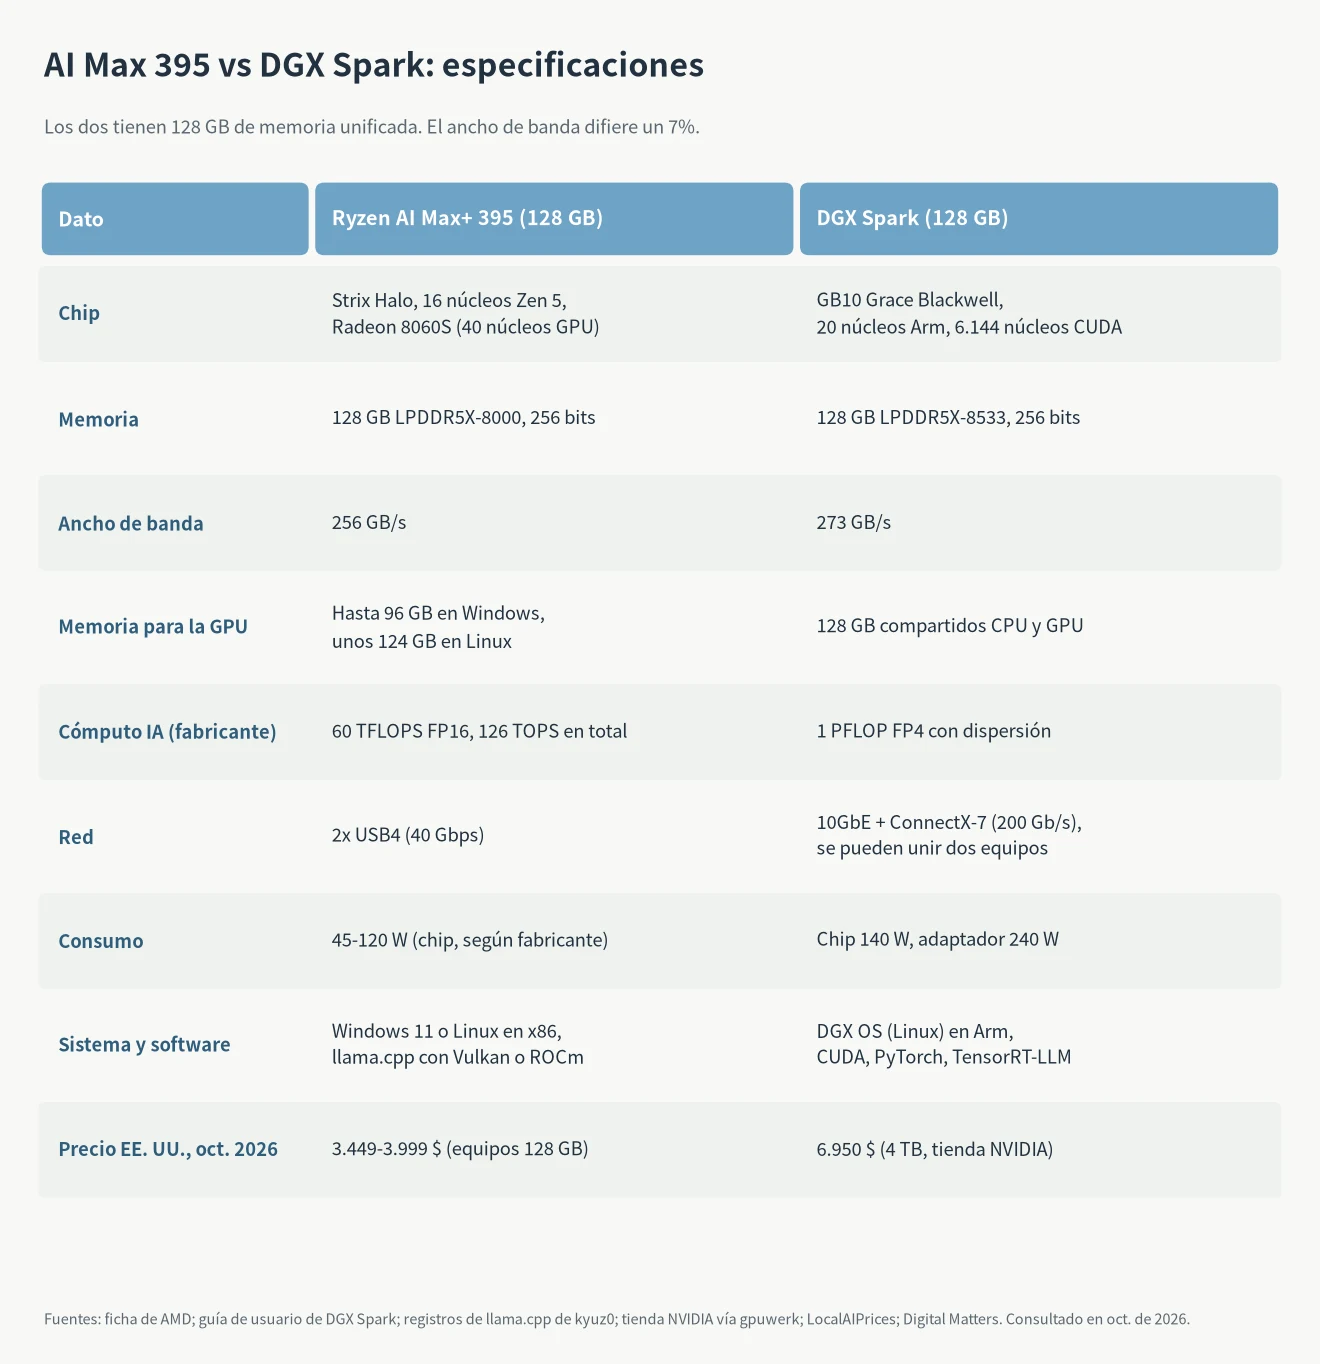
Sobre el papel se parecen mucho. Los dos usan 128 GB de LPDDR5X con bus de 256 bits, compartidos entre CPU y GPU. NVIDIA indica 273 GB/s para la DGX Spark (guía de usuario de NVIDIA DGX Spark). AMD indica LPDDR5X-8000 con bus de 256 bits para el Ryzen AI Max+ 395 (página de producto de AMD), lo que da 256 GB/s. La diferencia es del 7 %.
En el AI Max 395 vs DGX Spark, las diferencias importantes están en otro sitio:
- Potencia de cálculo. NVIDIA da 1 PFLOP en FP4 con dispersión para el chip GB10. AMD da 60 TFLOPS en FP16 y 126 TOPS en total para el AI Max+ 395. Son formatos distintos y no se pueden dividir entre sí. Lo que sí está claro es que la Spark tiene mucha más potencia para leer prompts.
- Memoria que puede usar la GPU. En Windows, el controlador de AMD deja usar hasta 96 GB de los 128 GB a la GPU (AMD, 29 de julio de 2025). En Linux, la GPU ve unos 124 GB; un registro de pruebas de Strix Halo muestra 126.976 MiB de VRAM (registro de kyuz0). En la Spark, los 128 GB son un solo bloque compartido con el sistema.
- Red. La Spark lleva una tarjeta ConnectX-7 con dos puertos QSFP de hasta 200 Gb/s, así que dos unidades pueden funcionar como una. El chip de AMD tiene dos puertos USB4 de 40 Gbps.
- Consumo. El chip GB10 tiene un TDP de 140 W y la Spark viene con un adaptador de 240 W. El AI Max+ 395 trabaja entre 45 W y 120 W, según lo que elija el fabricante del equipo.
Precios en octubre de 2026 y precio por GB
DGX Spark: 3.999 $ de salida, 6.950 $ ahora
La DGX Spark salió a la venta el 15 de octubre de 2025 por 3.999 $. El 23 de febrero de 2026 NVIDIA la subió a 4.699 $ por el suministro de memoria. Según el registro de precios de gpuwerk, consultado el 11 de octubre de 2026, la tienda de NVIDIA vende ahora la Founders Edition de 128 GB y 4 TB por 6.950 $. Tech Insider da la misma cifra.
Ahora también hay una DGX Spark de 64 GB. NVIDIA la anunció el 2 de octubre de 2026, desde 4.999 $ en fabricantes asociados a partir del 23 de octubre (blog de NVIDIA). NVIDIA dice que mueve modelos de hasta 100.000 millones de parámetros. Sale a 78 $ por GB, la opción más cara de esta comparativa.
Equipos AI Max+ 395: de 3.449 $ a 3.999 $
Muchas marcas venden mini PC con Ryzen AI Max+ 395 y 128 GB. El GMKtec EVO-X2 con 128 GB y SSD de 1 TB cuesta 3.500 $ en EE. UU., consultado el 27 de octubre de 2026 (LocalAIPrices). Digital Matters da 3.799 $ para el Minisforum MS-S1 Max de 128 GB y 3.999 $ para el Ryzen AI Halo de 128 GB de la propia AMD, lanzado en junio de 2026 (Digital Matters).
El Framework Desktop muestra lo rápido que han subido los precios. Se anunció a 1.999 $ con 128 GB. Framework lo subió a 2.459 $ en enero de 2026 por el coste de la memoria (The Verge). Digital Matters lo lista ahora a 3.449 $ y está agotado. Expliqué por qué no para de subir la memoria en por qué sube de precio la RAM.
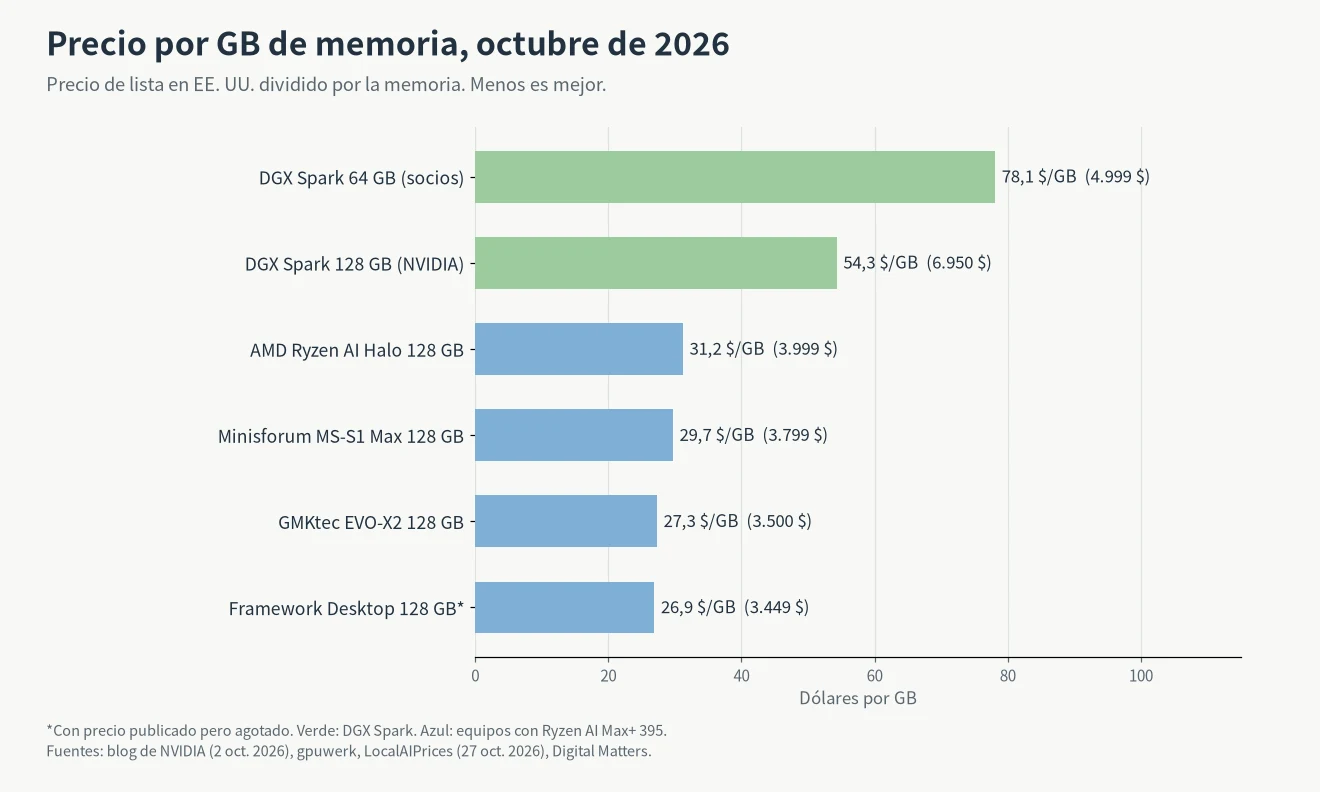
En precio por GB, la diferencia en el AI Max 395 vs DGX Spark es grande. Un equipo AI Max+ 395 de 128 GB cuesta entre 27 y 31 $. La DGX Spark de 128 GB cuesta 54 $. Si lo que pagas es capacidad de memoria, AMD te da casi el doble por cada dólar.
Velocidad real: gpt-oss-120b en tok/s
La comparación más limpia que encontré usa gpt-oss-120b, un modelo de mezcla de expertos (MoE) de 117.000 millones de parámetros que ocupa 59 GiB en MXFP4. Cabe en los dos con espacio para el contexto. Todas las cifras salen de llama-bench, la herramienta de pruebas de llama.cpp. pp2048 es la velocidad al leer un prompt de 2.048 tokens. tg32 es la velocidad al generar tokens nuevos.
La velocidad de generación es parecida
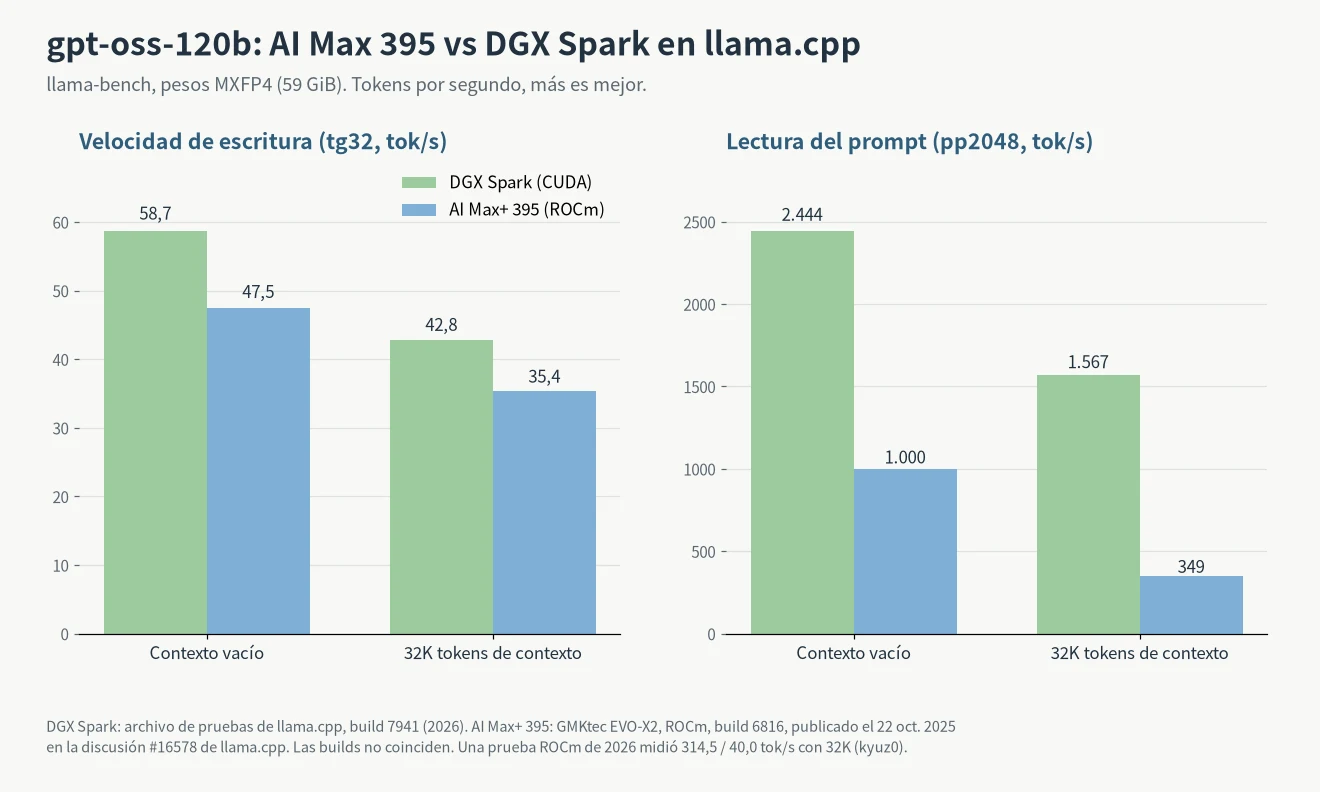
Con el contexto vacío, la DGX Spark genera 58,7 tok/s en el archivo oficial de pruebas de llama.cpp (pruebas de DGX Spark en llama.cpp). Un GMKtec EVO-X2 con AI Max+ 395 dio 47,5 tok/s con ROCm, publicado el 22 de octubre de 2025 en la discusión #16578 de llama.cpp (GitHub). Con 32K tokens ya en contexto, las cifras son 42,8 y 35,4 tok/s.
Esas dos pruebas usan versiones distintas de llama.cpp. En la misma publicación de octubre de 2025, el autor también probó la Spark con la misma versión que el equipo AMD, y dio 45,9 tok/s, un poco menos que AMD. Las actualizaciones posteriores pusieron a la Spark por delante. En cualquier caso, la diferencia del AI Max 395 vs DGX Spark al generar es del 25 % o menos, lo que encaja con la poca diferencia de ancho de banda.
Leer el prompt es donde gana la DGX Spark
Leer el prompt depende de la potencia de cálculo, y aquí la Spark va muy por delante: 2.444 tok/s con el contexto vacío y 1.567 tok/s con 32K. El equipo AMD dio 1.000 y 349 tok/s en la publicación de octubre de 2025. Una prueba más reciente de 2026 con ROCm en Strix Halo midió 314,5 tok/s con 32K (kyuz0). La Spark es unas 2,4 veces más rápida con prompts cortos y de 4 a 5 veces con prompts largos.
En la práctica, se nota en la espera. Un prompt de 30.000 tokens tarda unos 20 segundos en leerse en la Spark y más de un minuto en el equipo AMD, antes de que salga la primera palabra. En chats cortos no lo notarás. Si pegas un proyecto de código entero o un PDF largo, sí.
Los modelos densos son lentos en los dos
Los dos van rápido con modelos MoE porque cada token solo lee una parte pequeña del modelo. Con modelos densos es otra historia. LMSYS midió Llama 3.1 70B en FP8 en la DGX Spark a 2,7 tok/s (LMSYS, 13 de octubre de 2025). No encontré una prueba fiable de un 70B denso en el AI Max+ 395 en las mismas condiciones, así que no doy cifra. Con un 7 % menos de ancho de banda, no espero que sea más rápido.
Límite de tamaño de modelo: qué cabe en 128 GB
En tamaño de modelo, el AI Max 395 vs DGX Spark está más igualado de lo que dicen los precios. NVIDIA dice que una DGX Spark mueve modelos de hasta 200.000 millones de parámetros y dos unidades conectadas hasta 405.000 millones, en FP4 (NVIDIA). AMD dice que el AI Max+ 395 ejecuta modelos de hasta 128.000 millones de parámetros en Windows, con su límite de 96 GB para la GPU (AMD). En Linux la GPU de AMD puede usar más memoria, así que el límite real se acerca al de la Spark.
Ejemplos reales: gpt-oss-120b, de 59 GiB, funciona en los dos, como se ve arriba. Qwen3.5-122B-A10B en Q4 también cabe, y un AI Max+ 395 lo genera a entre 21 y 23 tok/s (pruebas de Strix Halo). Recuerda que el contexto también ocupa memoria. Un modelo de 110 GB deja muy poco sitio para una conversación larga en cualquiera de los dos.
Si piensas en DeepSeek, el modelo completo no cabe en 128 GB en ninguno de los dos. Expliqué qué versiones caben en qué hardware en mi guía para instalar DeepSeek en local.
Software: ROCm y Vulkan frente a CUDA
DGX Spark: CUDA listo para usar
El software es la mayor diferencia práctica en el AI Max 395 vs DGX Spark. La Spark viene con DGX OS, el Linux de NVIDIA basado en Ubuntu, con CUDA, Docker y el software de IA de NVIDIA instalados. NVIDIA indica soporte para PyTorch y TensorRT-LLM. LMSYS ejecutó SGLang con una imagen de Docker ya preparada (LMSYS). La mayoría de tutoriales y código de investigación dan por hecho CUDA, así que casi todo funciona sin más.
Dos avisos. La CPU es Arm, no x86, así que algunos paquetes de Python e imágenes de Docker necesitan versión Arm. Y es un equipo Linux: no vas a usar programas de Windows ni jugar en él.
AI Max+ 395: llama.cpp con Vulkan o ROCm
Los equipos AMD son PC x86 normales. Funcionan con Windows 11 o Linux y sirven para jugar. Para modelos locales, casi todo el mundo usa llama.cpp o herramientas basadas en él, como LM Studio y Ollama. llama.cpp puede usar la GPU con Vulkan o con ROCm de AMD.
Cuál va más rápido depende del modelo. En una serie grande de pruebas con ambos backends, Vulkan ganó la mayoría de pruebas de generación, mientras que ROCm y el controlador Vulkan de AMD se repartieron las de lectura de prompt (pruebas de kyuz0). Prueba los dos. No hay CUDA, así que el código que llama a CUDA directamente no funciona, y herramientas como vLLM y TensorRT-LLM están pensadas primero para NVIDIA.
AI Max 395 vs DGX Spark: cuál comprar según tu uso
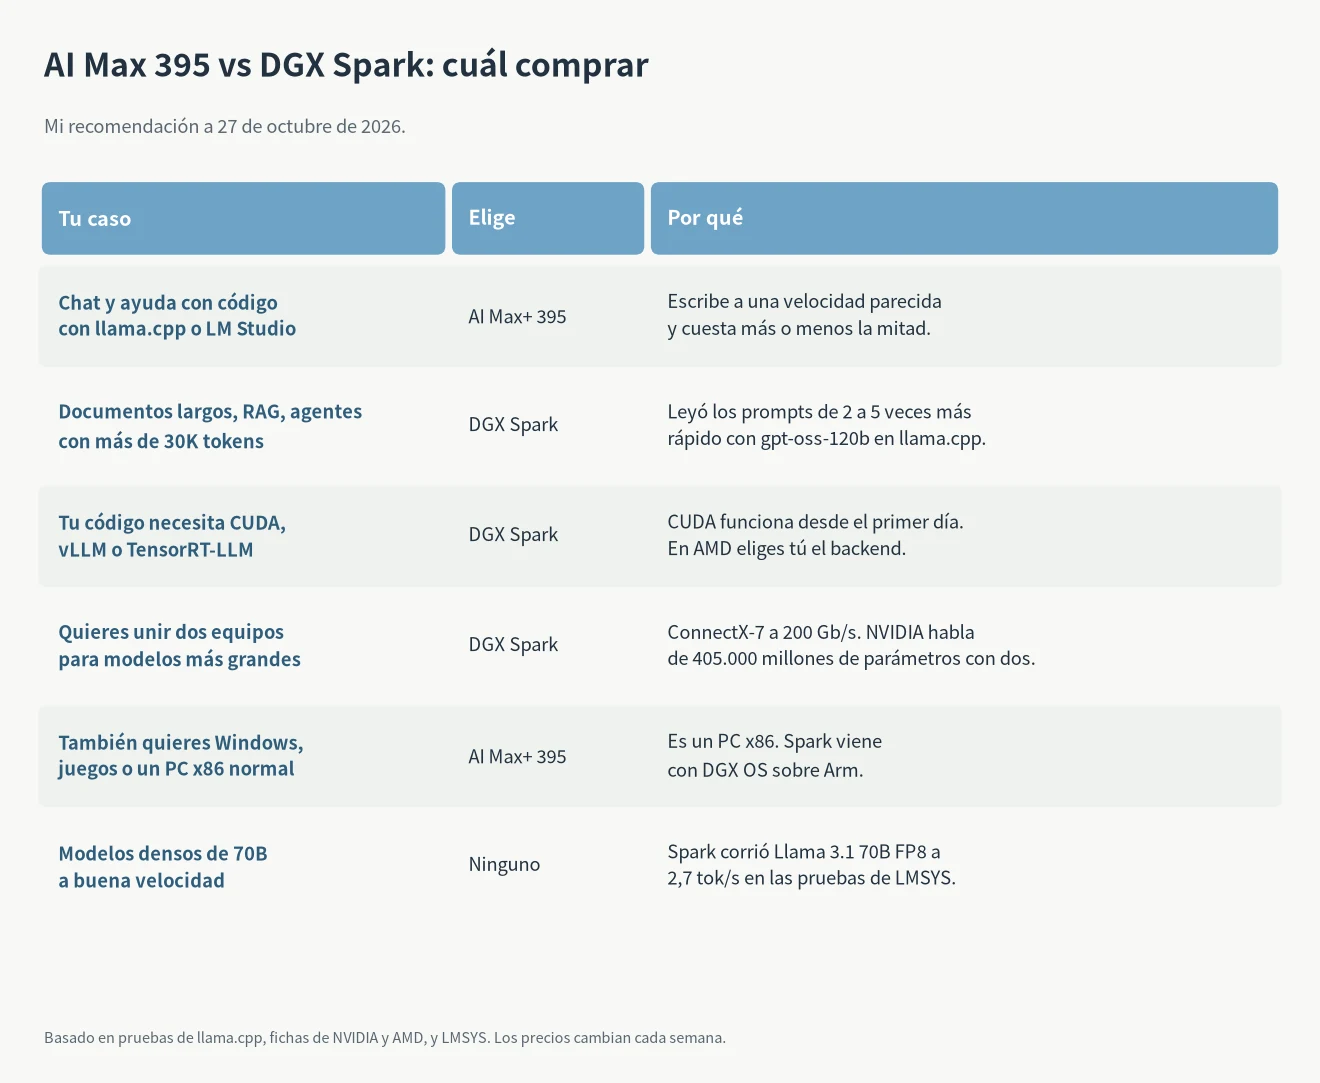
Compra un equipo AI Max+ 395 si
- Lo usas sobre todo para chatear o programar, con prompts de unos pocos miles de tokens.
- Usas llama.cpp, LM Studio u Ollama y no necesitas CUDA.
- Quieres un solo PC que también funcione con Windows y sirva para jugar.
- Lo que más te importa es la memoria por dólar. Entre 27 y 31 $ por GB, la mitad que una DGX Spark.
Compra una DGX Spark si
- Procesas documentos largos, usas RAG o agentes de programación que envían 30.000 tokens o más cada vez.
- Tu trabajo usa CUDA, vLLM, SGLang o TensorRT-LLM, o programas código que luego irá a servidores NVIDIA.
- Piensas conectar dos unidades para modelos de más de 200.000 millones de parámetros.
Mira otra opción si
Quieres modelos densos de 70B a buena velocidad. Ninguno de los dos es rápido en eso. Una tarjeta gráfica dedicada tiene varias veces más ancho de banda; analicé qué cabe en 32 GB en si vale la pena la RTX 5090 para IA. Si también estás mirando un Mac con mucha memoria, lee antes si comprar un Mac ahora o esperar.
Preguntas frecuentes
¿La DGX Spark es más rápida que el AI Max 395?
Al leer prompts, sí: de 2 a 5 veces en pruebas de llama.cpp con gpt-oss-120b. Al generar, la diferencia es del 25 % o menos, y en una prueba con la misma versión de octubre de 2025 el equipo AMD fue un poco más rápido.
¿El AI Max 395 puede ejecutar modelos de 120B?
Sí. En pruebas publicadas, gpt-oss-120b va a unos 47 tok/s y Qwen3.5-122B-A10B en Q4 a entre 21 y 23 tok/s. En Windows la GPU puede usar hasta 96 GB, así que para modelos grandes es mejor Linux.
¿Vale la pena la DGX Spark por 6.950 $?
Solo si necesitas CUDA, leer prompts largos rápido o conectar dos unidades. Para chatear y programar con llama.cpp, un equipo AI Max+ 395 genera a una velocidad parecida por la mitad de precio.
¿Cuál es la principal diferencia en el AI Max 395 vs DGX Spark?
La velocidad al leer prompts y el software. Los dos tienen 128 GB y un ancho de banda parecido, así que generan a una velocidad similar. La DGX Spark lee los prompts mucho más rápido y usa CUDA. Los equipos AMD cuestan la mitad y funcionan con Windows.
¿Conviene la DGX Spark de 64 GB?
A 4.999 $ por 64 GB sale a 78 $ por GB, más que la de 128 GB. Solo tiene sentido si necesitas el software de la Spark y tus modelos no pasan de 100.000 millones de parámetros.
Actualizaré esta comparativa AI Max 395 vs DGX Spark cuando salgan nuevas pruebas o cambien los precios.