

Modelos que puede ejecutar la RTX 4090: guía esencial 2026 de sus 24 GB
Una RTX 4090 mueve modelos de 8B y 14B con margen, 32B en Q4 hasta unos 16K de contexto y no cabe un 70B en una sola tarjeta. El cálculo de VRAM, las velocidades medidas y qué hacer cuando 24 GB no bastan.
 bufferSobre el autor10 min de lectura
¿Cuáles son los modelos que puede ejecutar la RTX 4090? Primero la conclusión. La RTX 4090 tiene 24 GB de VRAM. Mueve modelos de 8B a 14B con margen. Un modelo de 32B cabe en Q4, pero el contexto llega a unos 16K como mucho. Un modelo de 70B no cabe en una sola tarjeta. Calculé la VRAM con el tamaño real de los archivos GGUF de Hugging Face y el config.json de cada modelo. Las velocidades salen solo de pruebas publicadas. Todo revisado el 27 de octubre de 2026.
Modelos que puede ejecutar la RTX 4090: la respuesta corta
- 8B (Qwen3 8B, Llama 3.1 8B): sin problema. Incluso en F16, con precisión completa y 32K de contexto, necesita unos 21 GiB.
- 14B (Qwen3 14B): holgado en Q8_0, unos 21 GiB con 32K de contexto. En F16 solo los pesos ocupan 27,5 GiB, así que no cabe.
- MoE de 30B (Qwen3 30B-A3B): 17,3 GiB de pesos en Q4_K_M, y además es rápido.
- 32B (Qwen3 32B): solo en Q4_K_M. Unos 21,9 GiB con 8K de contexto, y el límite está en torno a 16K.
- 70B (Llama 3.3 70B): solo los pesos en Q4_K_M ocupan 39,6 GiB. No cabe. Una cuantización de 2 bits entra, pero la calidad cae mucho.
Si lo que miras es la tarjeta de 32 GB, lo expliqué en mi guía de la RTX 5090 para IA. Aquí hablo de la 4090 y solo comparo con la 5090 al final.
Las especificaciones de la RTX 4090 que importan
Según la página de NVIDIA de la RTX 4090: 24 GB de GDDR6X con bus de 384 bits, 16.384 núcleos CUDA, 450 W de consumo y una fuente recomendada de 850 W. El ancho de banda de memoria es de unos 1.008 GB/s, según la página de pruebas de Hardware Corner.
Con LLM en local, lo primero que te frena son esos 24 GB, no la potencia de cálculo. Si el modelo entero cabe en la VRAM, la 4090 va rápida. Si no cabe, una parte pasa a la RAM del sistema y la velocidad cae mucho. Por eso, para saber cuáles son los modelos que puede ejecutar la RTX 4090, hay que empezar por la VRAM.
Cómo calcular la VRAM: pesos más caché KV
Casi toda la memoria se va en dos cosas: los pesos del modelo y la caché KV, que crece con el contexto. También hace falta un pequeño margen para el programa.
Pesos: parámetros por bytes por parámetro
El README de cuantización de llama.cpp da los bits por peso medidos de cada formato. F16 son 16 bits, es decir, 2 bytes por parámetro. Q8_0 son 8,5 bits, unos 1,06 bytes. Q4_K_M son 4,89 bits, unos 0,61 bytes.
Así, un modelo de 8B ocupa unos 15 GiB en F16 y unos 4,6 GiB en Q4_K_M. Un 70B en Q4_K_M ronda los 40 GiB. Mucha gente supone que 4 bits son 0,5 bytes por parámetro. Con eso te quedas corto casi un 20%.
Caché KV: más contexto, más memoria
La fórmula es 2 × capas × cabezas KV × head_dim × tokens de contexto × bytes por elemento. En f16 son 2 bytes. Sigo el artículo de Hugging Face sobre cuantización de la caché KV. Usa el número de cabezas KV, no el de cabezas de atención. Los modelos actuales usan GQA y tienen muchas menos cabezas KV.
Qwen3 32B: 64 capas, 8 cabezas KV, head_dim 128
Por token = 2 × 64 × 8 × 128 × 2 bytes = 256 KiB
Contexto 8K = 2 GiB, 16K = 4 GiB, 32K = 8 GiB
Con la misma cuenta, Qwen3 8B usa 144 KiB por token, Qwen3 14B 160 KiB y Llama 3.3 70B 320 KiB. Las capas y cabezas salen del config.json de cada modelo, por ejemplo el de Qwen3-32B.
Al final sumo unos 1,5 GiB de margen. Esa cifra es mi estimación. Cambia según el programa y el tamaño de lote.
Qué modelos caben en 24 GB de VRAM
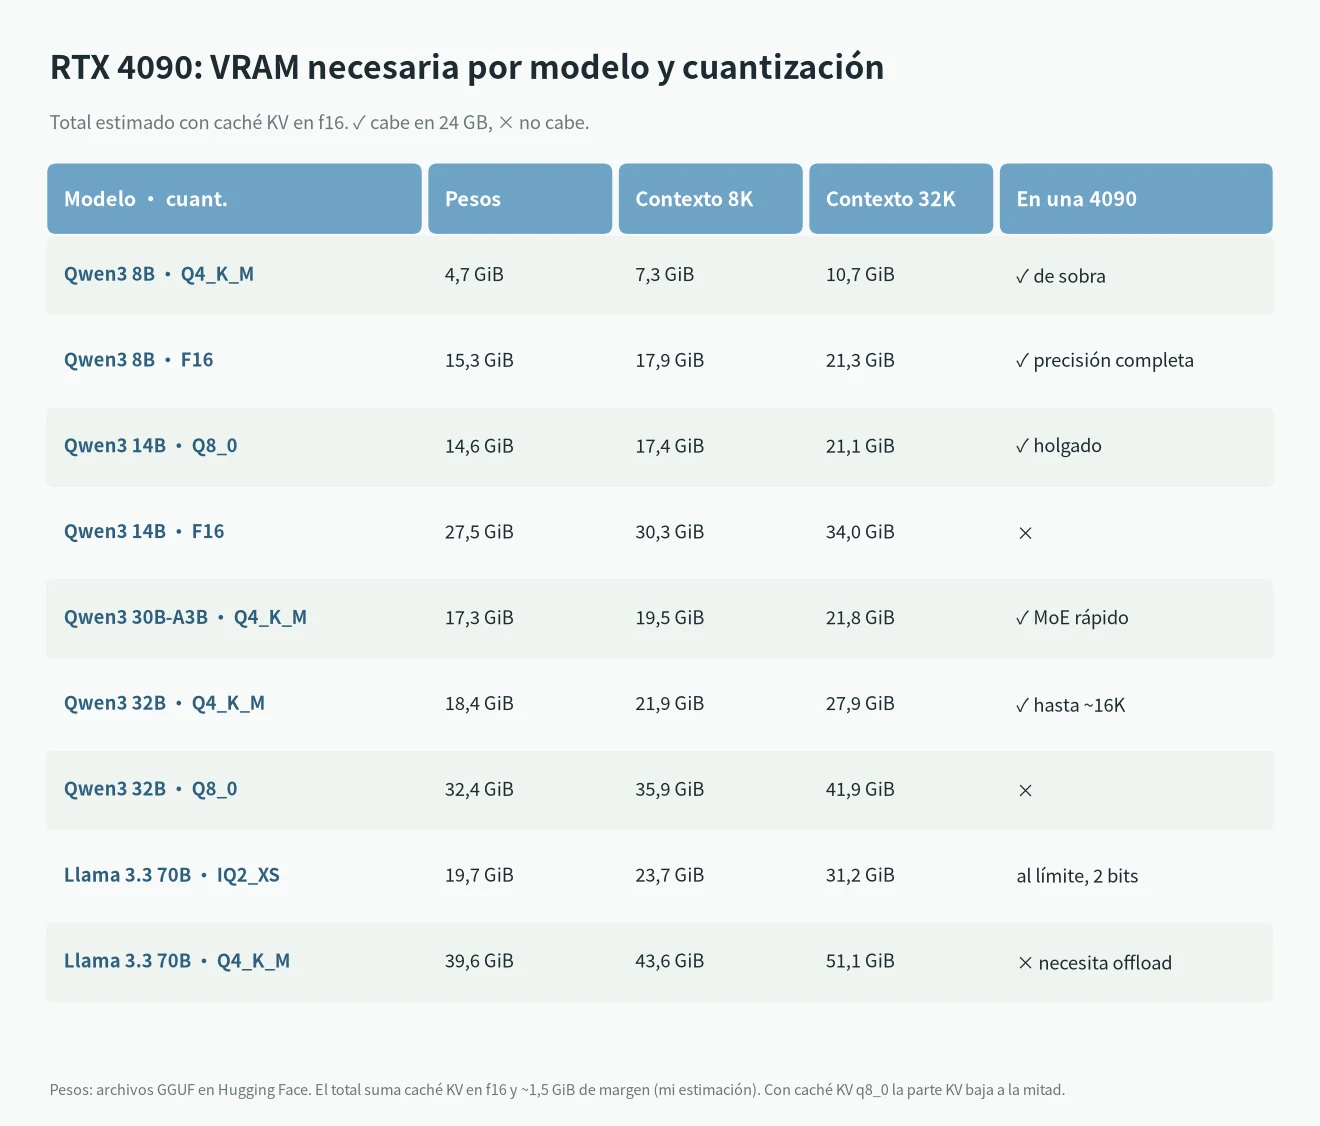
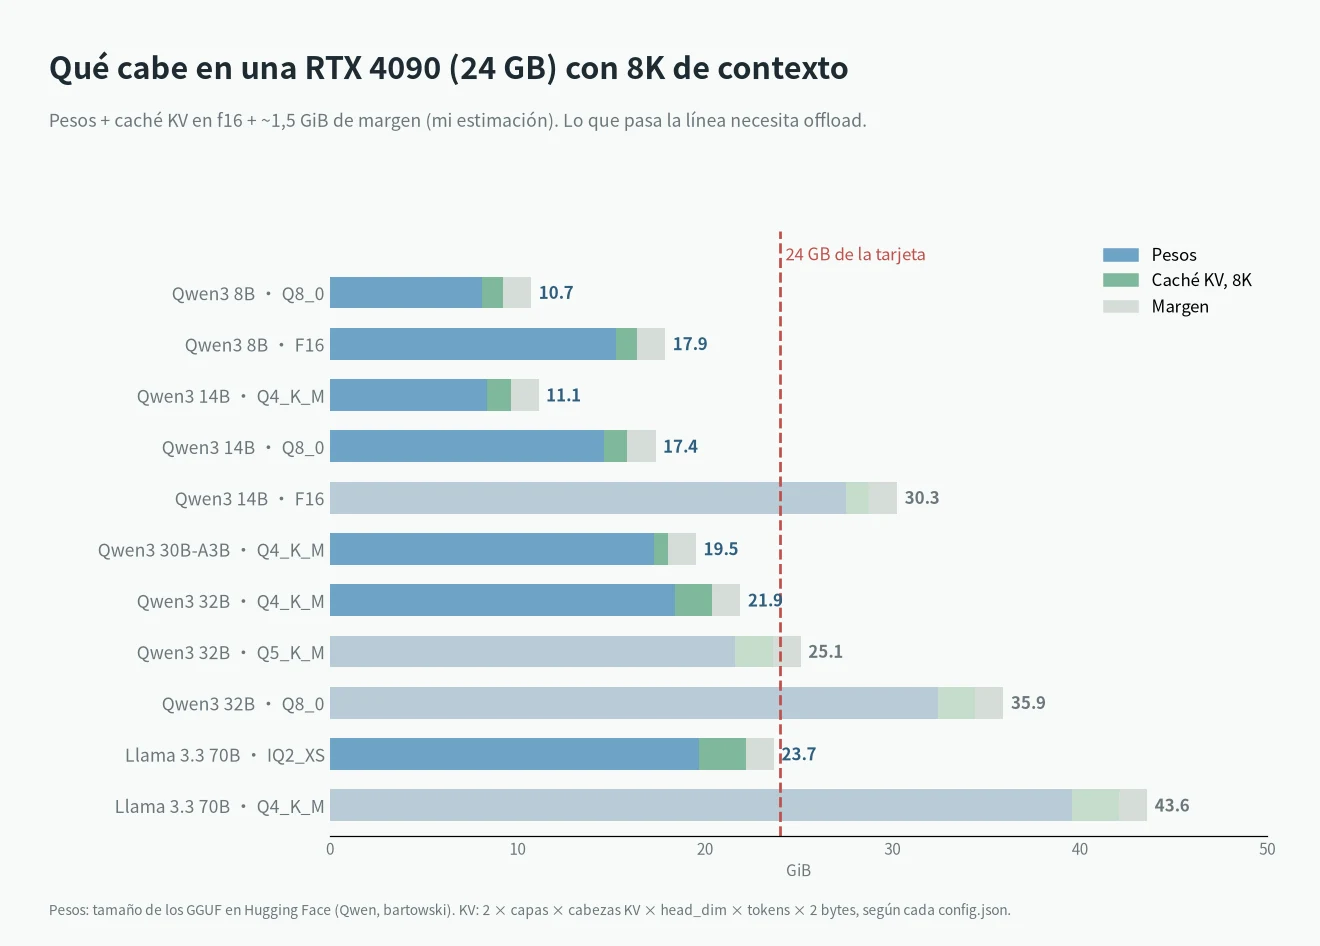
La columna de pesos usa el tamaño real de los GGUF. En el repositorio oficial Qwen3-32B-GGUF, Q4_K_M ocupa 18,4 GiB y Q8_0 32,4 GiB. Tres cosas a tener en cuenta con estos gráficos:
- No puedes darle los 24 GB enteros al modelo. El escritorio de Windows y el navegador también usan VRAM. Una configuración que llega justo a 24 puede no cargar.
- Qwen3 32B en Q4_K_M con 16K de contexto da unos 23,9 GiB según mi cuenta, justo en el límite. Hardware Corner solo probó Qwen3 32B hasta 16K en la 4090, así que coincide.
- Qwen3 30B-A3B es un modelo MoE. Solo activa unos 3B de parámetros por token, por eso es rápido. Para la VRAM cuentas igualmente sus unos 30B de parámetros.
¿Quieres más contexto? Usa caché KV en q8_0
Las preguntas frecuentes de Ollama dicen que una caché KV en q8_0 usa más o menos la mitad de memoria que en f16, con una pérdida de precisión muy pequeña. Necesita Flash Attention activado. En llama.cpp los parámetros son --cache-type-k q8_0 y --cache-type-v q8_0. Así, Qwen3 32B Q4_K_M con 32K queda en unos 18,4 + 4 + 1,5 = 23,9 GiB. Sigue justo, pero 16K pasa a ser cómodo.
Qué velocidad da la RTX 4090
Aquí solo uso cifras medidas. Estas son de las pruebas de Hardware Corner con la RTX 4090, hechas con llama.cpp y actualizadas en marzo de 2026. Son tokens generados por segundo.
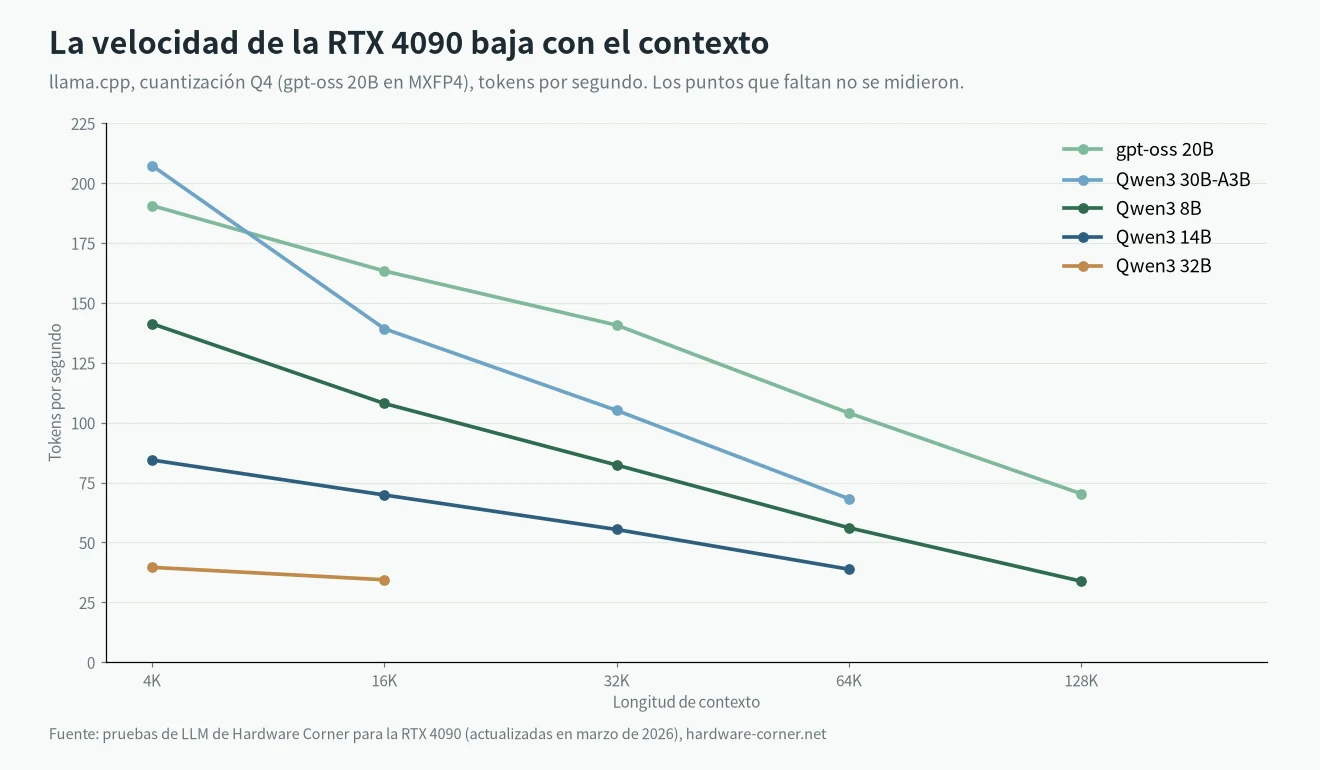
| Modelo (cuant.) | 4K | 16K | 32K | 64K |
|---|---|---|---|---|
| Qwen3 8B (Q4) | 141,3 | 108,0 | 82,3 | 56,1 |
| Qwen3 14B (Q4) | 84,4 | 69,8 | 55,4 | 38,8 |
| Qwen3 30B-A3B (Q4) | 207,3 | 139,2 | 105,1 | 68,2 |
| gpt-oss 20B (MXFP4) | 190,6 | 163,3 | 140,7 | 104,0 |
| Qwen3 32B (Q4) | 39,6 | 34,4 | sin probar | sin probar |
Otras dos fuentes cuadran. En las pruebas de XiongjieDai con llama.cpp de mayo de 2024, una 4090 movía Llama 3 8B Q4_K_M a 127,74 tokens/s y en F16 a 54,34 tokens/s. En la tabla de resultados CUDA de llama.cpp, la 4090 genera 188,96 tokens/s con Llama 2 7B Q4_0 y Flash Attention.
Procesar el prompt es mucho más rápido que generar. Hardware Corner midió Qwen3 32B a 2.448 tokens/s con 4K y a 1.707 tokens/s con 16K.
Más contexto, respuestas más lentas
La velocidad de generación baja a medida que crece el contexto. Qwen3 8B pasa de 141,3 tokens/s con 4K a 33,8 tokens/s con 128K. Cada token nuevo tiene que leer toda la caché KV. Así que no basta con que quepa. El contexto que usas de verdad decide lo rápido que va.
¿No cabe un 70B? Tus opciones
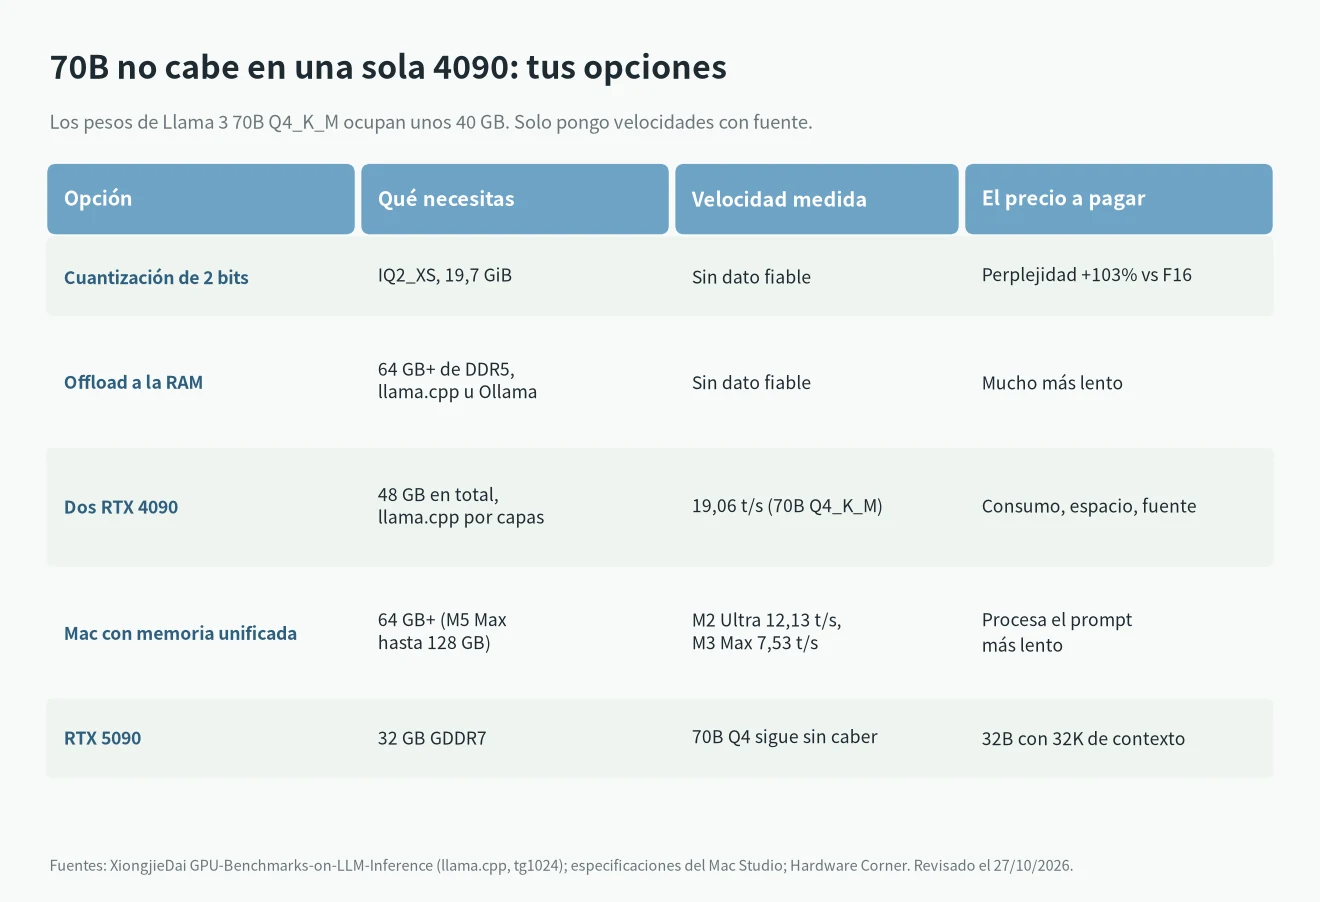
Meterlo con 2 bits
El archivo IQ2_XS de Llama 3.3 70B ocupa 19,69 GiB. Con 4K de contexto da unos 22,4 GiB, así que carga en una tarjeta. El precio es la calidad. En la tabla de perplejidad de Llama 3 70B que cita XiongjieDai, IQ2_XS sale un 103% peor que FP16, y Q4_K_M solo un 4,83% peor. No encontré una prueba fiable que lo compare con un 32B en Q4, así que no saco conclusiones. Yo no lo usaría así.
Pasar una parte a la RAM
Cuando un modelo no cabe, Ollama pone algunas capas en la memoria del sistema por su cuenta. ollama ps muestra entonces algo como «48%/52% CPU/GPU». En llama.cpp, -ngl fija cuántas capas van a la VRAM. Con modelos MoE, --n-cpu-moe deja los pesos de los expertos en la RAM.
Funciona, pero es mucho más lento. No encontré cifras fiables de una 4090 con un 70B repartido con la RAM, así que no doy ninguna. Necesitas RAM suficiente para la parte que no cabe. Para 70B en Q4_K_M yo empezaría con 64 GB. La RAM está subiendo de precio, así que mira por qué sube de precio la RAM antes de comprar.
Dos RTX 4090
Dos tarjetas suman 48 GB, y llama.cpp puede repartir las capas entre ellas. XiongjieDai midió dos 4090 con Llama 3 70B Q4_K_M a 19,06 tokens/s, y el prompt a 905,38 tokens/s. Una sola tarjeta se quedó sin memoria en la misma prueba. El precio a pagar son dos tarjetas de 450 W, así que la fuente, la caja y la refrigeración tienen que acompañar.
Un Mac con memoria unificada
En un Mac la CPU y la GPU comparten la misma memoria, así que cabe mucho más que 24 GB. Las especificaciones del Mac Studio dan el M5 Max con hasta 128 GB (460 o 614 GB/s) y el M5 Ultra con hasta 512 GB (1,2 TB/s). En las pruebas antiguas de XiongjieDai, un M2 Ultra movía 70B Q4_K_M a 12,13 tokens/s y un M3 Max de 64 GB a 7,53 tokens/s. No encontré cifras del M5 medidas igual. Si estás pensando en un Mac, mira si conviene comprar un Mac ahora o esperar.
¿Lo arregla una RTX 5090?
La 5090 tiene 32 GB de GDDR7 y 1.792 GB/s de ancho de banda. En las pruebas de Hardware Corner con la 5090, Qwen3 32B Q4 va a 61,4 tokens/s con 4K, 50,9 con 16K y todavía 43,8 con 32K. La 4090 saca 39,6 y 34,4, y 32K no se probó. En la tabla de llama.cpp, la 5090 genera 300,40 tokens/s con Llama 2 7B.
Pero 70B en Q4_K_M sigue sin caber en una 5090. Lo que arregla la 5090 es el contexto largo con 32B y Q8 con contexto largo en 14B. Las cuentas completas están en el artículo de la RTX 5090.
DeepSeek en una RTX 4090
Los DeepSeek que la gente usa en local suelen ser las versiones destiladas de R1. Se basan en Qwen o Llama y van de 1,5B a 70B. Las reglas son las mismas: 14B va sobrado, 32B necesita Q4 y 70B no cabe. El DeepSeek R1 completo tiene 671B, así que una 4090 no es una opción. La instalación y el hardware de cada tamaño están en cómo instalar DeepSeek en local, así que no lo repito.
Lo que yo haría
Al final, los modelos que puede ejecutar la RTX 4090 a gusto dependen del tamaño que más uses:
- Sobre todo 8B a 14B para programar, chatear o RAG: la 4090 sobra, y con contexto largo.
- 32B como modelo principal: funciona, y va bien hasta 16K. Si a menudo necesitas 32K o más, mira la 5090 o una caché KV en q8_0.
- Necesitas 70B sí o sí: dos 4090 o un Mac con mucha memoria. Repartir con la RAM en una tarjeta vale para probar, no para el día a día.
- Presupuesto justo: la RTX 3090 también tiene 24 GB, así que le caben los mismos tamaños, solo que va más lenta. En la tabla de llama.cpp da 158,16 tokens/s con Llama 2 7B.
Preguntas frecuentes
¿Cuáles son los modelos que puede ejecutar la RTX 4090 con fluidez?
Según Hardware Corner, los modelos de hasta 14B pasan de 55 tokens/s entre 4K y 32K de contexto. Qwen3 32B Q4 da 34,4 tokens/s con 16K, suficiente para chatear.
¿Puede una RTX 4090 ejecutar un modelo de 70B?
No entero en la VRAM. Los pesos en Q4_K_M rondan los 40 GiB. Las opciones son 2 bits, pasar parte a la RAM o una segunda tarjeta.
¿Cuánto contexto aguanta una 4090 con un 32B?
Unos 16K con caché KV en f16. Con la caché KV en q8_0 llegas a unos 32K, pero justo en el límite de 24 GB.
¿Puede una 4090 mover Qwen3 30B-A3B?
Sí. Los pesos en Q4_K_M ocupan 17,3 GiB. Hardware Corner midió 68,2 tokens/s incluso con 64K de contexto. Es de los mejores modelos para probar en una tarjeta de 24 GB.
¿Qué diferencia hay con la RTX 5090?
24 GB frente a 32 GB. Los tamaños que puedes usar a diario son casi los mismos. La diferencia está en cuánto contexto da con 32B, y en la velocidad. Ninguna de las dos mete un 70B en Q4.