

4090 能跑多大的模型?24GB 显存逐个算账,附实测速度(2026 实用版)
一张 RTX 4090 有 24GB 显存:8B、14B 很轻松,32B 只能用 Q4、上下文约 16K 到顶,70B 单卡放不下。按 GGUF 文件大小和模型参数逐个算显存,配上有出处的实测速度,再说放不下时怎么办。
 buffer关于作者约 8 分钟阅读
4090 能跑多大的模型?先说结论:RTX 4090 有 24GB 显存,跑得最舒服的是 8B 到 14B 的模型。32B 用 Q4 量化也能跑,但上下文大约 16K 就到顶。70B 一张卡放不下。下面的显存数字是我按 Hugging Face 上的 GGUF 文件大小和各模型的 config.json 算出来的,速度只用有出处的实测,北京时间 2026 年 10 月 27 日核对。
4090 能跑多大的模型:先看结论
- 8B(Qwen3 8B、Llama 3.1 8B):随便跑。F16 原始精度加 32K 上下文,也只要约 21 GiB。
- 14B(Qwen3 14B):Q8_0 很宽裕,32K 上下文约 21 GiB。F16 光权重就 27.5 GiB,放不下。
- 30B 级 MoE(Qwen3 30B-A3B):Q4_K_M 权重 17.3 GiB,而且速度很快。
- 32B(Qwen3 32B):只能用 Q4_K_M。8K 上下文约 21.9 GiB,16K 左右到顶。
- 70B(Llama 3.3 70B):Q4_K_M 光权重就 39.6 GiB,单卡放不下。2-bit 量化能硬塞进去,但质量掉得厉害。
如果你在看的是 32GB 的 5090,我之前单独写过一篇 5090 跑大模型值得买吗。这篇只讲 4090,5090 放在后面简单对比。
先把 4090 的规格说清楚
按 NVIDIA 的 RTX 4090 页面:24GB GDDR6X 显存,384 位位宽,16,384 个 CUDA 核心,整卡功耗 450W,NVIDIA 建议配 850W 电源。显存带宽约 1,008 GB/s,这个数取自 Hardware Corner 的 4090 测试页。
本地跑大模型,最先卡住你的是这 24GB,不是算力。模型能整个放进显存,4090 就很快。放不下,就得把一部分挪到内存里,速度会掉一大截。所以想知道 4090 能跑多大的模型,第一步是算显存。
显存怎么算:权重加 KV cache
吃显存的主要是两样东西:模型权重,和随上下文变长的 KV cache。另外还要留一点运行缓冲。
权重:参数量乘每参数字节数
llama.cpp 的量化说明里列了每种量化实测的 bits/weight。F16 是 16 bit,每个参数 2 字节。Q8_0 是 8.5 bit,约 1.06 字节。Q4_K_M 是 4.89 bit,约 0.61 字节。
所以 8B 的模型 F16 约 15 GiB,Q4_K_M 约 4.6 GiB。70B 的 Q4_K_M 约 40 GiB。很多人按「4-bit 就是每参数 0.5 字节」去算,结果会少算将近两成。
KV cache:上下文越长占得越多
KV cache 的公式是:2 × 层数 × KV 头数 × head_dim × 上下文 token 数 × 每个元素的字节数。f16 是 2 字节。写法参考 Hugging Face 关于 KV cache 量化的文章。注意要用 KV 头数,不是注意力头数。现在的模型基本都用 GQA,KV 头比注意力头少很多。
Qwen3 32B:64 层,8 个 KV 头,head_dim 128
每个 token = 2 × 64 × 8 × 128 × 2 字节 = 256 KiB
8K 上下文 = 2 GiB,16K = 4 GiB,32K = 8 GiB
同样的算法,Qwen3 8B 每个 token 是 144 KiB,Qwen3 14B 是 160 KiB,Llama 3.3 70B 是 320 KiB。层数和头数都取自各模型的 config.json,比如 Qwen3-32B 的 config.json。
最后再加约 1.5 GiB 运行缓冲。这个数是我的估计,不同工具、不同 batch 大小会有出入。
24GB 显存能装下哪些模型
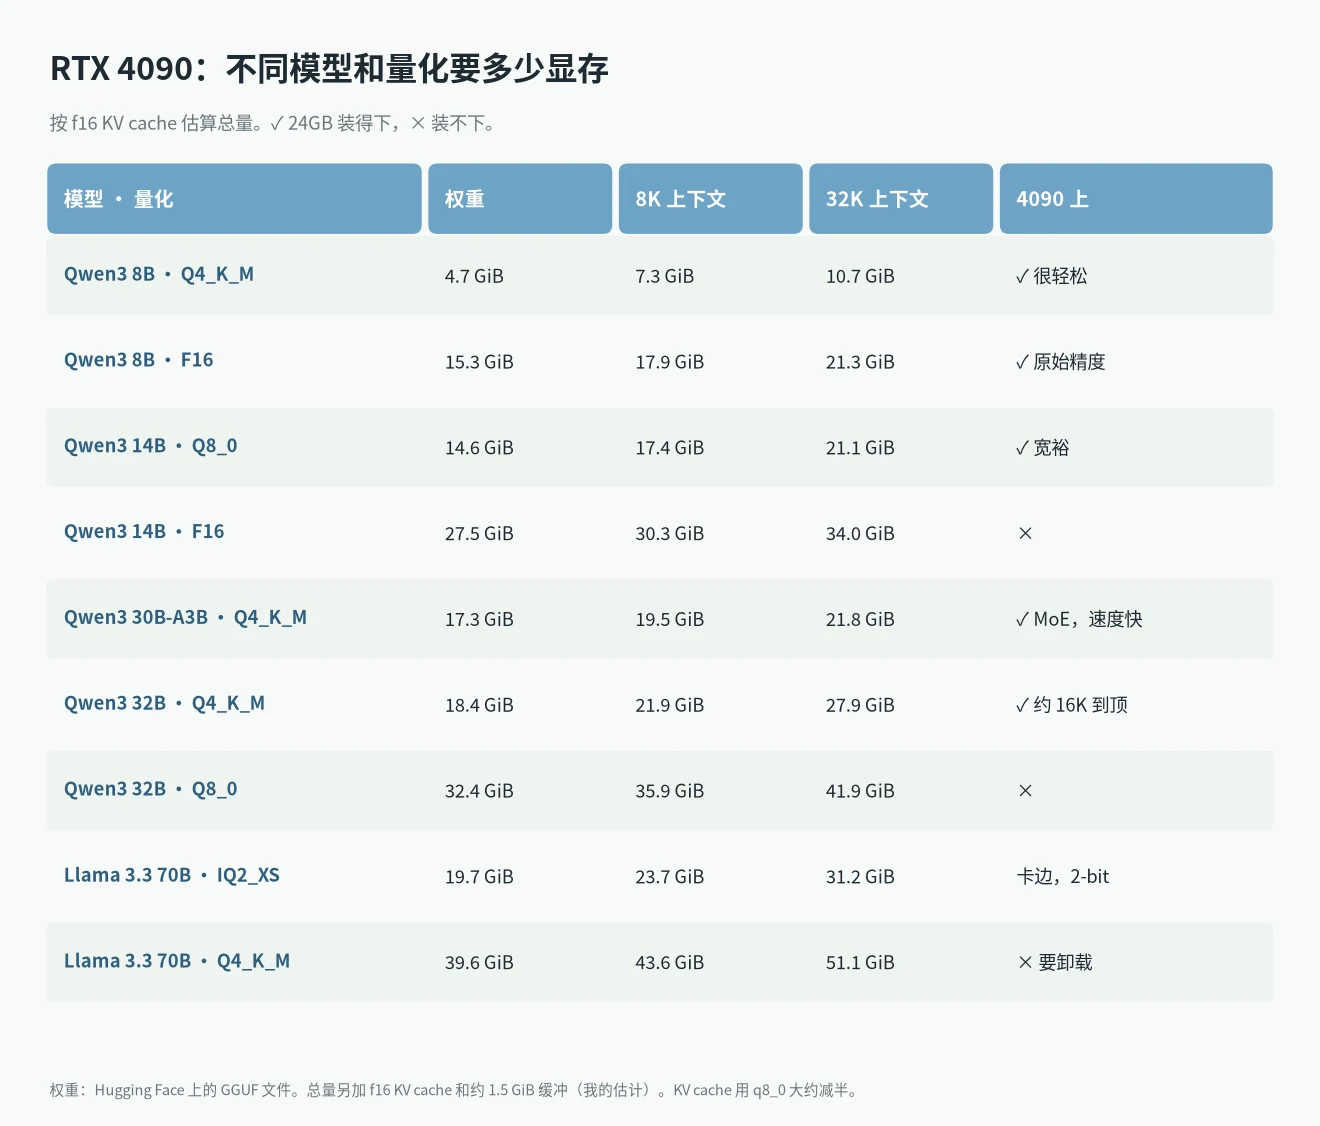
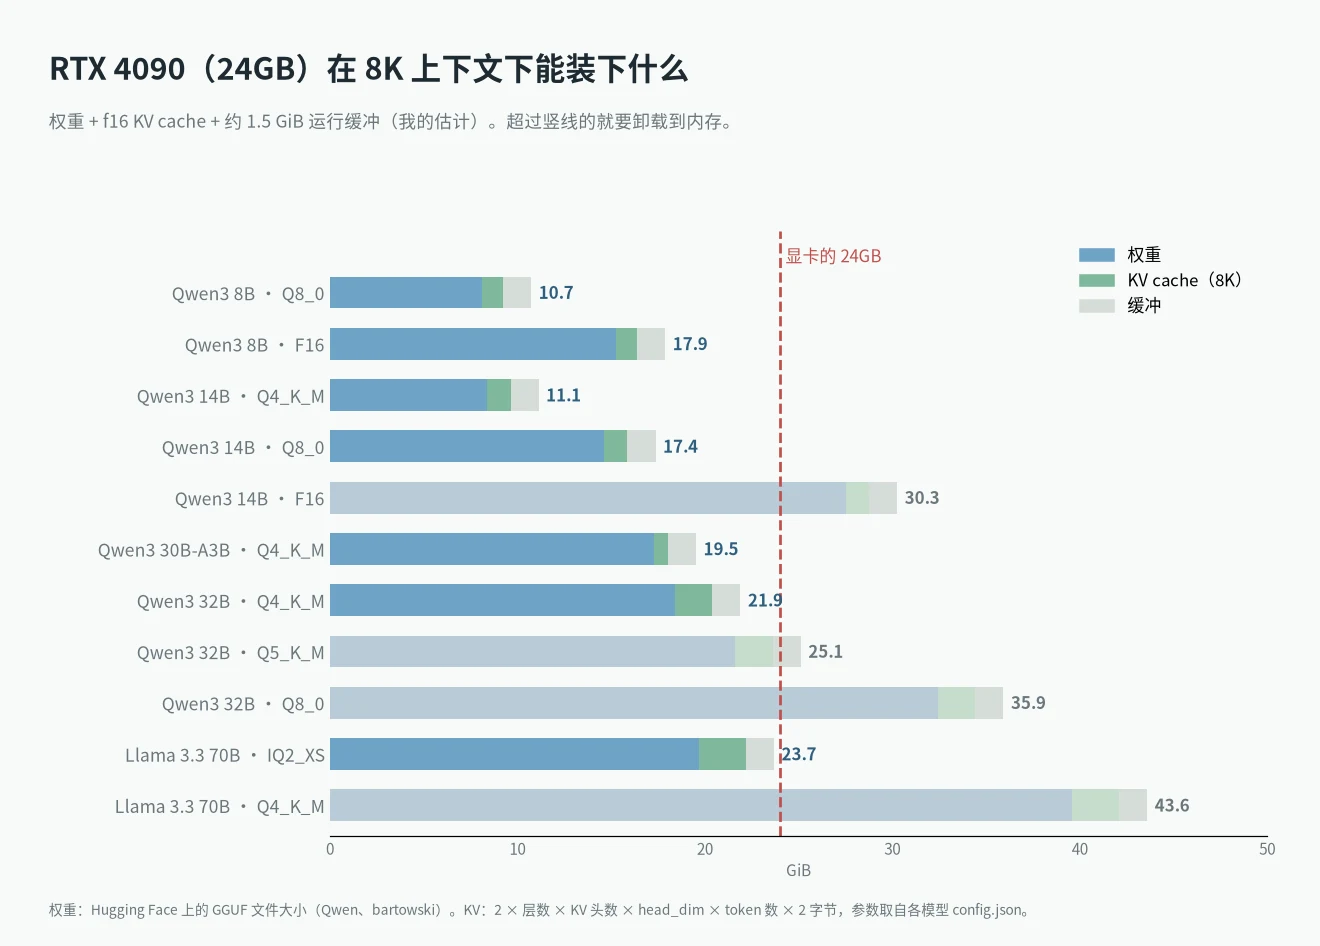
权重一栏是 Hugging Face 上实际的 GGUF 文件大小,比如 Qwen 官方的 Qwen3-32B-GGUF 里 Q4_K_M 是 18.4 GiB,Q8_0 是 32.4 GiB。想知道 4090 能跑多大的模型,主要就看这两张图。注意三点:
- 24GB 不能全给模型。Windows 桌面和浏览器也会占一些显存,总量贴着 24 的配置,实际可能放不下。
- Qwen3 32B 的 Q4_K_M 按我的算法,16K 上下文约 23.9 GiB,已经贴边。Hardware Corner 在 4090 上测 Qwen3 32B 也只测到 16K,两边对得上。
- Qwen3 30B-A3B 是 MoE 模型,每个 token 只激活约 3B 参数,所以生成很快。但算显存要按全部约 30B 参数算。
想开更长的上下文:KV cache 用 q8_0
Ollama 的 FAQ 写得很清楚:q8_0 的 KV cache 大约只占 f16 一半的内存,精度损失很小,前提是开了 Flash Attention。llama.cpp 里对应的参数是 --cache-type-k q8_0 和 --cache-type-v q8_0。这样 Qwen3 32B Q4_K_M 开 32K,大约是 18.4 + 4 + 1.5 = 23.9 GiB,还是很紧,但 16K 就宽松了。
4090 跑起来有多快
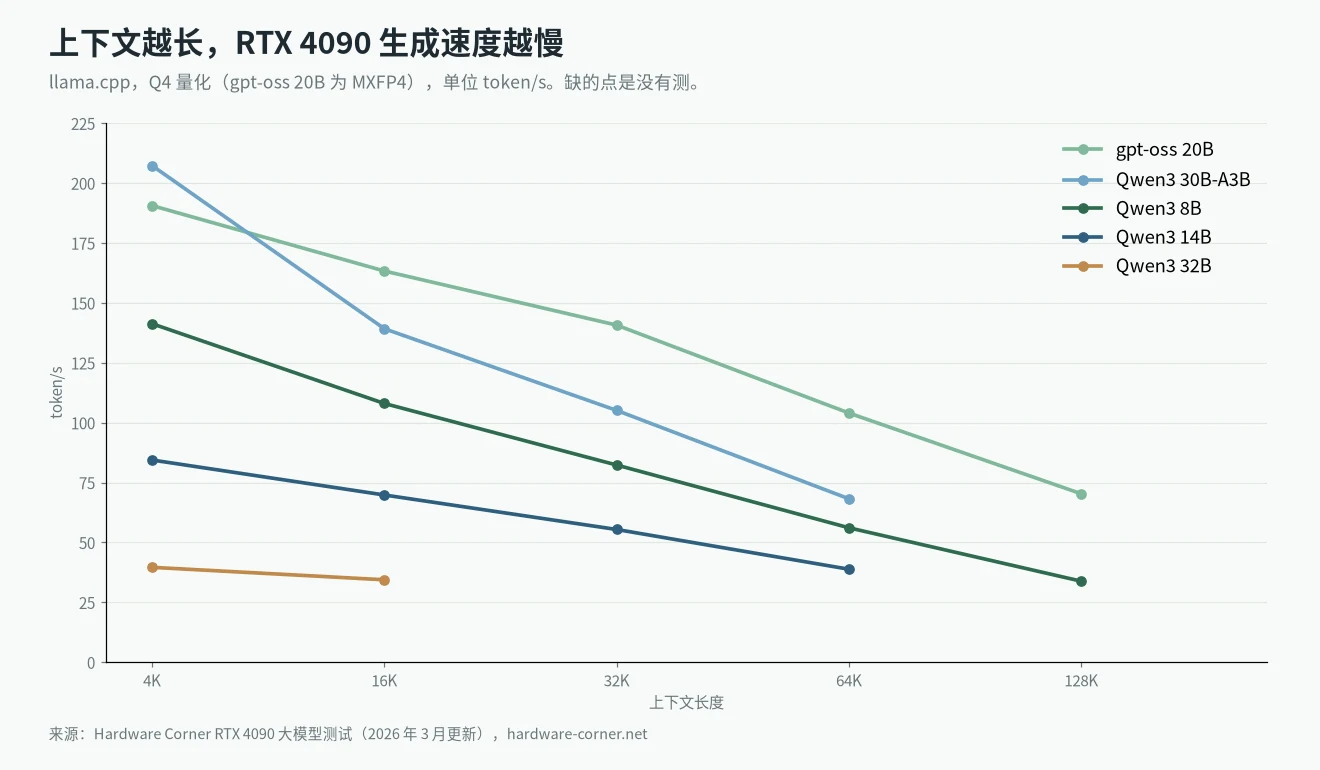
速度我只用实测数据。下面这组来自 Hardware Corner 的 4090 测试,用的是 llama.cpp,2026 年 3 月更新,单位是每秒生成的 token 数。
| 模型(量化) | 4K | 16K | 32K | 64K |
|---|---|---|---|---|
| Qwen3 8B(Q4) | 141.3 | 108.0 | 82.3 | 56.1 |
| Qwen3 14B(Q4) | 84.4 | 69.8 | 55.4 | 38.8 |
| Qwen3 30B-A3B(Q4) | 207.3 | 139.2 | 105.1 | 68.2 |
| gpt-oss 20B(MXFP4) | 190.6 | 163.3 | 140.7 | 104.0 |
| Qwen3 32B(Q4) | 39.6 | 34.4 | 没测 | 没测 |
另外两组来源可以交叉对一下。XiongjieDai 的 llama.cpp 测试(2024 年 5 月)里,单张 4090 跑 Llama 3 8B Q4_K_M 是 127.74 token/s,F16 是 54.34 token/s。llama.cpp 官方的 CUDA 跑分帖用 Llama 2 7B Q4_0,4090 开 Flash Attention 生成速度是 188.96 token/s。
读提示词(prompt processing)比生成快得多。Hardware Corner 测的 Qwen3 32B,4K 时是 2,448 token/s,16K 时是 1,707 token/s。
上下文越长越慢
同一个模型,上下文变长,生成速度会一直往下掉。Qwen3 8B 从 4K 的 141.3 token/s 掉到 128K 的 33.8 token/s。原因是每生成一个 token,都要把整段 KV cache 读一遍。所以不是放得下就行,你常用多长的上下文,决定了用起来快不快。
4090 放不下 70B 怎么办
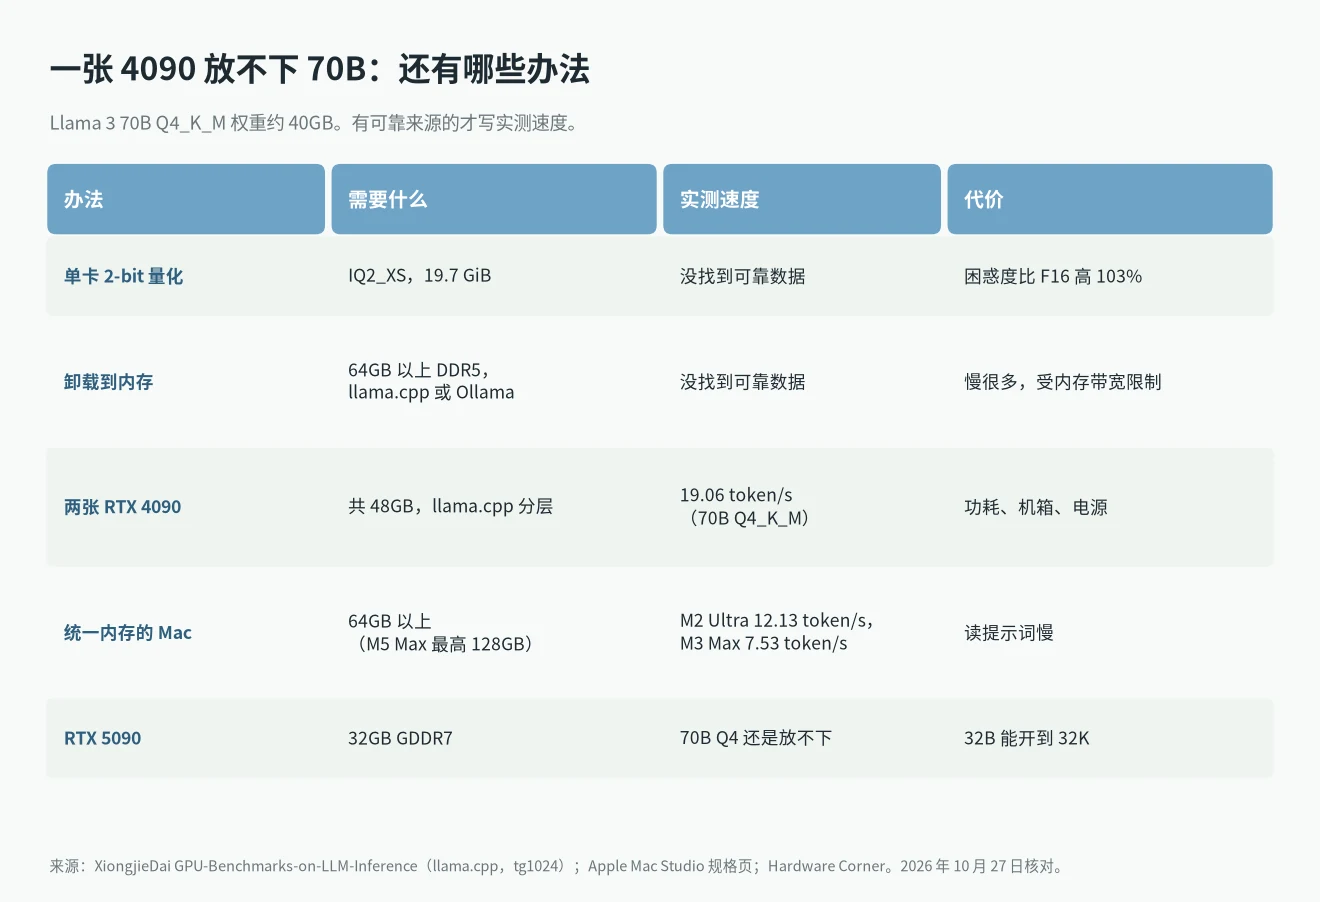
硬塞:2-bit 量化
Llama 3.3 70B 的 IQ2_XS 文件是 19.69 GiB,4K 上下文算下来约 22.4 GiB,单卡能放下。代价是质量。XiongjieDai 转引的 Llama 3 70B 困惑度测试里,IQ2_XS 比 FP16 高 103%,Q4_K_M 只高 4.83%。我没找到它和 32B Q4 直接对比的可靠测试,就不下结论了。我自己不会这么用。
卸载一部分到内存
Ollama 放不下时会自动把一部分层放到内存里,ollama ps 会显示类似「48%/52% CPU/GPU」。llama.cpp 用 -ngl 控制放多少层进显存,MoE 模型还可以用 --n-cpu-moe 把专家权重留在内存。
这样能跑,但会慢很多。我没找到 4090 加内存卸载跑 70B 的可靠速度数据,这里就不报数字。内存至少要能装下放不进显存的那部分,70B Q4_K_M 建议 64GB 起步。内存最近在涨价,可以先看看 DDR4 和 DDR5 价格倒挂这篇。
两张 4090
两张卡一共 48GB,llama.cpp 可以按层拆到两张卡上。XiongjieDai 实测两张 4090 跑 Llama 3 70B Q4_K_M 是 19.06 token/s,读提示词是 905.38 token/s。单张 70B 在同一测试里是 OOM(显存不够)。代价是两张 450W 的卡,电源、机箱和散热都要跟上。
Mac 的统一内存
Mac 的 CPU 和 GPU 共用一池内存,能装下比 24GB 大得多的模型。按 Apple 的 Mac Studio 规格页,M5 Max 最高 128GB(460 或 614 GB/s),M5 Ultra 最高 512GB(1.2TB/s)。XiongjieDai 的老测试里,M2 Ultra 跑 70B Q4_K_M 是 12.13 token/s,M3 Max 64GB 是 7.53 token/s。M5 系列我没找到同样口径的数字。什么时候买 Mac 合适,可以看 Mac 现在买还是等。
换 5090 能解决吗
5090 有 32GB GDDR7,带宽 1,792 GB/s。Hardware Corner 的 5090 测试里,Qwen3 32B Q4 在 4K 是 61.4 token/s,16K 是 50.9 token/s,32K 还有 43.8 token/s。4090 同样配置是 39.6 和 34.4,32K 没测。llama.cpp 跑分帖里 5090 的 Llama 2 7B 生成速度是 300.40 token/s。
但 70B Q4_K_M 在 5090 上照样放不下。5090 解决的是「32B 想开长上下文」和「14B 想跑 Q8 加长上下文」。详细的算账在 5090 那篇里。
想在 4090 上跑 DeepSeek
本地能跑的 DeepSeek 一般是 R1 的蒸馏版,底子是 Qwen 或 Llama,从 1.5B 到 70B 有好几档。规律和上面一样:14B 很轻松,32B 用 Q4,70B 放不下。满血的 DeepSeek R1 是 671B,一张 4090 完全不用考虑。具体装法和各档硬件要求,我在 DeepSeek 本地部署硬件指南里写过,这里不重复。
我的建议
所以 4090 能跑多大的模型,最后要看你主要用哪一档:
- 主要跑 8B 到 14B,用来写代码、聊天、做 RAG:4090 很够,还能开长上下文。
- 想用 32B 当主力:4090 能跑,16K 以内体验不错。经常要 32K 以上,考虑 5090 或者 KV cache 用 q8_0。
- 一定要 70B:两张 4090,或者大内存的 Mac。单卡卸载到内存,只适合偶尔试试。
- 预算有限:3090 也是 24GB,能跑的模型大小和 4090 一样,只是慢一些。llama.cpp 跑分帖里 3090 的 Llama 2 7B 生成速度是 158.16 token/s。
常见问题
4090 能跑多大的模型才算流畅?
按 Hardware Corner 的数据,14B 以内的模型在 4K 到 32K 上下文都有 55 token/s 以上。32B Q4 在 16K 时是 34.4 token/s,对聊天来说也够用。
4090 能跑 70B 吗?
完整放进显存不行。Q4_K_M 权重约 40 GiB。能跑的办法是 2-bit 量化、卸载到内存,或者两张卡。
4090 跑 32B 能开多长上下文?
f16 KV cache 下约 16K。KV cache 改成 q8_0,大约能到 32K,但已经贴着 24GB。
4090 能跑 Qwen3 30B-A3B 吗?
能,Q4_K_M 权重 17.3 GiB。Hardware Corner 测到 64K 上下文还有 68.2 token/s。这是 24GB 卡上最值得试的模型之一。
4090 能跑多大的模型,和 5090 差多少?
24GB 对 32GB。日常能跑的模型大小差不多,差别在 32B 能开多长的上下文,以及速度。70B 两张卡都放不下。