
RTX 5090 para IA: ¿vale la pena? Guía fácil de lo que cabe en 32 GB (2026)
¿Vale la pena la RTX 5090 para IA? Las cuentas de 32 GB de VRAM por modelo y cuantización, contrastadas con una prueba real, y frente a Mac Studio y DGX Spark.
 bufferSobre el autor8 min de lectura
¿Vale la pena la RTX 5090 para IA? Me lo preguntan como si fuera de sí o no, y no lo es. Es una pregunta de memoria. La tarjeta tiene 32 GB de VRAM, y que eso sobre o se quede corto depende del modelo, de la cuantización y del contexto que quieras.
Así que en vez de opinar a ojo, hice las cuentas para los modelos que la gente usa de verdad, las contrasté con una medición real y lo metí todo en un gráfico. Especificaciones y precios salen de las páginas de NVIDIA y Apple, revisadas el 21 de octubre de 2026 (hora de Pekín).
La tarjeta en un párrafo
Lo básico primero, porque cualquier debate sobre la RTX 5090 para IA empieza aquí.
Según la página de NVIDIA: 32 GB de GDDR7 con bus de 512 bits, 21.760 núcleos CUDA, 575 W de consumo de la tarjeta, y NVIDIA recomienda una fuente de 1000 W. El whitepaper de Blackwell da 1.792 GB/s de ancho de banda, frente a unos 1.008 GB/s de la 4090. El precio oficial fue de 1999 dólares en su lanzamiento de enero de 2025, según la nota de prensa de NVIDIA. A 21 de octubre de 2026 (última revisión), la página del producto no muestra precio, y en tienda se ha vendido muy por encima, así que no voy a poner una cifra de calle que la semana que viene ya estará mal.
Cuánta VRAM necesita un modelo: las cuentas de verdad
Dos cosas se comen la VRAM: los pesos y la caché KV, que crece con el contexto. Los pesos son fáciles: parámetros por bytes por parámetro. El README de cuantización de llama.cpp mide Q4_K_M en 4,89 bits por peso, o sea unos 0,61 bytes por parámetro (no los 0,5 que todo el mundo supone). Q8_0 son 8,5 bits, 1,0625 bytes. F16, 2 bytes.
La caché KV es donde la gente se equivoca. La fórmula, tal como la escribe Hugging Face, es 2 × capas × cabezas KV × head_dim × longitud de contexto × bytes por elemento. Ojo: cabezas KV, no cabezas de atención. Los modelos actuales usan atención agrupada (GQA), y si metes hidden_size te pasas varias veces.
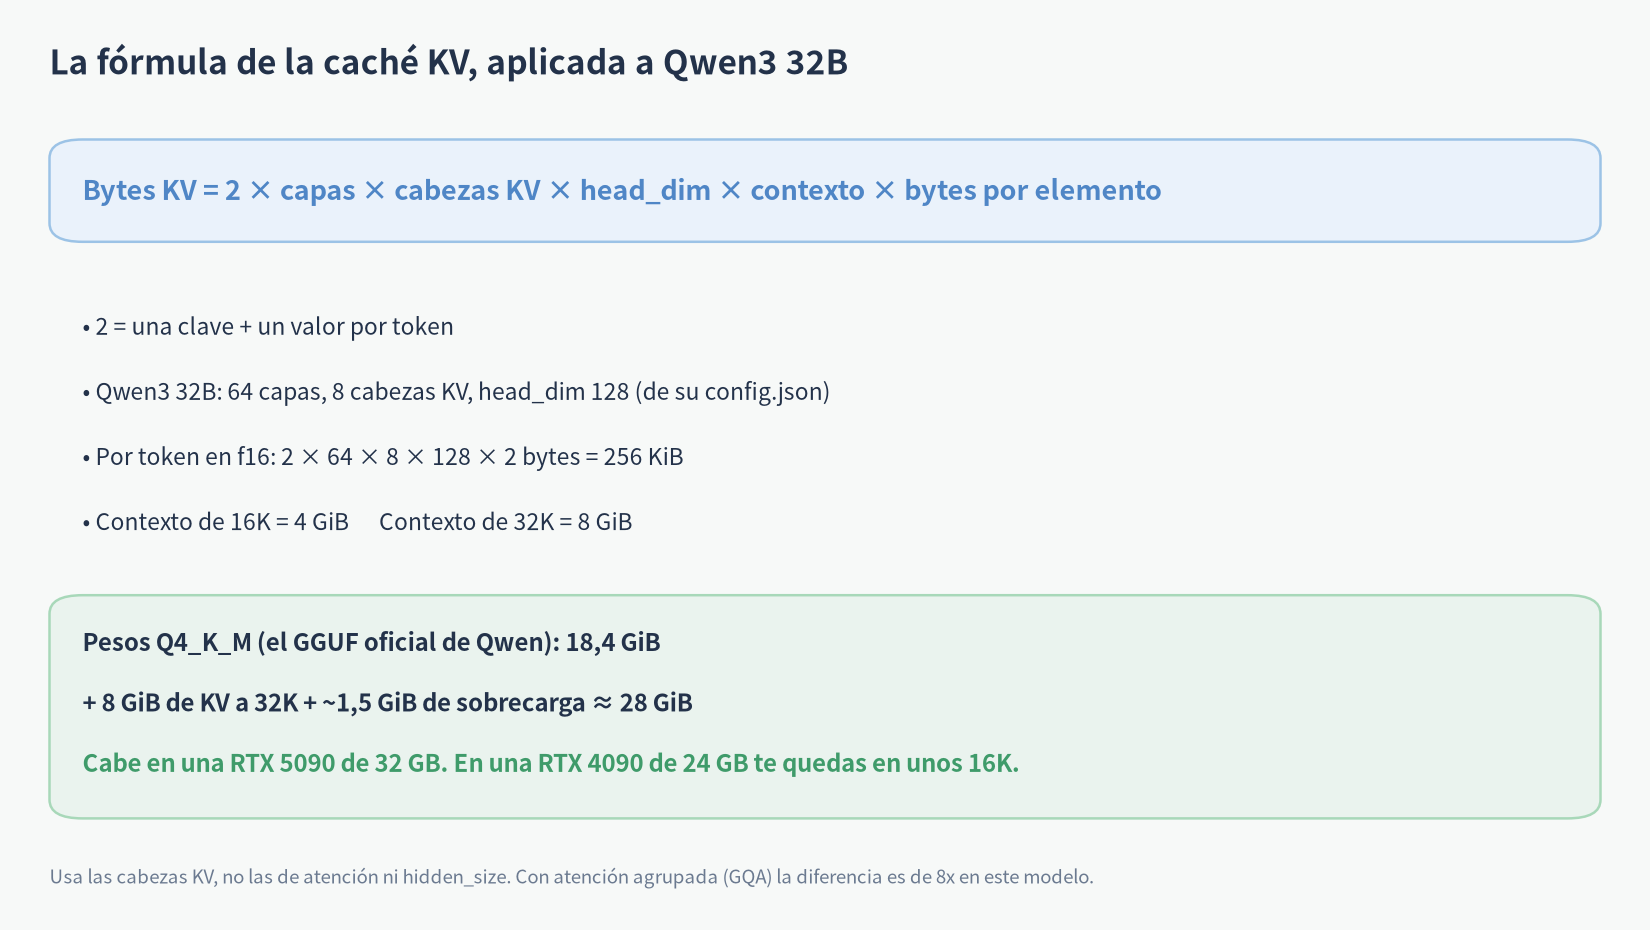
Ejemplo con Qwen3 32B. Su config.json dice 64 capas, 8 cabezas KV y head_dim 128. En f16 son 256 KiB por token: 16K de contexto son 4 GiB y 32K son 8 GiB. El archivo Q4_K_M oficial de Qwen pesa 18,4 GiB. Súmale un margen de ejecución de 1,5 GiB más o menos (estimación mía; cambia según el backend y el tamaño de lote) y 32K se queda en unos 28 GiB. Cabe en 32 GB. En una tarjeta de 24 GB, el mismo modelo llega a unos 16K.
Y coincide con una medición real, que es lo que me importa. Las tablas de Hardware Corner para la RTX 4090 llegan con Qwen3 32B Q4 hasta 16K de contexto, y las de la RTX 5090 hasta 32K (43,8 tokens/s ahí), sin datos a 64K. Fórmula y prueba dicen lo mismo, así que me fío del gráfico.
RTX 5090 para IA: qué cabe en 32 GB
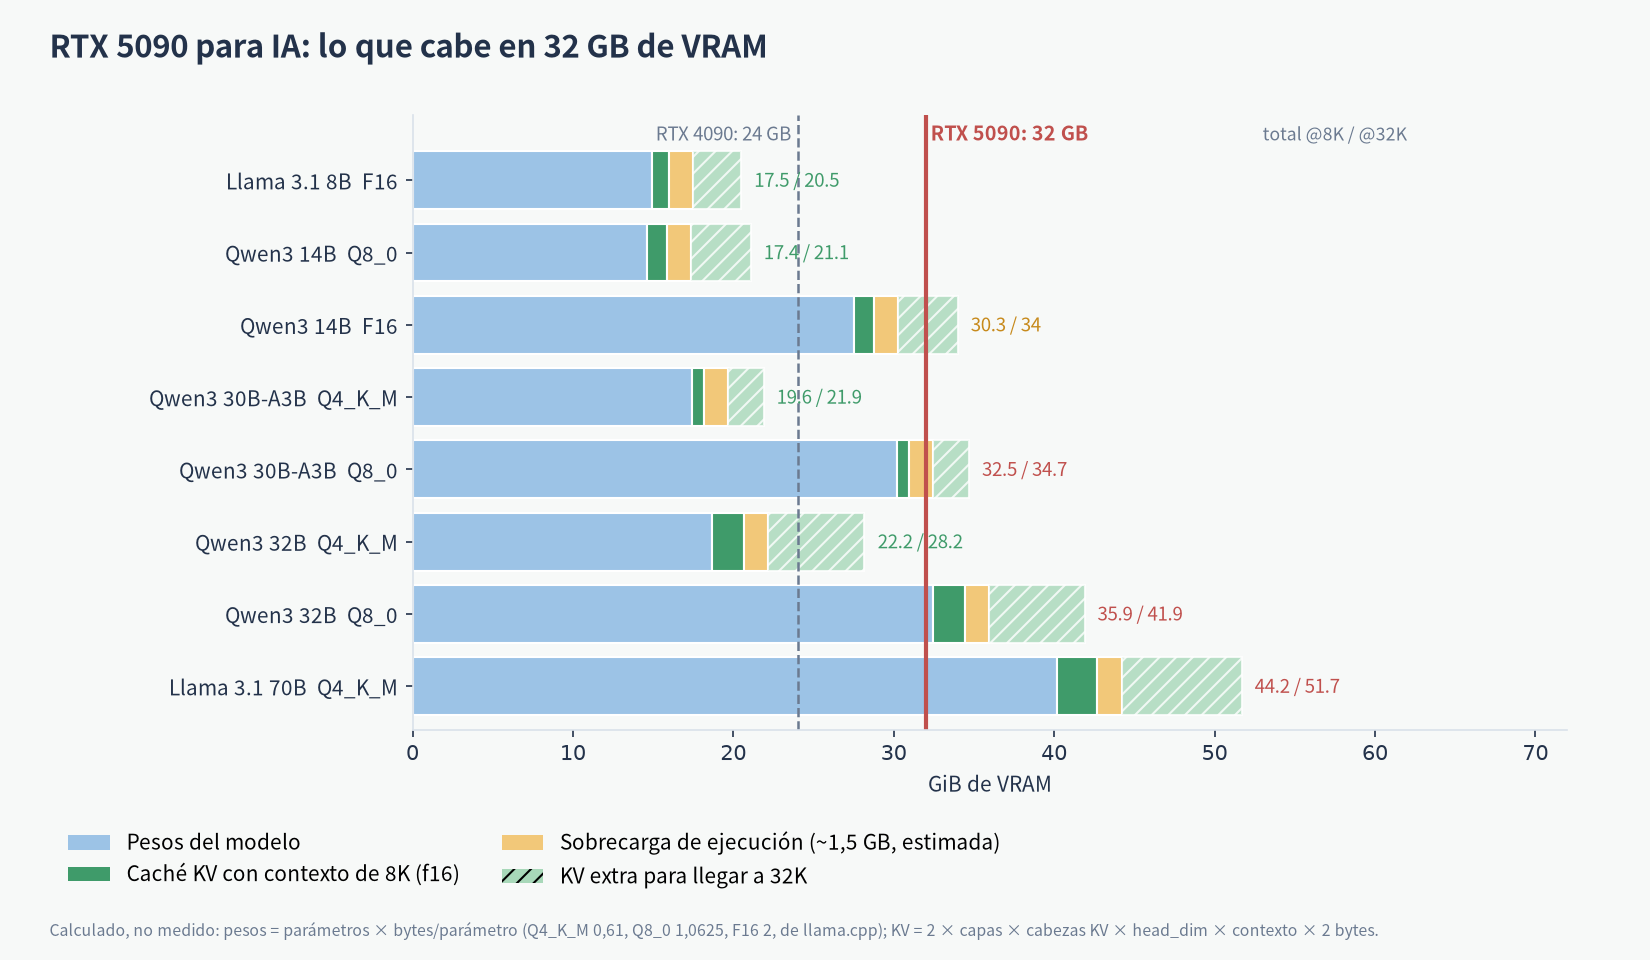
Este gráfico resume la RTX 5090 para IA en una imagen. De más cómodo a más justo: cualquier 8B corre incluso en F16 con contexto largo (unos 20,5 GiB a 32K). Qwen3 14B en Q8_0 va holgado, unos 21 GiB a 32K. Qwen3 30B-A3B, el de mezcla de expertos, va sobrado en Q4_K_M, unos 22 GiB a 32K, y como solo activa unos 3B parámetros por token también es rápido. Eso sí, para la memoria cuenta los 30,5B parámetros, no solo los activos.
Luego lo que va justo. Qwen3 32B en Q4_K_M cabe hasta unos 32K, que además está cerca de su límite nativo de 40.960 tokens. Qwen3 14B en F16 completo cabe, pero con poco contexto. Y gpt-oss-20b, con su archivo oficial MXFP4 de unos 11,3 GiB, no da ningún problema.
Y lo que no cabe. Cualquier 32B en Q8_0 (32,4 GiB solo de pesos). Qwen3 30B-A3B en Q8_0, que pide ~30 GiB antes del contexto. Y un 70B en Q4_K_M, unos 40 GiB de pesos. Puedes descargar capas a la RAM del sistema, y herramientas como Ollama lo hacen solas, pero no encontré cifras oficiales fiables de cuánto corre así un 70B en la 5090, así que no me lo invento.
Un truco que sí ayuda: el FAQ de Ollama dice que la caché KV en q8_0 usa más o menos la mitad que en f16 (con Flash Attention activado). Eso casi duplica el contexto que cabe.
RTX 5090 vs 4090 para IA
Si comparas la RTX 5090 para IA con la tarjeta anterior, el salto que importa no es la potencia, son los 8 GB extra y el ancho de banda. 24 GB frente a 32 GB es la diferencia entre Qwen3 32B a 16K o a 32K, o entre “14B en Q8” y “14B en F16 con poco contexto”.
El ancho de banda pasa de ~1 TB/s a 1,79 TB/s, y generar tokens en un modelo que cabe depende sobre todo de eso, así que la 5090 va claramente más rápida con el mismo modelo. Si ya tienes una 4090 y tus modelos caben, yo no cambiaría solo por esto. Si siempre te faltan 2 a 4 GB, ahí sí tiene sentido.
RTX 5090 frente a un Mac con memoria unificada y la DGX Spark
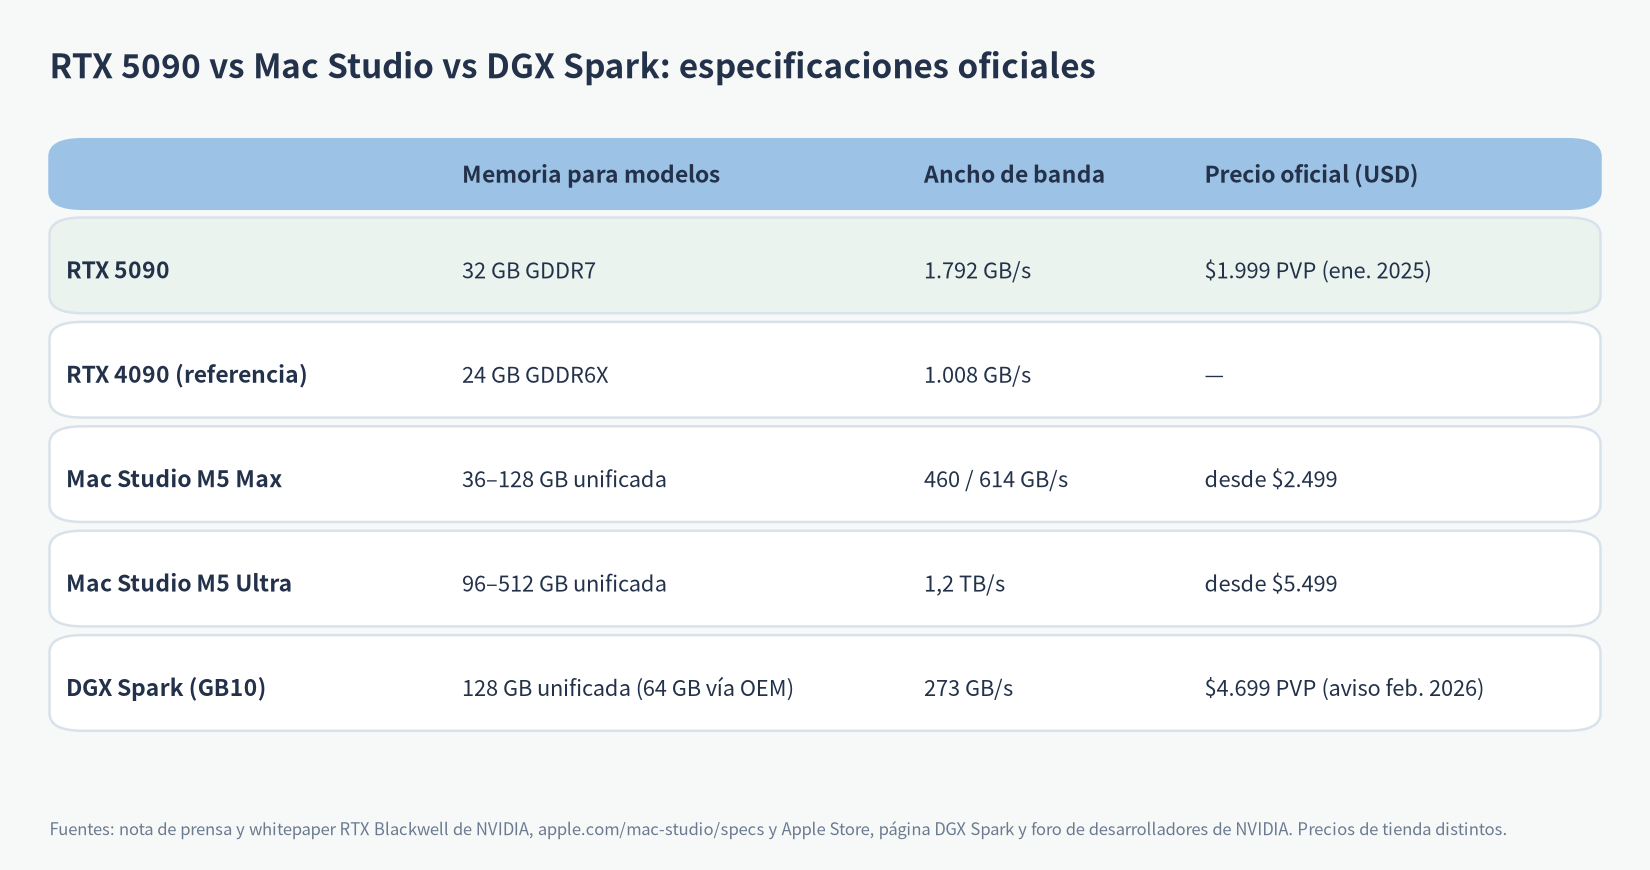
Aquí está el dilema de verdad. Un Mac comparte una sola memoria unificada entre CPU y GPU, así que carga modelos mucho más grandes. Las especificaciones del Mac Studio dan el M5 Max con 36 GB hasta 128 GB (460 o 614 GB/s) y el M5 Ultra con 96 GB hasta 512 GB (1,2 TB/s); en la Apple Store de EE. UU. empiezan en 2499 y 5499 dólares.
La DGX Spark de NVIDIA tiene 128 GB de LPDDR5x unificada a 273 GB/s, y NVIDIA dice que una unidad mueve modelos de hasta 200B parámetros. Su precio Founders Edition subió a 4699 dólares en un aviso de NVIDIA de febrero de 2026; en la última revisión (21 de octubre de 2026) la tienda de NVIDIA no me cargó, así que confirma el precio antes de comprar.
Así que, poniendo la RTX 5090 para IA al lado de estas máquinas: la 5090 tiene con diferencia el mayor ancho de banda, o sea los tokens más rápidos en todo lo que quepa en 32 GB. El Mac y la Spark cargan 70B y más sin despeinarse, pero cada token sale más lento porque su memoria es más lenta. Elige por el modelo más grande que de verdad vayas a usar, no por el más grande del que hayas oído hablar.
Dos notas sobre Mac, porque veo estos errores a menudo. macOS no le da a la GPU toda la memoria unificada por defecto.
Apple no publica el porcentaje; en equipos pequeños los registros de llama.cpp muestran entre dos tercios y tres cuartos, y la documentación de MLX explica cómo subir el límite con sysctl iogpu.wired_limit_mb. Y hay configuraciones que la gente cita y no existen: el Mac mini M4 llegaba a 32 GB como máximo (64 GB era solo el M4 Pro), y el Mac Studio M3 Ultra venía con 96 o 256 GB, no 192. Si estás mirando un Mac de todas formas, en comprar Mac ahora o esperar hablo de cuánta memoria elegir.
Entonces, ¿vale la pena la RTX 5090 para IA?
Sí, si tus modelos están entre 8B y 32B y te importa la velocidad. Mueve un 32B en Q4 con contexto decente, un 14B en Q8 con espacio de sobra, y lo hace más rápido que cualquier opción con memoria unificada. Encaja todavía mejor si además juegas o haces imagen y vídeo. Si quieres probarlo con los modelos destilados de DeepSeek, en mi guía para instalar DeepSeek en local están los pasos.
No, si la compras para correr 70B o más. Vas a estar descargando capas y esperando; un Mac de 128 GB o una DGX Spark son la máquina sensata para eso. Y siendo sincero, con lo que se han estado vendiendo las tarjetas, compara con una suscripción antes de gastar. Para eso mantengo la comparativa de precios de suscripciones de IA.
Preguntas frecuentes
¿La RTX 5090 puede con modelos de 70B?
No entero en la VRAM. Llama 3.1 70B en Q4_K_M pide unos 40 GiB solo de pesos. Puedes repartirlo con la RAM del sistema, pero irá mucho más lento; no encontré una cifra oficial sólida de cuánto.
¿Cuánta VRAM necesita un modelo de 32B?
En Q4_K_M, unos 18,4 GiB de pesos, más 256 KiB por token de contexto en Qwen3 32B. Unos 22 GiB a 8K y 28 GiB a 32K. En Q8_0 los pesos ya pasan de 32 GiB.
¿RTX 5090 o Mac Studio para modelos locales?
La 5090 para velocidad con modelos de hasta ~32B. El Mac Studio para capacidad: hasta 128 GB con M5 Max y 512 GB con M5 Ultra, más lento por token. Depende del modelo más grande que necesites.
¿RTX 5090 o DGX Spark?
La Spark tiene 4 veces la memoria (128 GB) y una sexta parte del ancho de banda (273 frente a 1.792 GB/s). Modelos grandes en la Spark, tokens rápidos en la 5090.
¿Puede una RTX 5090 correr DeepSeek?
Los R1 destilados de hasta 32B, sí. El DeepSeek V3/R1 completo de 671B, ni de lejos.
¿Cuál es el precio oficial de la RTX 5090?
1999 dólares, según el anuncio de NVIDIA de enero de 2025. Es el precio recomendado; lo que cobran las tiendas es otra historia.
Sigue leyendo: la categoría de hardware para IA y la comparativa de precios de IA.