
5090 跑大模型值得买吗?32GB 显存能装下什么(2026 实用算账)
5090 跑大模型值不值:32GB 显存按模型和量化逐个算,和实测对账,再对比 Mac Studio、DGX Spark 官方规格。
 buffer关于作者约 6 分钟阅读
5090 跑大模型到底值不值?很多人问得像是非题,其实它是道内存题。这张卡有 32GB 显存,够不够用,完全取决于你要跑哪个模型、用什么量化、开多长上下文。所以我没凭感觉答,而是把大家常跑的几个模型挨个算了一遍,拿一组真实测试对了账,再画成一张图。规格和价格都来自 NVIDIA、Apple 自己的页面,北京时间 2026 年 10 月 21 日核对。
先把卡说清楚
按 NVIDIA 的 RTX 5090 页面:32GB GDDR7,512 位位宽,21,760 个 CUDA 核心,整卡功耗 575W,NVIDIA 建议配 1000W 电源。NVIDIA 的 Blackwell 白皮书写的显存带宽是 1,792 GB/s,4090 大约是 1,008 GB/s。官方价格:2025 年 1 月发布时是 $1,999,见 NVIDIA 新闻稿。截至 2026-10-21 最近一次核对,产品页上没有实时价格,实际店里卖的又远高于这个数,所以我就不报一个下周就过时的市场价了。
显存到底怎么算
想用 5090 跑大模型,先搞懂吃显存的两样东西:模型权重,和随上下文变长的 KV cache。权重好算,参数量乘每参数字节数。llama.cpp 的 quantize 说明实测 Q4_K_M 是每权重 4.89 bit,也就是约 0.61 字节/参数,不是很多人随手按的 0.5。Q8_0 是 8.5 bit,即 1.0625 字节;F16 是 2 字节。
KV cache 才是大家最容易算错的地方。公式按 Hugging Face 的写法:2 × 层数 × KV 头数 × head_dim × 上下文长度 × 每元素字节。注意是 KV 头数,不是注意力头数。现在的模型基本都用分组查询注意力(GQA),拿 hidden_size 去套会多算好几倍。
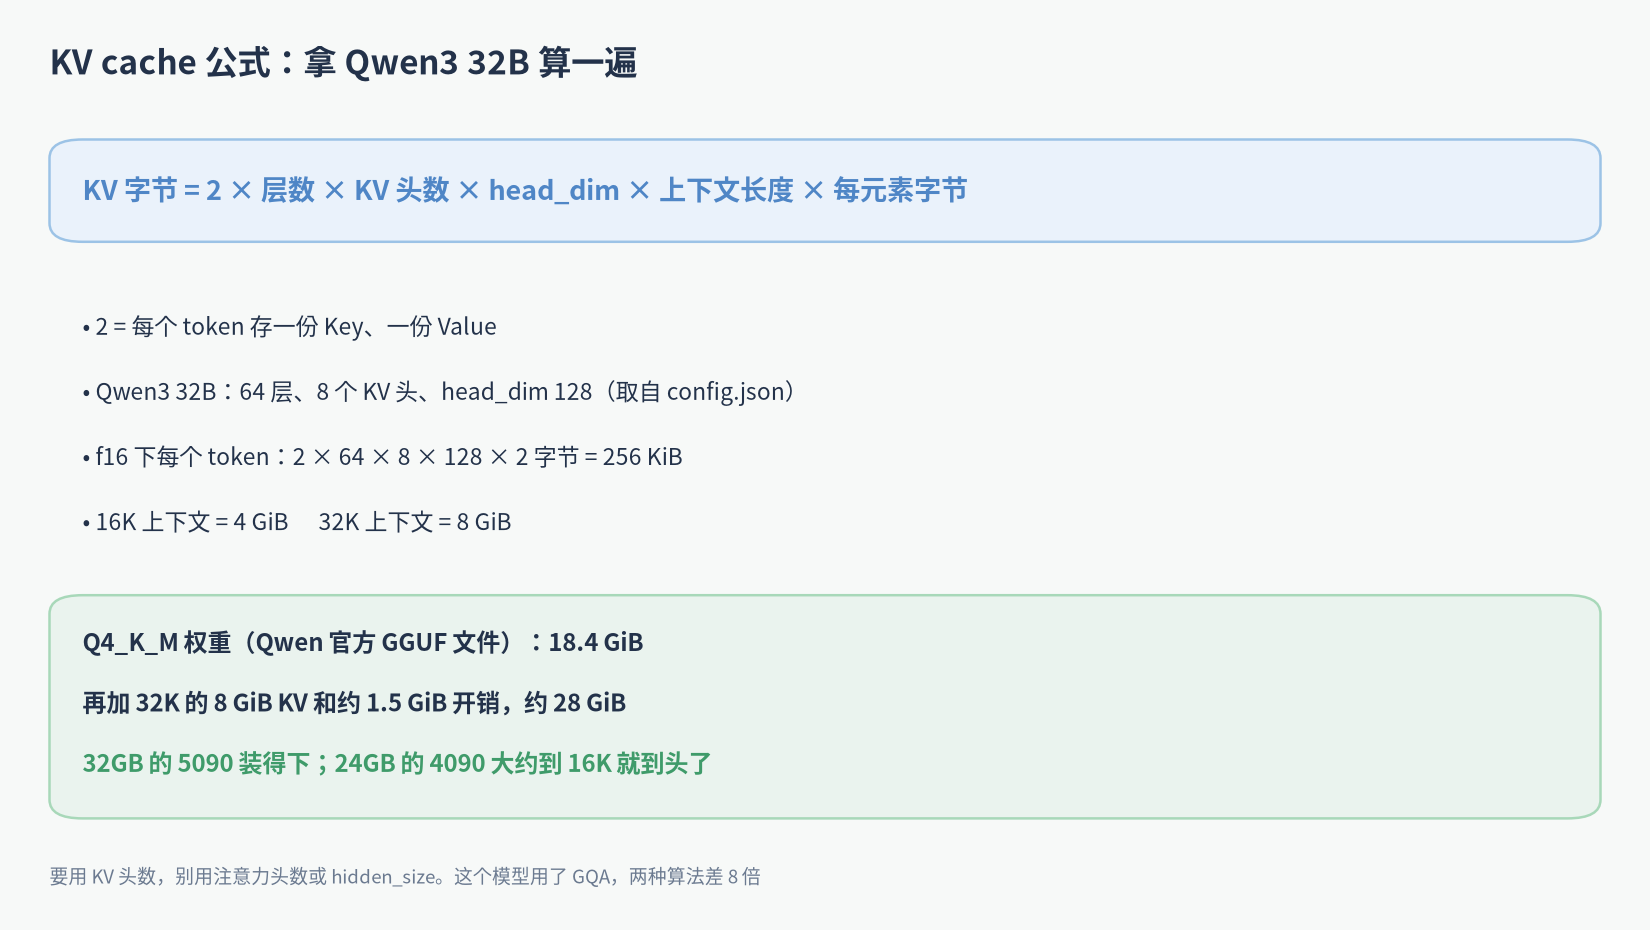
拿 Qwen3 32B 算一遍。它的 config.json 写着 64 层、8 个 KV 头、head_dim 128。f16 下每个 token 占 256 KiB,16K 上下文就是 4 GiB,32K 是 8 GiB。Qwen 官方的 Q4_K_M 文件是 18.4 GiB。再留约 1.5 GiB 运行缓冲(这是我的估计,随后端和 batch 大小变),32K 大概落在 28 GiB,32GB 装得下。换成 24GB 的卡,同一个模型大约 16K 就到顶了。
更重要的是它和实测对得上。Hardware Corner 的 RTX 4090 测试表里 Qwen3 32B Q4 最高只测到 16K,RTX 5090 那张表能到 32K(32K 时生成速度 43.8 token/s),64K 没有数据。公式和实测一致,所以下面这张图我是信得过的。
5090 跑大模型:32GB 能装下什么
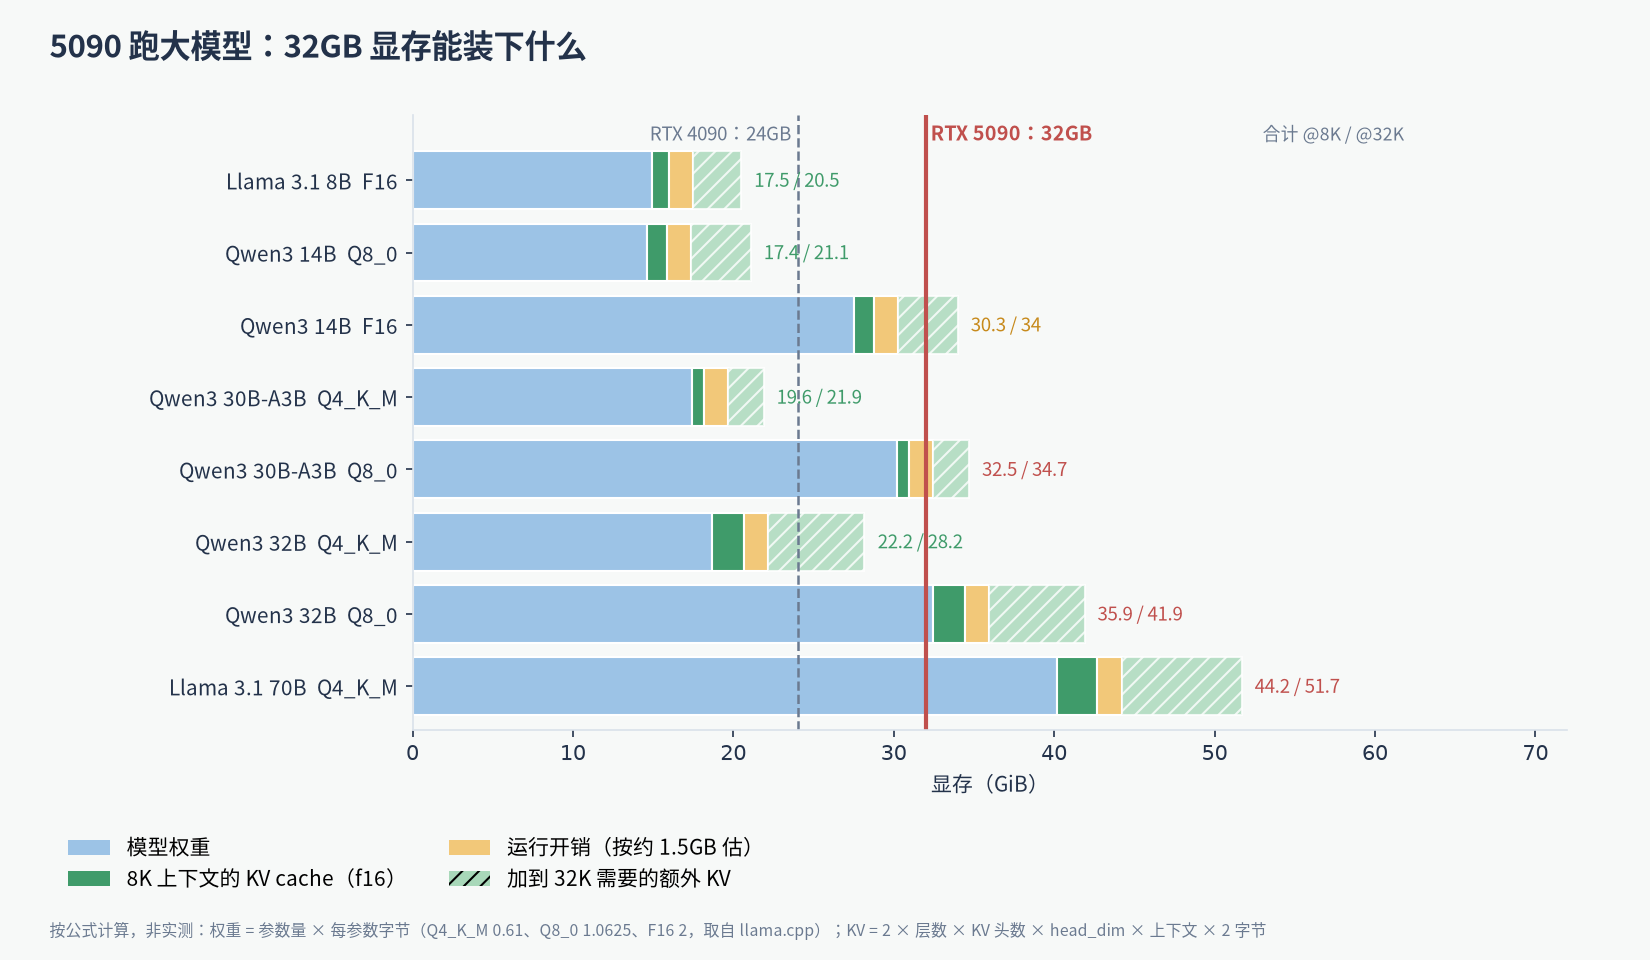
这张图基本就是 5090 跑大模型的全部答案。按舒服程度往下看:8B 级别的模型连 F16 都能跑,32K 上下文也才约 20.5 GiB。Qwen3 14B 用 Q8_0 很宽裕,32K 约 21 GiB。Qwen3 30B-A3B 这个 MoE 模型用 Q4_K_M 很轻松,32K 约 22 GiB,而且每个 token 只激活约 3B 参数,速度也快。只是算显存时要按全部 30.5B 参数算,别按激活参数算。
然后是卡边的。Qwen3 32B 用 Q4_K_M 能撑到 32K 左右,正好也接近它原生 40,960 token 的上限。Qwen3 14B 跑满精度 F16 理论上放得下,但上下文只能开很短。gpt-oss-20b 官方 MXFP4 文件约 11.3 GiB,完全没压力。
再就是装不下的。任何 32B 的 Q8_0(光权重就 32.4 GiB);Qwen3 30B-A3B 的 Q8_0,没算上下文就要约 30 GiB;70B 的 Q4_K_M,权重约 40 GiB。可以把部分层卸到内存里,Ollama 这类工具会自动做,但我没找到 5090 这样跑 70B 有多快的可靠官方数据,就不瞎说了。有个确实管用的办法:Ollama FAQ 说 KV cache 用 q8_0 大约只占 f16 的一半内存(需要开 Flash Attention),能装下的上下文差不多翻倍。
5090 和 4090 跑大模型差在哪
真正拉开差距的不是算力,是多出来的 8GB 和带宽。24GB 对 32GB,就是 Qwen3 32B 开 16K 还是 32K 的区别,也是「14B 跑 Q8」和「14B 跑 F16、短上下文」的区别。带宽从约 1 TB/s 到 1.79 TB/s,而模型放得下时生成速度主要看带宽,所以同一个模型 5090 明显更快。已经有 4090、模型也放得下的,我不会为这个专门升级;如果你老是差那 2 到 4GB,那就是换卡的理由。
5090、统一内存的 Mac、DGX Spark 怎么选
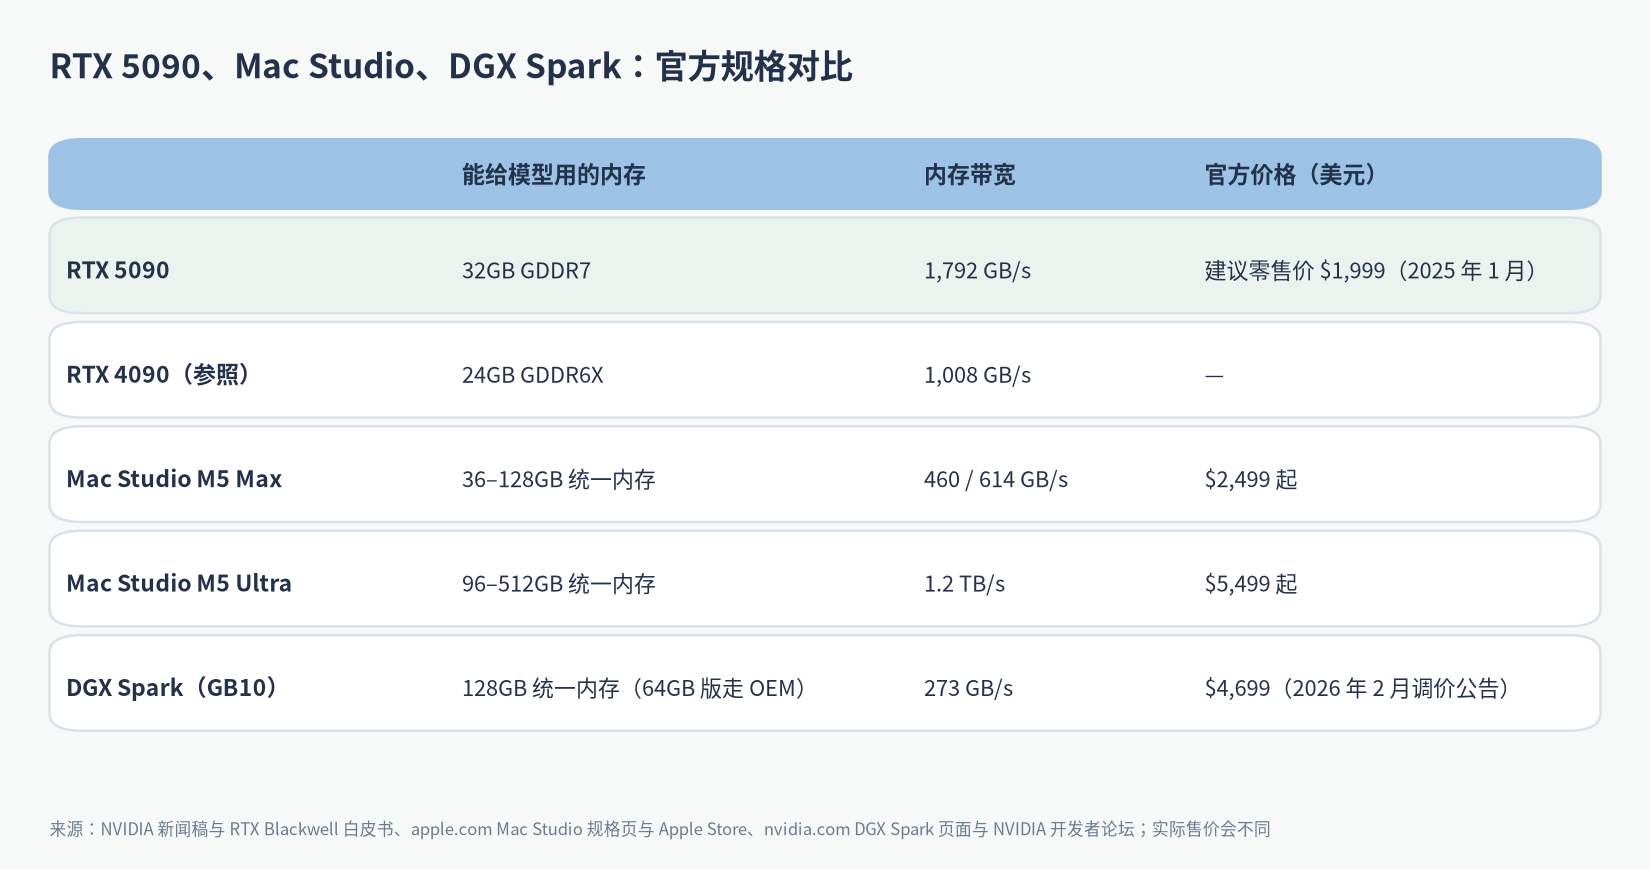
这才是真正的取舍。Mac 的统一内存是 CPU 和 GPU 共用一池,所以能装下大得多的模型。Apple 的 Mac Studio 规格页:M5 Max 是 36GB 起、最高 128GB(460 或 614 GB/s),M5 Ultra 是 96GB 起、最高 512GB(1.2 TB/s);Apple Store 上起售价分别是 $2,499 和 $5,499。NVIDIA 的 DGX Spark 是 128GB LPDDR5x 统一内存、273 GB/s,NVIDIA 说一台能跑最高 200B 参数的模型。它的 Founders Edition 建议价在 2026 年 2 月的 NVIDIA 公告里调到了 $4,699;2026-10-21 最近一次核对时 NVIDIA 商城页面我没打开,下单前请再确认一次现价。
所以拿 5090 跑大模型和这两类机器比:5090 带宽遥遥领先,32GB 以内的模型它出字最快;Mac 和 Spark 装 70B 甚至更大的模型很轻松,但内存慢,每个 token 也慢。按你真正要跑的最大模型来选,别按你听说过的最大模型来选。
关于 Mac 再补两句,因为老看到有人说错。macOS 默认不会把全部统一内存都给 GPU 用。Apple 没公布这个比例;在小内存机器上 llama.cpp 的日志大概是三分之二到四分之三,Apple 的 MLX 文档写了怎么用 sysctl iogpu.wired_limit_mb 调高。另外有两个常被提到的配置其实不存在:M4 Mac mini 最高 32GB(64GB 只有 M4 Pro 版),M3 Ultra Mac Studio 是 96GB 或 256GB,没有 192GB。真在考虑 Mac 的话,我在 Mac 现在买还是等那篇里写了内存怎么选。
5090 跑大模型值得买吗
值,如果你的模型集中在 8B 到 32B,而且在乎速度。它能带 32B Q4 加像样的上下文,14B Q8 绰绰有余,速度比任何统一内存方案都快。要是你还打游戏、做图做视频,32GB 也用得上。想先拿 DeepSeek 的蒸馏模型试试 5090 跑大模型,可以照我那篇 DeepSeek 本地部署的步骤来。
不值,如果你买它是为了跑 70B 或更大的。你会一直在卸载和等待,128GB 的 Mac 或 DGX Spark 才是更合理的机器。说句实在话,按最近显卡的实际售价,掏钱前先跟订阅比一比。我一直在更新 AI 订阅和 API 价格对比,就是干这个用的。
常见问题
5090 能跑 70B 模型吗?
没法全放进显存。Llama 3.1 70B 的 Q4_K_M 光权重就要约 40 GiB。可以和内存拆着跑,但会慢很多,具体慢多少我没找到可靠的官方数据。
32B 模型要多少显存?
Q4_K_M 权重约 18.4 GiB,Qwen3 32B 每个 token 的上下文再加 256 KiB。8K 大约 22 GiB,32K 大约 28 GiB。Q8_0 光权重就超过 32 GiB。
5090 跑 DeepSeek 行不行?
32B 及以下的 R1 蒸馏版可以。满血 671B 的 DeepSeek V3/R1 不行,差得很远。
5090 和 Mac Studio 跑本地模型选哪个?
32B 以内要速度选 5090;要容量选 Mac Studio,M5 Max 最高 128GB、M5 Ultra 最高 512GB,但每个 token 更慢。看你要跑的最大模型。
5090 和 DGX Spark 比呢?
Spark 内存是 4 倍(128GB),带宽只有约六分之一(273 对 1,792 GB/s)。大模型选 Spark,出字速度选 5090。
5090 官方价格多少?
NVIDIA 2025 年 1 月公布的是 $1,999,这是官方建议零售价,店里实际卖多少是另一回事。
顺便看:AI 硬件分类、AI 订阅和 API 价格对比。