
Precio de Qwen4-Max: 1,5 $ / 4,5 $ en Singapur y cómo usarlo
Qwen4-Max ya está en disponibilidad general. En Singapur: 1,5 $ de entrada y 4,5 $ de salida por 1M tokens; en Pekín, 10 / 30 CNY. Cuotas y un cálculo de 10 turnos.
 bufferSobre el autor10 min de lectura
La cuenta oficial de Qwen (@Alibaba_Qwen) anunció la disponibilidad general de Qwen4-Max a las 18:01 PT del 15 de noviembre (10:01, hora de Pekín, del 16 de noviembre). El mensaje dice que la API ya está en QwenCloud, y que también se puede probar Qwen4-Max en Qwen Studio, QwenWork y Qoder. El blog oficial se titula «Qwen4-Max: Your New Teammate Has Arrived» (qwen.ai/blog?id=qwen4-max). Este artículo cubre el precio de pago por uso, las cuotas y cómo llamar al modelo ya disponible. Es una página distinta de nuestro artículo del 11 de noviembre sobre la vista previa de Qwen4-Max y los planes Token Plan.
Empiece por los precios de lista. El mensaje oficial cita las cifras del sitio internacional: 1,5 $ por millón de tokens de entrada, 4,5 $ por millón de tokens de salida y 0,075 $ por millón de tokens de caché implícita, «all lower than Qwen3.8-Max, with implicit caching down by 70%». Yo contrasté esos números con la página de precios internacional de Model Studio, la página de precios del sitio de China y la página del modelo qwen4-max, actualizadas el 17 de noviembre. En Singapur, en el sitio internacional, el precio es efectivamente 1,5 / 4,5 $, con escritura de caché a 1,875 $ para una TTL de 5 minutos y 3 $ para una TTL de 1 hora, y aciertos de caché a 0,075 $. En el sitio de China, el precio de lista de China (Pekín) es 10 CNY por millón de tokens de entrada y 30 CNY por millón de tokens de salida, con escritura de caché a 12,5 CNY (5 minutos) y 20 CNY (1 hora), y aciertos a 0,5 CNY. Ambas páginas indican que muestran solo precios estándar, y que las promociones vigentes están en la consola.
Comprobado el 2026-11-18 hacia las 04:30, hora de Pekín (12:30 PT del 17 de noviembre). Los precios de lista pueden cambiar. La ventana de vista previa termina a las 24:00, hora de Pekín, del 25 de noviembre (08:00 PT ese día), y planeo volver a comprobarlos después de esa fecha.
Dos listas de precios, que no conviene mezclar
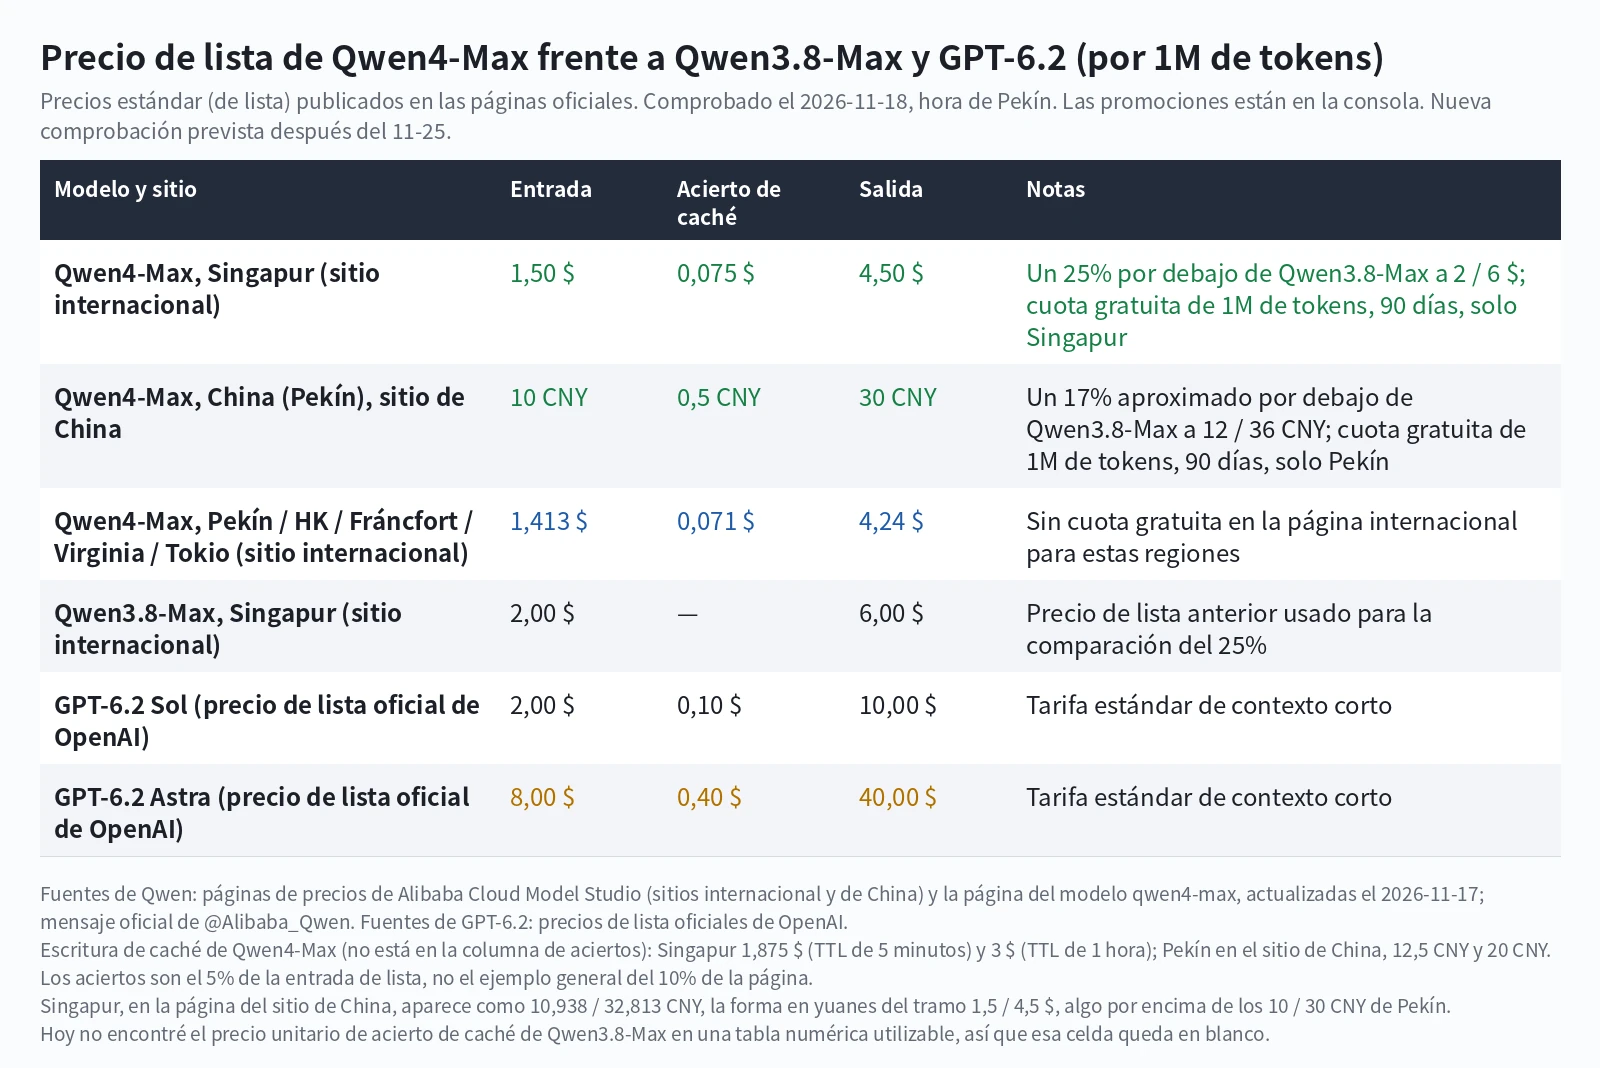
Frente a Qwen3.8-Max a 2 / 6 $ en Singapur, la entrada y la salida de Qwen4-Max son un 25% más bajas. Frente a los 12 / 36 CNY anteriores en la lista de Pekín del sitio de China, 10 / 30 CNY es alrededor de un 17% más bajo. Un recorte general del «25%» no se sostiene para los precios en yuanes del sitio de China.
La página internacional lista China (Pekín), Hong Kong (China), Fráncfort, Virginia y Tokio a 1,413 / 4,24 $, con aciertos de caché a 0,071 $, y no muestra cuota gratuita en esas regiones. La página del sitio de China lista Estados Unidos (Virginia), Hong Kong (China), Fráncfort y Tokio a 10 / 30 CNY; Singapur, en esa misma página del sitio de China, aparece como 10,938 / 32,813 CNY, que corresponde al tramo de 1,5 / 4,5 $ convertido a yuanes y es un poco más alto que los 10 / 30 CNY de Pekín. Hay que comprobar en qué consola y en qué región se factura de verdad.
Los precios de salida incluyen la cadena de pensamiento más la respuesta final. Qwen4-Max tiene un único tramo de 0 a 1 millón de tokens, sin una tarifa más alta por prompts más largos. Los aciertos de caché explícita e implícita comparten el mismo precio unitario en la tabla; la caché explícita también cobra una tarifa de creación, con una TTL de 5 minutos o 1 hora. La página de precios incluye un ejemplo general según el cual los aciertos se facturan al 10% de la entrada estándar, pero la tabla de aciertos de Qwen4-Max es 0,075 $ y 0,5 CNY, es decir, el 5% de la entrada estándar. El cálculo de más abajo usa la tabla, no ese ejemplo.
La inferencia por lotes solo está admitida en China (Pekín), según la página oficial del modelo; Singapur y las demás regiones no la admiten. Batch File en Pekín cuesta 5 / 15 CNY por millón de tokens (la tabla en dólares lista 0,707 / 2,12 $). Batch Chat aparece como un 50% de descuento por tiempo limitado, pero la tabla muestra los precios originales de 10 / 30 CNY (o 1,413 / 4,24 $ en la tabla en dólares). El precio promocional hay que leerlo en la consola, y lo volveré a comprobar después del 25 de noviembre. Los descuentos por lotes y los descuentos de caché no se pueden combinar.
La tabla más amplia está en nuestra comparativa de precios de API de LLM. Esa página todavía no tiene una fila de Qwen4-Max y habrá que añadirla cuando se apruebe este artículo.
Un ejemplo de coste de 10 turnos con las tarifas oficiales
Para alinearlo con el artículo de esta mañana sobre el precio de GPT-6.2 Astra, usé la misma carga supuesta: 10 turnos, cada uno con un prefijo de proyecto de 200.000 tokens, más 8.000 tokens de entrada nueva y 6.000 tokens de salida. En el primer turno el prefijo aún no está en caché, así que los 208.000 tokens de entrada se facturan a la tarifa de entrada sin caché; en los 9 turnos siguientes, el prefijo de 200.000 tokens se factura a la tarifa de acierto de caché y los 8.000 tokens nuevos siguen sin caché. Este es un uso que yo mismo he supuesto, no una carga de trabajo oficial de Qwen, y no incluye las tarifas de creación de caché explícita.
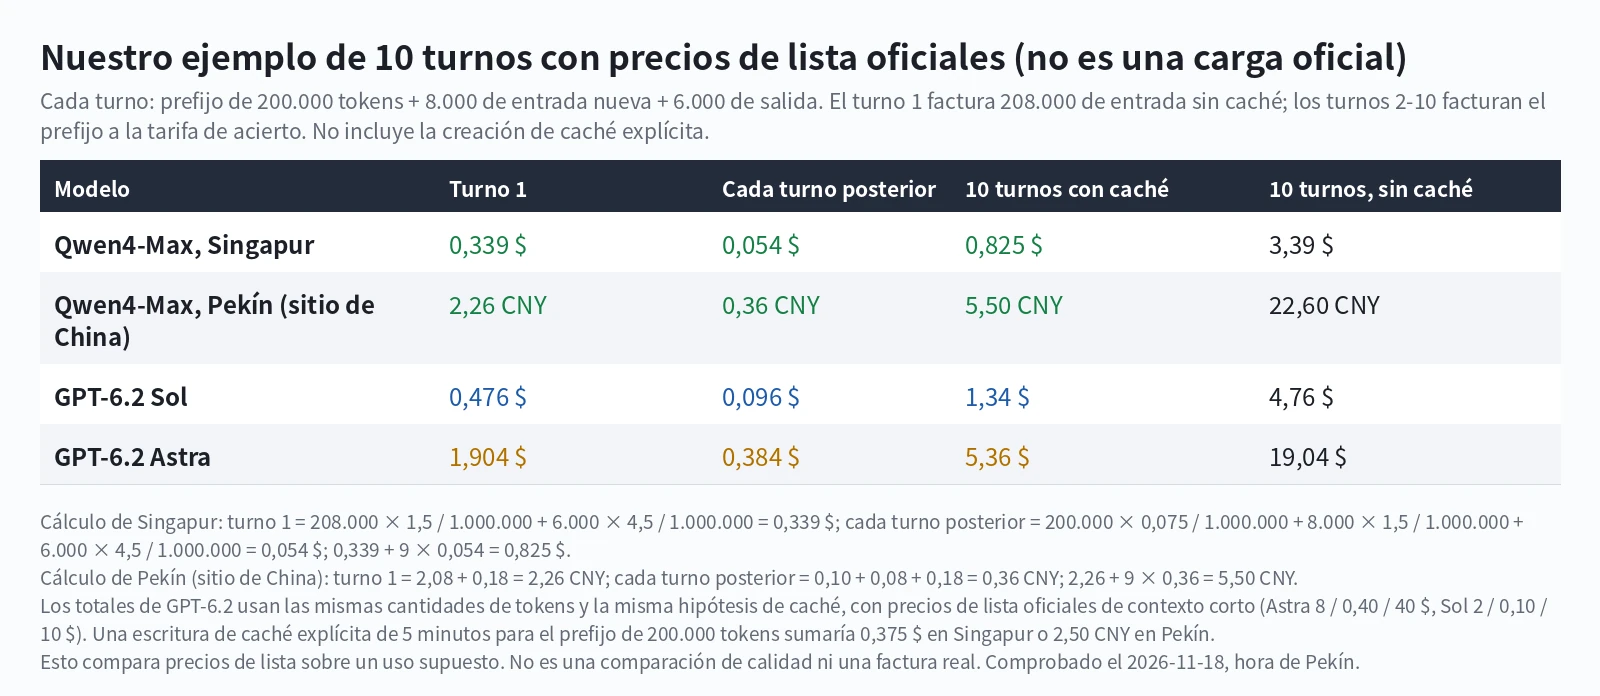
Con las tarifas internacionales de Singapur de 1,5 / 0,075 / 4,5 $: el primer turno es 208.000 × 1,5 / 1.000.000 + 6.000 × 4,5 / 1.000.000 = 0,339 $; cada uno de los 9 turnos siguientes es 200.000 × 0,075 / 1.000.000 + 8.000 × 1,5 / 1.000.000 + 6.000 × 4,5 / 1.000.000 = 0,054 $. El total de 10 turnos es 0,825 $. Los mismos 10 turnos sin ninguna caché serían 3,39 $.
Con las tarifas de Pekín del sitio de China de 10 / 0,5 / 30 CNY: el primer turno es 2,26 CNY, cada turno posterior es 0,36 CNY y el total de 10 turnos es 5,50 CNY; sin caché serían 22,60 CNY. Si el primer turno también creara una caché explícita de 5 minutos para el prefijo de 200.000 tokens, habría que sumar 0,375 $ en Singapur o 2,50 CNY en Pekín.
Con las mismas cantidades de tokens y la misma hipótesis de primero sin caché y después con caché, los precios de lista oficiales de OpenAI dan 1,34 $ para GPT-6.2 Sol y 5,36 $ para GPT-6.2 Astra (Sol es 2 $ de entrada, 0,10 $ de entrada en caché y 10 $ de salida por millón de tokens; Astra es 8 / 0,40 / 40 $). Eso compara precios de lista sobre un uso que yo he supuesto. No es una comparación de calidad ni una factura real.
Qwen también publicó una cifra de coste propia. En un mensaje de seguimiento del mismo minuto, @Alibaba_Qwen escribió que, en su evaluación Work360, el coste medio por tarea bajó de 4,43 $ a 1,67 $; el uso de tokens cayó alrededor de un 24% (Xhigh) y un 35% (High) en Work360, y alrededor de un 48% y un 49% en Terminal-Bench 4.0. (mensaje) Work360 es una evaluación propia de Qwen. Esas cifras son afirmaciones oficiales, no mediciones que yo haya hecho. El mensaje principal también dice que Qwen4-Max «outperforms Qwen3.8-Max with up to ~50% fewer tokens, while average cost per task drops over 60% in our internal evaluation», el mismo marco promocional que el seguimiento. Cito la frase «implicit caching down by 70%» tal como está escrita. La página de precios solo marca que Qwen3.8-Max tiene un descuento de caché de contexto; no encontré el precio unitario de acierto anterior en una tabla con la que pudiera comprobar ese 70%, así que no lo presento como un número que yo haya verificado.
Cuota gratuita, límites de velocidad y cómo llamarlo
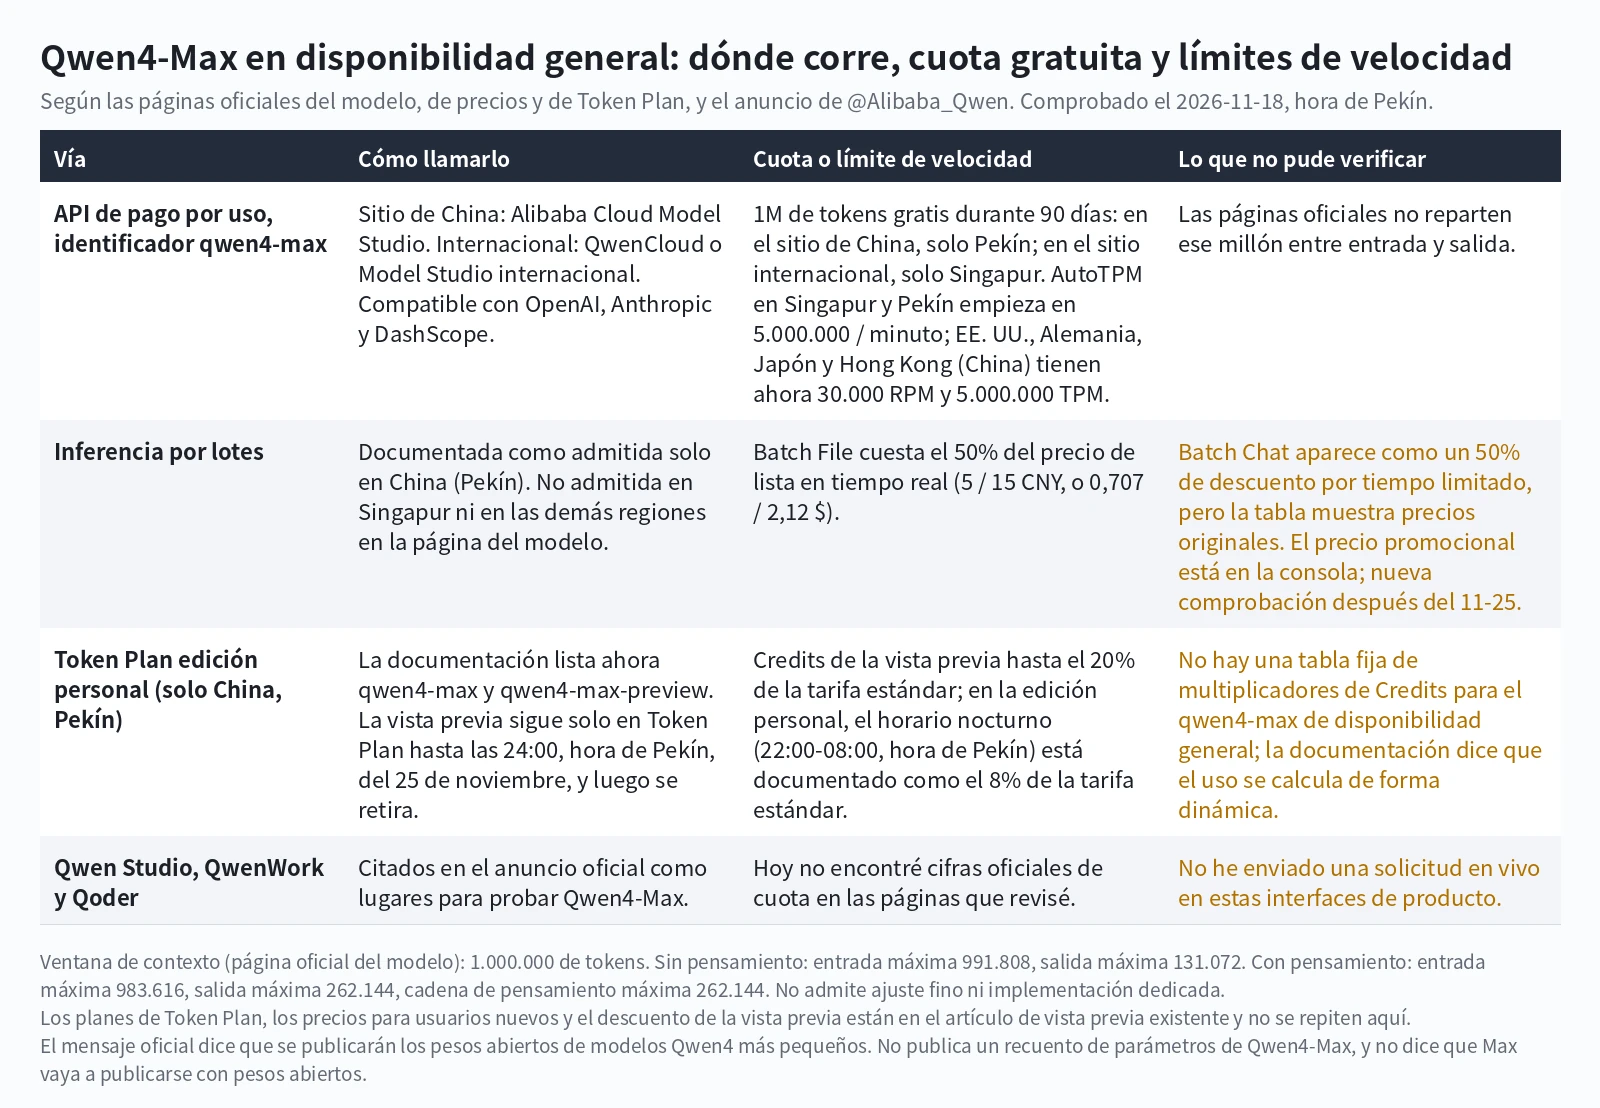
El identificador del modelo es qwen4-max. La página oficial del modelo indica que acepta entrada de texto, imagen y vídeo y devuelve texto; el pensamiento está activado por defecto, reasoning_effort vale high de forma predeterminada y puede ser low, high o xhigh; y es compatible con OpenAI Chat Completions, Responses, Anthropic Messages y DashScope. La longitud de contexto es 1.000.000 de tokens. En el modo sin pensamiento, la entrada máxima es 991.808 y la salida máxima es 131.072; en el modo de pensamiento, la entrada máxima es 983.616 y la salida máxima es 262.144, con una cadena de pensamiento máxima de 262.144. No admite ajuste fino ni implementación dedicada del modelo. Yo no he enviado una solicitud en vivo; el formato exacto de llamada está en la página del modelo.
La cuota gratuita es válida durante 90 días a partir de la fecha de activación de Model Studio, del lanzamiento del modelo o de la aprobación de la solicitud, la que sea posterior. La página del sitio de China indica que una cuota gratuita de 1 millón de tokens está disponible solo en China (Pekín). La página internacional indica que una cuota gratuita de 1 millón de tokens está disponible solo en Singapur. Ninguna de las dos páginas reparte ese millón entre entrada y salida, y este artículo no inventa esa división.
En cuanto a los límites de velocidad, Singapur y Pekín usan tramos AutoTPM según el gasto mensual de 5.000.000 / 10.000.000 / 20.000.000 tokens por minuto. Los tramos del sitio de China son hasta 100.000 CNY, de 100.000 a 1.000.000 CNY, y por encima de 1.000.000 CNY. La página internacional usa hasta 8.000 $, de 8.000 $ a 140.000 $, y por encima de 140.000 $. En Estados Unidos, Alemania, Japón y Hong Kong (China), las cifras actuales son 30.000 llamadas por minuto y 5.000.000 de tokens por minuto, incluida la entrada y la salida.
Hay tres caminos prácticos. Primero, la API de pago por uso: el sitio de China a través de Alibaba Cloud Model Studio, o a nivel internacional a través de QwenCloud o del Model Studio internacional, siempre con el identificador qwen4-max. La página del modelo en QwenCloud da esta URL base de ejemplo compatible con Singapur: https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1. Use una variable de entorno para la clave y no la deje en un repositorio. Segundo, las superficies de producto citadas en el mensaje oficial: Qwen Studio, QwenWork y Qoder. No encontré cifras oficiales de cuota para esas interfaces de producto. Tercero, Token Plan. La documentación de la edición personal ahora lista tanto qwen4-max como qwen4-max-preview. El modelo de vista previa sigue estando solo en Token Plan. Su ventana de vista previa corre hasta las 24:00, hora de Pekín, del 25 de noviembre (08:00 PT ese día), y el modelo se retira después. Durante la vista previa, el consumo de Credits puede bajar hasta el 20% de la tarifa estándar; en la edición personal, las llamadas entre las 22:00 y las 08:00, hora de Pekín (06:00 a 16:00 PT), están documentadas como el 8% de la tarifa estándar. No encontré una tabla fija de multiplicadores de Credits para el qwen4-max de disponibilidad general en Token Plan; la documentación dice que el consumo se calcula de forma dinámica según el modelo, los tokens, el modo de pensamiento y las llamadas a herramientas. Token Plan Personal Edition está disponible por ahora solo en la región de China (Pekín). Para los planes, los precios para usuarios nuevos y los descuentos de la vista previa, véase el artículo de la vista previa. Esta página no repite ese desglose, para que los dos artículos no compitan por las mismas palabras clave.
El mensaje oficial termina así: «The open weights of smaller Qwen4 models will be released. Stay tuned.» No publica un recuento de parámetros de Qwen4-Max, y no dice que Max vaya a publicarse con pesos abiertos. Este artículo no completa esos datos.
Lecturas relacionadas
Para dónde corre la vista previa, los planes de Token Plan y el descuento de la vista previa, véase Qwen4-Max vista previa. Para una tabla más amplia de precios de lista, véase la comparativa de precios de API de LLM. Para las tarifas oficiales de GPT-6.2 Astra y Sol, véase el precio de GPT-6.2 Astra.