

Longitud de contexto en Ollama: cómo cambiar num_ctx (5 métodos probados)
Ollama se olvida del principio de una conversación larga o tu agente de código pierde de vista los archivos porque el contexto es más corto de lo que crees. Probamos en Ollama 0.40.13 cada forma de cambiar la longitud de contexto, cuál gana cuando hay varias y qué pasa si pasas del límite del modelo.
 bufferSobre el autor8 min de lectura
Hablas un rato con un modelo local y se olvida de lo que dijiste al principio. Conectas una herramienta de código como Claude Code y pierde de vista un archivo que acaba de leer. Casi siempre el modelo está bien y lo que pasa es que la longitud de contexto en Ollama es menor de lo que crees. Hay varios sitios donde cambiarla, y es fácil tocar uno que otro ajuste anula sin avisar. Probamos cada método en un equipo Linux sin GPU, con el Ollama actual (0.40.13) y qwen2.5:0.5b, y después de cada cambio miramos el valor real con ollama ps.
¿Cuál es la longitud de contexto por defecto en Ollama?
Las preguntas frecuentes oficiales de Ollama dicen que la ventana de contexto por defecto es de 4096 tokens. La página de longitud de contexto lo concreta: depende de la VRAM. Con menos de 24 GiB son 4k, entre 24 y 48 GiB son 32k, y con 48 GiB o más son 256k. Los modelos en la nube usan por defecto su contexto máximo.
Nuestro equipo de prueba no tiene GPU, y el log de arranque del servidor muestra esta línea, que coincide con la documentación:
msg="vram-based default context" total_vram="0 B" default_num_ctx=4096Sin tocar nada, qwen2.5:0.5b arrancó con 4096 en la columna CONTEXT de ollama ps. Ojo: ollama show qwen2.5:0.5b muestra context length 32768. Ese es el máximo que admite el modelo, no lo que Ollama le asigna, y confunde a mucha gente.
Otra incoherencia: la tabla de parámetros de la documentación del Modelfile todavía pone «Default: 2048» para num_ctx. No coincide con las preguntas frecuentes, ni con la página de contexto, ni con los 4096 que medimos, así que guíate por las preguntas frecuentes y por ollama ps.
5 formas de cambiar la longitud de contexto en Ollama
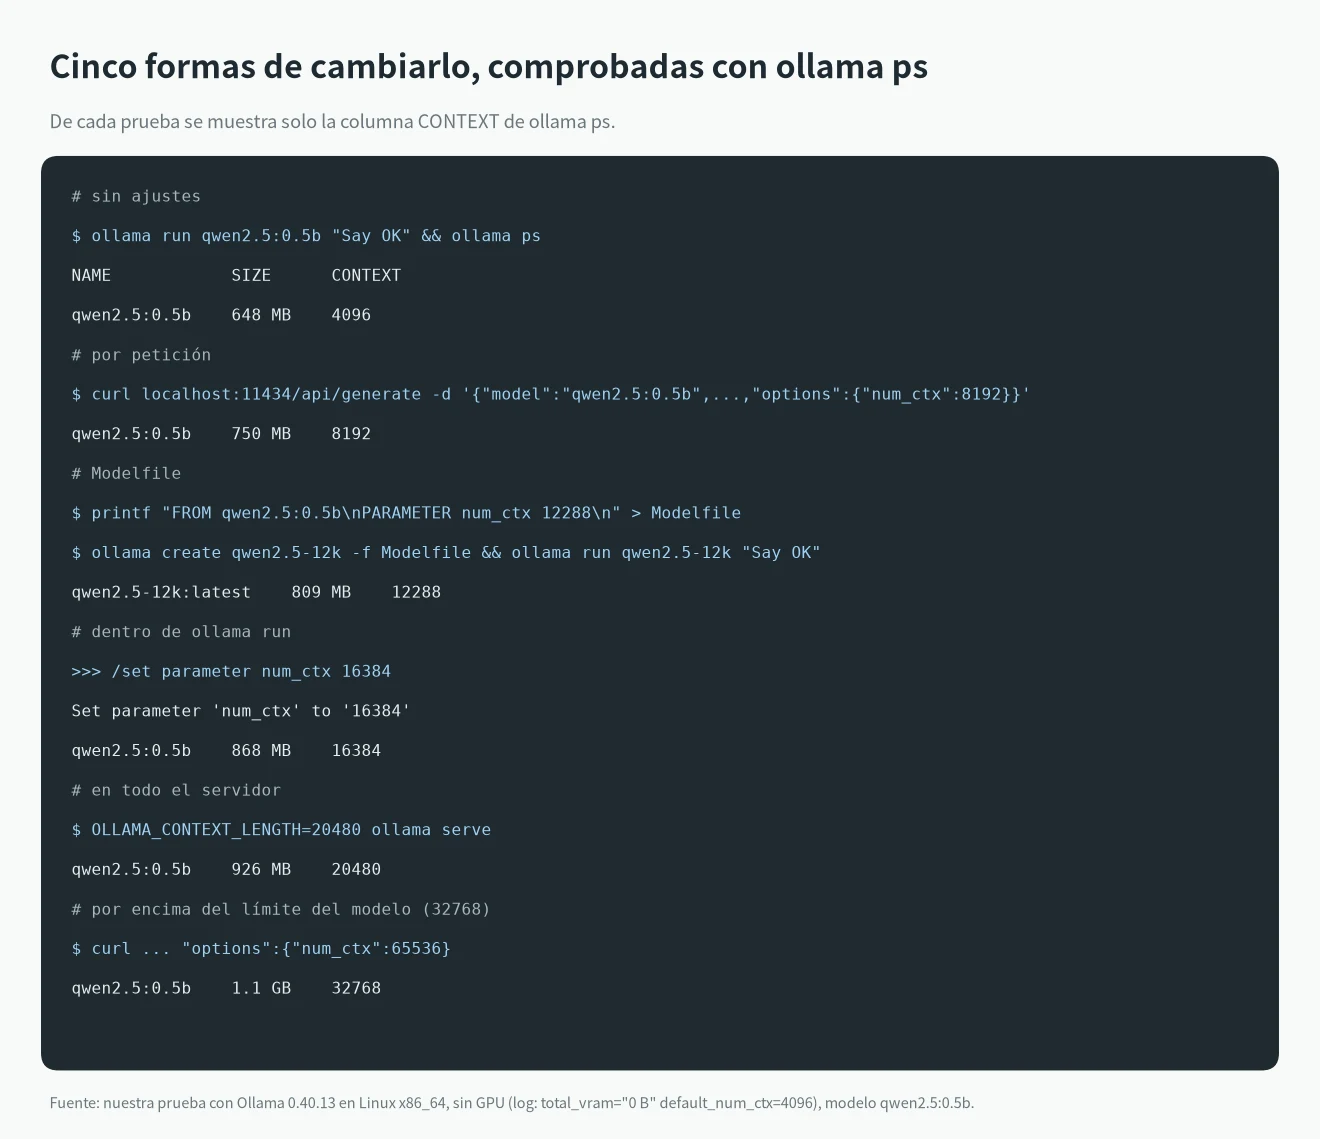
Probamos cada método en 0.40.13. La imagen muestra lo que marcó ollama ps tras cada cambio:
1. OLLAMA_CONTEXT_LENGTH: todo el servidor
Si quieres el mismo contexto para todos los modelos y todos los clientes, define esta variable al arrancar el servidor. Al arrancarlo con OLLAMA_CONTEXT_LENGTH=20480 ollama serve, la línea de configuración del arranque mostró OLLAMA_CONTEXT_LENGTH:20480 y ollama run cargó el modelo con CONTEXT 20480.
OLLAMA_CONTEXT_LENGTH=64000 ollama serveSi Ollama corre como servicio o como aplicación de escritorio, una variable exportada en tu terminal no le llega. Defínela como indican las preguntas frecuentes:
- Linux (systemd): ejecuta
systemctl edit ollama.service, añadeEnvironment="OLLAMA_CONTEXT_LENGTH=64000"bajo[Service]y luegosystemctl daemon-reloadysystemctl restart ollama. - App de macOS: ejecuta
launchctl setenv OLLAMA_CONTEXT_LENGTH 64000y reinicia Ollama. - Windows: cierra Ollama desde la barra de tareas, crea
OLLAMA_CONTEXT_LENGTHen «Editar las variables de entorno de esta cuenta», guarda y vuelve a abrir Ollama desde el menú Inicio.
La página de contexto también menciona un control deslizante de longitud de contexto en los ajustes de la app de Ollama. Probamos en la línea de comandos de Linux, así que no lo usamos.
2. num_ctx en una petición a la API: solo esa petición
Cuando llames a /api/generate o /api/chat, pon num_ctx dentro de options:
curl http://localhost:11434/api/generate -d '{
  "model": "qwen2.5:0.5b",
  "prompt": "Say OK",
  "stream": false,
  "options": {"num_ctx": 8192}
}'
Tras esta petición, ollama ps marcó CONTEXT 8192 y 750 MB. Luego enviamos otra sin num_ctx: el modelo se recargó y CONTEXT volvió a 4096. Hay que enviar el parámetro en cada petición; si falta, mandan los demás ajustes.
3. PARAMETER num_ctx en un Modelfile: fijo en el modelo
Para que un modelo use siempre el mismo contexto, lo más fiable es crear un modelo nuevo a partir de él:
FROM qwen2.5:0.5b
PARAMETER num_ctx 12288
ollama create qwen2.5-12k -f Modelfile
ollama run qwen2.5-12kDespués, ollama show qwen2.5-12k --parameters mostró num_ctx 12288 y ollama ps marcó CONTEXT 12288 mientras corría. Cualquier cliente que pida qwen2.5-12k recibe esa longitud.
4. /set parameter num_ctx dentro de ollama run: solo esta sesión
Dentro de ollama run, escribe:
>>> /set parameter num_ctx 16384
Set parameter 'num_ctx' to '16384'
En nuestra prueba CONTEXT pasó a 16384. Al salir y abrir de nuevo ollama run qwen2.5:0.5b, volvió a 4096. Para conservarlo, escribe /save qwen2.5-16k después del /set. Ollama responde Created new model 'qwen2.5-16k', y al ejecutar qwen2.5-16k sale CONTEXT 16384, igual que con el método 3.
Los comandos con barra solo funcionan si los escribes en el modo interactivo. Cuando pasamos /set parameter num_ctx 16384 a ollama run por una tubería, se envió al modelo como una pregunta normal y el ajuste no cambió. ollama run --help en 0.40.13 tampoco tiene una opción para el contexto.
5. La API compatible con OpenAI (/v1): usa el método 1 o el 3
Muchas herramientas hablan con Ollama por /v1/chat/completions. La documentación de compatibilidad con OpenAI dice que la API de OpenAI no tiene forma de fijar el tamaño del contexto, así que hay que crear un modelo con un Modelfile y llamarlo por su nuevo nombre.
También probamos la variable del servidor. Con OLLAMA_CONTEXT_LENGTH=20480, una llamada a qwen2.5:0.5b por /v1/chat/completions lo cargó con CONTEXT 20480. Para herramientas que usan /v1, sirven el método 1 y el 3.
Qué ajuste gana cuando hay varios
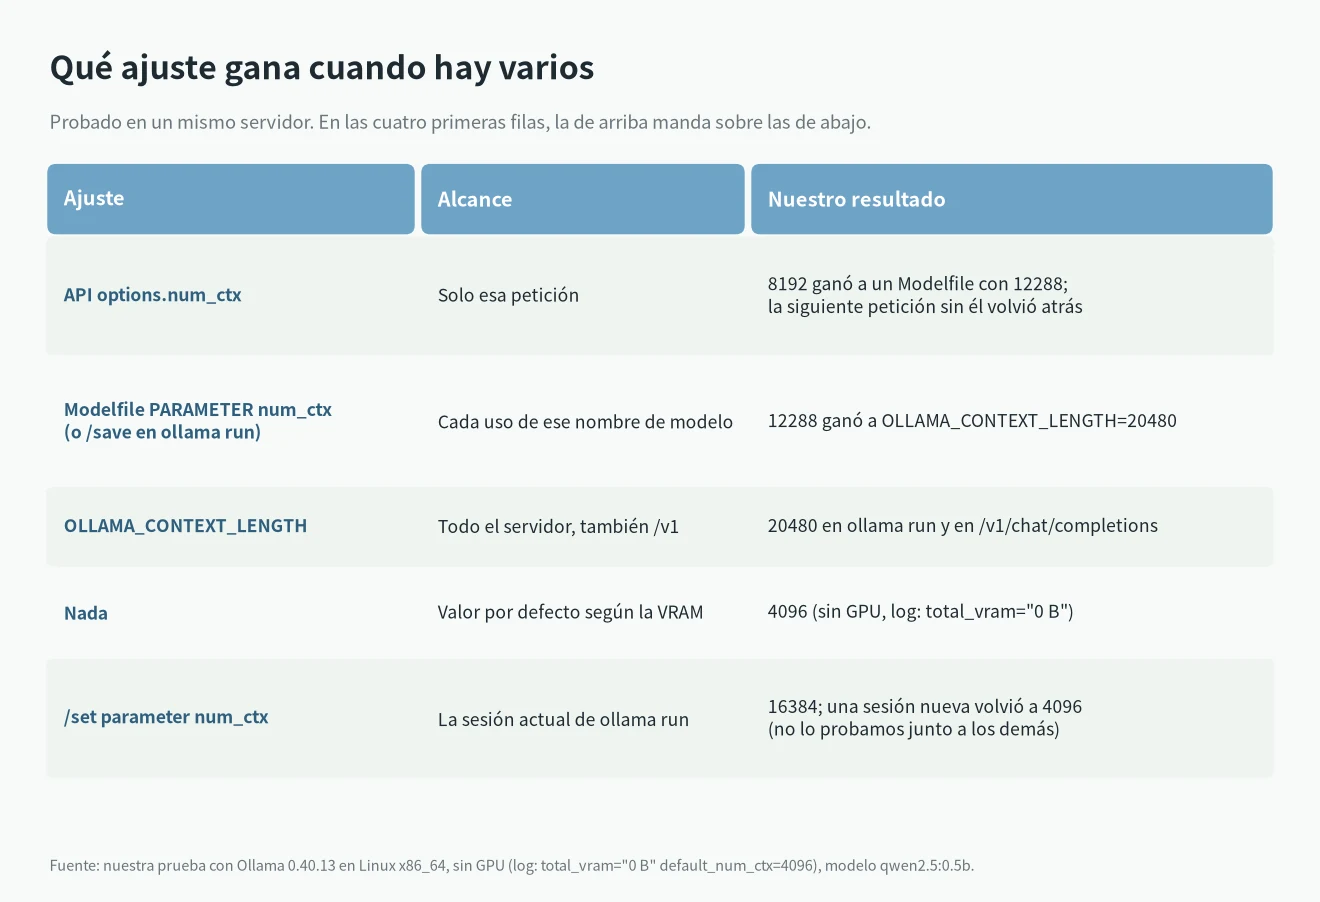
Cuando un cambio parece no hacer nada, normalmente otro ajuste lo está anulando. Combinamos los ajustes en un mismo servidor:
- Con el servidor arrancado con
OLLAMA_CONTEXT_LENGTH=20480,qwen2.5-12k(12288 en su Modelfile) cargó con CONTEXT 12288. El parámetro del modelo ganó a la variable. - El mismo
qwen2.5-12kcon"num_ctx": 8192en la petición a la API cargó con CONTEXT 8192. La petición ganó al Modelfile. - El orden es: num_ctx en la petición, luego num_ctx en el Modelfile, luego OLLAMA_CONTEXT_LENGTH y, al final, el valor por defecto según la VRAM.
Revisa en ese orden. Si pusiste OLLAMA_CONTEXT_LENGTH=64000 y ollama ps muestra otra cifra, mira si el modelo trae su propio num_ctx (ollama show MODELO --parameters) o si tu cliente envía num_ctx en sus peticiones.
Cómo comprobar que funcionó y qué pasa si te pasas
El valor real se lee en un solo sitio: ejecuta ollama ps con el modelo cargado y mira CONTEXT. La página de contexto recomienda lo mismo, y vigilar la columna PROCESSOR para que el modelo no acabe en la CPU.
Por encima del límite del modelo, Ollama recorta el valor. qwen2.5:0.5b admite 32768. Enviamos "num_ctx": 65536, la petición funcionó, ollama ps marcó CONTEXT 32768 y el log del servidor dijo n_ctx_slot = 32768. No hay error, pero tampoco recibes 65536.
Más contexto ocupa más memoria. Con el mismo qwen2.5:0.5b medimos 648 MB con 4096, 750 MB con 8192, 868 MB con 16384, 926 MB con 20480 y 1,1 GB con 32768. Un modelo de 0.5b es diminuto y el aumento es pequeño. Con uno de 14B crece en gigas, y si la carga falla con model requires more system memory, mira cómo resolver model requires more system memory en Ollama. Para estimar la memoria de un modelo y un contexto, usa nuestra calculadora de VRAM.
¿Cuánto contexto conviene poner?
La página de contexto dice que tareas como búsqueda web, agentes y herramientas de código deberían usar al menos 64000 tokens. Para charlar, los 4096 por defecto suelen bastar; la documentación no da cifras más finas. Para saber cuánto contexto cabe en cada GPU al usar un modelo local con una herramienta de código, mira las estimaciones de el mejor LLM local para programar. Para otros errores de Ollama, busca el mensaje exacto en nuestra lista de errores de Ollama y llama.cpp.
Preguntas frecuentes
¿Por qué ollama show dice 32768 si solo tengo 4096?
La longitud de contexto de ollama show es el máximo que admite el modelo. Lo que Ollama asigna de verdad sigue el orden de arriba. Sin ajustes, usa el valor por defecto según la VRAM, que es 4096 con menos de 24 GiB. El valor real lo muestra ollama ps.
Puse OLLAMA_CONTEXT_LENGTH y no cambió nada. ¿Por qué?
Primero asegúrate de que el proceso del servidor recibió la variable: la línea server config del log de arranque debe mostrar OLLAMA_CONTEXT_LENGTH: seguido de tu valor. Con systemd, la app de macOS y Windows, sigue los pasos del método 1 y reinicia Ollama. Si el log está bien y ollama ps sigue con otra cifra, el Modelfile del modelo o la petición de tu cliente lleva su propio num_ctx.
La documentación del Modelfile dice 2048 por defecto. ¿Cuál es?
En 0.40.13, nuestra prueba, el log de arranque y las preguntas frecuentes dicen 4096 con menos de 24 GiB de VRAM. El 2048 de la tabla de parámetros del Modelfile no coincide con el resto de la documentación.