

Artificial Analysis Intelligence Index 是什么?v5 的 9 项评测、4 类各占 25%,分数怎么看(2026)
Artificial Analysis Intelligence Index 是什么?一句话:第三方机构 Artificial Analysis 自己跑 9 项评测,加权合成一个分数。2026 年 10 月起是 v5,知识工作、编程、科学、通用四类各占 25%,目前 Claude Opus 5.5(Max)58 分第一。下面讲清楚它测什么、v5 改了什么、怎么看才不被误导。2026 年 10 月 28 日按官网核对。
 buffer关于作者约 5 分钟阅读
先说结论:Artificial Analysis Intelligence Index 是第三方机构 Artificial Analysis 自己跑分、自己加权得出的一个综合分数,用来横向比较大模型“整体有多聪明”。2026 年 10 月起用的是 v5.0:9 项评测,分成知识工作、编程、科学、通用四类,每类 25%。截至 10 月 28 日,官方页面上第一名是 Claude Opus 5.5(Max)58 分,其次是 Claude Opus 5.5(Xhigh)和 GPT-6 Astra(Max),都是 57 分。下面的数字都来自 官方方法论页 和 Intelligence Index v5.0 页面。
Artificial Analysis Intelligence Index 是什么
Artificial Analysis 是一家专门测模型和 API 的独立机构。它把多项难度很高的评测放在同样的条件下跑一遍,再按固定权重算一个加权平均,这就是 Artificial Analysis Intelligence Index。官方的说法是:Artificial Analysis Intelligence Index 是对模型整体智能的一个“有用的综合”,但和所有指标一样有局限,不一定适用于每个场景。
有两点要先知道。第一,所有评测都是 Artificial Analysis 自己跑的,不是厂商自报的分数。第二,Artificial Analysis Intelligence Index 主要是英文、纯文本的测试。看图、听语音、多语言能力是另外单独测的,不算进这个分数。所以中文用得多的人,别把它当成中文能力排名。
v5 的 9 项评测和权重
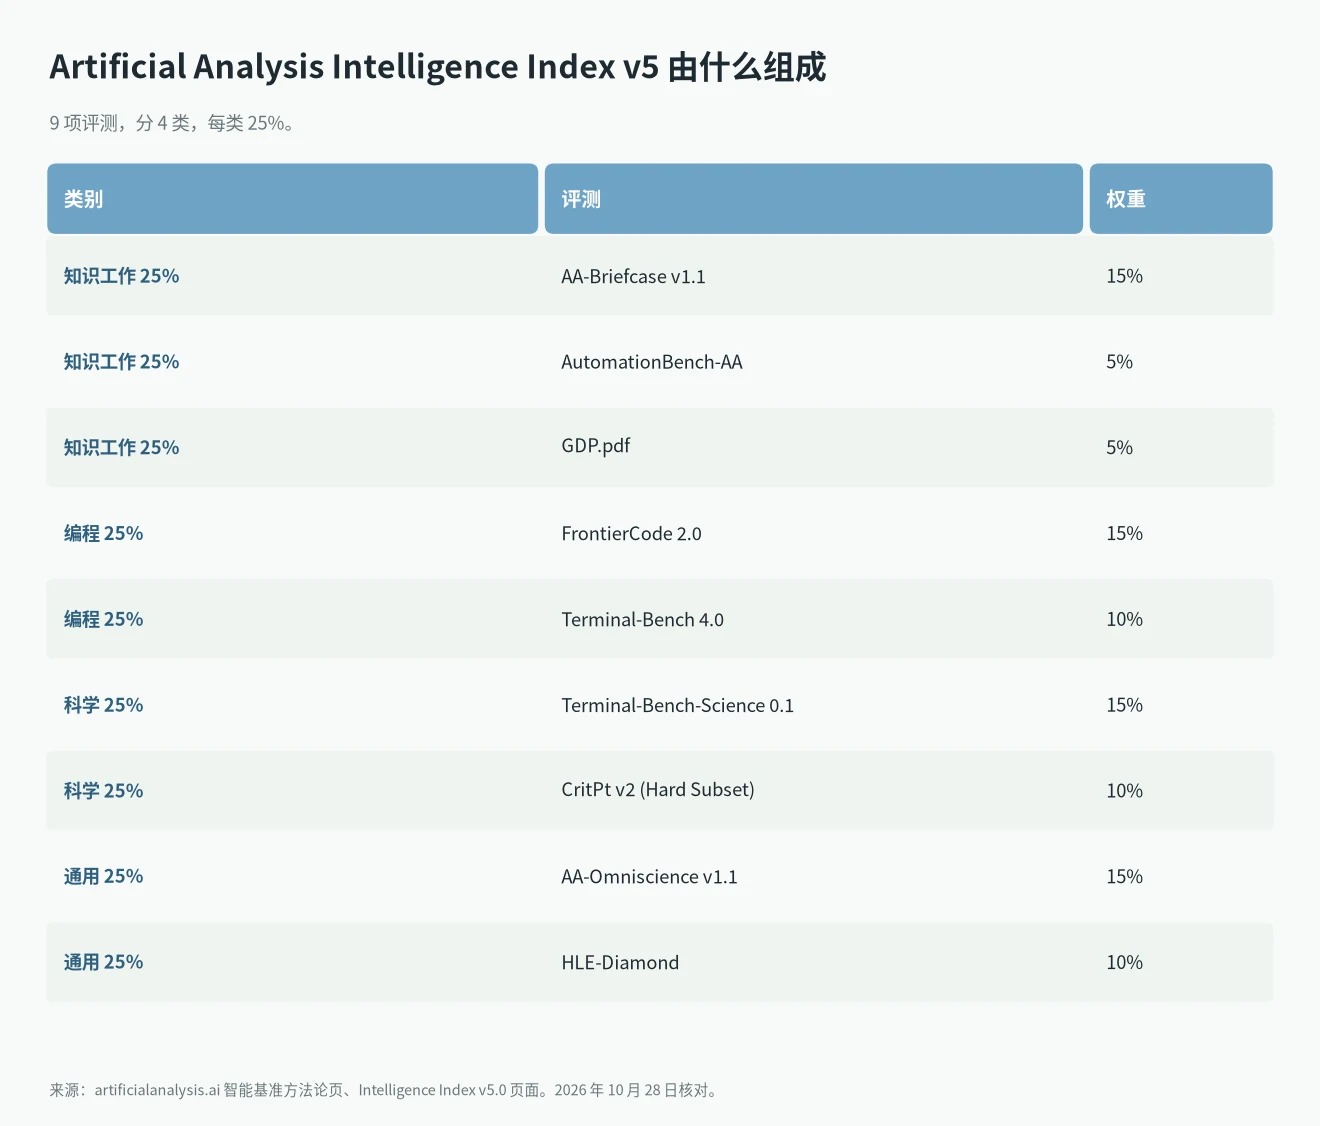
Artificial Analysis Intelligence Index v5 分四大类,每类 25%,类里面再按评测分配权重:
| 类别 | 评测 | 权重 | 测什么 |
|---|---|---|---|
| 知识工作 | AA-Briefcase v1.1 | 15% | 91 个任务,产出文件的代理型工作 |
| 知识工作 | AutomationBench-AA | 5% | 657 个任务,用 REST API 自动化 SaaS 流程 |
| 知识工作 | GDP.pdf | 5% | 100 个任务,基于长 PDF 回答 |
| 编程 | FrontierCode 2.0 | 15% | 132 题,改开源仓库的代码 |
| 编程 | Terminal-Bench 4.0 | 10% | 66 题,在终端里完成任务 |
| 科学 | Terminal-Bench-Science 0.1 | 15% | 70 题,5 个科学领域的终端任务 |
| 科学 | CritPt v2(难题子集) | 10% | 40 道物理推理难题 |
| 通用 | AA-Omniscience v1.1 | 15% | 3000 题,准确率占 10%,不胡编占 5% |
| 通用 | HLE-Diamond | 10% | 1000 题,推理和知识各一半 |
我觉得最值得注意的是 AA-Omniscience:它单独给“不胡编”(1 减幻觉率)5% 的权重。也就是说,一个模型不会的时候老实说不会,在 Artificial Analysis Intelligence Index 里是加分的。
v5 相比 v4 改了什么
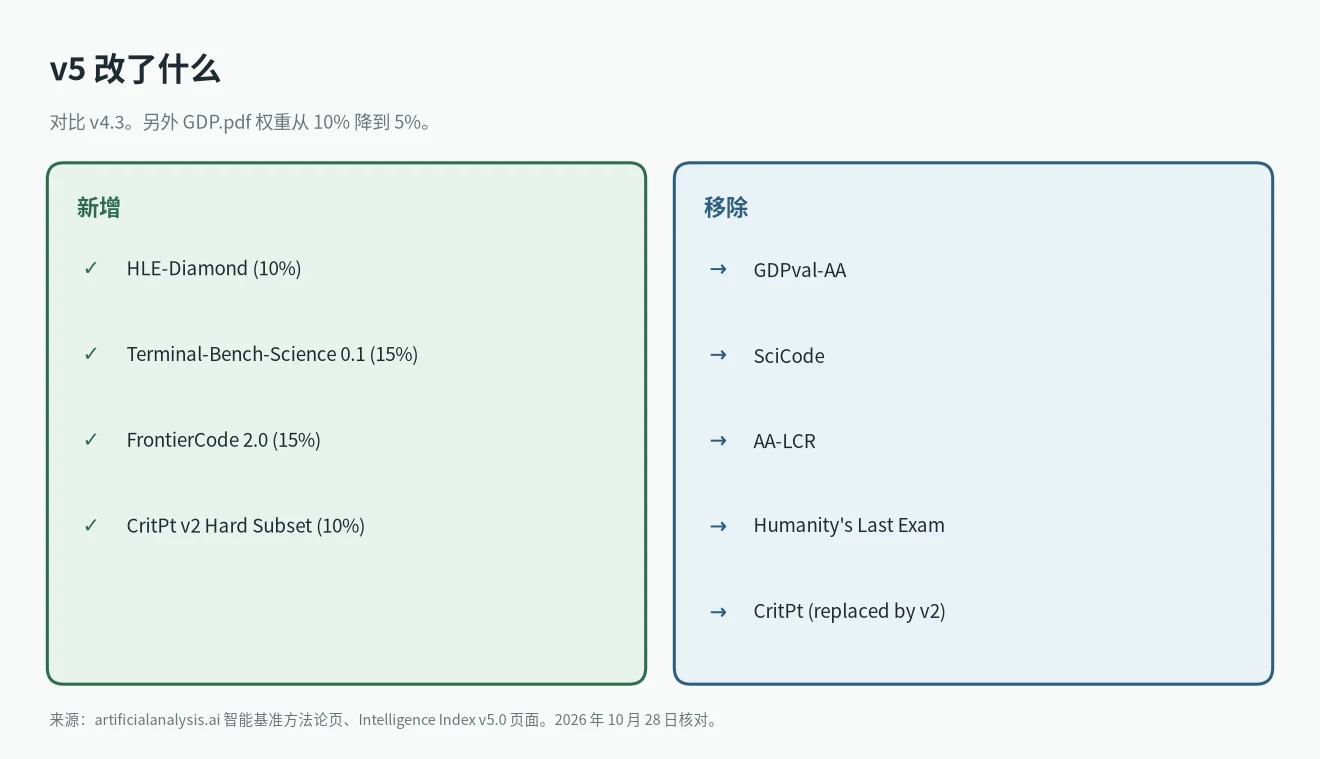
按官方版本记录,v5.0 从 2026 年 10 月开始:新增 HLE-Diamond、Terminal-Bench-Science 和 FrontierCode 2.0;GDP.pdf 从 10% 降到 5%;CritPt 换成 CritPt v2 难题子集;GDPval-AA、SciCode、AA-LCR 和完整版 Humanity’s Last Exam 移出 Artificial Analysis Intelligence Index;“Agents”类改名为知识工作,“科学推理”改名为科学。
这意味着一件很实际的事:Artificial Analysis Intelligence Index v5 的分数和 v4 时代的分数是两套题算出来的,不能直接拿来比。看到“某模型从 70 多分掉到 50 多分”,大概率是换了版本,不是模型变差了。这是我的理解,官方没有给换算公式。
现在谁排第一
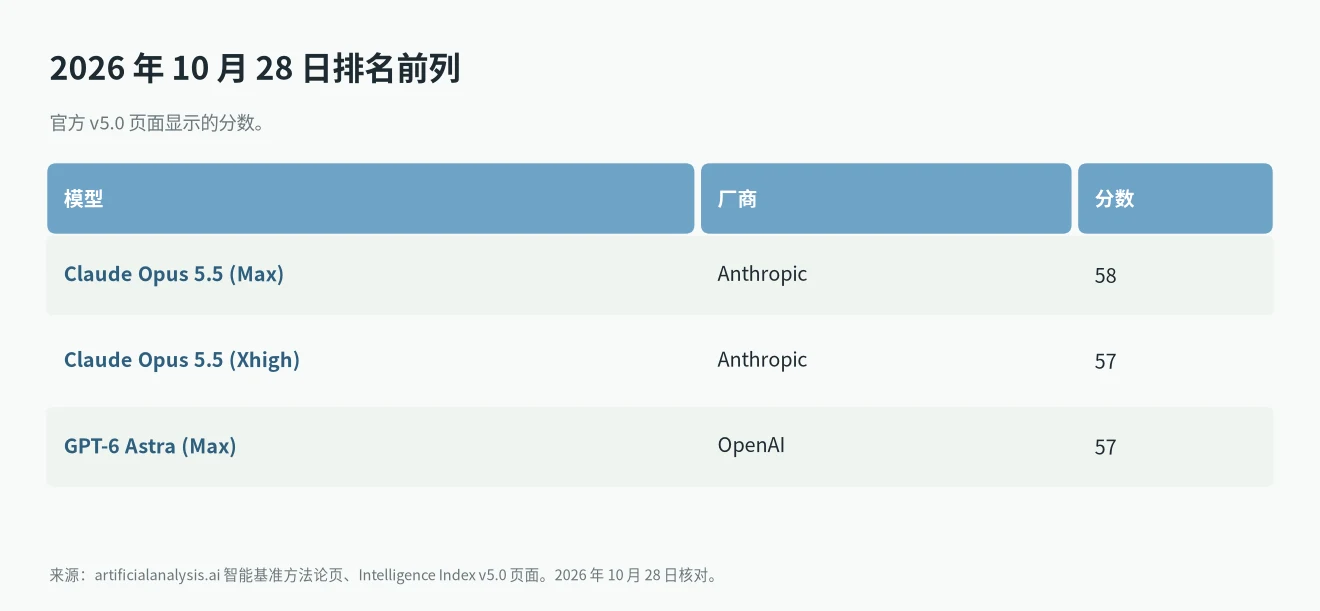
2026 年 10 月 28 日,Artificial Analysis Intelligence Index 官方 v5.0 页面写的是:Claude Opus 5.5(Max)58 分最高,Claude Opus 5.5(Xhigh)和 GPT-6 Astra(Max)都是 57 分。页面同时说明,图里展示的是 77 个模型中的 28 个。
国产模型方面,按页面数据,Kimi K3.1 Pro 约 46 分,是国产里最高的;开放权重模型里最高的是 DeepSeek V4.1 Flash,约 32.5 分。Opus 5.5 和 GPT-6.1 Sol 的详细对比我写在 Opus 5.5 vs GPT-6.1 Sol 哪个好,Kimi 的价格见 Kimi K3.1 Pro 价格对比。
怎么测:几条规则
- 统一条件:Artificial Analysis Intelligence Index 里所有模型用同样的提示、温度和评分标准。非推理模型温度 0,推理模型 0.6(厂商另有推荐时除外)。
- 零样本:只给清楚的指令,不给示例。
- 第一次答对才算:大多用 pass@1,多次重复的评测取平均。
- API 出错自动重试,最多 30 次;持续出错影响结果的,不发布。
怎么看这个分数才不被误导
我的建议是把 Artificial Analysis Intelligence Index 当成“初筛”,别当成“结论”。
- 差 1 到 2 分,基本可以当作同一档。58 和 57 的差别,在你自己的任务上很可能感觉不到。
- 同一个模型会按推理强度分成好几个条目,比如 Max 和 Xhigh。比较时要看清是哪一档,档位越高通常越贵、越慢。
- 页面上还有每任务成本、输出 token 和耗时。分数接近时,成本差几倍才是真正该看的,这一点在 Opus 5.5 和 GPT-6.1 Sol 的对比里特别明显。
- 想本地跑模型的,开放权重那几行更有参考价值,可以配合 本地大模型推荐 一起看;算 API 成本可以看 大模型 API 价格对比表。
Artificial Analysis Intelligence Index 常见问题
分数满分是多少?
官方没有说“满分 100”这种话。它是各项评测得分的加权平均,目前最高的是 58 分,所以离“全做对”还远。
多久更新一次?
新模型发布后会陆续测完再上榜,评测组合则按版本更新,Artificial Analysis Intelligence Index 今年从 v4.0 一路改到了 v5.0,具体看官方方法论页最下面的版本记录。
和 LMArena 这类投票榜有什么不同?
Artificial Analysis Intelligence Index 是机构自己跑固定题目打分,不是用户投票。两者测的东西不一样,可以对照着看。