

DGX Spark vs Mac Studio: la comparativa esencial para LLM locales (2026)
DGX Spark vs Mac Studio, revisado con las especificaciones de NVIDIA y Apple, sus tiendas y las pruebas de llama.cpp el 28 de octubre de 2026: el Mac Studio genera unas tres veces más rápido y el DGX Spark aporta CUDA.
 bufferSobre el autor10 min de lectura
DGX Spark vs Mac Studio depende de para qué vas a usar el equipo. Si sobre todo vas a conversar con modelos locales y usarlos para programar, con el mismo presupuesto conviene más el Mac Studio. El Mac Studio con M5 Ultra de 80 núcleos de GPU cuesta desde 6.799 $, genera tokens más de tres veces más rápido que el DGX Spark en las pruebas de llama.cpp y admite 256 o 512 GB de memoria. El DGX Spark de 128 GB cuesta ahora 6.950 $. Su punto fuerte no es la velocidad, sino el software CUDA de NVIDIA: cómpralo si necesitas vLLM, TensorRT-LLM o ajuste fino, o si quieres conectar dos equipos. Con unos 3.000 $, un Mac Studio con M5 Max de 40 núcleos de GPU ya genera el doble de rápido que el DGX Spark. Las especificaciones vienen de NVIDIA y Apple, los precios de sus tiendas y de un rastreador de precios, y las velocidades de los hilos de pruebas del repositorio oficial de llama.cpp. Lo revisé todo el 28 de octubre de 2026.
Respuesta corta
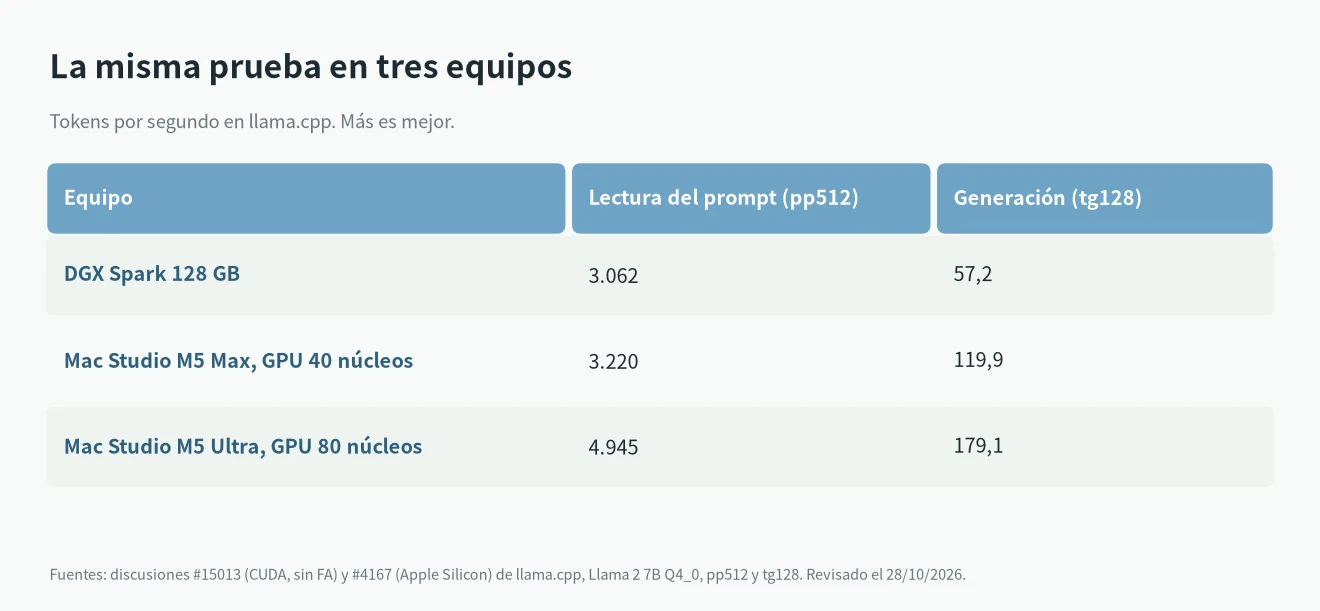
- Velocidad de generación: gana el Mac Studio. En la misma prueba, el DGX Spark genera 57,2 tokens por segundo, el M5 Max 119,9 y el M5 Ultra 179,1.
- Lectura del prompt: la diferencia es menor. El DGX Spark lee 3.062 tokens por segundo, el M5 Max 3.220 y el M5 Ultra 4.945.
- Tamaño del modelo: el DGX Spark tiene 128 GB fijos. El Mac Studio con M5 Ultra puede llevar 256 GB, y la versión de 80 núcleos hasta 512 GB.
- Software: el DGX Spark usa CUDA, así que la mayoría de los frameworks de IA funcionan sin cambios. El Mac Studio usa Metal y MLX. llama.cpp, Ollama y LM Studio funcionan, pero herramientas de CUDA como vLLM y TensorRT-LLM no.
- Cuál comprar: para usar modelos por tu cuenta, el Mac Studio. Si tu trabajo depende de CUDA, el DGX Spark.
DGX Spark vs Mac Studio: especificaciones
Según la guía de usuario del NVIDIA DGX Spark, el DGX Spark usa el chip GB10 con 128 GB de memoria unificada LPDDR5X y 273 GB/s de ancho de banda. Trae un SSD de 4 TB y una tarjeta de red ConnectX-7 de hasta 200 Gb/s, de modo que dos unidades pueden trabajar como una. El GB10 tiene un TDP de 140 W y el equipo incluye un adaptador de 240 W.
Según las especificaciones técnicas del Mac Studio, hay dos chips. El M5 Max con GPU de 32 núcleos tiene 36 GB de memoria y 460 GB/s. La versión con GPU de 40 núcleos llega a 614 GB/s y hasta 128 GB. El M5 Ultra empieza en 96 GB con 1,2 TB/s y se puede configurar con 256 GB. La versión con CPU de 36 núcleos y GPU de 80 también admite 512 GB. La tienda de Apple indica que la opción de 512 GB llega a finales de octubre.
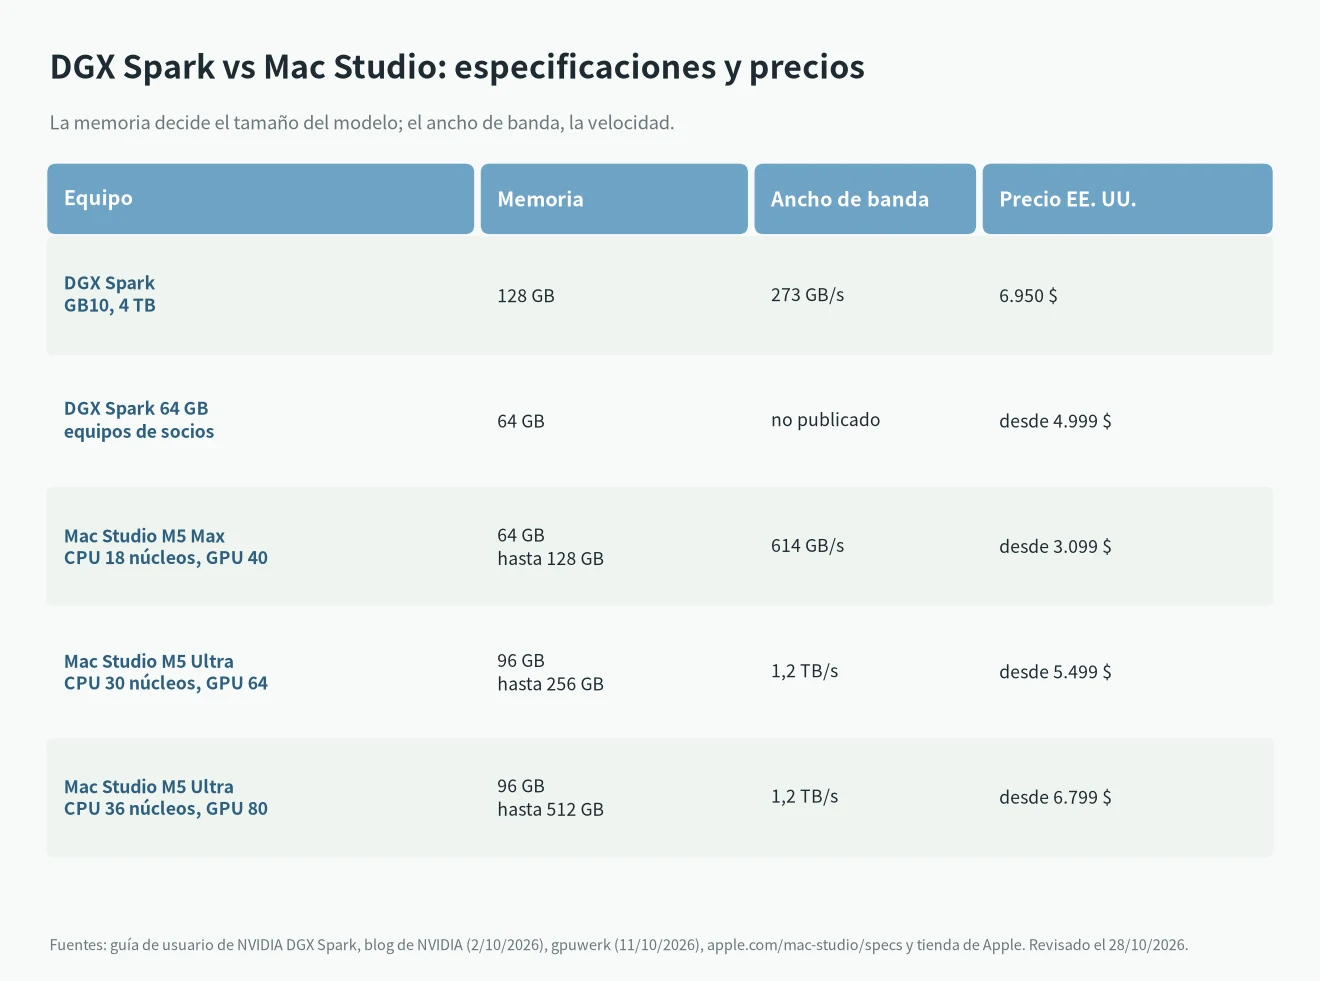
El ancho de banda es el dato más importante de esta comparación. Para escribir cada token nuevo, el equipo tiene que leer los pesos del modelo desde la memoria una vez, así que más ancho de banda significa más velocidad. Los 1,2 TB/s del M5 Ultra son más de cuatro veces los 273 GB/s del DGX Spark. El M5 Max de 40 núcleos, con 614 GB/s, tiene más del doble.
Precios en octubre de 2026
El precio del DGX Spark ha subido varias veces. Salió a 3.999 $ en octubre de 2025. Según el rastreador de precios de gpuwerk, la tienda de NVIDIA vende ahora el modelo de 128 GB y 4 TB a 6.950 $ (revisado el 11 de octubre). El 2 de octubre de 2026, NVIDIA anunció además un modelo de 64 GB, vendido por fabricantes socios desde el 23 de octubre, desde 4.999 $. NVIDIA dice que puede con modelos de hasta 100.000 millones de parámetros (blog de NVIDIA).
Los precios del Mac Studio son de la tienda de Apple en EE. UU., revisados el 28 de octubre:
- M5 Max (CPU de 18 núcleos, GPU de 32, 36 GB, 512 GB): desde 2.499 $.
- M5 Max (CPU de 18 núcleos, GPU de 40, 64 GB, 1 TB): desde 3.099 $.
- M5 Ultra (CPU de 30 núcleos, GPU de 64, 96 GB, 1 TB): desde 5.499 $.
- M5 Ultra (CPU de 36 núcleos, GPU de 80): desde 6.799 $.
Más memoria cuesta aparte; el configurador de Apple muestra el precio exacto. Así que, con el mismo presupuesto, la comparación es el DGX Spark de 6.950 $ contra el Mac Studio con M5 Ultra de 80 núcleos desde 6.799 $.
Velocidad real: la misma prueba en los dos
Lo más justo es comparar con el mismo modelo y la misma prueba. El repositorio de llama.cpp tiene dos hilos de pruebas que se actualizan desde hace tiempo: la tabla de CUDA, #15013 y la tabla de Apple Silicon, #4167. Las dos usan Llama 2 7B en Q4_0. pp512 mide la lectura de un prompt de 512 tokens y tg128 la generación de 128 tokens nuevos.
Generación: el Mac Studio es de 2 a 3 veces más rápido
El DGX Spark de 128 GB genera 57,2 tokens por segundo. El M5 Max de 40 núcleos genera 119,9, unas 2,1 veces más. El M5 Ultra de 80 núcleos genera 179,1, unas 3,1 veces más. La diferencia coincide con la del ancho de banda.
Lectura del prompt: una diferencia menor
Leer el prompt depende sobre todo de la potencia de cálculo. El DGX Spark lee 3.062 tokens por segundo sin Flash Attention y 3.661 con ella. El M5 Max lee 3.220 y el M5 Ultra 4.945. Apple añadió aceleradores neuronales a la GPU de los chips M5, así que el Mac Studio tampoco se queda atrás aquí. Los dos hilos usaron versiones distintas de llama.cpp, así que estos números sirven para ver la diferencia aproximada, no un porcentaje exacto.
Datos con un modelo grande
Los resultados del DGX Spark con gpt-oss-120b están en el archivo oficial de pruebas de llama.cpp para el DGX Spark. Con el contexto vacío genera 58,7 tokens por segundo y lee un prompt de 2.048 tokens a 2.444 tokens por segundo. Con 32K tokens de contexto, la generación baja a 42,8. No encontré un resultado oficial del M5 Ultra en la misma prueba, así que no los comparo aquí. Por el ancho de banda, el Mac Studio también debería ser más rápido con modelos grandes.
DGX Spark vs Mac Studio: qué cabe en la memoria
Para saber si un modelo funcionará, empieza por el tamaño del archivo. Los datos vienen de las páginas de Ollama de gpt-oss, Llama 3.3 y Qwen3. En uso, el modelo ocupa algo más que el archivo, porque el contexto y el sistema también necesitan memoria.
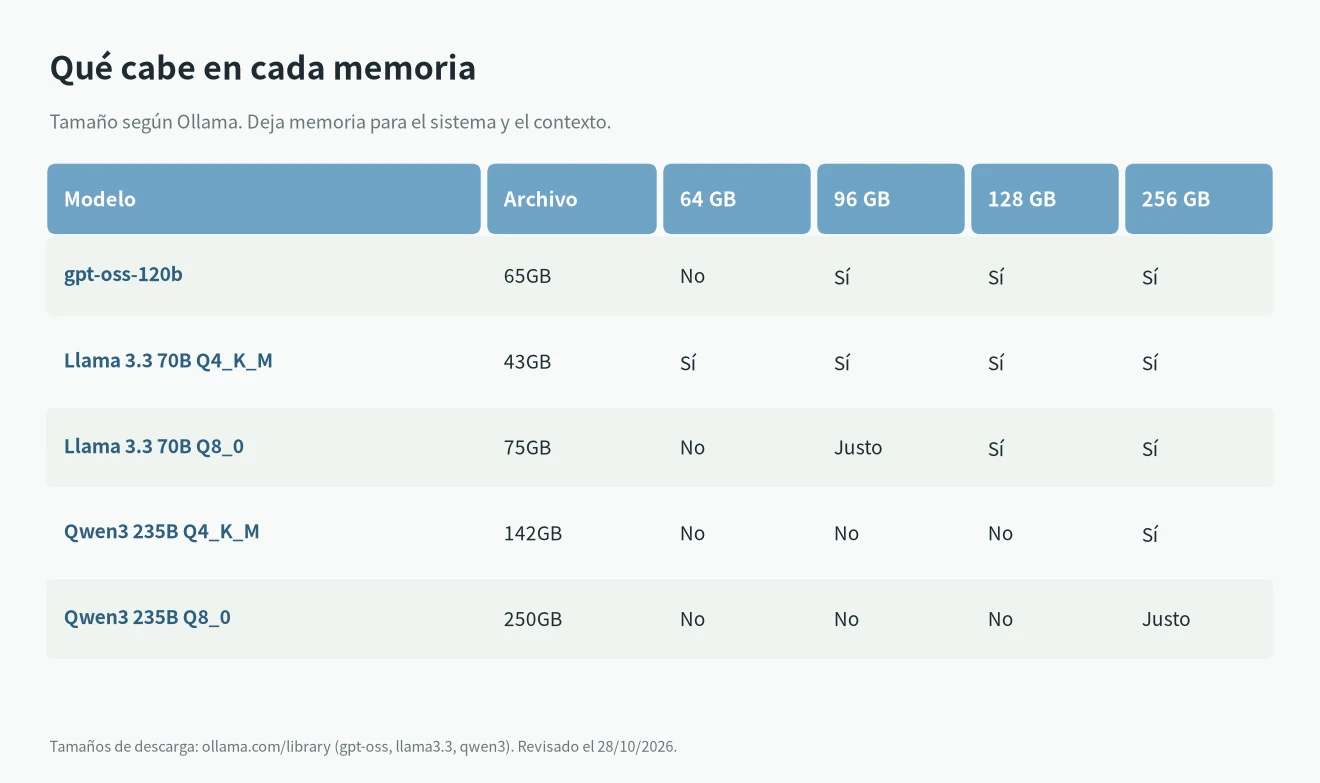
- 64 GB (el DGX Spark de 64 GB o un M5 Max básico): Llama 3.3 70B en Q4_K_M, de 43 GB, funciona. gpt-oss-120b, de 65 GB, no cabe.
- 96 y 128 GB (un M5 Ultra básico o el DGX Spark): funcionan gpt-oss-120b y Llama 3.3 70B Q8_0, de 75 GB.
- 256 GB (un M5 Ultra con más memoria): funciona Qwen3 235B en 4 bits, de 142 GB. Un solo DGX Spark no puede con él; hacen falta dos conectados.
Si quieres usar modelos de más de 200.000 millones de parámetros, el Mac Studio es la opción más sencilla, porque basta con un equipo.
Software: CUDA frente a Metal
El DGX Spark viene con NVIDIA DGX OS, y CUDA, PyTorch, vLLM y TensorRT-LLM tienen soporte. Si tu trabajo se va a desplegar en GPU de centros de datos de NVIDIA, el código que escribas en el DGX Spark se puede llevar directamente. Para ajuste fino y entrenamiento también hay muchas más herramientas de CUDA que de Mac.
El Mac Studio ejecuta modelos locales sobre todo con llama.cpp, Ollama, LM Studio y MLX de Apple. Para descargar modelos y usarlos para conversar, programar o responder preguntas, estas herramientas bastan y funcionan nada más instalarlas. La desventaja es que no hay CUDA, así que mucho código de investigación necesita cambios para funcionar en un Mac.
DGX Spark vs RTX 5090 para LLM
Mucha gente compara el DGX Spark con una RTX 5090 en vez de con un Mac. En corto: con modelos que caben en 32 GB, la RTX 5090 es unas cinco veces más rápida y mucho más barata. El DGX Spark solo gana cuando el modelo necesita más de 32 GB.
| DGX Spark | RTX 5090 | |
|---|---|---|
| Memoria | 128 GB unificada | 32 GB GDDR7 |
| Ancho de banda | 273 GB/s | 1.792 GB/s |
| Llama 2 7B Q4_0, tg128 | 57,2 tok/s | 290 tok/s |
| Consumo | Chip de 140 W (adaptador de 240 W) | Tarjeta de 575 W, más el PC |
| Precio | 6.950 dólares (tienda de NVIDIA) | 1.999 dólares la tarjeta (lanzamiento) |
Las dos velocidades salen de la misma prueba en la tabla oficial de CUDA de llama.cpp. La diferencia sigue al ancho de banda: la 5090 mueve unas 6,6 veces más datos por segundo. El precio de la 5090 es el precio de lanzamiento de NVIDIA solo para la tarjeta; aún necesitas un PC para montarla.
El tamaño de la memoria le da la vuelta al resultado. gpt-oss-120b necesita más de 60 GB en su formato nativo de 4 bits, así que no cabe en una 5090. Tendrías que llevar la mayor parte a la RAM del sistema, que es mucho más lenta. En el DGX Spark cabe entero y genera 58,7 tokens por segundo, según el benchmark de DGX Spark de llama.cpp. Así que compra la 5090 para modelos de hasta 32B, y mira el DGX Spark (o un Mac Studio) para modelos de 70B a 120B en un equipo pequeño y silencioso. Datos revisados el 28 de octubre de 2026.
Cuál comprar según tu caso
Compra un Mac Studio si
- Sobre todo conversas, programas o trabajas con documentos, y te basta con Ollama o LM Studio.
- Te importa la velocidad de generación. Por el mismo precio, el M5 Ultra genera unas tres veces más rápido que el DGX Spark.
- Quieres usar modelos de más de 200.000 millones de parámetros y necesitas 256 o 512 GB.
- Tu presupuesto ronda los 3.000 $. El M5 Max de 40 núcleos ya es más rápido que el DGX Spark.
Compra un DGX Spark si
- Tu trabajo depende de CUDA, vLLM o TensorRT-LLM.
- Haces ajuste fino o entrenamiento, o tu código se desplegará en servidores de NVIDIA.
- Piensas conectar dos unidades más adelante para usar modelos más grandes.
Mira otras opciones si
Si quieres 128 GB por menos dinero, mira los mini PC con AMD Ryzen AI Max+ 395. Comparé uno con el DGX Spark en AI Max 395 vs DGX Spark. Para modelos de hasta 32B en una tarjeta gráfica, lee mi artículo sobre la RTX 5090 para IA. Si dudas entre varios Mac con M5, lee primero la guía M5 para LLM locales, y con menos presupuesto, Mac mini para LLM locales.
Preguntas frecuentes
¿Qué es más rápido para LLM, el DGX Spark o el Mac Studio?
El Mac Studio genera tokens más rápido. En la misma prueba de llama.cpp, el M5 Ultra de 80 núcleos genera 179,1 tokens por segundo y el DGX Spark 57,2. El M5 Ultra también lee los prompts algo más rápido.
¿Cuánto cuestan el DGX Spark y el Mac Studio?
El DGX Spark de 128 GB cuesta ahora 6.950 $. El Mac Studio con M5 Ultra cuesta desde 5.499 $, la versión de 80 núcleos desde 6.799 $ y el M5 Max de 40 núcleos desde 3.099 $.
¿Puede el DGX Spark ejecutar gpt-oss-120b?
Sí. En la prueba oficial de llama.cpp, el DGX Spark genera 58,7 tokens por segundo con gpt-oss-120b. Un Mac Studio con 96 GB o más también puede ejecutarlo.
¿El DGX Spark es más rápido que una RTX 5090?
No. Con modelos que caben en 32 GB, la RTX 5090 genera unas cinco veces más tokens por segundo (290 frente a 57,2 con Llama 2 7B Q4_0). El DGX Spark solo conviene para modelos de más de 32 GB, como gpt-oss-120b.
¿Vale la pena el DGX Spark de 64 GB?
Cuesta desde 4.999 $, 1.900 $ más que un Mac Studio con M5 Max de 64 GB, y su ancho de banda es mucho menor. Salvo que necesites CUDA, no compensa.