

LLM local para programar: guía esencial 2026 de modelos y hardware
Qué LLM local para programar cabe en tu equipo en 2026: gpt-oss-20b con 16 GB, Qwen3.8-27B con 24 GB y Qwen3-Coder-Next con 64 GB. Memoria con 64K de contexto, velocidades medidas, cómo conectarlo a Claude Code y cuándo sale mejor una suscripción.
 bufferSobre el autor9 min de lectura
Elegir un LLM local para programar depende de cuánta memoria tienes. Con una GPU de 16 GB, usa gpt-oss-20b. Con una tarjeta de 24 GB como la RTX 3090 o la 4090, usa Qwen3.8-27B. Con un Mac de 64 GB u otro equipo de memoria unificada, usa Qwen3-Coder-Next. Con menos de 16 GB, sale mejor una suscripción de 20 dólares al mes. Pon el contexto en 64K como mínimo, porque los agentes de código lo necesitan y el valor por defecto de Ollama es menor. Revisé todas las cifras el 27 de octubre de 2026 y cada una enlaza a su fuente.
Respuesta corta: qué LLM local para programar cabe en tu equipo
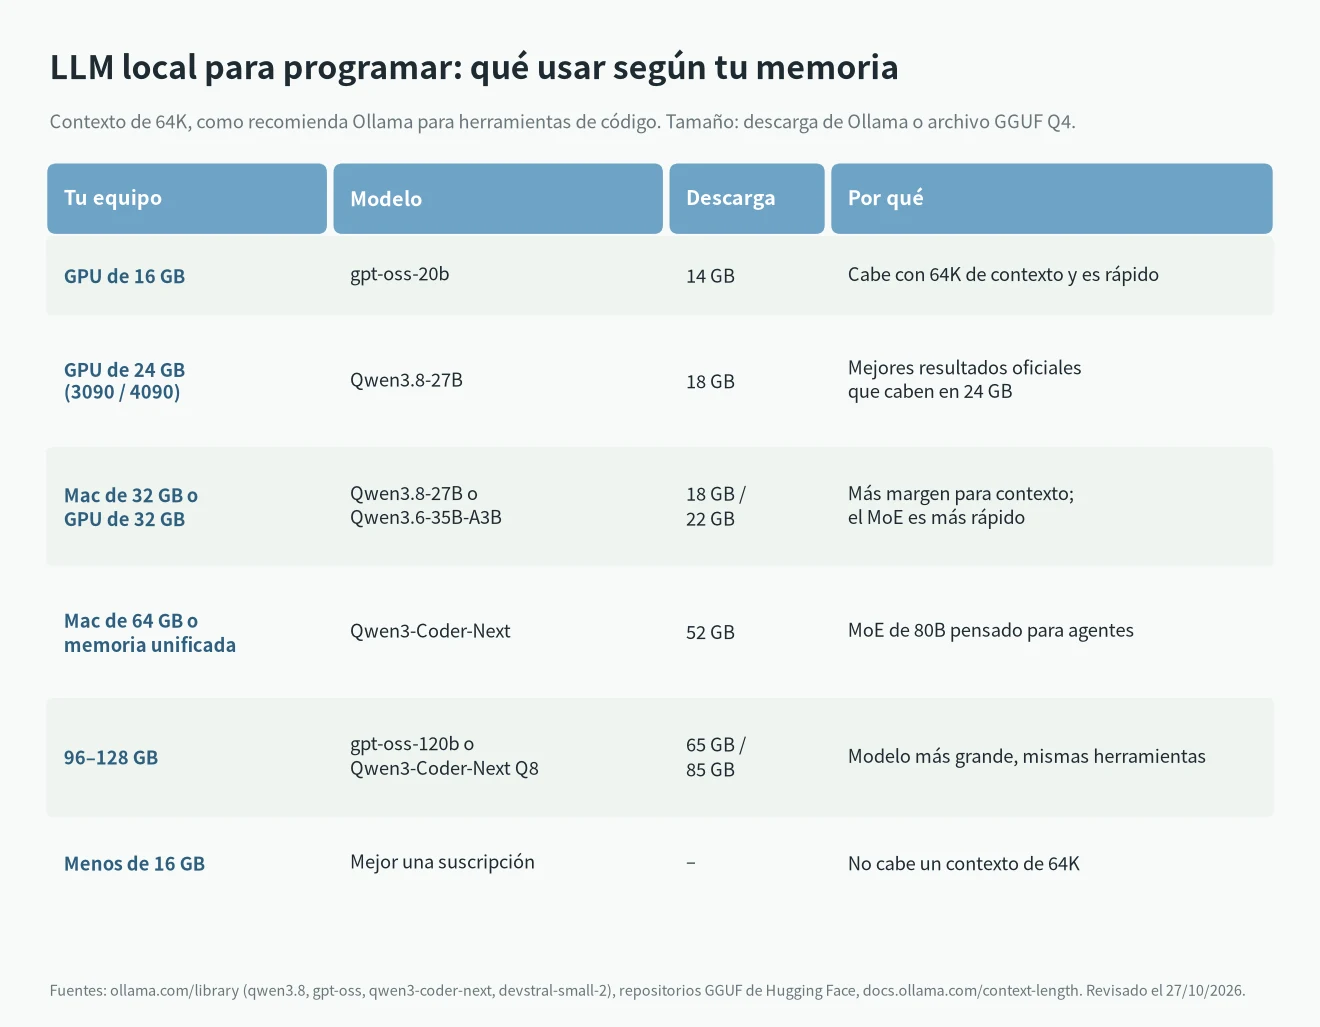
- GPU de 16 GB: gpt-oss-20b. La ficha oficial dice que funciona con 16 GB. Según mis cálculos, necesita unos 14,3 GiB con 64K de contexto.
- GPU de 24 GB (RTX 3090, RTX 4090): Qwen3.8-27B en Q4_K_M. Unos 20,8 GiB con 64K de contexto, así que cabe con algo de margen.
- Mac de 32 GB o GPU de 32 GB: Qwen3.8-27B con más contexto, o Qwen3.6-35B-A3B, que es más rápido porque solo activa 3B parámetros por token.
- Mac de 64 GB o memoria unificada: Qwen3-Coder-Next. Es un modelo de mezcla de expertos de 80B con 3B activos, pensado para agentes de código. Unos 48 GiB con 64K.
- De 96 a 128 GB: gpt-oss-120b, unos 62,8 GiB con 64K, o Qwen3-Coder-Next en Q8.
- Menos de 16 GB: para programar con agentes no merece la pena. No caben el modelo y 64K de contexto a la vez.
Si solo quieres saber qué más cabe en una tarjeta de 24 GB, lo expliqué en qué modelos puede ejecutar la RTX 4090. Este artículo trata solo de programar.
Por qué el contexto de 64K importa tanto
Herramientas como Claude Code envían mucho texto en cada petición: el prompt de sistema, las definiciones de herramientas, los archivos que leen y la conversación. La página de longitud de contexto de Ollama dice que los agentes y las herramientas de código deben usar al menos 64.000 tokens. La guía de integración con Claude Code dice lo mismo: elige un modelo y pon un contexto de 64K o más.
El problema es el valor por defecto. La misma página lo indica: 4K de contexto con menos de 24 GiB de VRAM, 32K entre 24 y 48 GiB, y 256K a partir de 48 GiB. Con una tarjeta de 16 o 24 GB, el valor por defecto se queda corto para agentes de código. Tienes que subirlo tú:
OLLAMA_CONTEXT_LENGTH=64000 ollama serveCuánta memoria ocupa la caché KV en un LLM local para programar
Más contexto significa una caché KV más grande. La calculé con el config.json de cada modelo: 2 × capas de atención completa × cabezas KV × tamaño de cabeza × 2 bytes por token. Los modelos con atención híbrida solo cuentan sus capas de atención completa, por eso algunos necesitan muy poco.
- Qwen3.8-27B: 16 de sus 64 capas usan atención completa, con 4 cabezas KV. Son 64 KiB por token, o 4 GiB con 64K.
- Devstral Small 2 24B: 40 capas de atención completa con 8 cabezas KV. Son 160 KiB por token, o 10 GiB con 64K.
- gpt-oss-20b y Qwen3-Coder-Next: unos 24 KiB por token, o 1,5 GiB con 64K.
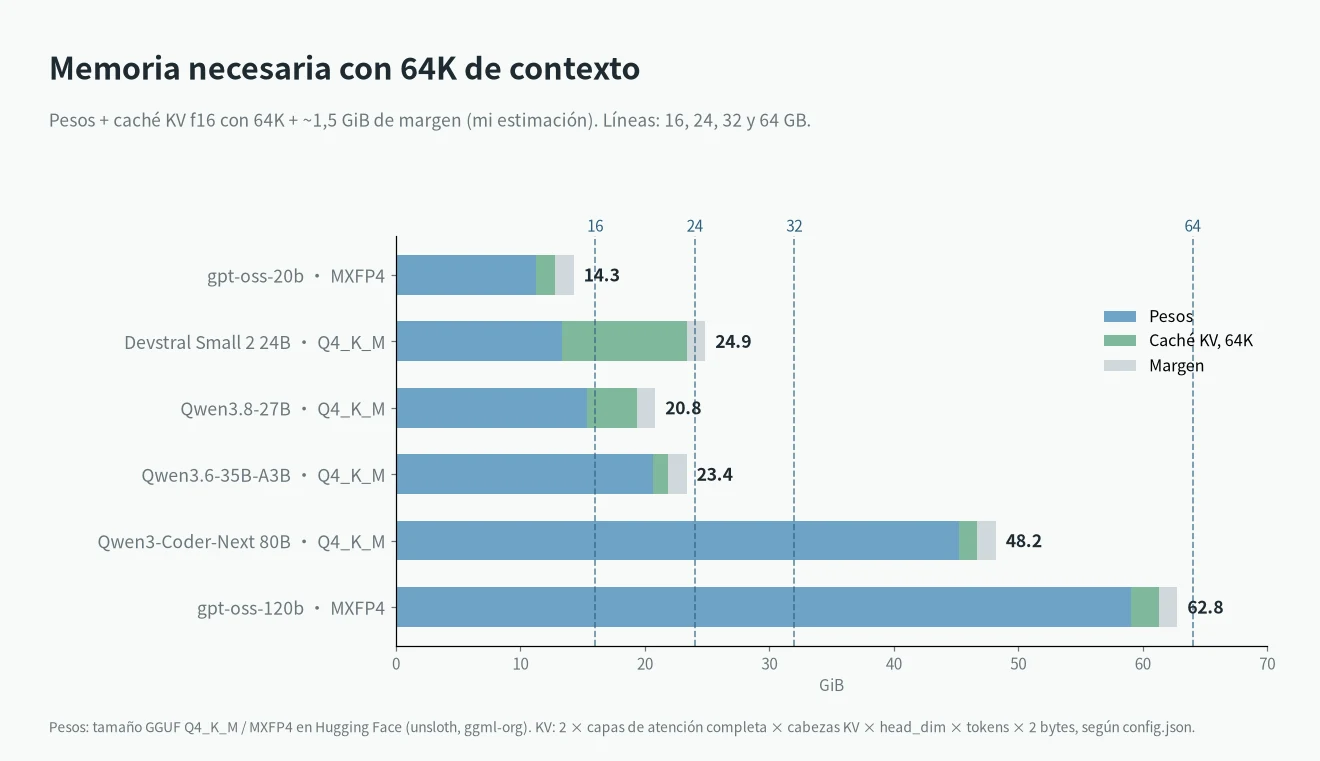
Por eso Devstral Small 2 cuesta más de encajar de lo que sugiere su archivo de 13,35 GiB. Con 64K llega a unos 24,9 GiB, un poco más que una tarjeta de 24 GB. Ollama puede guardar la caché KV en 8 bits, lo que la reduce a la mitad. Las preguntas frecuentes de Ollama explican el ajuste OLLAMA_KV_CACHE_TYPE, que requiere flash attention activado. Con q8_0, mi estimación baja a unos 19,9 GiB.
Estos totales son estimaciones mías: tamaño del archivo más caché KV en f16 más 1,5 GiB de margen. En uso real puede variar uno o dos gigas.
Los modelos que vale la pena probar en 2026
Qwen3.8-27B: la mejor opción para 24 GB
Qwen publicó Qwen3.8-27B el 5 de agosto de 2026. Es un modelo denso de 27B con 262.144 tokens de contexto nativo. En su ficha de Hugging Face saca 61,7 en SWE-bench Pro, medido con Claude Code y 256K de contexto. Saca 73,0 en Terminal Bench 2.1 y 90,3 en LiveCodeBench v6. La misma ficha da 53,5 en SWE-bench Pro para Qwen3.6-27B. No aparece una cifra de SWE-bench Verified para la versión 3.8.
El GGUF de unsloth en UD-Q4_K_M ocupa 15,33 GiB. Q8_0 ocupa 27,05 GiB y necesita una tarjeta de 32 GB o un Mac más grande. En la biblioteca de Ollama la descarga de 27B es de 18 GB, y hay una versión MLX para Apple silicon.
Qwen3.6-27B y Qwen3.6-35B-A3B
El anterior Qwen3.6-27B saca 77,2 en SWE-bench Verified. La versión de mezcla de expertos Qwen3.6-35B-A3B saca 73,4. Solo activa 3B parámetros, así que genera más rápido que un modelo denso de 27B. Su archivo Q4_K_M ocupa 20,61 GiB, unos 23,4 GiB con 64K. Va justo en 24 GB y holgado en 32 GB.
Devstral Small 2 24B
Devstral Small 2 de Mistral saca 68,0% en SWE-bench Verified y 22,5% en Terminal Bench 2. Tiene licencia Apache 2.0 y su ficha dice que funciona en una RTX 4090 o un Mac de 32 GB. Vigila la caché KV, como vimos arriba.
Qwen3-Coder-Next: para equipos de 64 GB
Qwen3-Coder-Next salió el 30 de enero de 2026. Tiene 80B parámetros en total y 3B activos, con 256K de contexto. La ficha dice que funciona con Claude Code, Qwen Code y Cline. El GGUF oficial ocupa 45,09 GiB en Q4_K_M y 78,99 GiB en Q8_0. Ollama lo lista con 52 GB.
gpt-oss-20b y gpt-oss-120b
gpt-oss-20b de OpenAI tiene 21B parámetros con 3,6B activos y 131.072 tokens de contexto. Su archivo MXFP4 ocupa 11,28 GiB. El gpt-oss-120b tiene 117B parámetros con 5,1B activos y cabe en una GPU de 80 GB. Su archivo ocupa 59,03 GiB.
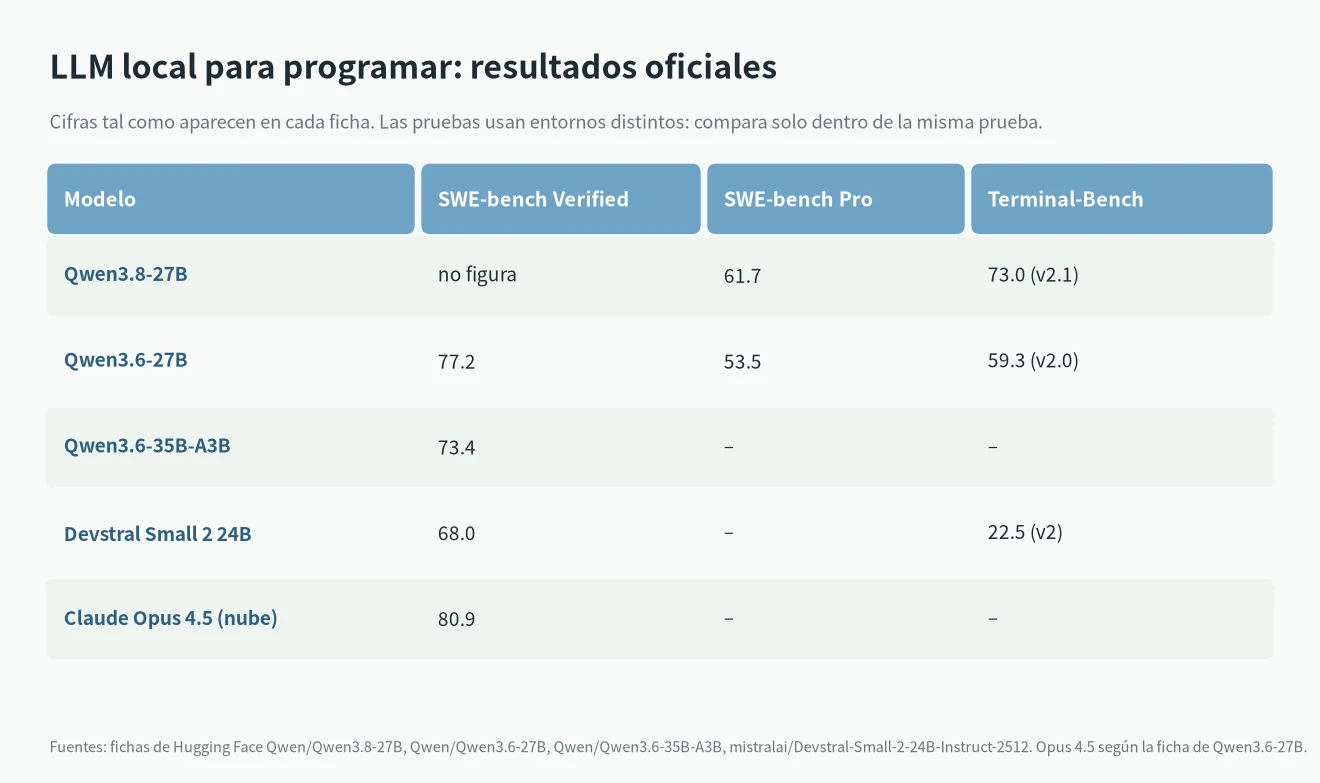
Un apunte sobre estas cifras. Cada fabricante mide con su propio entorno, así que 3 puntos de diferencia entre dos fichas no dicen mucho. La referencia útil es el mejor modelo en la nube: la ficha de Qwen3.6-27B da 80,9 en SWE-bench Verified para Claude Opus 4.5. Los mejores modelos locales están cerca sobre el papel. En el día a día, un modelo en la nube sigue llevando mejor las tareas largas y complicadas.
Qué velocidad tiene un LLM local para programar
Aquí solo uso cifras medidas. Con Qwen3.8-27B en Q4_K_M y llama.cpp, llm-speed registra de 43 a 44 tokens por segundo en una RTX 4090, con un mejor resultado de 44,2. El pico de VRAM fue de 18,7 GiB con 8K de contexto. La página del modelo muestra 38,61 tok/s en una RTX 3090 y 75,19 tok/s en una RTX 5090, aunque la prueba de la 5090 usó una versión antigua. Una prueba de la comunidad con decodificación especulativa MTP llegó a 84,5 tok/s en una 4090, según este artículo de llm-speed.
Para gpt-oss-20b, Hardware Corner midió 190,6 tok/s en una RTX 4090 con 4K de contexto. La velocidad baja al crecer el contexto: 104,0 tok/s con 64K y 70,3 tok/s con 128K.
No encontré una velocidad medida de Qwen3-Coder-Next en una fuente fiable, así que no doy cifra.
Si estás pensando en una tarjeta de 32 GB, mira si la RTX 5090 para IA vale la pena. Para equipos de 128 GB, comparé AI Max+ 395 y DGX Spark.
Cómo conectarlo con Ollama y Claude Code
Ollama 0.15 añadió ollama launch, según su anuncio. Un solo comando configura la herramienta de código y la apunta a un modelo local:
ollama pull qwen3.8
ollama launch claude --model qwen3.8
Lo mismo sirve para OpenCode y OpenClaw. La página de OpenClaw también pide al menos 64K de contexto con modelos locales.
ollama launch opencode --model qwen3.8
ollama launch openclaw --model qwen3.8
Si prefieres lanzar Claude Code tú mismo, Ollama ofrece una API compatible con Anthropic desde la versión 0.14.0, como explica su artículo sobre Claude Code:
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_BASE_URL=http://localhost:11434
claude --model qwen3.8
Recuerda arrancar Ollama con 64K de contexto antes. Si Claude Code pierde de vista los archivos o se repite, lo primero que revisaría es que el contexto no se haya quedado corto.
Local o suscripción: las cuentas
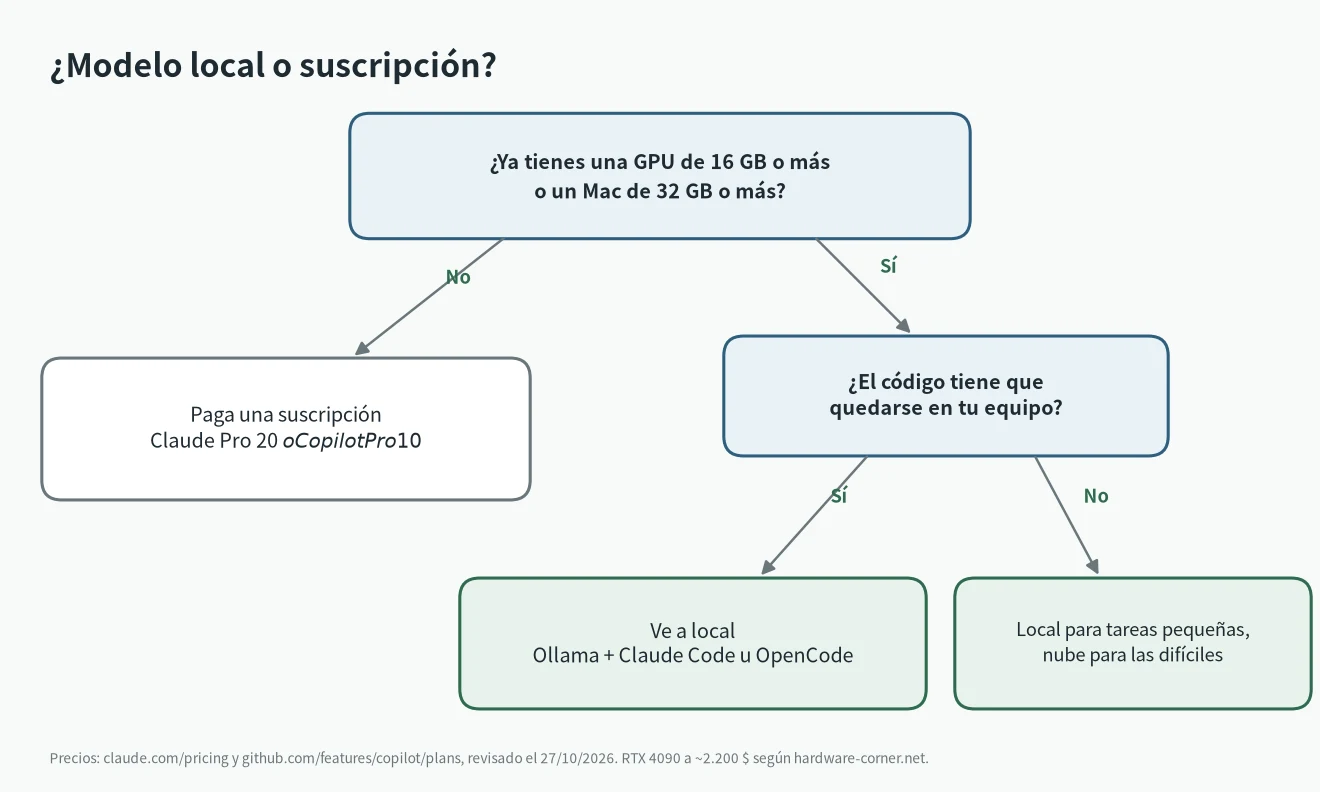
Claude Pro cuesta 20 dólares al mes, o 17 al mes con pago anual, e incluye Claude Code. GitHub Copilot Pro cuesta 10 dólares al mes. Hardware Corner sitúa el precio medio de mercado de la RTX 4090 en 2.200 dólares. Eso son 110 meses de Claude Pro.
Por eso no compraría una GPU solo para usar un LLM local para programar. Tiene sentido si ya tienes el hardware, si tu código no puede salir de tu equipo o si quieres trabajar sin conexión. Comparé las opciones de pago en Claude Code o Codex: cuál pagar y en la mejor suscripción de IA en 2026.
Mi recomendación
- Si tienes una 3090 o una 4090, prueba hoy Qwen3.8-27B con 64K de contexto. No cuesta nada.
- Si tienes una tarjeta de 16 GB, usa gpt-oss-20b para cambios pequeños y preguntas. No esperes que haga grandes refactorizaciones.
- Si vas a comprar un Mac para esto, con 64 GB puedes usar Qwen3-Coder-Next. Sobre cuándo comprar, mira comprar un Mac ahora o esperar.
- Guarda un modelo en la nube para las tareas difíciles. Mucha gente usa el modelo local para el trabajo rutinario y cambia cuando se atasca.
Preguntas frecuentes
¿Cuál es el mejor LLM local para programar con una GPU de 24 GB?
Qwen3.8-27B en Q4_K_M. Según mi estimación ocupa unos 20,8 GiB con 64K de contexto, y tiene los mejores resultados oficiales entre los modelos que caben.
¿Puedo usar Claude Code con un modelo local?
Sí. Ollama 0.14.0 y posteriores hablan la API de Anthropic, y desde la 0.15 ollama launch claude --model qwen3.8 lo configura en un paso.
¿Bastan 16 GB de VRAM?
Para gpt-oss-20b, sí. La ficha oficial dice que funciona con 16 GB, y mi estimación es de unos 14,3 GiB con 64K de contexto. Los modelos de código más grandes no caben con un contexto útil.
¿Un LLM local para programar es tan bueno como Claude?
Sobre el papel la diferencia es menor que antes: Claude Opus 4.5 saca 80,9 en SWE-bench Verified y Qwen3.6-27B saca 77,2. Pero se midieron en entornos distintos, así que tómalo como una guía aproximada.